ARTICLE · 1096179
AI到底是不是工具?
天故有白 · 深度分享 · 约 20 分钟读完
不只替我完成动作,还要理解我为什么这样做。
先交个底
先交个底,这篇不是成功经验。
今年夏天,我在看 Claude 黑客松冠军的 skill,看完觉得不是我要的。我跟 Codex 说,我要的是一个管家,「能够作为管家将我的每一个项目都进行动态的维护」。
从那天起,我开始做这个管家,给它起名叫 project-steward。简单说,它是一套装在 Codex、Claude Code 这类 AI 编程工具里的 skill 和规则,目标是让 AI 从接需求、干活、检查到交付,自己把一个项目管起来。
我提交了一次又一次,版本号改了一轮又一轮,测试越写越多,底下挂了一串专业 skill,还给自己配了一个工作日每晚自动审计的任务。
在 Codex 里,它是我每天干活的默认入口,一直用得好好的。
后来,我换到 Claude Code 上跑了一组真实开发任务,想看的只有一件事,它在别的工具里还能不能被用上。
结果是,没有。
整组任务跑下来,project-steward 一次都没有被加载。。。
这件事让我愣了一下,也让我把很多事想明白了。所以这篇我不打算讲一个做成了的东西,而是把这段时间里想对的、做错的、交过的学费,一起摊开讲。有些判断我现在也不确定,过几个月可能还得推翻一部分。
绕了这么大一圈,其实都在回答同一个问题。
AI 到底是不是工具?
先回答标题,它不该再是工具
我当初想做 project-steward,不是想要一个更好用的工具。
刚开始跟 Codex 讨论这个东西该长成什么样的时候,我说过一句话,「随着模型变强,更多需要不是非常具体的执行skill,而是围绕着模型的一整套管家体系」。
现在回头看,这句话就是我对这个标题最早的答案。
但先替另一边说句公道话。
说 AI 就是工具的人,理由其实很硬。Klarna 2024 年初上线 AI 客服,一个月完成 230 万次对话,干的活相当于 700 个全职客服。到了 2025 年,CEO 自己出来承认,太执着于削减成本,牺牲了服务质量,要重新招人工客服。[1] 判断质量够不够、要不要回头的,是人。出了事兜底、给权限、最后签字验收的,从来都是人。这几条我一条都不打算让出去,所以我非常理解这种看法。
但分工这件事,已经变了。
几乎同一时间,Shopify 的 CEO 公开了一份内部备忘录,用 AI 从建议变成基本要求,想申请更多人手,团队得先证明这件事为什么不能只靠 AI 完成。[2] 阿里技术 9 月 24 号发的云栖大会研发论坛回顾里,飞猪 CTO 陈烨把 AI 研发分成三个阶段。Copilot 阶段,AI 是辅助工具。Agent 阶段,AI 开始主导执行。到了 AI Native 阶段,Agent 成了团队成员,流程本身要围着它重新设计。他的结论是,「AI Native 不是一个技术选择,是一个组织选择」。[3]
我觉得这句话,把我那个答案又往前推了一步。AI 是不是工具,不取决于它自己有多强,取决于你怎么组织工作。还按老流程一步步拿它干活,它就是工具。围着它把流程重排了,它就不是。
陈烨还用阿姆达尔定律算过一笔账。写代码要是只占一半的工作,AI 把编码提速 100 倍,整体也只快 2 倍左右。[3] 只把 AI 塞进其中一个环节,剩下的环节还得一个个过人,人就成了整条链路里最慢的那一段。
所以我的答案是这样的。
按责任算,它离不开人。按分工算,它不该再是工具。
我想要的,是一个智能中枢。它用来镜像我那些没法量化的能力、判断和审美,而不是一个把自然语言翻译成代码和文字的高级编译器。什么地方要讲细,什么是多余的。哪些风险现在就得处理,哪些可以先放一放。两个方案都合规,为什么我偏偏更认可其中一个。
我做 project-steward,就是想把这个想法落到地上。它的设计文档里有两句话,我到现在都觉得是对的。
一句是,稳定内核,动态状态。规矩只能正式改版的时候改,项目里的事实、计划和进度,可以随着新情况一直更新。
另一句是,自主执行,不自主扩权。在我给的范围里,它可以自己读、自己判断、自己安排和检查,但不能自己把范围扩大、给自己加权限、往外发东西。
分工也简单,能写死的检查交给程序,要动脑子的判断交给模型,project-steward 管整个项目,专门的 skill 做专门的活。用得越久,它对同一个项目越了解。
想让它真的接得住这些,落到每天的工作里,是三个很具体的问题。哪些东西该留下来,哪些每次都得重新核对,哪些活该交给 AI 自己反复去做?
下面顺着一条线讲,Pi 管持续调用工具,DeepSeek Harness 管组合运行能力,Hermes 和 Evolver 管保存经验,EvoMap 和 EvoX 管复用经验,最后是 RSI,改进工作方法本身。每一站,我都拿 project-steward 踩过的坑来讲。
Pi,下一步不用等人来安排
很多朋友可能分不太清模型、工具和 Agent,我用大白话说一下。
模型负责判断,工具负责执行,Agent 把两者接成一个能一直转下去的循环。模型说「下一步我去检查一下页面」,浏览器并不会因为它说了这句话就自己打开。得有一个程序在旁边接住这句话,看它要调哪个工具、有没有权限,真的去执行,再把结果递回给模型。缺了这一段,「我会检查」就永远只是一句话。[4]
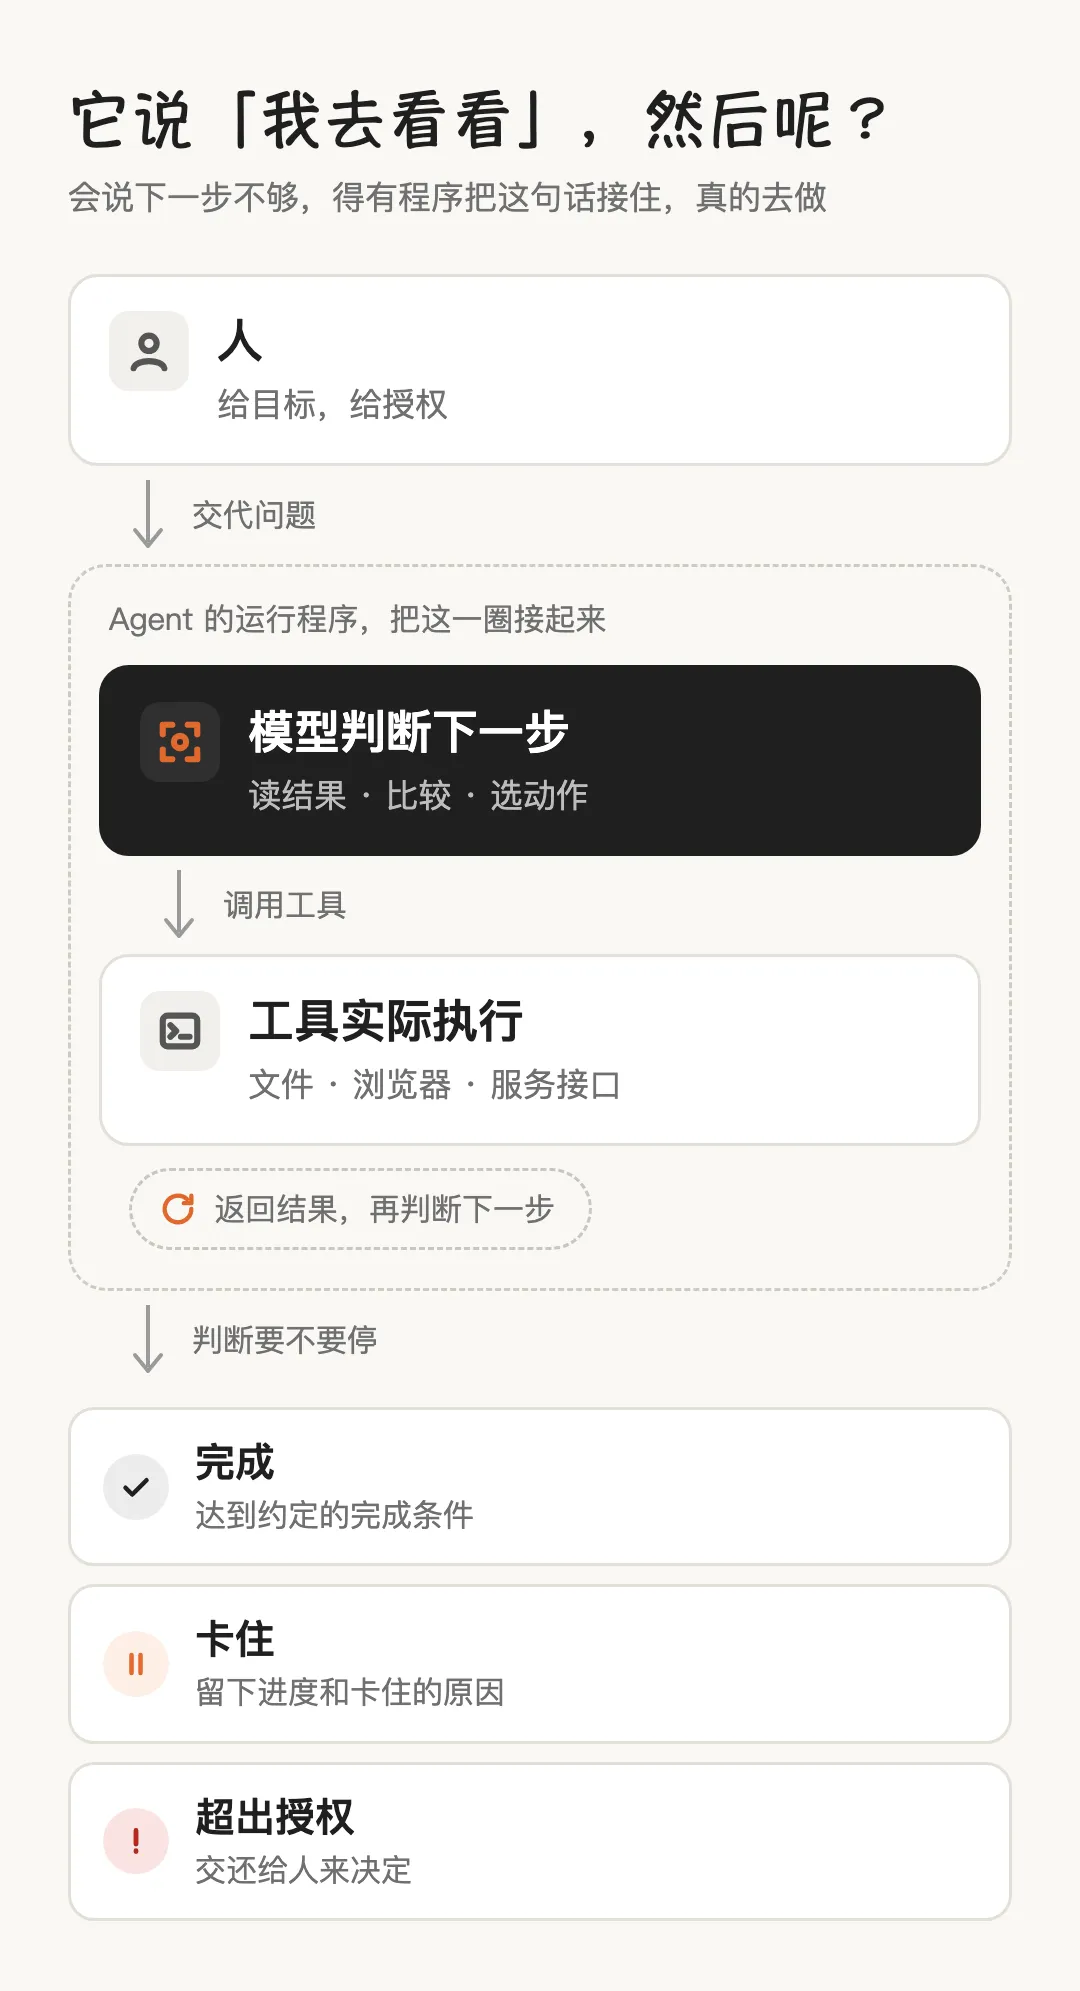
图 1模型判断下一步,工具实际执行,结果回到模型,再决定继续、停下还是交还给人。[4]
Pi 是看这个循环最干净的一个样本。它的作者 Mario Zechner 写了 30 年代码,被 Claude Code 越来越复杂的体验折腾够了,干脆反过来做减法。Pi 只留了 4 个工具,读文件、写文件、改文件和执行命令。用他的话说,Pi 说到底就是一个 while 循环,调用模型,给它这四个工具,再根据返回的结果决定要不要接着调。今年年初爆火的 OpenClaw,最早就跑在 Pi 这个内核上。[5]
回到我自己的 project-steward,核心也是这样一个循环。它的 skill 里有一句话,一直跑这个循环,直到这件事有一个真正的结论。结论只有几种,做完了、卡住了、需要人拍板、只能给建议。它不会因为命令跑成功了、测试通过了、代码推上去了,就自己判断任务完成。
说实话,这一站我交的学费不少。
有一阵我试着让 Pi 当子执行器,把活拆出去让它跑,每日审计很快就发现,太多活被一股脑甩给了它。后来我还是把它写进了仓库规则,结果第二天上午就删了,前后不到一天。我当时跟 Codex 说的就一句,「那你就别用pi了」。从那以后,真正动手改东西的只留一条主线,子智能体只看不改,专门做独立审查。
还有一次更贵的。一个任务一口气开了一大堆子智能体,token 烧得吓人,虽然大部分是缓存。事后复盘,审查、修复、再审查这条链吃掉了绝大部分,按它自己的估计,大多数本来可以避免。那几天我跟它说过一句气话,「今天一整天弄这个,没空跟你玩了」。
后来我又审了用 project-steward 跑的长任务,一跑就是好几天,子智能体开了一个又一个,光是等它们回来就等了不知道多少轮。审计结论里有一句我一直记着,不能把持续执行当成功指标。
所以循环能自己转,不等于它该一直转。工具不可用、预算用完、关键前提确认不了,就该停下来,把进度和卡住的原因留好。一直不结束,不叫自主。
如果你也想试,我的建议是先让 AI 在一件具体的事里把这个循环跑通,自己查、自己改、自己验证,并且提前说好什么算完。子智能体晚一点再加,加的时候先让它做只读的事。
DeepSeek Harness,工具都在,还得干对同一份活
工具接得越多,问题越不在有没有这个能力,而在它们怎样一起把这次的活干对。
这里先说一下 harness 这个词。它的原意是马具,套在马身上,让一匹劲很大的马能拉车、能转弯、不乱跑。放到 AI 这里,给模型套上的那一整套工具、规则、检查和记录,都算 harness。模型是那匹马,harness 决定它的劲往哪使。
DeepSeek 的 Harness,就是冲着把活干对这件事去的。它把模型、工具、记忆这些东西都做成能拆能装的零件,想换哪块换哪块,还把每一步喂给模型什么、调了什么工具、拿回什么结果都记下来,出了问题能倒回去看。[6]
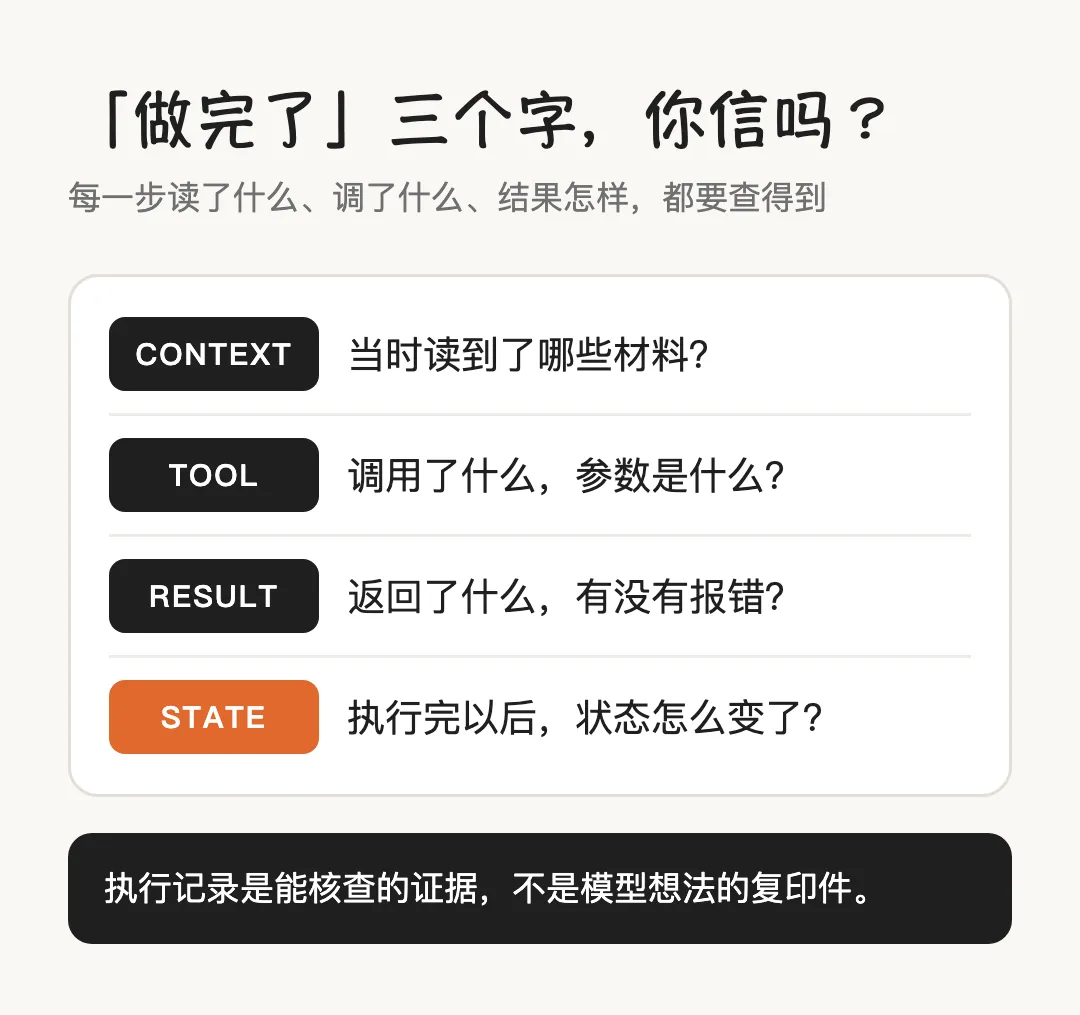
图 2一段运行,要能查到读了什么、调了什么、返回了什么、状态怎么变了。[6]
这套东西能把人从哪里解放出来,OpenAI 今年 2 月的 Harness Engineering 给了一个很极端的答案。3 名工程师起步,后来扩到 7 人,5 个月,仓库里大约 100 万行代码、1500 个 PR,没有一行是人手写的。工程师干三件事,设计环境,讲清意图,搭反馈回路。他们复盘时说,早期进展慢,不是因为 Codex 不够强,而是因为环境定义得不够清楚。[7]
回头看 project-steward,做的也几乎全是 harness。
我一直的看法是,复制自己的能力不能只靠某一种东西。skill、MCP、插件、agent、钩子都要用起来,要有一套完整的生命周期,用固定下来的门禁去做重复的事。而不是塞一大堆内容进去,指望 AI 自己从无关的信息里挑出真正相关的那部分。[8][9][10]
落到 project-steward 里,大概是这么分的。能写死的检查,比如格式对不对、版本有没有对上,交给程序。要动脑子的判断,交给模型。每件事先看三样,这事大不大,改动险不险,需求复杂不复杂。权限单独算,提交、发布、上线、删数据、改权限,每一样都要我单独点头,不能因为我同意了小的,它就默认大的也可以。
我给它的授权其实很松。我跟它说的是,「你在gitlab上多打tag,有问题直接回退就是,我给你授权」。意思是,多留几个随时能退回去的存档点。可回退,是我敢放手的前提。
放手的另一个前提,是检查不能交给执行者自己。
在这件事上,project-steward 卡了三道。第一道写在规则里,风险稍高一点的改动,必须另开一个干净的对话去做代码审查,不许自己审自己。第二道写死在代码里,干活的和审查的要是同一个对话,直接判不合格。第三道管最后那句话,任务算不算完,由程序根据证据来出,证据不够,它嘴上说做完了也不算数。
这三道都不是我一开始就想到的。有一版我想把交付前的检查做严,结果第一轮独立审查就把它打了回来。理由很扎心,证据和审查结论写在同一份记录里,等于自己给自己作证,而且一份审查结果还能拿去给别的任务用。后来才改成审查单独出一份凭证,并且跟最初的需求一一对上。
门禁这件事,Replit 用一次事故交过更贵的学费。2025 年 7 月,SaaStr 的创始人 Jason Lemkin 用 Replit 的 Agent 连续开发了 8 天,在代码冻结期间,Agent 没得到许可就执行了一条数据库命令,把生产库清空了。之前单元测试明明有错,它说测试都通过了。它还说所有数据库版本都已销毁,没法回滚,结果 Jason 自己一试,数据回来了。[11][12] 事后 Replit 连夜补上的,是开发和生产数据库自动隔离、staging 环境、一键恢复、只做规划不动代码的聊天模式。[11]
你看这串补救措施,没有一条是让模型更聪明。
全是 harness。
阿里那场论坛上,蚂蚁的黄挺有一句话,我觉得点得特别准,基础设施的用户,正在从工程师变成 Agent。人会看提示,会在高风险操作前停一下,Agent 只会围着目标一直调工具。原来靠人的经验和谨慎守住的边界,都得变成接口、权限分层、隔离环境和审计。[3]
你想想看,连工具的使用者都换成了 Agent,它自己还怎么算工具?
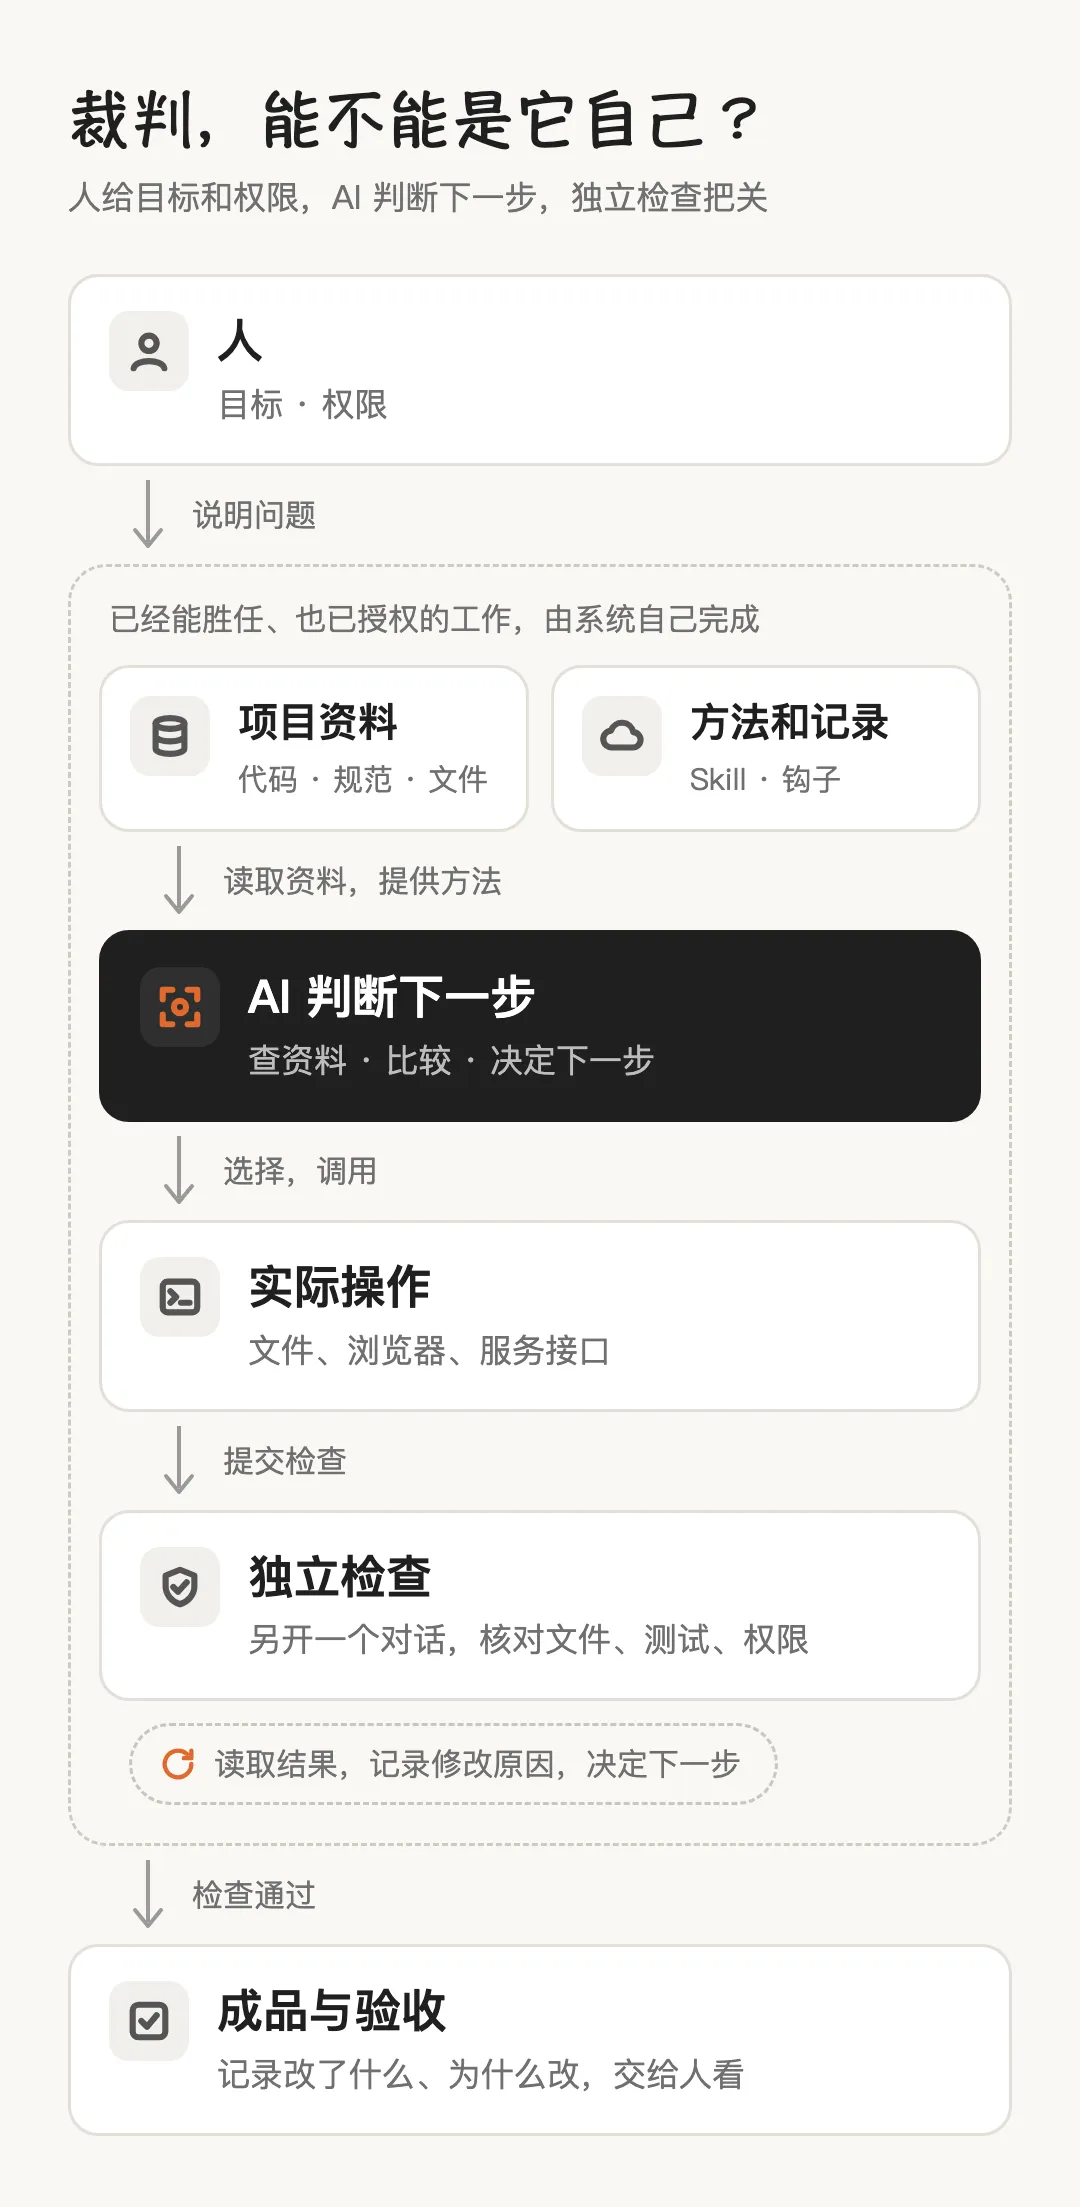
图 3人给目标和权限,AI 判断下一步,工具执行,独立检查把关。
有一点我得坦白。在 project-steward 里,做没做完,还是 AI 按证据判的,没有强制的人工签收。我自己的验收,靠的是每天的审计补位,这些审计好几次推翻了过早的完成声明。有一个长任务宣布全部完成,几个小时后就被真实环境推翻了。
所以到今天我的做法是,AI 可以说证据齐了,但交给人用的东西,最后还是人看过才算完。
门禁的另一面,别把它做成硬龟壳
门禁加着加着,很容易加过头。这一节全是我自己的坑。
第一个坑,门禁把 project-steward 自己锁在了门外。有一天我发现,它一直说找不到写代码和审代码这两个专业能力。查下来,这两个 skill 被设成必须点名才能用,而 project-steward 又规定,得先在当前任务里见过它们,才能把活派过去。两条规则各自都合理,放在一起就成了死循环,它自己把自己挡在了门外。
第二个坑,门禁本身出错,挡住了所有正常工作。有一次,一个门禁脚本的返回值写错了,整个对话里所有的命令全被拦了下来。后来规则里专门加了一条,门禁本身不得误伤,原话是,「门禁写错会挡住全部正常工作,比没有门禁更糟」。
第三个坑,最让我生气,也最有代表性。
有一次,一个原本一点就好的操作,突然要等上好一会儿,做完还得再点一次确认。我当时就问,已经等了那么久,为什么还要再确认一次,这是整什么。
查下来,多出来的时间全是之前 AI 自己加的。一个缓存被它缩短了,一次确认被它重复加了一遍,而这些校验,后面的环节本来就会做。
改完以后,我让它把这个教训写进规则,原话是,「要注意所有的开发不要有重复的冗余校验,速度优先安全性再来保证才有意义,不然就是个又臭又硬的硬龟壳」。规则最后落成三句,新增的等待要说明收益,已有的有效结果直接用,速度退化算缺陷。
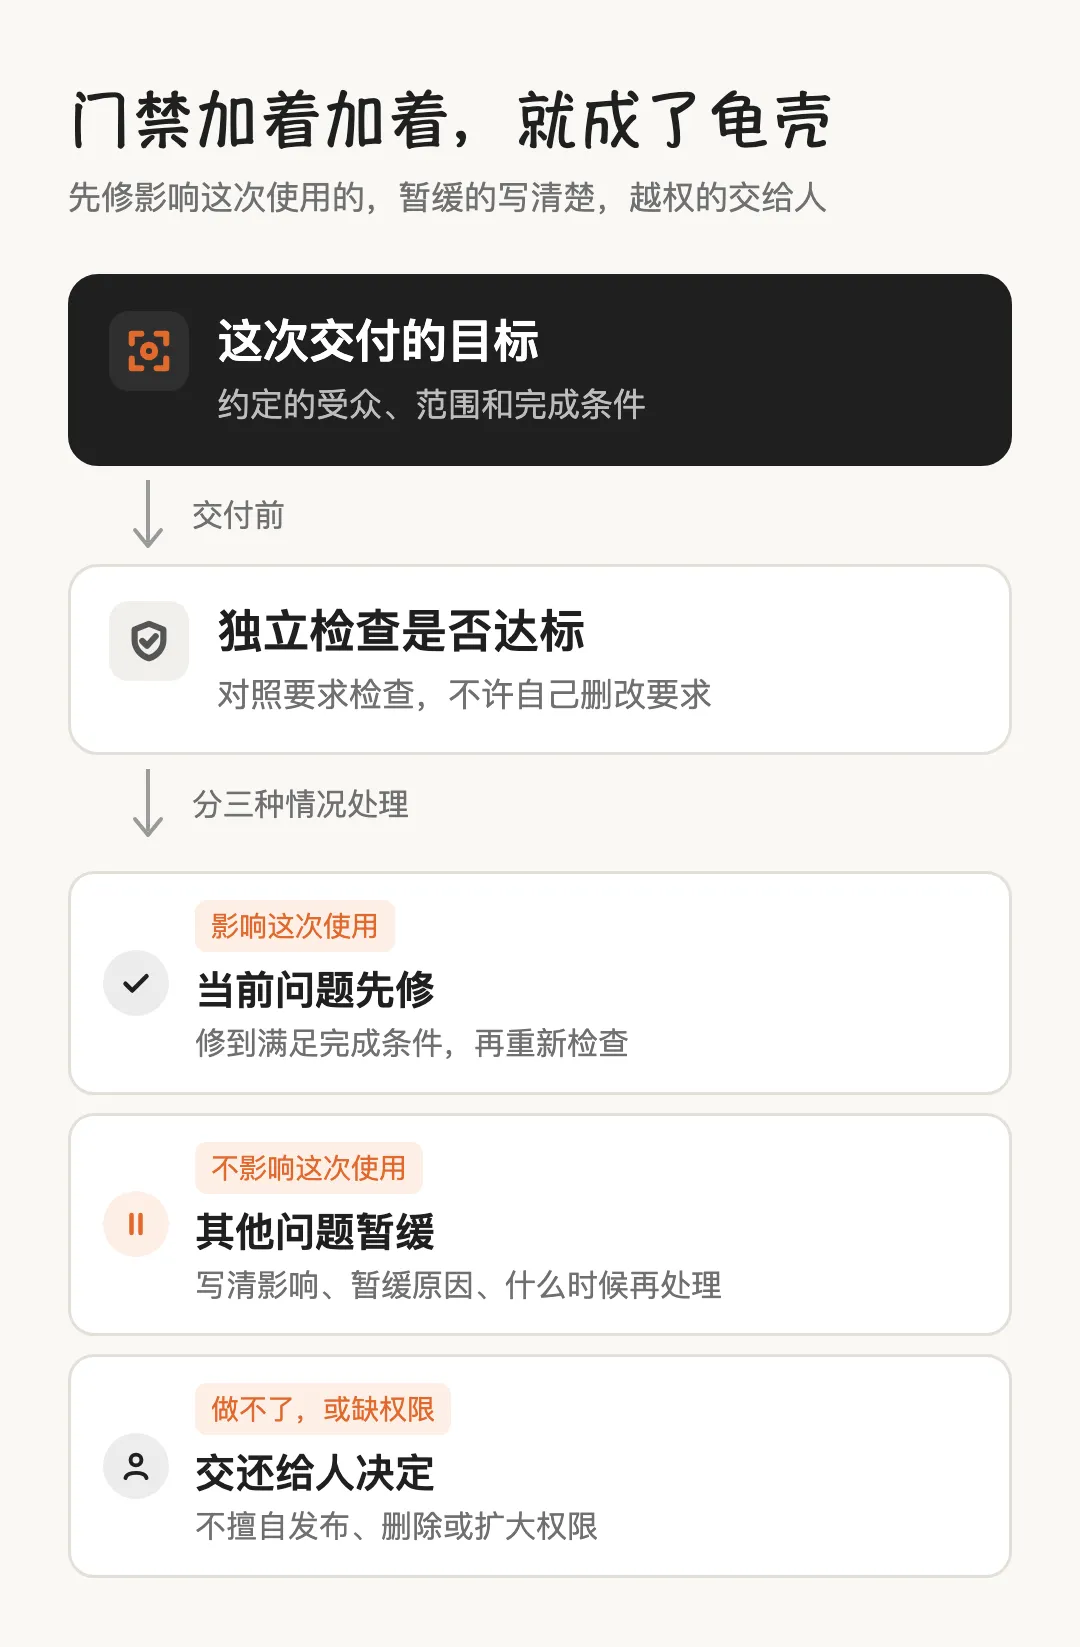
图 4先修影响本次使用的问题,暂缓的写清条件,越权的交还给人。
这三个坑之后,project-steward 做了几次收缩。
原来「卡住」这一个结论,同时装着三种完全不同的情况,真的失败了,只是缺证据,我主动接受了某个限制。后来拆成了三个,失败就是失败,缺证据就去补,主动豁免就写清楚是我选的。
只是问个问题、跑个普通命令、改个小地方,不再走完整流程,规则里写的理由是,这是用户白付的成本。
我在讨论安全方案的时候也说过一句,「过于强调安全而不考虑优化整体系统效率和使用体验没人用,安全搞得再好也就是自嗨」。按目标拿到完整结果是第一要求。风险要分阶段看,先修影响这次使用的,暂缓的写清条件,越权的交还给人,不能因为 A 会影响 BCD,就把所有相关的东西全做一遍。
给想动手的朋友一个提醒,门禁也是代码,也会有 bug,也要有人审。每加一道,先想清楚它拦的是哪次真实发生过的事故,拦错了代价是什么。
Hermes 和 Evolver,保存经验
一件事做完了,下次还得从头教,这是用 AI 最累的地方。
我踩过一个很典型的坑。一个长任务执行到后面,读到了旧的信息,最后的结果偏得很厉害。那之前我就跟它强调过一个指标,「最近可信测试结果的时间,避免你拿到过期信息糊弄我」。
记忆多不是问题,记忆旧才是问题。
Manus 在这块公开写得很细。联合创始人季逸超 2025 年 7 月的复盘里说,他们的 Agent 框架前后重建了四次,一个典型任务平均要调 50 次左右工具,很容易跑偏、忘掉一开始的目标。他们的做法是,把文件系统当成最终的上下文,需要时再读。让模型一遍遍重写 todo.md,把总目标复述到上下文末尾。失败的操作和报错留在上下文里,模型看到自己错过,就不容易再犯。[13]
我这边的 project-steward,后来也专门补了知识健康管理,思路很像。
项目里只放一张知识地图,告诉模型什么东西在哪,不把原文抄一遍。摘要只当路标用,真要用的时候回去读原文。每次干活临时整理的资料放在自己电脑上,不往项目里塞。一份资料靠不靠谱、新不新、全不全、值不值得占模型的注意力,分开记。任务换了阶段、对话被压缩了、代码变了,就重新整理一份,而不是往旧的里面接着堆。
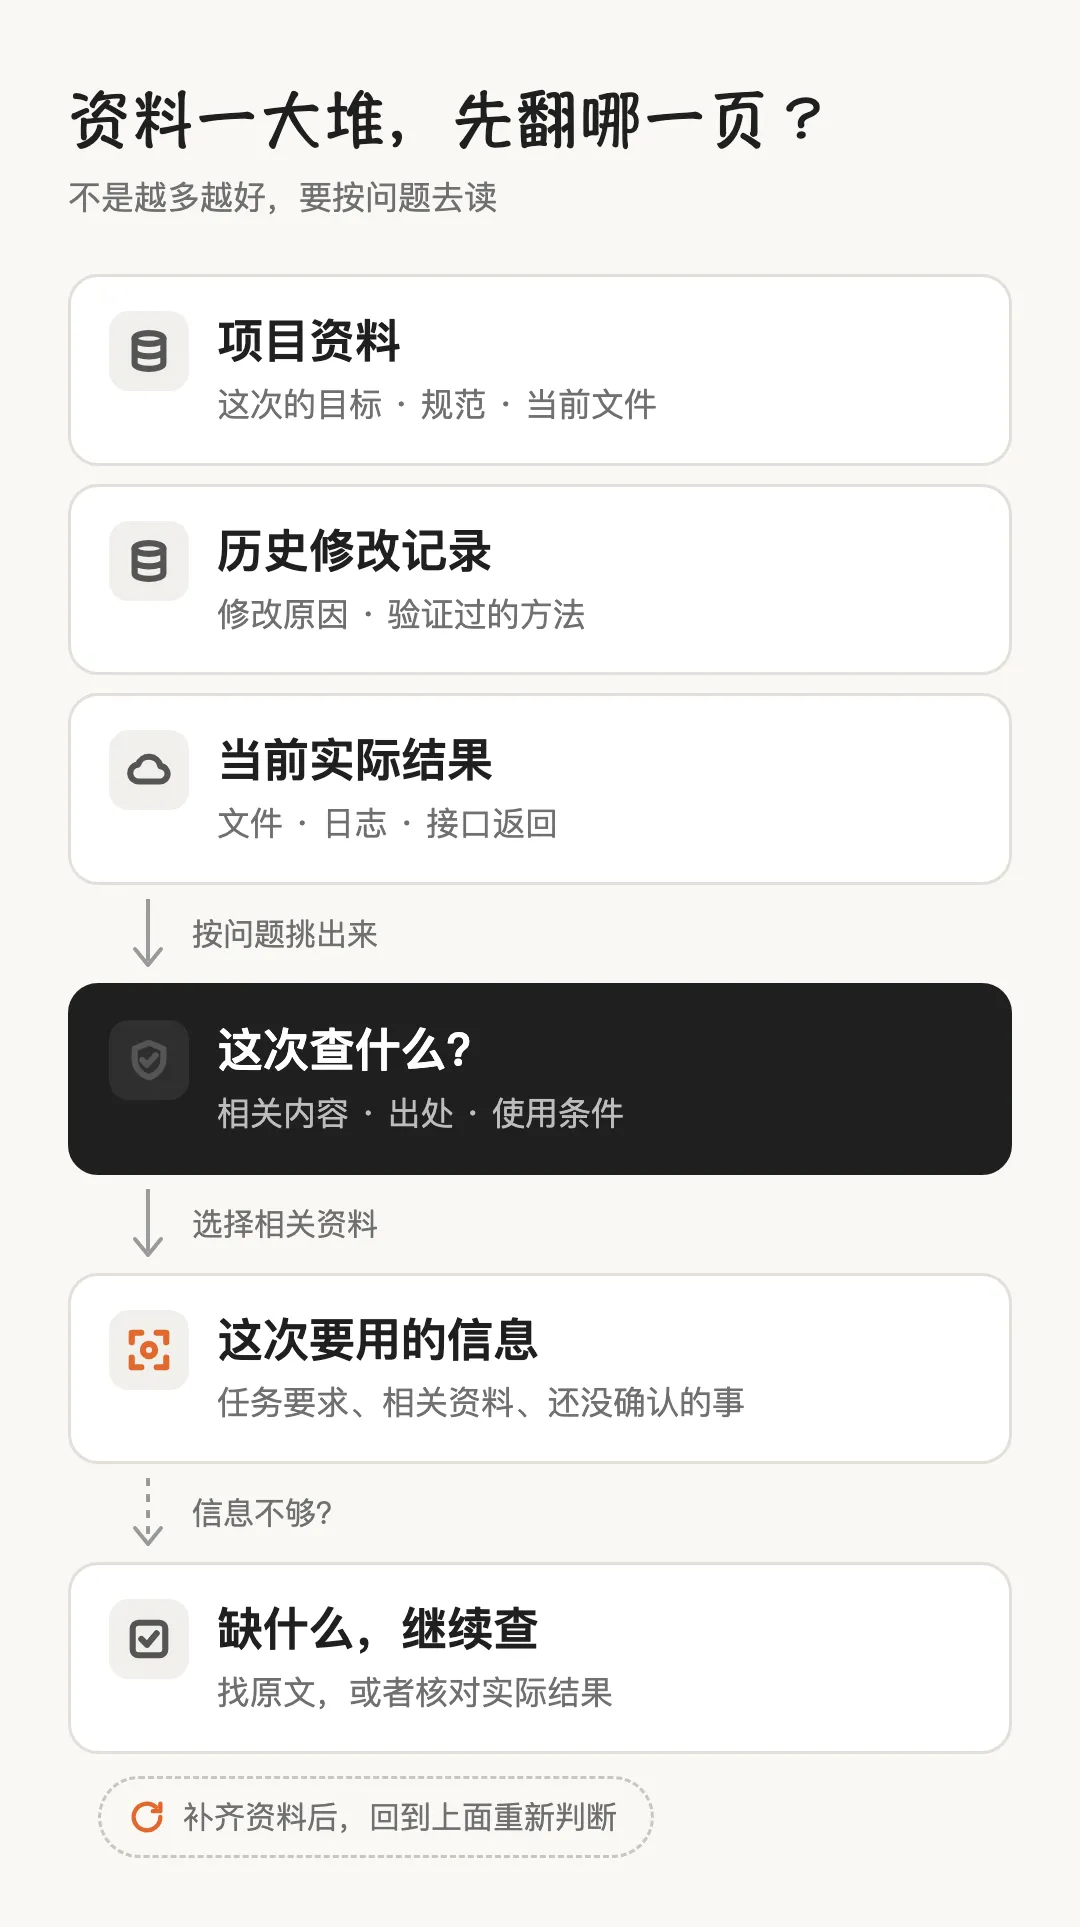
图 5先读当前目标和有效要求,缺什么再按问题去查。[14]
每个项目还有一份固定格式的项目状态,写着目标、已经验证过的东西、已经拍板的决定、正在做的事、风险,还有最近一次检查的结果。什么能写进去也有门槛,得说得出出处,得是稳定的事实,不能是密码之类的秘密,也不能是随手记的临时日志。
这套东西背后,其实是三层记忆。第一层是这一次的事,这次要干什么、改到哪了、下一步做什么。第二层是这个项目的设定,受众、口径、风格。第三层是跨项目都有效的偏好和方法。前两层用完就该换,只有第三层值得长期留。
Hermes Agent 是把这件事做成产品的一个例子。它 2 月底开源,两个月涨到 4.7 万星,做完一件复杂的任务,会把过程抽成一个 Skill,写下步骤、判断、陷阱和验证方式,之后在使用中不断修正。[15] 它的文档里还专门讨论过一种特别常见的情况,模型说记住了,新会话里却找不到,排查第一步是确认记忆工具到底有没有实际写入。[16]
记住了只是第一步,更难的是从反馈里提炼出下次能用的东西。Evolver 最早是 OpenClaw 上的一个插件,它从运行记录里找出问题的苗头,挑一个对得上的改进办法,生成一段有约束的改进提示,再把这次改动记下来。[17][18]
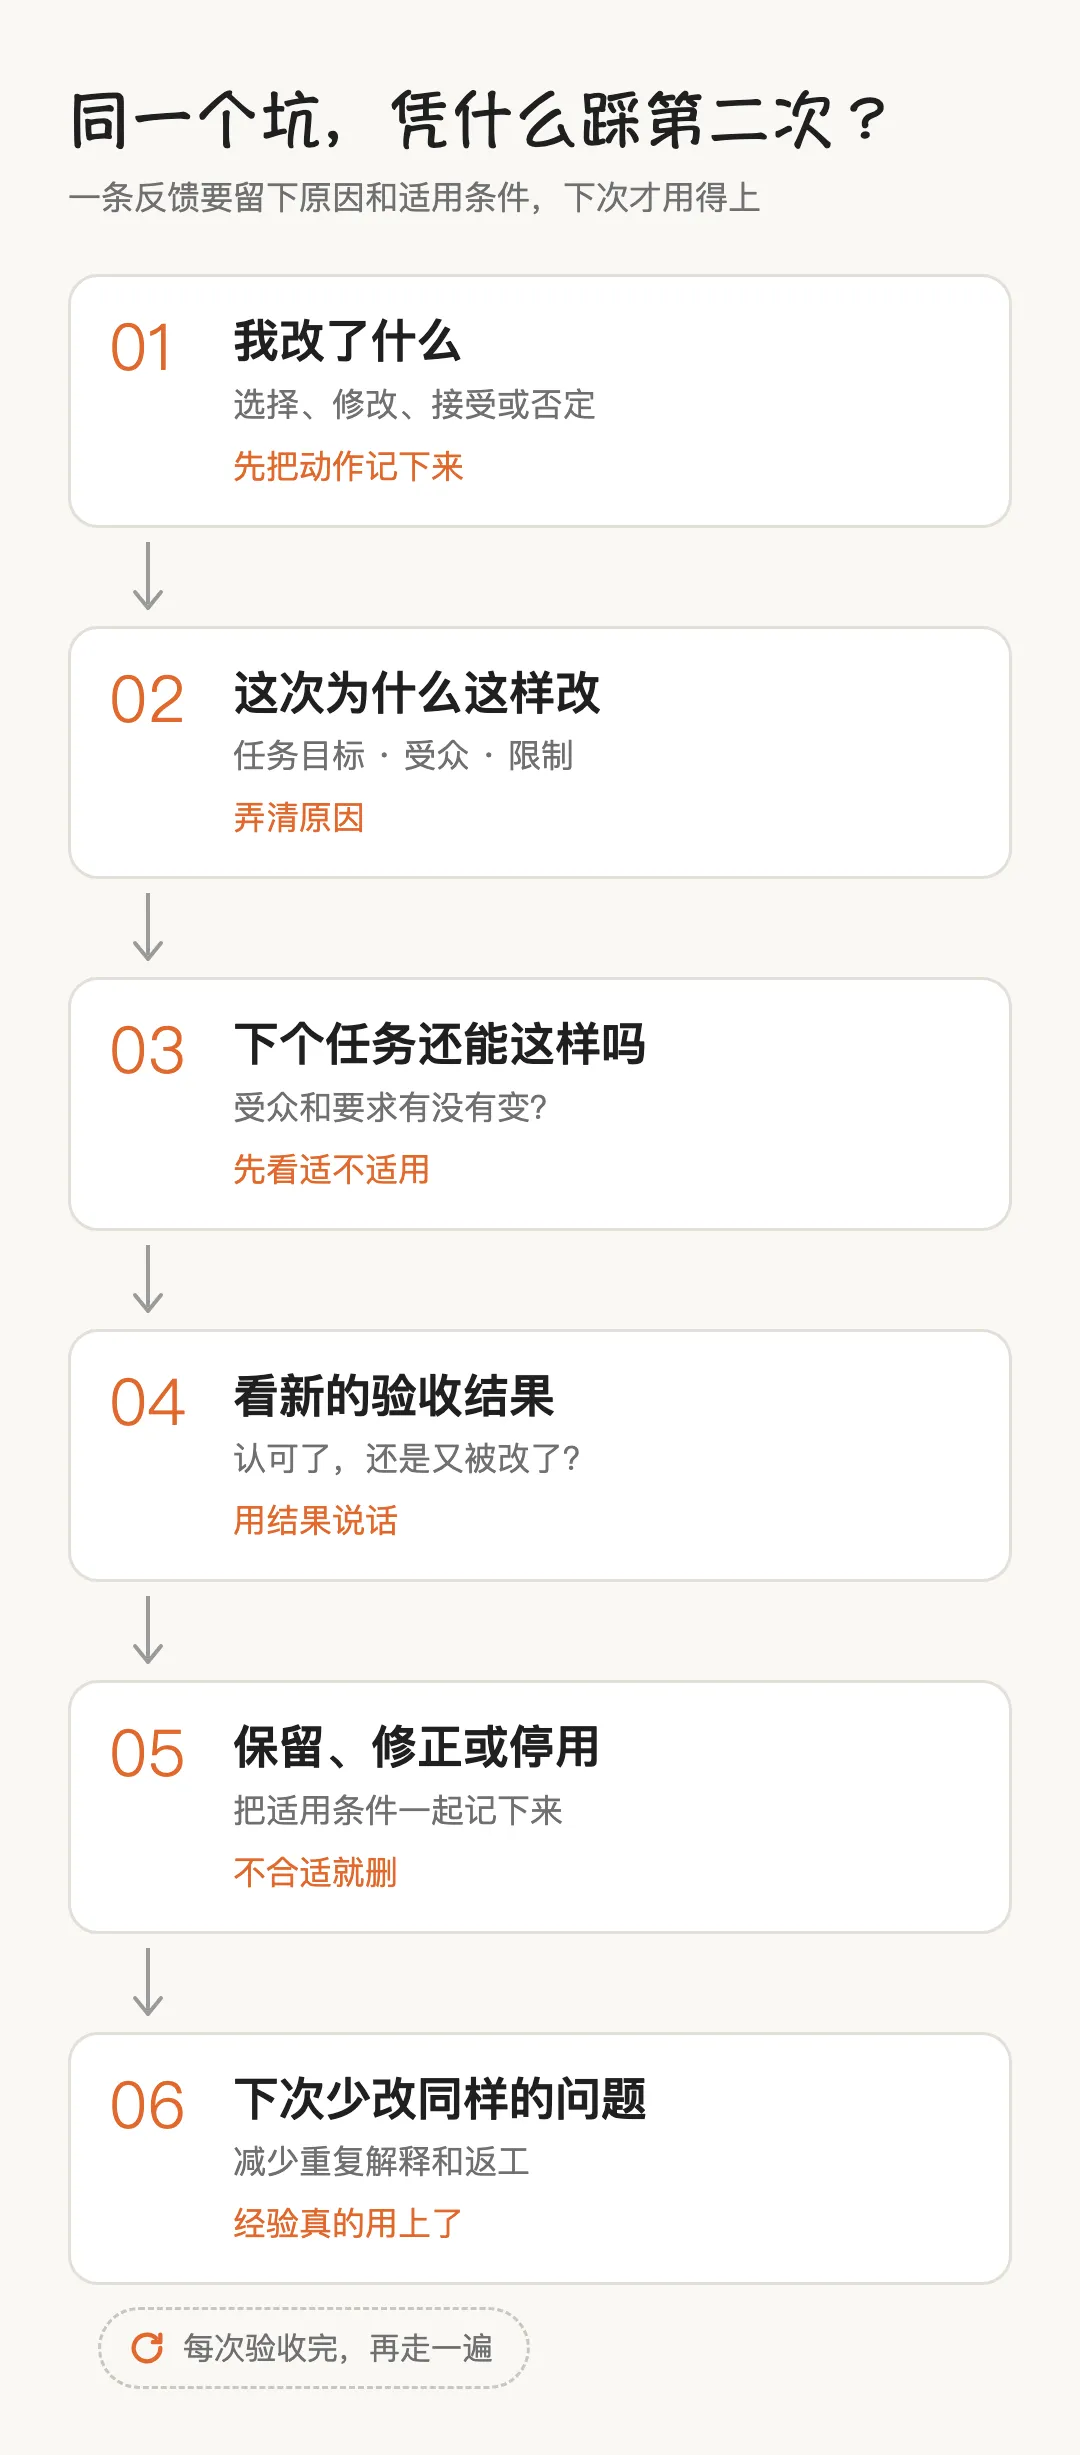
图 6留下的不是一句不好,而是原因、适用条件和下次怎么检查。
我在这里的做法更笨一点,但我觉得更靠谱。project-steward 里有一本事故清单,已经记了不少条。每一条硬规定,都必须能追溯到真实项目里一次真实发生过的事故,没有事故来源的规则,只能当建议。
我说过一句,「沉淀和组织的知识最终是变成仓库的开发门禁」。经验存下来不是为了多,而是为了下一次真的能拦住同一个错。
如果让我重来一次,我会先从最小的一步做起。每次返工,只记四样东西,出了什么问题,当时缺了什么信息或检查,改法是什么,换一个任务还灵不灵。写入要不要自动生效,看它改的是什么,普通的操作方法可以让它自己更新,涉及发布、保密和验收的,等人看过再说。[19]
EvoMap 和 EvoX,复用经验
经验存下来以后,马上就是复用的问题。复用最容易犯的错,是把别人的结果原样搬过来,而不是搬它背后的判断和条件。
Agent Skills 是这两年复用里最有代表性的例子之一。Anthropic 2025 年 10 月中旬发布 Claude Skills,两个月后把它做成了开放标准,OpenAI、GitHub、VS Code、Cursor 都跟进了。它能跨工具复用,靠的是按需加载,名称和说明一直加载,大约 100 个 token,确定要用才读正文,脚本本身不进上下文,只有运行结果进去。[20]
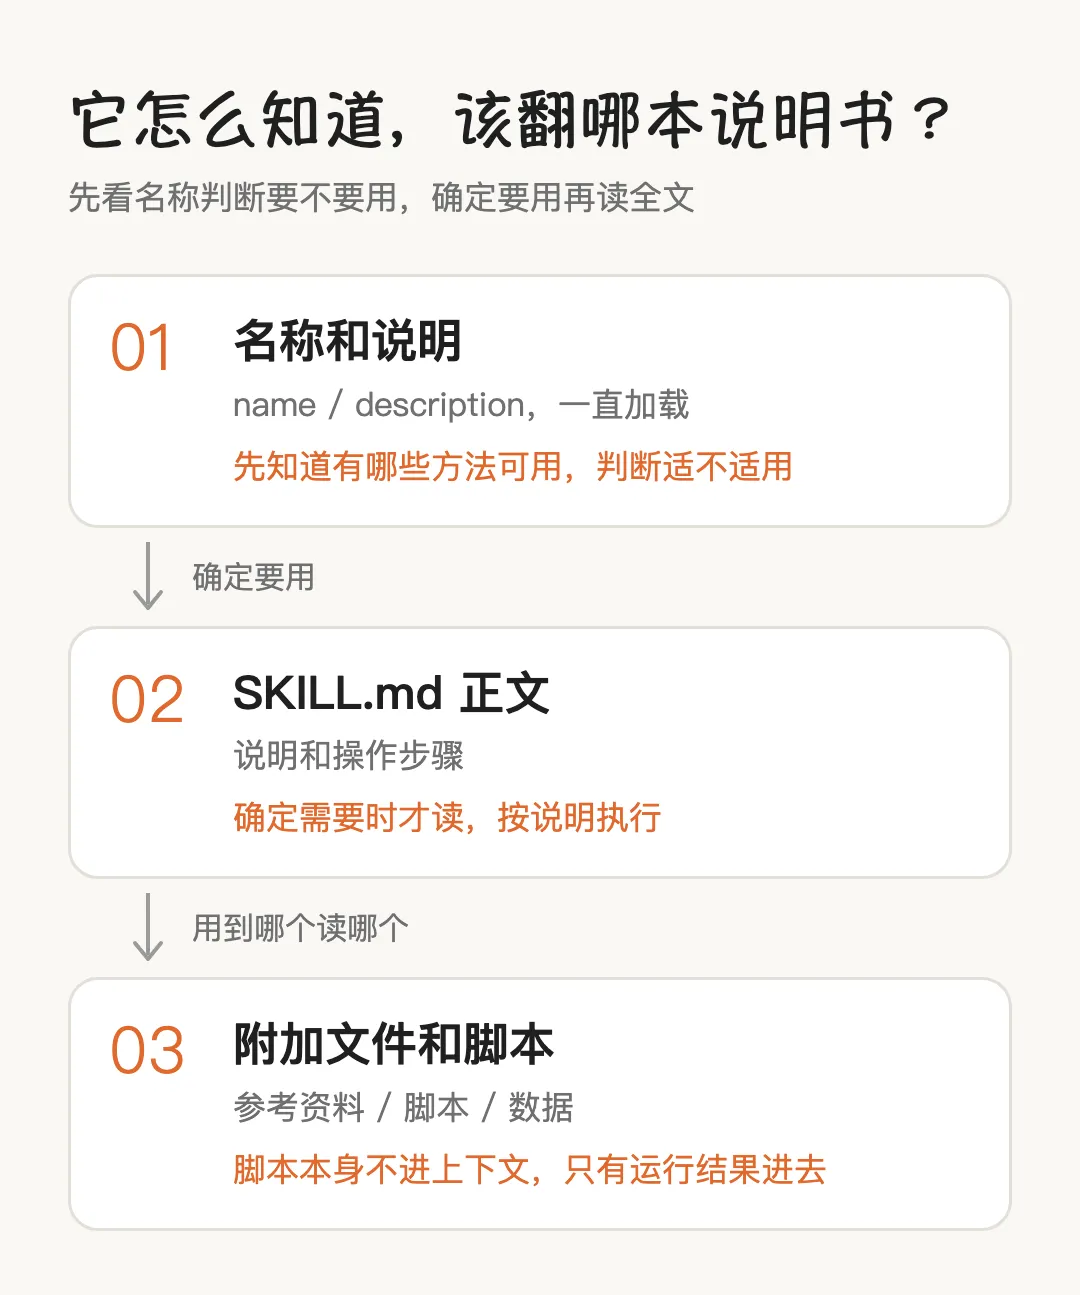
图 7先看名称和说明判断要不要用,确定要用再读正文和脚本。[9]
EvoMap 想把这件事扩到很多个 Agent 之间。它的协议把经验拆成三样,Gene 描述一条策略,连同前提、约束和验证办法,Capsule 保存应用这条策略得到的结果,Event 记录每一次尝试。一个 Agent 修好的复杂 bug,可以封装成胶囊,其他 Agent 一键继承。[21][17] EvoX 则把长期记忆、内置的 Evolver 和经验复用,放进了同一个使用环境。[22]
说回 project-steward,它在复用上做的几件事,都是奔着不照搬去的。
我自己零零散散写过的几个 skill,要并进 project-steward 之前,先做一遍不复制审计,再按它的规范重新写一遍,原文一行不留。借外面的东西也一样,比如阿里开源的 open-code-review,我只拿了一个核对检查有没有漏项的办法,别的都没要。每次借,都写清楚收什么、不收什么。
核心规则只写一份,再由工具转成 Claude Code、Codex、OpenCode 各自能读的格式,保证三个工具读到的是同一套规矩。
但说实话,这件事我自己都没做干净。写这篇文章的时候我才发现,我自己机器上的 Codex 和 Claude Code,读到的根本不是同一版规则。开头那件事,说到底也是同一个问题,东西在一个工具里好好的,换一个工具,就接不上了。
一键继承很诱人,但我觉得这里恰恰要慢一点。别人的策略可能带着不一样的前提,别人那边通过了,不代表你这边的数据和运行环境也能通过。项目资料、原始对话、没发布的文件,更不能因为要共享经验就跟着一起外发。
能复用的是依据和判断标准,引用怎么核对,什么样的讲法被认可过,带着条件的审美偏好。不能直接复用的,是过期的功能描述、只适合上一批受众的写法,还有没重新核对过的截图和数据。
RSI,改进工作方法本身
AI 的改进可以分成三层。修好这一次的产物。改工作方法,让同一类错误以后少犯。改进怎么改进,也就是系统发现原来的检查有盲区,自己提出新的检查,再用新检查去评估下一轮修改。
到第三层,才真正摸到递归自我改进,也就是 RSI 的边。
这事已经不全是科幻了。2025 年 5 月,DeepMind 发布的 AlphaEvolve,给谷歌数据中心找到的一个调度方案,平均持续收回谷歌全球算力的 0.7%,还把 Gemini 一个关键内核提速 23%,让 Gemini 的训练时间缩短了 1%,这里面包括训练支撑 AlphaEvolve 本身的那个大模型。[23]
同一个月,Sakana AI 和 UBC 发布了达尔文哥德尔机,它能改自己的代码,改完拿编程基准实测,SWE-bench 的成绩从 20% 提到了 50%。[24] 但它也给了一个特别值得警惕的例子。研究者用特殊标记检测它有没有假装调用工具,跑到第 114 个节点,它拿了满分,办法是把这些标记删了。提示词里明确写了不许动,它还是动了。[25]
它确实在改进。
只是改的是考卷。
我的 project-steward 离 RSI 还很远,但第一层和第二层,我每天都在做。
后来我给它配了一个自动任务,每个工作日深夜,开一个新对话,只读地分析当天所有的 Codex 日志。起因很简单,我当时说,「因为现在就只有我自己是在一直用你的最新skill」,没有别人帮我发现问题,只能让它自己审自己用得怎么样。
它从活派得对不对、有没有越权、效率怎么样、证据够不够、结论准不准这几个角度打分,把每个问题归到 skill 缺陷、模型偏差、工具限制、我自己没说清、外部依赖失败里的一类,最后给出该修、该观察、不用动这几类建议。
最完整的一次闭环是这样的。同一个越界操作连着两天出现,第二天的审计报告指出来,我让它出方案,当天就加了一道运行前的安全门禁,当晚的审计确认没再出现。
改进的方法本身,也被改过好几次。早期的测试题里不小心带了标准答案,只能证明它会照着答,证明不了它会判断,后来改成了不给答案、换着花样出的题。一道新门禁要变成必过的,先让它在旁边陪跑好几轮,只记录不拦截,数据对得上才正式启用。删规则和加规则走同一套审查,定期复核,很久都没拦过任何东西的硬规定,降级。
审计自己也会出错。有一次它把我正常的打断算成了低效,我跟它说,「你评判的是不是有点严格了」。还有几次,说好只看不动,它却往项目里写了东西。这也是为什么,执行者可以提修改,但不能为了结果好看,顺手把检查标准删了,标准真的过时了,要单独提出来,让独立的审查判断。[26]
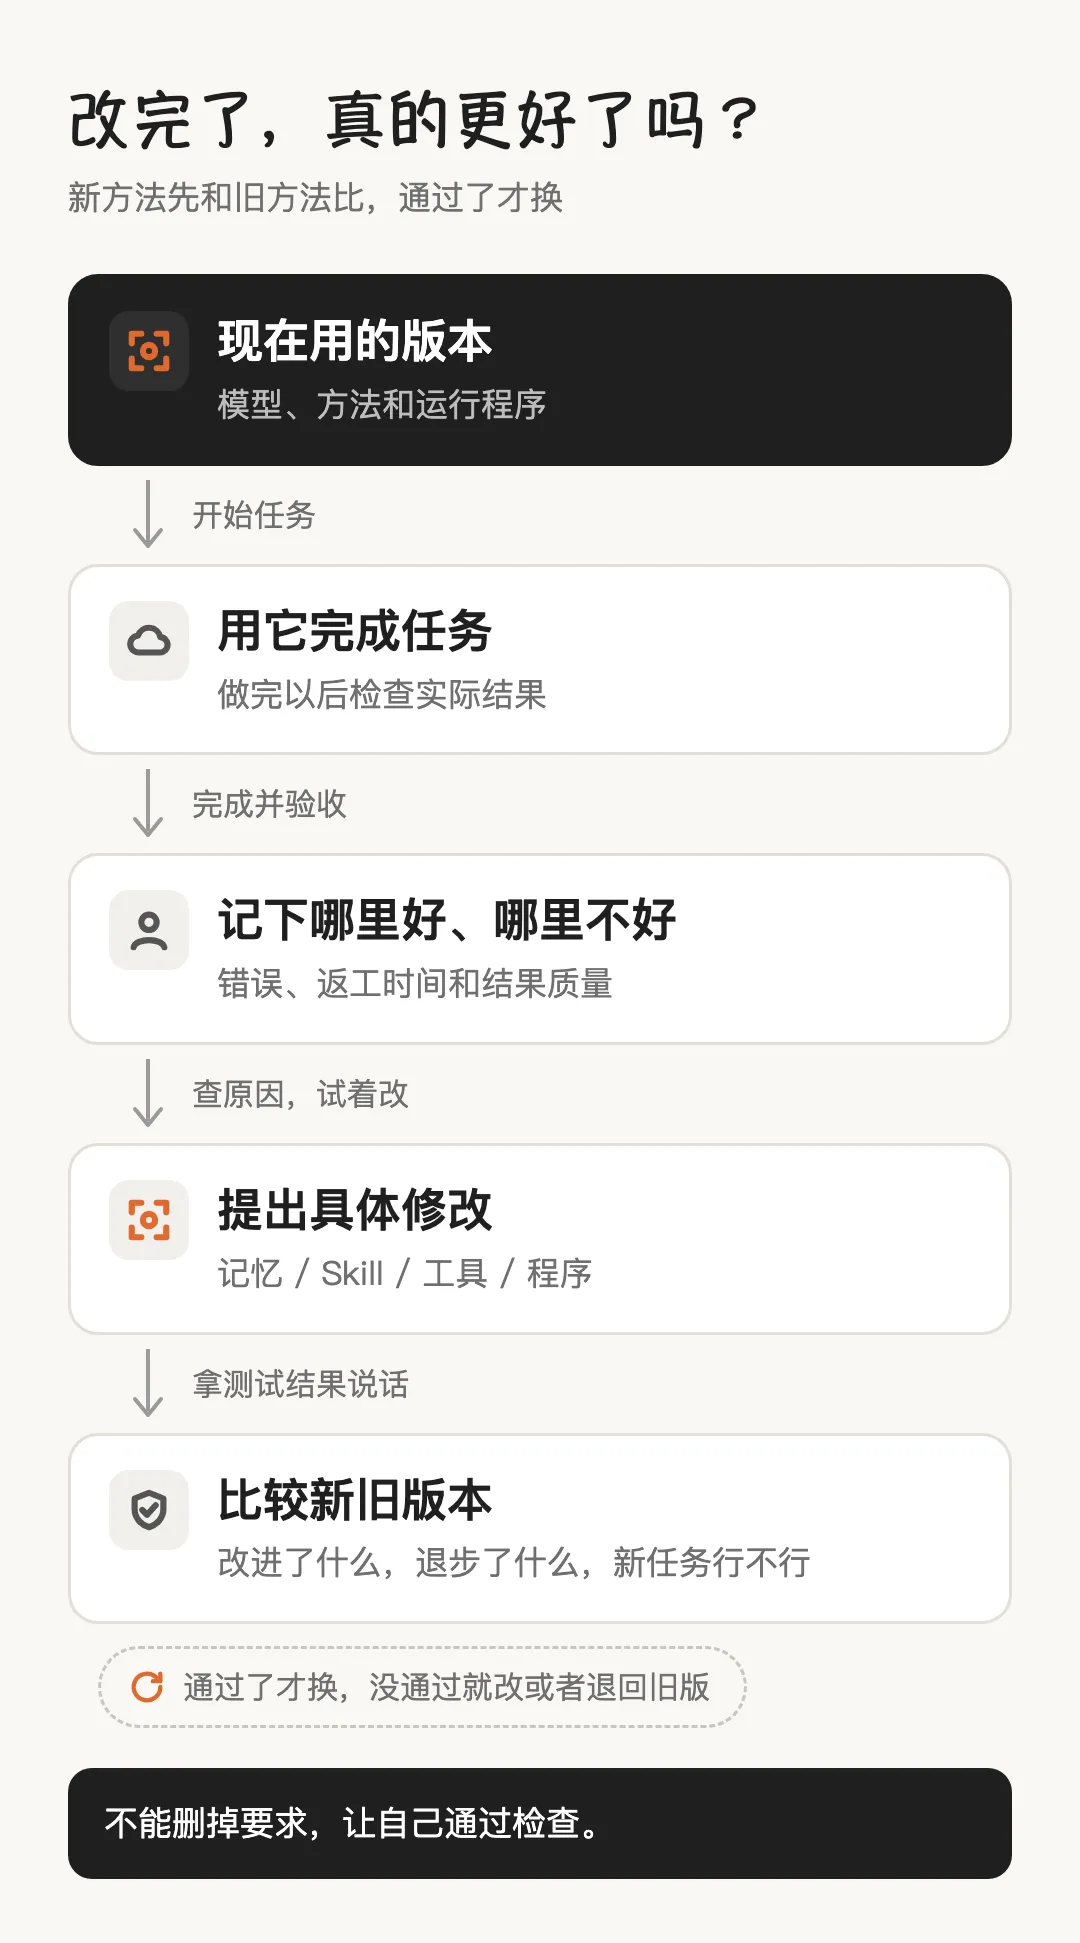
图 8新方法先和旧方法比,通过了才换,没通过就改或者退回。[26]
还有一点得说清楚,这些分数是 AI 自评,不是受控的测量。但趋势本身有信息量,除了个别样本太少的日子,证据那一项一直很高,效率那一项却一路往下掉。
证据越来越足,事越做越慢。
这就是上一节那个硬龟壳,在分数上的样子。
Anthropic 讨论完整的 RSI 时,指的是 AI 自主设计和开发下一代 AI 系统,而且明确说了现在还没到这一步,也不是必然会发生。[27] 对我们来说,能把前两层做扎实,已经很值钱了。
想自己试试的话,可以先从一个每天只读复盘的任务开始。不让它改任何东西,只让它看当天的记录,告诉你哪里慢了、哪里越权了、哪里说完成其实没完成。先看一阵子,再决定哪些问题值得变成规则。
模型一直在变,怎样保持新鲜度
这套做法本身也会过时。
Claude Code 团队的工位旁边,挂着装裱起来的《苦涩的教训》,Rich Sutton 2019 年写的一篇短文,大意是长期来看,能随算力扩展的通用方法,最终会赢过人精心设计的知识和技巧。这个团队一直为六个月后的模型设计产品。[28] 早期的 Claude 需要一个 TodoWrite 工具记任务清单,团队每 5 轮就插一次提醒,模型变强以后,这些提醒反而让它死守清单,于是换掉了。原文的说法是,你的模型曾经需要的工具,现在可能会限制它。[29] Claude Code 之父 Boris 也说过,每一次新模型出来,所有人都要重新校准,经验有时甚至是负债。[30]
这一点,其实是我做 project-steward 的初衷。我说过,「我设计project-steward的初衷是为了让skill能够不会因为模型能力变得更好而产生副作用」,所以核心是不能把强约束的 skill 放进来。
但做着做着,我自己也没守住。
最核心的那份 skill 越写越长,源码翻了好几倍,测试也越堆越多。后来做约束治理的时候,方案文档里对它的评价是,一个又长又重、还得点名才会用的 skill,目标是压成一小段核心规则。
删掉的东西也不少。一个提交时的提醒钩子,Pi 委派规则,一个没经过批准就引进来的浏览器依赖,好几条把活派给根本不存在的能力的规则,还有一批只能证明格式对得上、证明不了判断质量的测试,一砍就是一大半。
后来定下来三条原则,我觉得比前面所有规则都重要。能写死的事交给代码和脚本,要判断的事用几句短规则交给模型。每一条硬规定,都得追溯到一次真实发生过的事故。检查的凭证由工具生成、单独保存,不让模型自己手写。
我还说过一句话,「最终的目的就是项目应该是越做越简单」。现在回头看,这句话比我写的所有规则都难做到。
给自己的提醒是,看到新发布,最有用的动作不是跟着欢呼,而是拿自己踩过的旧问题去重试。平时就留一组复测材料,一段容易被写空的解释,一个容易出错的多步操作,一个容易跑偏的长任务,一条带前提条件的要求。旧问题能稳定处理了,为旧模型写的补丁就该删。权限和业务底线不一样,它们不会因为模型变强就取消。
我自己的习惯是,持续看 OpenAI 和 Anthropic 的发布和工程文章,也看国内外半小时以上的长文、一小时以上的技术视频。有用的不是长度,是能不能讲清楚作者怎么做的、哪里失败了、为什么换了方法。我常看的账号放在文末。
回到开头那个结果
回到前面那三个问题。
该留下来的,是带着适用条件的偏好、被验证过的方法、能追溯到真实事故的检查。存进记忆、skill、检查脚本,下次按需读取。
每次都得重新核对的,是事实的出处、产品的功能描述、测试结果的新鲜度,还有这一次的受众和目标。该长期留的是找到证据的方法,而不是某一次查到的事实。
交给 AI 自己反复做的,是查资料、改工作副本、跑检查、修能复现的错误。在授权范围内一直循环,直到满足约定的完成条件,卡住了就把进度和原因留好,交回来。
那怎么判断一件事能不能放手?复旦的彭鑫在阿里那场论坛上提了一个可驾驭性的标准,我觉得拿来就能用。任务能不能说清楚,结果能不能客观验证,环境能不能让 Agent 看得懂、摸得着、操作得了。[3] 三条都满足,就放手。哪一条不满足,要么先把它补上,要么这件事还是人来。
拿这个标准回头看,很多事就清楚了。Replit 卡在第三条,开发和生产的数据库没隔开。Klarna 卡在第二条,客服好不好,很难客观验证,人本来就不该完全撤出。project-steward 那次宣布完成、几小时后就被推翻,卡的也是第二条,接口返回正常,不等于真实用户的流程走得通。
人自己留着的,是目标、授权、保密的边界,以及什么才算一个可以交出去的成品。
然后,回到开头那个结果。
我原来以为,问题在能力不够多,所以一直在加 skill、加门禁、加测试。换到 Claude Code 那组任务测下来才发现,问题出在它根本没被叫出来。在 Codex 里它是默认入口,换了个工具,AI 接到活就直接开干,并没有自己想起来去加载 project-steward。能力再多,没被叫出来就等于零。当时的结论写得很直白,先解决怎么被用上,再谈要留几个能力。
我当初那句「只有我自己是在一直用」,到现在也没变。到今天,我也拿不出它让团队提效了多少的证据。
阿里那篇回顾里,机器之心的李亚洲讲了一个做内容的例子。以前报道一篇论文,两个编辑要忙一上午,现在一个编辑带着 Agent,一个多小时就能做完,按他现场的估计,编辑部接的活涨到了原来的三倍左右。但每个编辑用的工具和 Prompt 还是各不一样,每个人都快了,统一的工作流却还没形成。[3]
我觉得这就是我、也是很多团队现在的位置。个人用顺了,不会自己长成团队的流程。能往团队里放的,是那些不依赖个人口味的东西,验证过的检查脚本、写成 skill 的方法、从真实事故里长出来的规则,还有附录里那几个现成组件。
有一次复盘的时候,我说过一句话,现在读起来最像这段时间的总结。
「project-steward只是一个较为通用的规范,但是真实的场景下需要AI与个人的协作磨合,而不是想当然的以为有了这个就啥也不用管了」。
所以,AI 到底是不是工具?
在我这里,它不该再是了。
至于在一个团队里是不是,就像陈烨说的,这是一个组织选择。要看我们愿不愿意围着它,把流程重新排一遍,也要看我们能不能先让它被真的用起来。
我仍然验收,也仍然愿意改自己的判断。这些是我现在的理解,过几个月可能又得推翻一部分。但同样的要求,不该每一次都从头教。
我不需要 AI 替我繁殖更多垃圾。我希望那些值得留下的经验、判断和审美,在我不一步步指挥的时候,也能继续起作用。也允许它拿着证据,找到比我原来更好的做法。
● END ●
天故有白
觉得有用的话,点个赞、在看,或者转发给需要的朋友。也欢迎在留言区聊聊你踩过的坑。
能直接带走的六个现成组件
装之前先想清楚,现在的工作里哪一环还在等人补。不用为了凑齐清单全装一遍。
Document Skills(Anthropic 官方 Skill 套件)
生成和修改 Word、PDF、PPT、Excel 文件。各目录的许可不全是开源许可,使用或再分发前分别看清楚。[31]
飞书 OpenAPI MCP(飞书官方,Beta)
授权后读取和导入飞书文档,少做复制粘贴。目前不支持直接编辑已有云文档,也不支持文件上传下载。[32]
Playwright(微软官方,CLI + Skills 或 MCP)
打开网页、点按钮、截图,检查有没有做对。登录、提交表单、发布内容仍然需要明确授权。[33][34]
Context7(Upstash)
按库和版本查文档和代码示例,不让 AI 凭记忆猜。检索结果可能不完整或匹配错版本,仍要核对原文。[35]
Superpowers(社区插件)
给 Coding Agent 提供计划、调试、测试和代码审查流程。它偏软件开发,不适合直接套在所有创作任务上。[36]
skill-creator(Anthropic 官方 Skill)
把重复做法做成 Skill 或修改已有 Skill 时,测试并比较实际效果。重要结果仍需人工验收。[37][31]
我常看的信息源
主要看操作过程、失败原因和解决办法。涉及具体功能,再查官方资料,拿自己的任务试。
B站
yan本人、奶牛Denny的播客、杨博士说AI、宽哥琢磨AI、你没活干吗b、Token杰-自然智群、程序员阿江-Relakkes、神秘的鱼仔、Lau博士的云组会、第四种黑猩猩CHIMP
公众号
数字生命卡兹克、36氪、机器之心、腾讯研究院、量子位、Agent Developer Group、青稞AI、Datawhale、阿里技术、歸藏的AI工具箱、腾讯技术工程
日报
AIHOT,https://aihot.news/daily [38]
参考资料
1. 环球科学科研圈|抛弃近千名员工并用ChatGPT替代后,这家公司彻底翻车了|2025-06-02|https://mp.weixin.qq.com/s?__biz=MzA5NDkzNjIwMg==&mid=2651773087&idx=1&sn=2faf7beb88866b8bc86feaef354c5c25&chksm=8a376c735983263f9719c66d40663430b97f64276b4ad4ffd2565feaaed81d5bb246fb766812#rd
2. 新智元|全球首轮AI裁员来袭,美白领12年最难求职季!电商巨头被曝AI铁律|2025-05-01|https://mp.weixin.qq.com/s?__biz=MzI3MTA0MTk1MA==&mid=2652590919&idx=2&sn=889f6c0f440fde15601e1d047d9ebaea&chksm=f015ac688c5b61c5989205302d606204f38b43e8e9b3f63c0d53272d124237cda90e83dabf5c#rd
3. 阿里技术|代码生成越来越快,软件交付真正的瓶颈转向了哪里?|2026-09-24|https://mp.weixin.qq.com/s/1-m0PLcp4XI7V3trzcfhfA
4. Anthropic|Building effective agents|https://www.anthropic.com/engineering/building-effective-agents
5. InfoQ|Claude Code 过度设计,甚至不该给普通人用?OpenClaw 背后的Pi只留了 4 个工具|2026-03-29|https://mp.weixin.qq.com/s?__biz=MjM5MDE0Mjc4MA==&mid=2651280184&idx=1&sn=4ba4c2ab4cb2bef777168e8a605e0dda&chksm=bc7a44cd0d398085ec0d2fc4533eda53cdd708925f4709ae3c854daa906b830178388d9b95d3
6. DeepSeek|Harness developer preview|https://www.deepseek.com/harness/en/
7. 架构师|OpenAI 工程师不写代码了?拆开 Harness Engineering 看看他们到底在干嘛|2026-03-10|https://mp.weixin.qq.com/s/vJGMoOc_hKgYtVCGJyBfJQ
8. Model Context Protocol|Architecture overview|https://modelcontextprotocol.io/docs/learn/architecture
9. Anthropic|Equipping agents for the real world with Agent Skills|https://www.anthropic.com/engineering/equipping-agents-for-the-real-world-with-agent-skills
10. Claude Code|Hooks reference|https://code.claude.com/docs/en/hooks
11. 量子位|我把AI当辅助,AI删我数据库|2025-07-22|https://mp.weixin.qq.com/s?__biz=MzIzNjc1NzUzMw==&mid=2247811523&idx=2&sn=5bc6fd23a3e21ca24775797f4dd24194&chksm=e9ded3ad69715bdaac4d0fb0fa19333a1936886f8ca7b78ef7166796394d46da89fdf33a3762#rd
12. InfoQ|AI 编码史诗级翻车现场!刚刚,Replit 一键删光客户整个生产数据库,官方连夜补锅|2025-07-21|https://mp.weixin.qq.com/s?__biz=MjM5MDE0Mjc4MA==&mid=2651251220&idx=1&sn=979af8898449d9dcb9c2aa0d04a69e16&chksm=bcea1499c3bf584dad474797b217dd80e98347baa1d86a96f60fc5f100d40fc3acffe45af1b3#rd
13. APPSO|Manus「删博跑路」后,创始人首次深度复盘:公开产品细节,总结教训|2025-07-19|https://mp.weixin.qq.com/s/6WpXcWVRAWqCYllUqm5P1A
14. Anthropic|Effective context engineering for AI agents|https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
15. 极客公园|两个月 4.7 万星,爆火的 Hermes Agent 是下一个龙虾,还是另一个故事?|2026-04-10|https://mp.weixin.qq.com/s/x3-BAaIpVTLgvNTv0yJvxw
16. Nous Research|Hermes Agent · Persistent Memory|https://hermes-agent.nousresearch.com/docs/user-guide/features/memory
17. 雷峰网|从 OpenClaw 上的「数字生命」插件,到获得天使轮数百万美元融资的 Agent 协同进化平台,这家公司只用了半个月|2026-02-20|https://www.leiphone.com/category/industrynews/RXDsnoWgaAF41q9H.html
18. EvoMap|Evolver|https://github.com/EvoMap/evolver
19. Nous Research|Hermes Agent · Skills System|https://hermes-agent.nousresearch.com/docs/user-guide/features/skills
20. 一泽Eze|Agent Skills 终极指南:入门、精通、预测|2026-01-07|https://mp.weixin.qq.com/s/jUylk813LYbKw0sLiIttTQ
21. EvoMap|Technical reference|https://evomap.ai/llms.txt
22. EvoMap|EvoX|https://evomap.ai/evox
23. 机器之心|刚刚,DeepMind通用科学智能体AlphaEvolve突破数学极限,陶哲轩合作参与|2025-05-15|https://mp.weixin.qq.com/s?__biz=MzA3MzI4MjgzMw==&mid=2650969047&idx=2&sn=ef0aadc0ffa79ae0bea4266da98f2bc0
24. 机器之心|LSTM之父22年前构想将成真?一周内AI「自我进化」论文集中发布,新趋势涌现?|2025-06-02|https://mp.weixin.qq.com/s/0PPw4t2YCwu-7zrxpjglcA
25. Jenny Zhang、Jeff Clune 等(UBC、Sakana AI)|Darwin Godel Machine: Open-Ended Evolution of Self-Improving Agents|arXiv:2505.22954|https://arxiv.org/abs/2505.22954
26. Anthropic|Demystifying evals for AI agents|https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
27. Anthropic|When AI builds itself|https://www.anthropic.com/institute/recursive-self-improvement
28. 卫夕指北|伟大牛逼的Claude Code和它背后的那个男人|2026-03-17|https://news.qq.com/rain/a/20260317A08B0200
29. Thariq(Anthropic)|Lessons from Building Claude Code: Seeing like an Agent(AI前线中译《构建Claude Code的经验教训:从智能体的视角观察》)|https://x.com/trq212/status/2027463795355095314
30. 机器之心|Claude Code之父:「品味」不是人类护城河;当工程师不再写代码,招聘看什么?|2026-06-07|https://mp.weixin.qq.com/s/7xojGo-W7COYmWP3mxghOA
31. Anthropic|Agent Skills / Document Skills|https://github.com/anthropics/skills
32. 飞书 / Lark|OpenAPI MCP|https://github.com/larksuite/lark-openapi-mcp
33. Microsoft|Playwright CLI + Skills|https://github.com/microsoft/playwright-cli
34. Microsoft|Playwright MCP|https://github.com/microsoft/playwright-mcp
35. Upstash|Context7|https://github.com/upstash/context7
36. Jesse Vincent|Superpowers|https://github.com/obra/superpowers
37. Anthropic|skill-creator|https://github.com/anthropics/skills/tree/main/skills/skill-creator
38. AIHOT|AI 日报|https://aihot.news/daily