ARTICLE · 1096188
AI 编码工具让提交多了 240%,发布只多了 30%?
三位研究者在 2026 年 9 月修订的论文 Writing Code vs. Shipping Code 中,把这个问题沿着软件生产链追到了最后。研究估计:从代码补全逐步用到交互式、异步编码 Agent,开发者的代码提交数累计增加约 240%;参与的项目数增加约 80%,正式发布次数只增加约 30%。
这不是“AI 没提高效率”。更值得追问的是:多出来的工作去了哪里?
先看清楚,这三个数字各在数什么
论文结合公开 GitHub 活动和部分工具使用记录,识别出 52 万多名符合活跃条件的工具采用者;各指标的分析还会进一步筛选样本。作者为采用者匹配此前活动水平接近的开发者,再比较采用工具前后的变化。为了减轻对照组私下使用 AI 的影响,对照活动取自工具大规模出现前一年的相同日历周。这是匹配事件研究,有多种稳健性检查,但不是把开发者随机分配去使用某种工具的实验。
研究把代码行、文件、提交、PR、参与项目和发布看作不同层级的产出。它们不是同一个指标的六种叫法:提交能反映编码活动,发布更接近可以交到用户手里的软件。图中只取论文 Figure 1 里三处最能说明差别的数字。
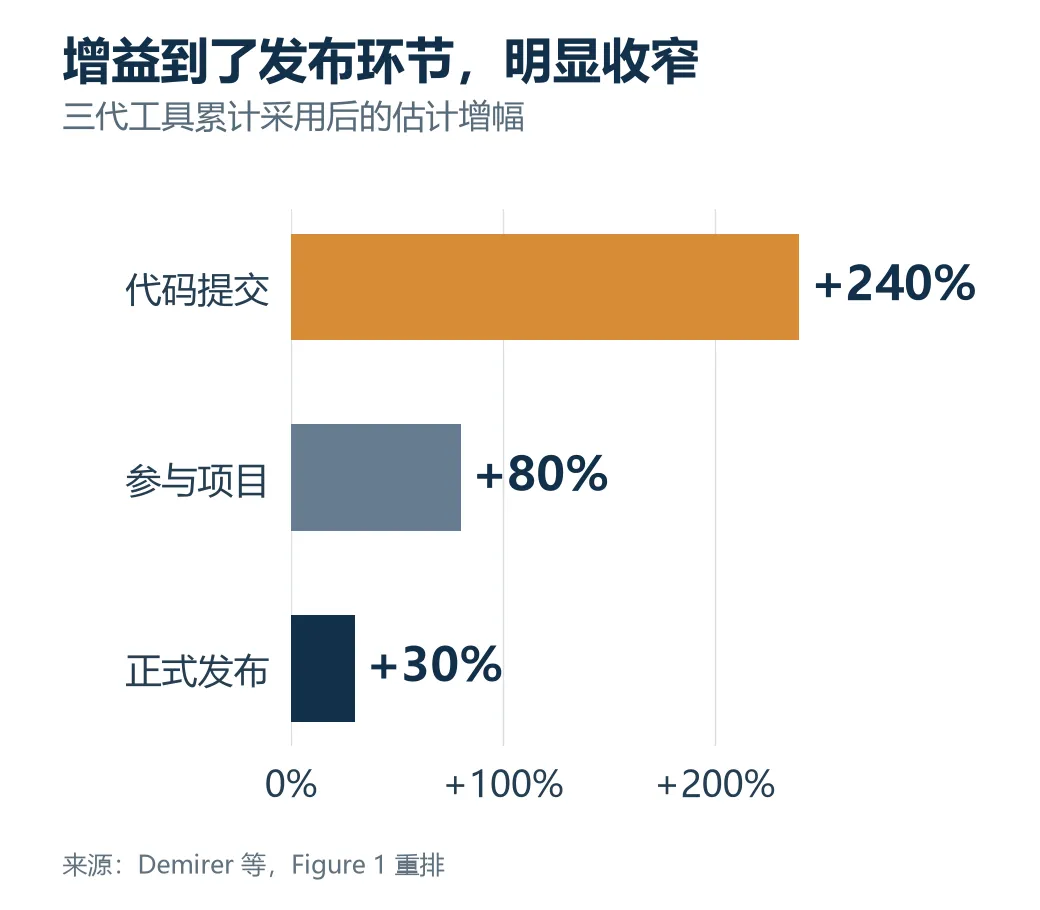
240% 也不是“每个程序员都快了 240%”。 它是研究样本在特定工具采用路径上的平均估计,衡量的是每周提交活动;30% 衡量发布次数。两者不能直接相减,算成“有 210% 的代码被浪费”。一次发布可以包含多个提交,软件价值也不能只用发布次数衡量。
增长为什么在后半程收窄
编码工具首先减少写代码、改文件的成本。改动随后还要被理解、测试、审查、合并,最后才可能形成可发布版本。研究发现,越靠近这个末端,活动增幅越小。这符合一个直观的生产约束:上游产出增加后,如果下游的人力和流程没有同步扩容,交付不会等比例增长。
但“审查堵住了发布”还不是论文唯一解释。多写的代码也可能成为更多试验:开发者更便宜地探索方案,最后只保留其中一部分。作者专门检查了“每次发布变得更大”和“试验更多”这两种机制。前者确实存在,却只能解释一小部分收窄;更多证据指向后者。
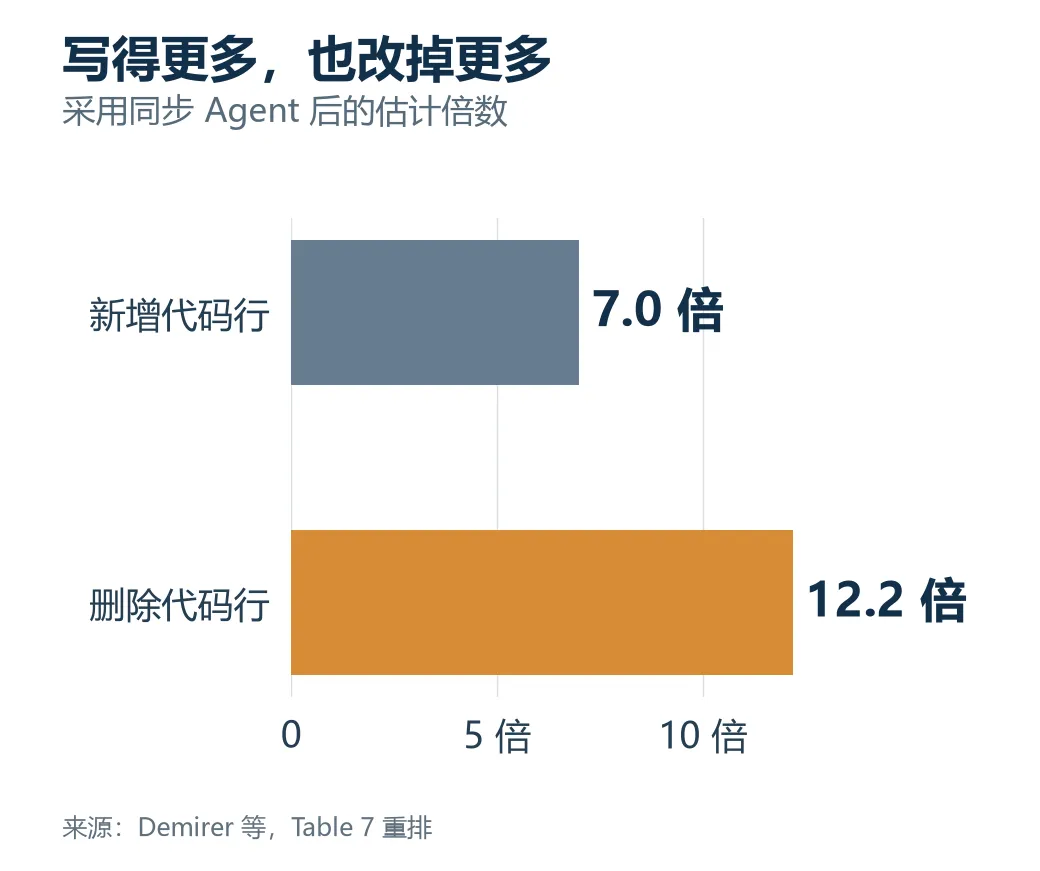
例如,在使用交互式 Agent 的样本中,论文估计新增代码行数约为采用前的 7.0 倍,删除代码行数约为 12.2 倍;新建分支增加约 79%。这说明更多工作被尝试,也有更多工作被改写或舍弃。删掉代码本身未必是坏事;原型被淘汰、错误方案被撤回,也可能是有效研发的一部分。
还有一个更长时间的背景变化:研究追踪的仓库中,创建后首月再无活动的比例,从 2021 年的 60% 升至 2026 年的 69%。这条趋势与试错增加相符,但它跨越多年,不能单独证明是 AI 导致了仓库被放弃。
软件发出去了,用户买账了吗
论文还看了 Apple App Store、Google Play、Chrome Web Store 和 SourceForge 四个平台。2025 年初之后,新应用数量明显上升,月新增量平均约翻倍;但新应用的总下载或评分等参与指标没有随之上升。作者也观察到,几乎没有用户的新应用所占比例提高。
这一步让“发布”也显得不够靠终点。一个版本上线,只说明供给增加;有没有解决用户问题,还得看采用、留存和实际使用。论文无法在现有数据中区分两种可能:边际新增应用质量不足,或好应用仍卡在发现和分发环节。把所有无人使用的应用都说成“AI 垃圾”,证据并不支持。
对开发团队来说,这也是一个测量提醒:提交数、PR 数、发布数、用户结果是一条链,不是四张可以互相替代的成绩单。
团队该改哪一段
如果你正在评估编码 Agent,先选一类真实任务,按同一批改动记录四件事。
交付速度:从需求明确到用户可用的周期,而不只是 Agent 完成写码的时间。人工成本:澄清需求、审查、修改、测试、处理回滚各花多少时间。
通过质量:PR 合并率、回滚和线上缺陷如何变化,哪些失败在测试中才被发现。用户结果:发布后的采用、留存或任务完成情况,而不只统计发布次数。
然后看哪一段排队最久。如果 PR 在审查处积压,就先改善验收条件、测试证据和审查分工;如果版本上线后没人用,就回到需求验证与分发。继续购买更快的生成能力,未必能解决已经暴露在下游的约束。这是根据论文结果提出的工程判断,不是论文替所有团队测出的最优流程。
这项研究的局限也很清楚。样本主要是公开 GitHub 项目和四个软件市场,对企业内部代码覆盖有限;工具能力和工作方式仍在变化;匹配设计虽努力处理采用者原本更活跃的问题,仍无法像随机试验一样排除所有未观察到的差异。论文的 9 月修订版还更新了样本和若干估计,早期报道中的 180% 提交增幅 与新版的 240% 不能混成同一组结果。
真正值得带走的问题很朴素:当团队宣布“AI 让编码快了”时,下一句要问的是——快出来的东西,最终走到了哪一步?