ARTICLE · 1100335
从“问AI”到“组织AI”:我用了半年才明白的事
从“问AI”到“组织AI”:我用了半年才明白的事我很早就用过ChatGPT,它刚出来的时候我就下载了,最让我新奇的是可以直接语音聊天。聊了几句,觉得有意思,和媳妇分享,然后就没有然后了。我没想过它能为我的学习、工作做什么。 现在回头看,那时的我算是“用过AI”,但谈不上理解AI。真正的变化,发生在2026年3月。 01 从“试过”到“研究” 那个月我读到一篇文章,作者过去一年在AI上投入了不少时间和费用,也确实做出了东西。具体内容我已经记不清了,但触动很直接:与其站在外围看,不如自己付费、自己实践。 于是我订阅了Claude,开始认真研究怎么用AI。 很快我发现,自己此前最大的误解,是把AI当成一个更聪明的百度:想到问题,问一句,拿到答案,关掉对话。这当然也是一种用法,但如果只停留在一问一答,AI能创造的价值其实很有限。 02 《诗经》项目:AI第一次进入项目 第一次让我明显感到不一样的,是一件和AI看似无关的事:读《诗经》。 我一直有写读书笔记的习惯。读《诗经》,一篇笔记要走完一整套流程:读原文,查文献、对照不同参考书,比较各家解释,形成自己的理解,最后整理成文。做完一篇,通常要三个小时左右。 后来我在Claude里创建了一个专门的《诗经》Project:写好Project Instructions,参考资料放入Files,围绕这本书逐渐积累的上下文。同时,我重新划分了自己和AI的分工。 读书这件事,还是要我自己来。阅读、理解、思考,以及形成真正属于自己的心得,仍然由我完成。AI负责整理资料、搭结构,再根据我的想法起草初稿。 这样分工之后,一篇笔记的时间从三小时左右压到了半小时左右。 但比“三小时变半小时”更重要的,是另一个变化:AI第一次从“我偶尔去问问题的工具”,变成了一个持续存在的项目伙伴。 之后我开始琢磨Project该怎么用:Project Instructions 怎么写,Files放什么最合适,上下文的Token限制是多少,同一个Project里的不同Chat能不能分工,比如一个负责创作,一个负责审校,一个负责资料研究。 那段时间,市面上很流行卖Prompt的玩法,各种付费模板、课程广告满天飞。殊不知Prompt只是AI的一部分,除此之外还有Project Instructions、Files、Memory、上下文和工作流。 总之,AI开始为我稳定创造价值,不是因为它回答得更聪明,而是因为我把它从一次性问答,放进了长期项目和工作流。 03 用得越深,越想手搓一个自己的AI 3月起我的主力是Claude,5月开始订阅ChatGPT,也一直在用Gemini、Grok;国内的DeepSeek、Kimi、Qwen、GLM、豆包也都用过不少。 起初我想在国产LLM中选一个合适的AI使用,希望它们有Project 功能,可以长期工作。但用了一遍才发现,国产AI对C端极其不友好——这不是说国产模型不够强,而是在我实际使用的那些版本里,产品形态更偏向“一问一答”:打开聊天框,问完一个再问下一个,缺少类似Project的长期空间,上下文也容易断裂。比如Qwen,我三天前聊过的内容,三天后接着聊,它可能已经不知道前面发生了什么,甚至会一本正经地编出一个答案来。 于是,我开始手搓个人AI了。 
Rowan AI 登陆界面 在动手做Rowan AI之前,我还曾重仓过飞书Aily。后来飞书和豆包合并,产品用起来不顺手,我就放弃了。 此后,我开始做Rowan AI:一个更接近海外成熟C端产品形态的国内AI产品,有Project功能,有Project Instructions,有持续上下文,能围绕长期任务持续工作。我注册了域名,买了服务器,订阅了DeepSeek、Qwen的API。 这件事对我的影响很大。我第一次从“选择别人做的 AI”,走到“按自己的理解做一个AI产品”,也开始反过来想:一个好用的AI产品,到底应该具备什么? 同时,我也没把探索限制在知识工作上,还研究过AI漫剧、AI写小说、AI画图。这些方向其实是同一件事:不断试探AI的能力边界,看它能进入哪些原本属于人的生产和创作过程。 04 下一步:进入真实工作,但不把自己绑在任何一家 既然AI能进入一个长期读书项目,为什么不能进入真实工作? 于是我开始研究AI办公:WorkBuddy、QwenWork、Cowork、ChatGPT Work,再到飞书 Aily、CLI、MCP。 体验得越多,我越觉得各家产品在趋同。所以当时给我家媳妇发了一则体验心得: 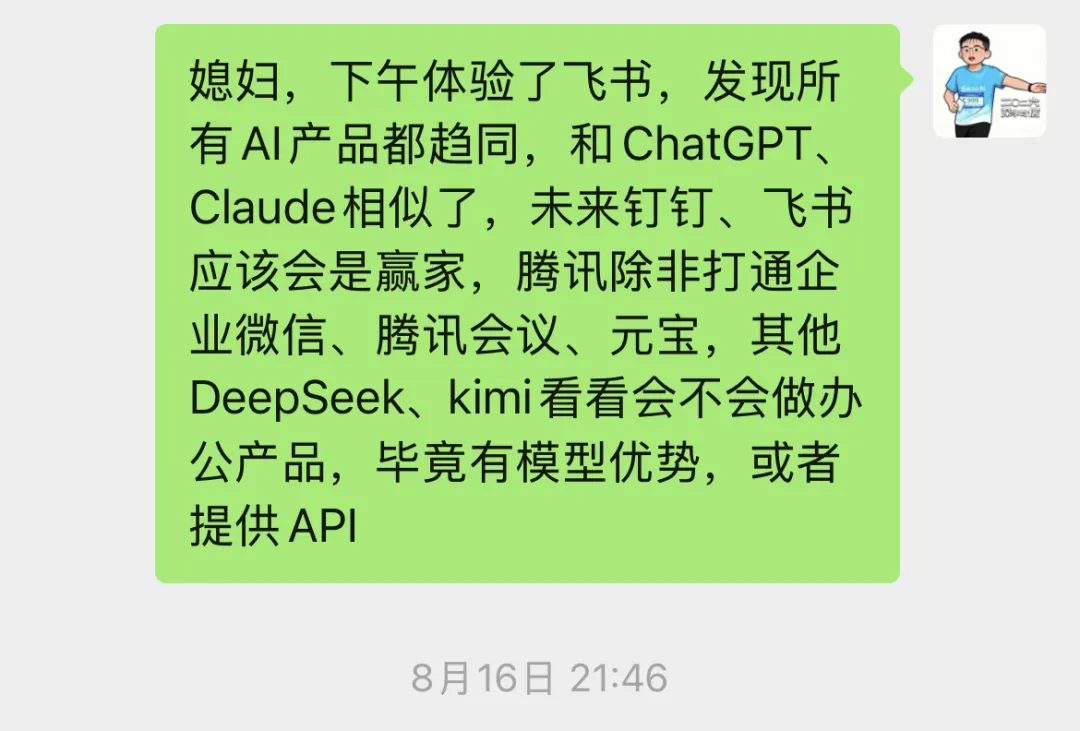
这两天看到DeepSeek出了办公产品,才有了写这篇文章的念头,想梳理一下自己这半年对AI的探索过程。 AI界变化太快,我不想把自己的工作绑在任何一家产品上。 这时我在X上看到一位大佬分享Claude的使用方法,核心思路是:把数据和AI大脑分离。数据放在自己手里AI只是大脑,只要数据还在,无论AI界怎么动荡,我都可以自由选择。 经过深度体验和研究,我选择了飞书作为数据库,再通过CLI把飞书接出来,让ChatGPT Work 和 Codex 去操作它。 具体用起来是这样的:飞书妙记会把我每周的会议内容记录下来。每次工作,我让ChatGPT Work通过飞书CLI调取这些记录,帮我做360度的总结和分析,再给我建议。 会议开完,内容不是很好整理,这样记录留在飞书里,就成了可以反复调用的数据。 数据始终留在我自己的飞书里,ChatGPT只是眼下最顺手的大脑。哪天出现更好的,换掉大脑就行,数据不用动。 这条路我还在探索。AI能不能理解持续的工作上下文,能不能调用工具、执行任务、真正提效,我还没有最终答案。但有一点我越来越确定:比起猜哪一家会赢,更值得花力气的是,怎样把这些能力变成自己的生产力,并且不被任何一家绑住。 05 试过,不等于用好 回头看,我很早就“用过”ChatGPT,按有没有用过算,我早就是AI用户。但真正的理解,是从我愿意投入时间和费用开始的:做真实项目,比较不同产品,设计工作流,尝试不同分工,做自己的产品,再把AI接进真实工作。 由此我得到一个比AI本身更普遍的体会:接触过一种新技术,和真正掌握它,是两回事。 以后再遇到可能影响深远的新技术,我不想只停在“试过了”,而要去研究它、理解它,想办法用好它。这也是我后来建立“AI精进”项目的原因。 我关心的不只是哪个AI又更新了、哪个模型登顶榜单,而是:哪些能力真正有价值,哪些只是宣传;哪些方法可以复用;AI为什么有时好用有时不好用;怎样组织上下文、工具和流程;哪些工作交给AI,哪些仍然该由人来做。 我想积累的不是几条很快过时的Prompt,而是一套能跟着AI一起升级的使用能力。 如果要说整个过程的转折点,不是我从Claude 换到ChatGPT,也不是用过多少模型,而是《诗经》项目让我第一次看到:当AI从一次性问答进入持续项目,再被放进真实的工作流程,它才开始稳定地产生价值。 我的探索还远没有结束。但有一个问题,也是我这半年体验下来最确定的一点:人是目的,AI只是工具,但我们得学会用好这个工具,因为往后,它会像水和电一样,成为一种基础能力。