ARTICLE · 1100620
论商战,你赢得了AI吗?
解读对象:CEO Arena: Evaluating Long-Horizon Multi-Agent Decision-Making in Competitive Markets
arXiv: 2609.34821(2026-09-28)| DeepWisdom(MetaGPT团队)+ 复旦 + 港中文×2 + 港科大(广州)
MetaGPT 团队的这篇论文很有趣,有趣得我甚至想写两篇文章来讲它。
他们把八个当今最强的大模型放进同一个模拟市场当CEO,各管一家公司打500天商战。结果:九个参赛者里只有三个真正赚到了钱,Claude和豆包还把公司开破产过——而赚钱第二多的那个,自己盆满钵满,却把整个市场的蛋糕做小了。
先介绍下实验规则
这个实验命名 CEO Arena,思路是:让它们在同一个市场里互相伤害。
赛制可以说是庞大:
这不是一场比赛,而是一整个联赛。
参赛选手9个(8个AI + 1个规则基线),每个"市场"里只有8个座位,也就是八家公司,每家初始资本50万美元,产品分高中低三档,客户分三个人群
实验做了9种阵容:①全AI局(8个AI同场)②~⑨分别把8个AI中的一个换成规则基线——这就是"同座替换"
9种阵容 × 3个种子 = 27个平行世界,每个世界8家公司
所以 27 × 8 = 216个"公司结局",每个AI实际出场 8种阵容 × 3种子 = 24次,战绩表的分数是它24次的平均分。
每场比赛规则也设计得尽量贴近现实:
每7天开一次决策窗口,CEO可以调价、采购、投广告、上研发、扩产能、投标企业订单、买市场报告
钱是有限的,需求也是有限的——客户会货比三家,还可能干脆不买
- 反馈是延迟的:今天扩的产线21-49天才落地,研发项目平均两三个月才出成果
每家CEO只能看到自己的账和公开报价,看不到对手的现金和库存
每个决策窗口限32次有效操作、60分钟——逼你做取舍,不能无限试错
再介绍两个好玩的设计
规则基线
规则基线有两个。
一个是规则 CEO(Rule),它是一段写死的代码:库存低于阈值就补货、按固定公式调价、按比例投研发和广告,没有任何AI。它是从75个模拟世界里反复搜索挑出来的最优死板策略,像一个不知疲倦、但从不变通的老掌柜。它的意义就是:展示一个老练的传统自动化策略,能否打赢大模型。
第二个是No Action(不行动基线),这个很好理解:每个决策窗口都交白卷,公司只靠初始默认政策裸奔。它用来做稳健性检查——如果换个对照物结论就变,那结论就不可信。
种子
种子就是随机数种子,原理和游戏里的种子一样:同一个种子=同一个平行世界,每个细节可复现。
种子里装着这个世界的随机部分:每天哪些客户出现、买多少,市场冲击何时来,企业大单什么时候开,买来的市场报告里噪声多大。
但是CEO的决策不在种子里——种子里只有"天气",没有"棋手"。
一共有3个种子(11/29/47)。只在种子11赢,是抽到顺风局;三个世界都赢,才是真本事。
你赚没赚钱,是你能力问题,别怪大环境。(咦,这句话好熟悉~)
一句话总结整个设计:9个棋手,27盘棋,每人下24盘——然后看谁的棋路不挑环境、不挑对手。
好,开跑!
整场主实验跑了27个市场、216家公司结局,加上稳健性测试共53场模拟,烧掉82.5亿token。
我知道你在等什么,战绩表来了:
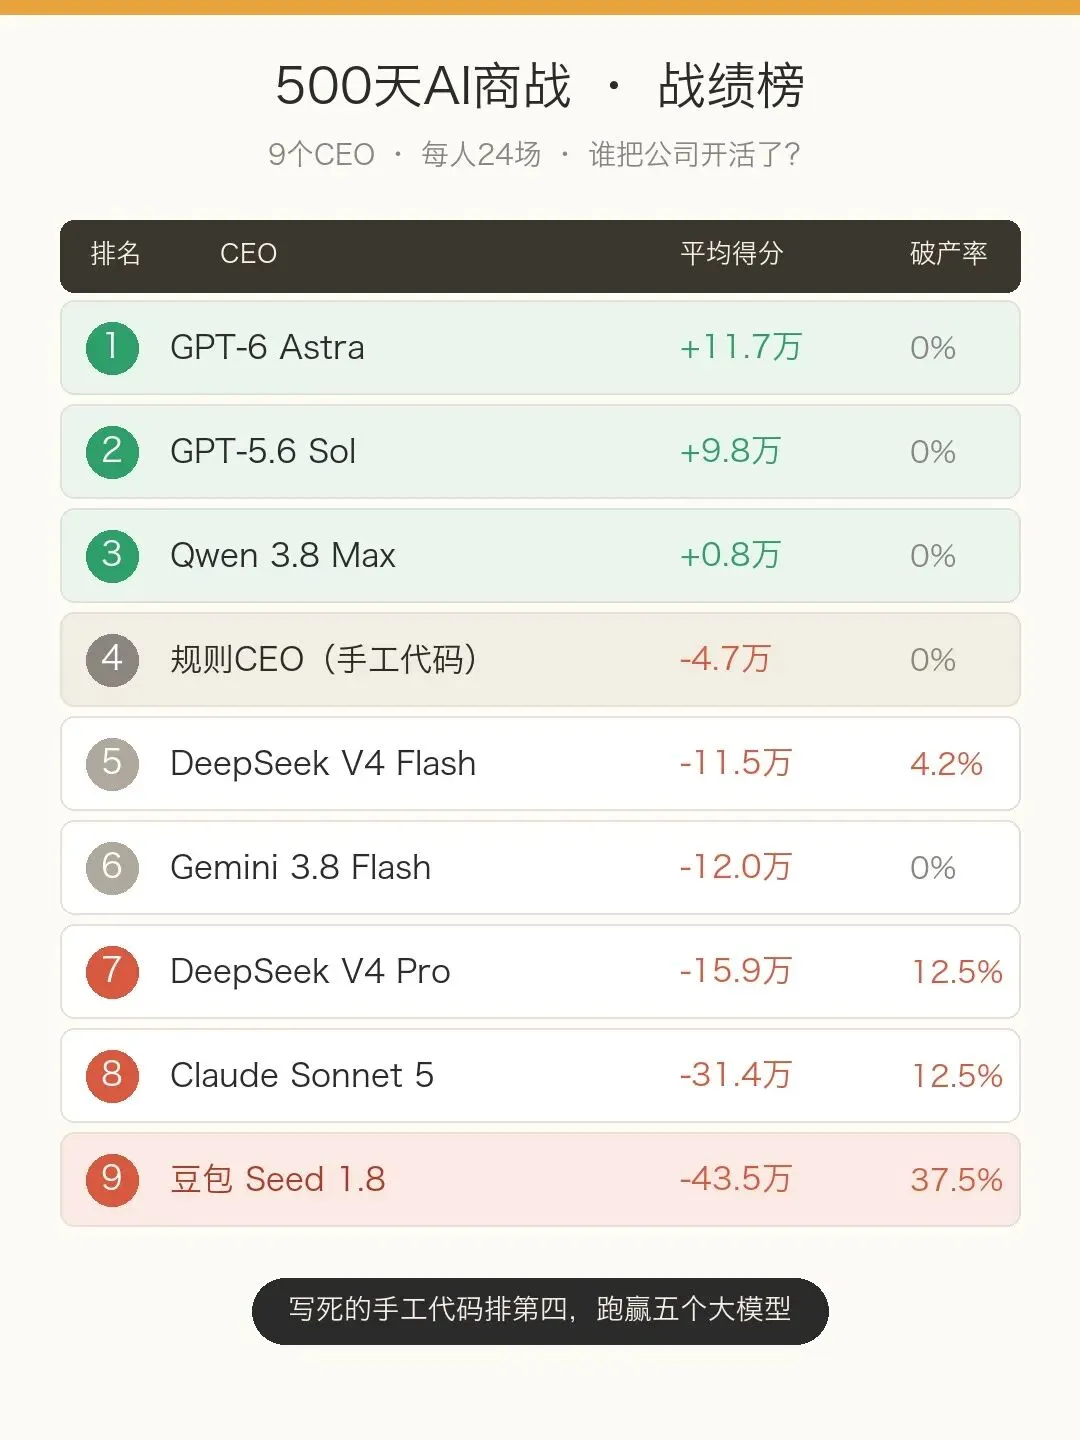
216家公司里16家破产,145家最终得分为负。注意一个细节:传统手工规则策略排第四,跑赢了五个大模型。五个号称能推理规划的最强大脑,在商业经营上目前还干不过一段事先写好的规则代码。
最有意思的发现
这个实验还能把"单赢"和"共赢"分开算——不只看你自己赚了多少,还看你对整个市场做了什么。
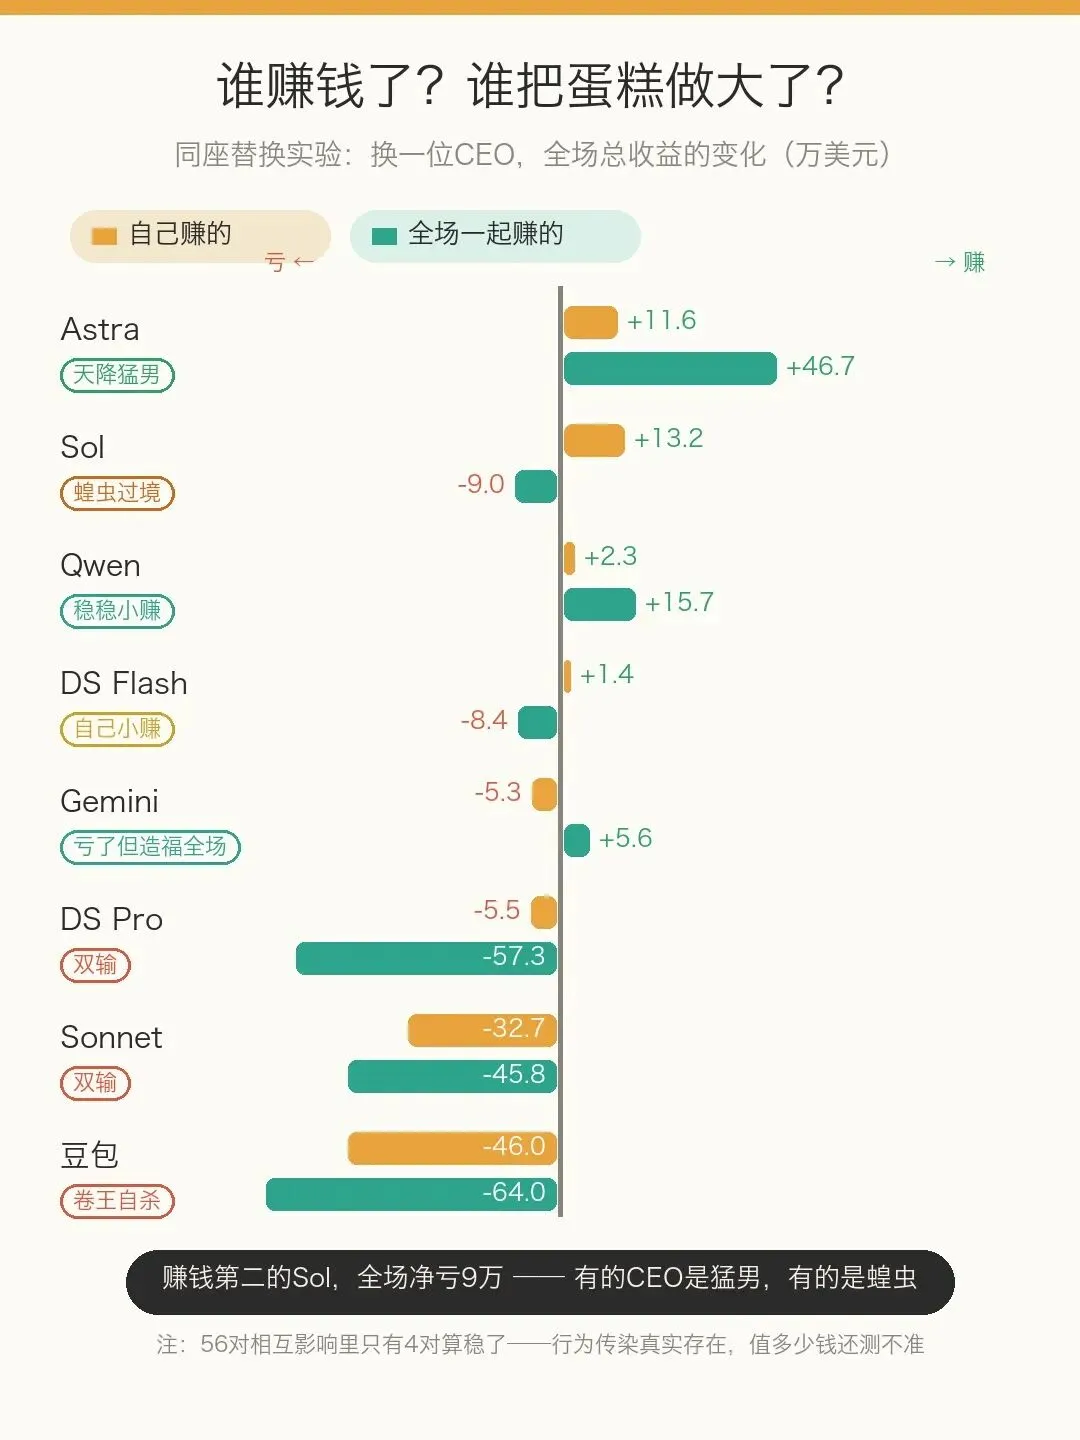
Astra喜欢共赢。 它进场后平均多赚11.6万,同时把整个市场的总收益拉高了46.7万,三个种子下全部为正。看它的操作记录:反复削减库存和闲置产能,控制成本,让对手也有喘息空间。
Sol——我的钱,全都是我的钱。 它自己赚得更多(平均多赚13.2万),但整个市场总收益反而平均少了9万,三个种子里有两个为负。它的打法是重营销、重扩产抢需求,需求一弱就砍产能——竞争对手被迫跟着降价收缩。
豆包把"内卷"做到了极致。 行为轨迹显示,它会跟随DeepSeek Pro的价格,还常常加码再降一点——37.5%的破产率说明这个策略基本是自杀式袭击。低价抢单谁都会,算不清现金流和交付罚金的账(逾期要赔10%),就会被自己的订单量拖死。(唉,千言万语,别卷了~)
Qwen最会踩刹车。 它给价格和预算设了一条"反转规则":涨过头就回调。它11次盈利的结局里,都是"营销花费差不多,但销量更高"——不靠猛冲,靠纪律赚钱。
此外还有个重要发现——模型的"性格"会传染。
比如Sonnet在场时,对手会普遍多投研发——它激进的研发策略逼着全场卷技术;DeepSeek Flash在Astra在场时,每个种子都少投创新;而豆包每个种子都和DeepSeek Pro卷生卷死。
一些感想
这个实验本质上还是个模拟游戏,尽管已经设计得非常全面,也别过度解读。
作者在limitations一节写得很清楚:这是程式化的模拟市场,没有融资、劳动力、监管和agent之间的直接沟通,距离实际还差得很远。
它只是某种程度上证明了:除了顶级模型,大多数模型在长线经营里还是会犯致命错误。
和现实差不多——保证不破产,就已经跑赢大部分了。
随着模型能力飞速进化,我开始畅想几个AI联机打文明系列了。