ARTICLE · 1106088
008 同一句话,AI为什么每次答得都不一样?
三句都能用,三句都不一样。
那它到底有没有一个“标准答案”?如果有,为什么不每次都把最好的那一句给你?
先把答案放在这里:这通常不是出了故障,而是 AI 写字时,本来就留着一点“抽签”的空间。控制这份空间有多大的旋钮,叫温度。
一、它每写一个字,都在抽一次签
第一篇讲过,大语言模型写东西,是一个 Token 一个 Token 往后接。每接一步,它都会给许多候选词各打一个概率,也就是“这个词接在这里有多合适”。
关键在下一步:它不一定每次都挑概率最高的那个,而是按概率抽签。概率高的签多,更容易被抽中;概率低一些的,也有机会。
一句口号有十几个字,每个字都抽一次签。只要其中一步抽到了第二名,后面的句子就会顺着新的方向写下去。所以“重新生成”一次,换一句话,一点也不奇怪。
这种按概率抽签带来的不确定,叫随机性。
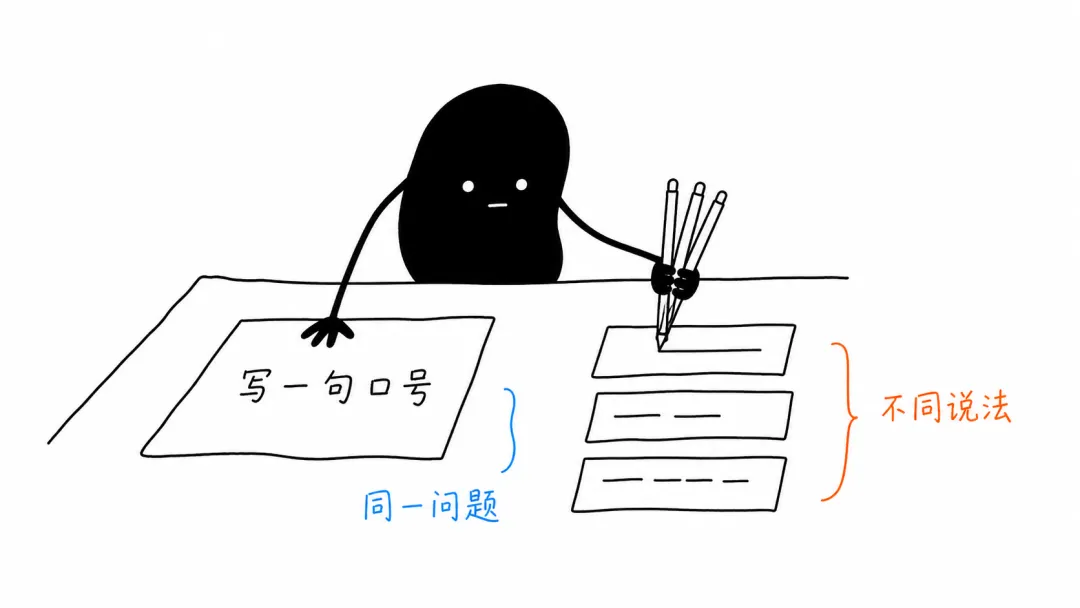
图1|同一句话发三次,三次措辞都不一样
二、为什么不每次都选第一名?
听起来,永远挑概率最高的词最稳妥。可研究者早就发现,这样写出来的文字往往又平又闷,长一点还容易车轱辘话来回说,甚至在一句话里原地打转。
原因不难理解:每一步都挑“最常见”的那个词,拼出来的就是最常见的套话。人写东西也不会每个字都挑最保险的那个。
所以大多数聊天产品默认会留一点随机性,让回答读起来更自然、也更有变化。
三、温度:给抽签拧一个火力旋钮
温度就是调节这份随机性的旋钮。它不改变候选词的排名,改变的是名次之间的差距。
来看一个假想的例子。口号写到“一起出发,一起……”,下一个词有四个候选:
温度调低,第一名越来越占便宜,几乎次次都是“成长”,回答稳定,但也容易千篇一律。温度调高,几个候选的机会被拉平,“摸鱼”这种出人意料的词也有了露脸的机会,回答更有新意,但也更容易跑偏。
这张表里的数字是为了讲清道理编的,不是哪个模型的真实输出;不过“调低就集中、调高就摊平”的方向是对的。
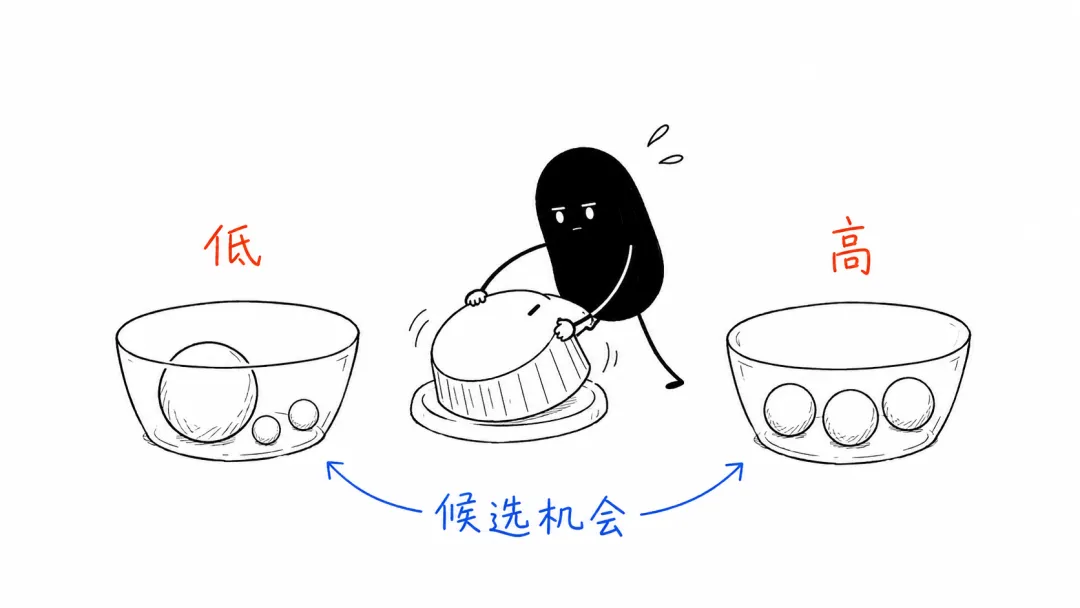
图2|温度只改变候选词之间的差距,不负责让答案更正确
可以把它想成炒菜的火力。火小,味道稳,每次都差不多;火大,香气更冲,偶尔出彩,也可能炒糊。
这个比喻要说清边界:温度高不等于更聪明,温度低也不等于更正确。它只管措辞敢不敢偏离最常见的那条路。如果模型本来就不知道答案,调低温度,只会让它把同一个错误答案说得更稳定。
大多数聊天软件从来不让你拧这个旋钮,它们在后台替你设好了。以前,开发者调用模型时还能自己调;这两年最新的模型,却越来越不让调了。OpenAI 最新一代模型只要开着“深度思考”,就不接受温度设置;谷歌则“强烈建议” Gemini 3 把温度保持在默认值,说调低了反而可能让模型原地打转、表现变差。
不过,旋钮并没有被拆掉,只是被厂商固定在了一个位置上,通常就是表里“平时”那一档。抽签照常进行,所以回答照样会变。
四、把温度拧到零,就每次都一样了吗?
按道理,温度调到零,就是每一步都只选第一名,答案应该一字不差。
实际上不一定。2025年,一家名叫 Thinking Machines 的 AI 公司做了个实验:把温度设成零,用同一个问题“介绍一下理查德·费曼”问同一个模型 1000 次,结果得到了 80 种不同的回答。
问题出在计算过程里。服务器同时在处理很多人的请求,每次一起算的请求多少不一样,计算的先后顺序会有极细微的差别,小数点后很远的地方会出现一点点误差。平时这点误差无关紧要,可一旦某一步有两个候选词的概率几乎打平,它就可能让结果翻个面,后面的句子也跟着走上另一条路。
会“先想再答”的推理模型,变化往往还更大。它们给出答案前,会先在后台写一大段思考过程,动辄几千个 Token,每一个都要抽一次签。思路一旦在前面岔开,后面就越走越远,最后的措辞、甚至结论都可能不同。
另外,你在聊天软件里看到的“每次不一样”,还可能来自别的原因:它记住了你之前聊过的内容,联网搜到的网页变了,或者产品悄悄换了新版本的模型。温度只是其中最常见的一个。
五、你也可以做的小实验
这个实验看“换说法”和“换答案”的区别。分两组,每组都问三次,每次都新开一个对话:
请写一句“社区二手书交换”的宣传口号,只要一句话,不要解释。
《静夜思》的作者是谁?只回答名字。
把六次回答抄下来对比。第一组,三句口号大概率各不相同,这就是随机性在起作用;第二组,三次多半都是“李白”,因为正确答案的概率远远领先,抽签也很难抽到别的名字。
手边没有顺手的 AI,也可以用“动手学”小站,长按下面的二维码打开,一句一句粘进去。小站每次提问都是全新的,不会记得上一次问过什么,正好符合实验要求。
提示词会发给模型服务商生成回答,所以别往里输入密码、证件号这类隐私信息。
这个实验只能说明,你用的这个模型、在这一天、按它的默认设置会怎样表现。换一个产品、换一天,结果都可能不同,不要据此下“所有 AI 都这样”的结论。
六、变化什么时候是好事,什么时候是警报?
写口号、起标题、想点子,变化是好事,多点几次“重新生成”,就是多要几个备选。
但问事实的时候,变化反而是一个有用的警报。研究者发现,如果对同一个事实问题多问几次,模型每次给出的答案都互相打架,那它多半是在编:真正有把握的事,概率会集中在一个答案上,抽几次签都差不多;没把握的时候,概率分散,每次抽出来的都不一样。
反过来却不成立:三次答案一模一样,不代表就是对的。网上流传很广的错误说法,模型也可能背得很牢,每次都答得一样肯定。所以日期、金额、条款原文这类东西,还是要回到原始出处核对。
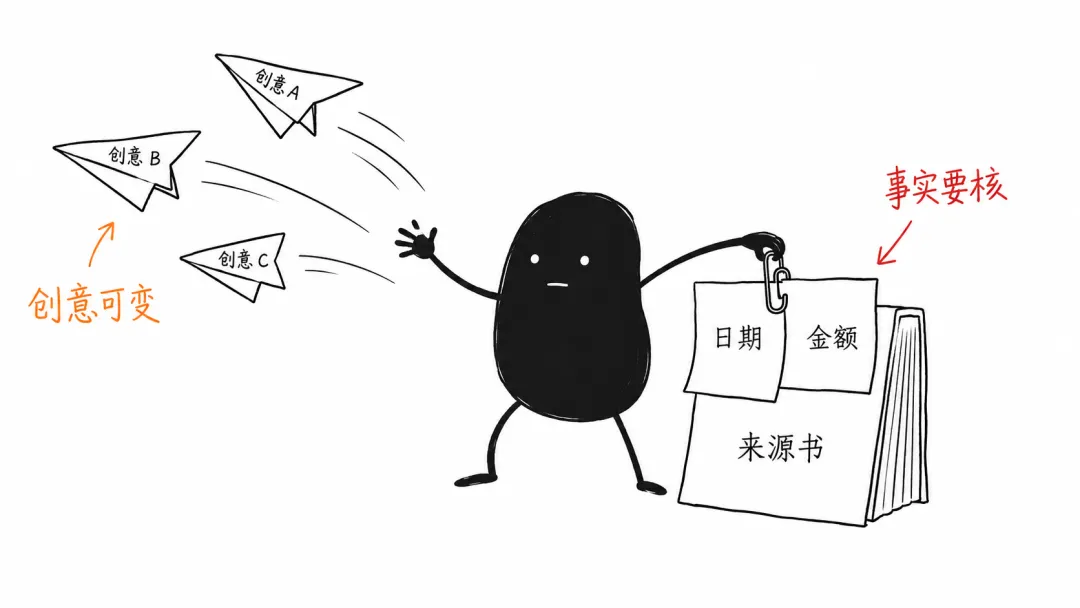
图3|点子可以多要几个版本,事实只能有一个
今天记住这四句话
1.AI 写字时每一步都按概率抽签,所以同一句话每次的回答都可能不一样。
2.温度是调节抽签随机性的旋钮:调低更稳、更单调,调高更活、更容易跑偏;它不管对错。
3.最新的模型大多不让调温度,但旋钮只是被固定住了,抽签还在;推理模型想得越长,差异还会被放大。
4.创意任务里,变化是备选;事实问题里,答案来回变,是提醒你去核查的信号。
回到那句团建口号。你点“重新生成”时,AI 不是在敷衍你,而是在重新抽一次签。抽到哪一句,好不好用,最后还得你来挑。
下一篇,聊一个让 AI 少编一点的办法:
如果 AI 没读过某份资料,怎样让它像开卷考试一样,边查边答?
如果这期对你有帮助,随手点个赞就行;想持续看这类拆解,记得关注,我们下期继续。
资料来源
•OpenAI, API Reference: Chat Completions — temperature(取值 0—2;较高值如 0.8 输出更随机,较低值如 0.2 更聚焦、更确定).
•OpenAI, Using the latest model(reasoning effort 不为 none 时需去掉 temperature、top_p 等参数), 2026.
•Google, Gemini 3 Developer Guide(强烈建议温度保持默认值 1.0,调低可能导致循环或表现下降).
•Ari Holtzman et al., The Curious Case of Neural Text Degeneration, ICLR 2020.
•Horace He and Thinking Machines Lab, Defeating Nondeterminism in LLM Inference, 2025.
•Potsawee Manakul, Adian Liusie, Mark J. F. Gales, SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models, EMNLP 2023.