ARTICLE · 1106756
美军智能体AI融入多域海上指挥控制的分析
美国某机构论文用混合方法测了一个问题:智能体人工智能(Agentic AI)能不能真正进入多域海上指挥控制。对 32 名现役学员的问卷显示,总体信任是感知作战效能的唯一显著预测变量(b = 0.965,p < 0.001),而 AI 使用经验、指挥控制经历和军龄都不显著;AI 经验越深的人,信任分数反而越低。作者据此提出五条落地建议和一套 AUTOCON 分级授权框架,主张把"信任校准"当作训练和条令问题来解,而不是技术问题。
作者把问题的性质说得很直白:缺的不是 AI 工具,是人的信任和组织配套。美军联合全域指挥控制(JADC2)战略要求部队"利用不断增长的数据量,运用自动化与人工智能,在对手决策周期内行动";海军 2022 年《航行计划》要求 2027 年前把自主与 AI 系统常规化编入舰队行动,"超越匹配"(Project Overmatch)项目和"态势感知智能学习系统"(SAILS)试点都在朝这个方向走。但现实是,SAILS 即便能以机器速度分析多源情报并给出可行方案,操作员仍经常不敢按机器给的建议办。作者写了空军的对照案例:" planned Maven"项目里,指挥官坚持对 AI 标注的目标逐个人工复核;2003 年"爱国者"导弹因过度依赖自动化造成友军误伤,则从另一头说明信任失衡的代价。
组织层面的阻力形成一个自我强化的循环。现行条令 rooted 在层级化、反应式的控制范式里,机构不敢让算法在没有多层人工审批的情况下参与决策;操作员很少见到 AI 驱动的工作方式,缺乏建立信任的正向经验;而低信任又被当作前提,反过来继续压缩 AI 的条令空间。作者引海军少将西科·冈野(Seiko Okano)2025 年在 AFCEA West 年会上的话收束这一段:把自主系统集成进来"不是技术问题,这是文化问题"。
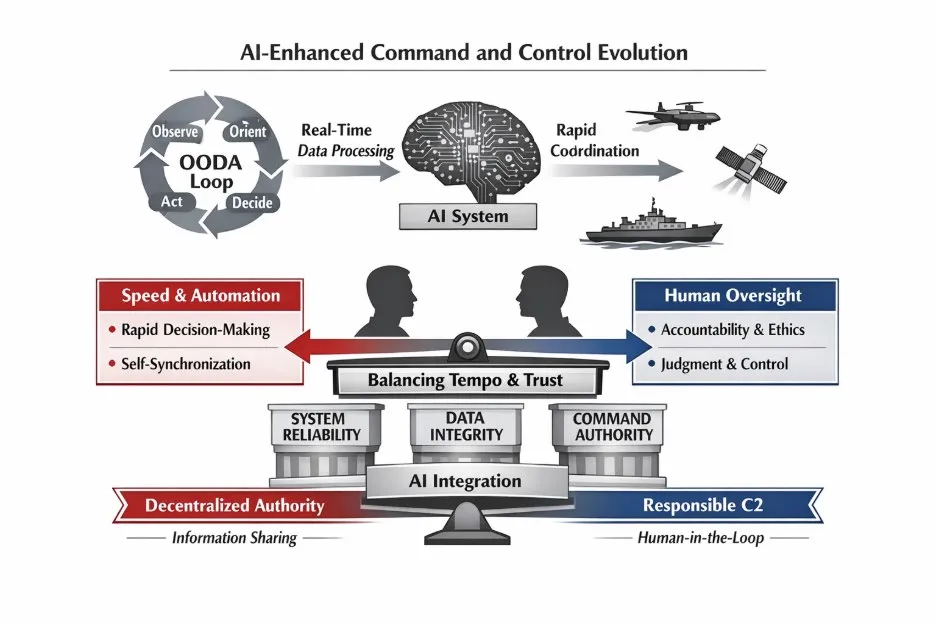
图 2:AI 增强指挥控制的演进:在速度与信任之间求平衡(AI-Enhanced Command and Control Evolution. Image generated by CoPilot (2026)),原报告第 11 页
量化侧是一份围绕 NavAI 想定展开的问卷,核心工具是 TAIS 量表。问卷先给一段 NavAI 想定短文,让受访者在一个具体场景里作答,再用 27 个里克特量表题测六个信任维度:能力(Ability)、正直(Integrity)、透明(Transparency)、无偏(Unbiasedness)、警觉(Vigilance)和总体信任(Global Trust),另加技术接受模型(TAM)的有用性、易用性题目和开放式文本框。清洗后保留 32 份完整问卷:海军 23 人(71.9%)、陆战队 7 人(21.9%)、陆军和海岸警卫队各 1 人;尉官级(O-1 至 O-3)22 人,占 68.8%;军龄 6 至 10 年的 15 人,占 46.9%。32 人里 24 人(75%)在开放式题目里留了长段反馈。
质化侧是 5 名专家的单轮半结构化访谈,每人约一小时。名单覆盖作战(海军上校、陆军上校)、技术(海军中校、高级行政职位 SES 文职)和政策(文职专家)三类背景,入组门槛是 10 年以上领域经验。编码先从 TAIS 文献推出 5 个演绎码,数据分析中又补了 3 个涌现码——人在回路(HITL)、数据治理、法律责任,凑成 8 个一级码,再归并为"问责与正直""可靠性与作战能力""可解释性与功能透明""人的监督与自动化偏倚"四个宏观主题。
六个维度的得分画出一条清晰的落差线。能力维度均分 4.61 最高,正直 4.41 次之;透明只有 3.34,警觉 3.03,无偏 3.58 居中,总体信任均值 3.87,属于中等水平。量表信度良好,总体信任合成分的 Cronbach's α 达 0.942,全球信任 0.909,只有警觉子量表偏低(0.661)。相关分析里,全球信任与感知作战效能的相关最强(r = 0.721,p < 0.001),总体信任 0.698,正直 0.660;透明维度虽然也显著,但只有 0.416,是六个维度里最弱的。
回归模型把结论钉死了:控制其他变量后,只有总体信任显著。模型整体显著(R² = 0.701,调整后 R² = 0.657,F(4, 27) = 15.83,p < 0.001),具体见下表。
来源:原报告第 41 页 Table 9,因变量为感知作战效能,N = 32
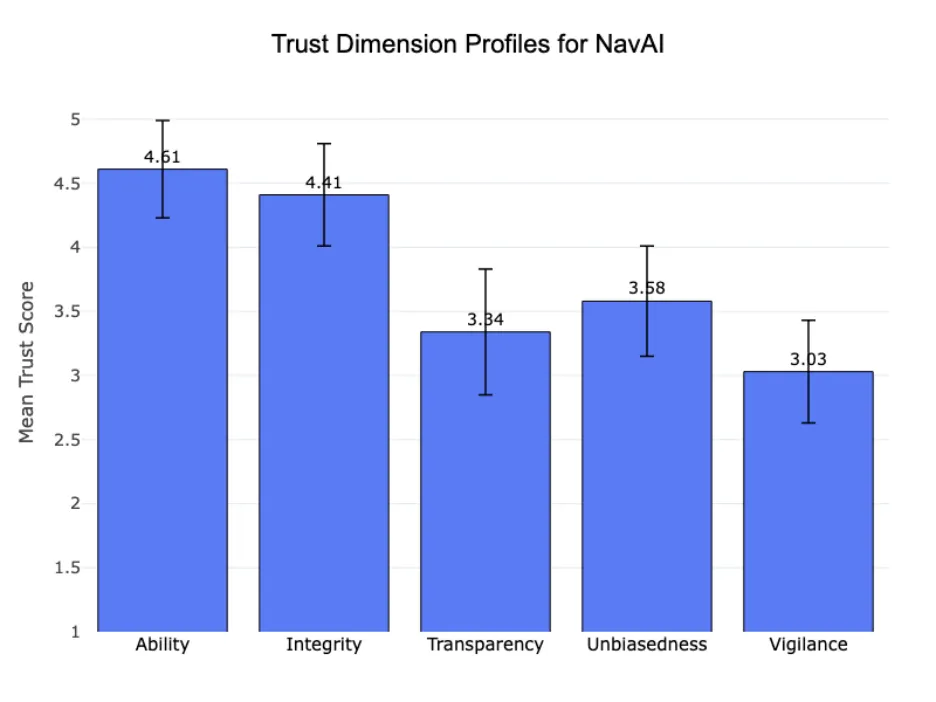
图 3:NavAI 信任维度剖面(Trust Dimension Profiles for NavAI. Image generated by CoPilot (2026)),原报告第 39 页
开放题的反馈集中在四个方向,与低分维度一一对应。一是透明与可解释性:受访者要"原始数据、决策指标、决策树、每个决策的理据",明确说"除了置信度评分,还要更多信息";二是数据质量与来源可靠性:怀疑系统怎么给被欺骗或降级的传感器输入加权、不同密级的数据怎么融合;三是人的监督:"AI 不能替代领导决策""生成行动方案前必须先核实结果""人必须始终负责";四是安全与任务风险:网络漏洞、电子战攻击和系统被攻陷被列为"立即清零信任"的事项。
论文的工作假设被数据干脆利落地否掉了。假设原本写的是"熟悉生信":上手 AI 系统越多的人,对把智能体 AI 编入指挥控制流程的信任越高。实测结果是反向的——AI 经验与总体信任呈非线性、经常倒挂的关系,经验最深的一批受访者在透明子量表上的分数尤其低。作者从开放题里找到解释:老手对现有 AI 模型的局限、失效模式和架构弱点有更细的体感,会直接追问 NavAI 用没用检索增强生成(RAG)、怎么防幻觉。专家访谈给了同样的观察:用 AI 反复训练("reps and sets")让操作员看清的不只是能力,还有明确的边界。作者的结论是,这不是在否定 AI 的价值,而是一支走向成熟的部队拒绝把智能体 AI 当作不会错的先知——经验造出来的是校准过的信任,不是盲从。
专家访谈里"问责"是被提到最多的词,112 次引用。一位专家的话被论文原样引了两次:"如果 NavAI 建议的动能打击命中一栋民用建筑,站上军事法庭的不会是算法,是指挥官。我不能把我的指挥权委托给一个黑箱。"可靠性与作战能力主题有 74 处引用,焦点在降级、间断、受限(DDIL)环境:另一位专家说,"在对抗性 DDIL 环境里,系统必须不回连服务器也能完美工作。蜂群攻击时它要是幻觉出一个航迹,是要死人的。"透明维度的落差在访谈里被进一步细化为两种需求的分歧:数据科学家要算法级透明,作战人员要数据溯源——"95% 的置信分数对我毫无意义,如果我看不见底层的传感器数据。"人的监督主题有 46 处引用,专家给出的边界按任务性质切分:防御性反蜂群可以让系统在人回路上(HOTL)抢秒级窗口,一切升级性、进攻性动作必须保留人在回路里(HITL)的实体扳机。
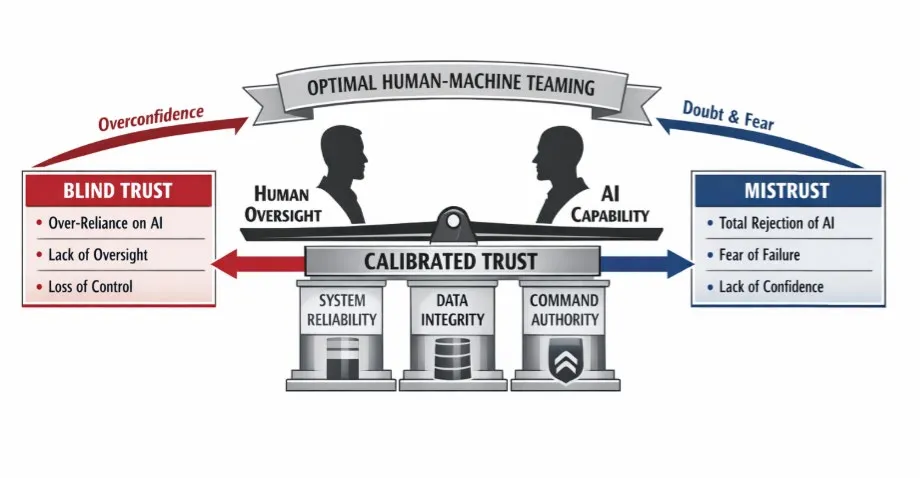
图 4:海军指挥控制的校准信任模型(The Calibrated Trust Model for Naval C2. Image generated by CoPilot (2026)),原报告第 52 页
论文对指挥控制架构的判断是:线性层级已经结构性过时,要往"边缘组织"迁。按 Alberts 与 Hayes 2003 年的理论,权力、态势感知和决策权都要推到战术边缘,实现快速自同步;配套要求是开放式、模块化架构和自动化的安全密级流转,让数据以机器速度跨安全飞地流动。训练侧,作者主张把 AI 深度嵌入实兵、虚拟、推演(LVC)三类环境:实兵环境练真实压力下的动能与非动能执行,虚拟环境跑上千次"reps and sets"看系统的极端工况和失效模式,推演环境评估 AI 生成的行动方案对作战设计和后勤的长期影响。专家强调,训练不能只教怎么开机,要练"怎么识别系统正在失效、正在幻觉、正在被投毒"。
组织政策一侧点名了"冻结的中层"(frozen middle)。一位专家把文化障碍具体化为中层军官和高级士官里的"战列舰水兵",抵触新指挥控制流程;对策是陆战队已经铺开的数字转型分队(DTX)和编制内的数据与 AI 办公室,把技术人才嵌进作战单位。采办侧,2026 年国防部 AI 战略立了"速度制胜"(Speed Wins,第 14 页)的原则,论文主张软件类项目绕开传统 JCIDS 流程,用持续集成/持续交付(CI/CD)和"沙箱"部署取代动辄多年的运行授权(ATO)流程。试点证据用的是"超越匹配"项目:它像商用手机应用一样向 590 名受训水兵持续推送更新(DVIDS,2023)。
五条建议之外,论文给出一个条令创新:AUTOCON(自动化条件)分级授权框架。它的逻辑是把"向 AI 委托指挥权"变成双门槛判断——任务复杂度和系统可靠性必须同时满足预设阈值才允许委托,四级姿态见下表。
来源:原报告第 64 页 Table 11(Proposed AUTOCON Matrix)
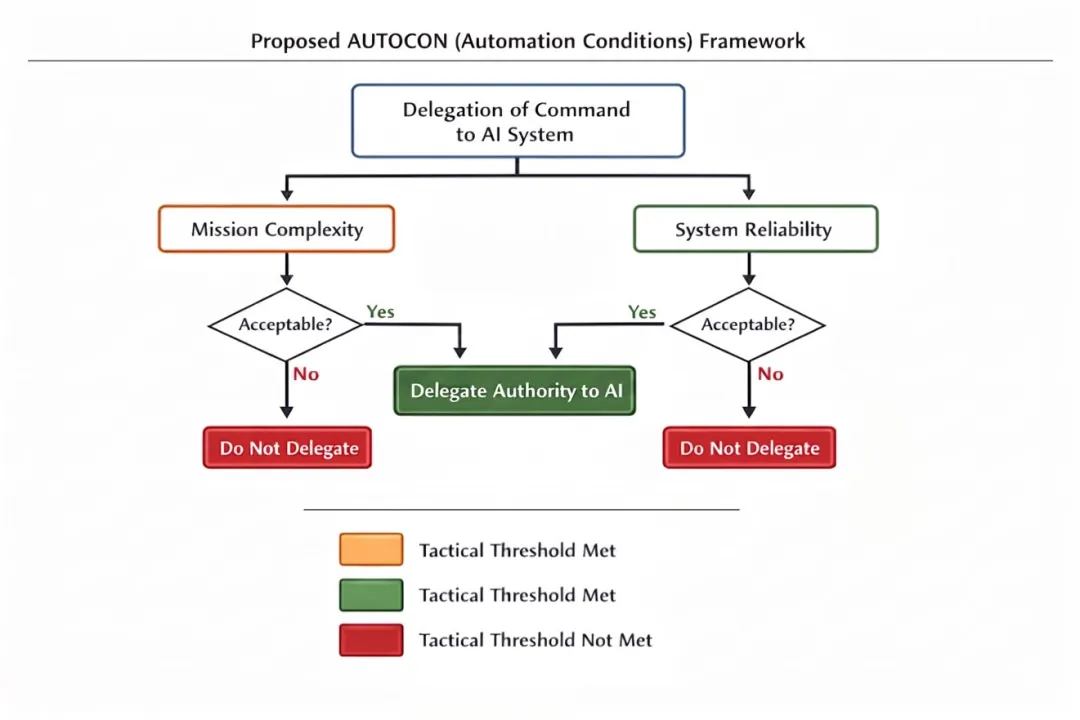
图 5:AUTOCON(自动化条件)框架提案:按任务复杂度与系统可靠性决定是否向 AI 委托指挥权(Proposed AUTOCON (Automation Conditions) Framework. Image generated by CoPilot (2026)),原报告第 63 页
其余四条建议覆盖采办、设计、人才和联盟四个口。采办上,把 2026 年"定标项目"(Pace-Setting Projects,含 Agent Network 与 Swarm Forge)和"超越匹配"推广到全部作战司令部,用好 GenAI.mil 平台把一线模型下放到各密级人员手里;设计上,所有作战 AI 工具强制装"数据溯源"架构,界面必须能从 AI 给出的行动方案一键点回它引用的具体传感器、情报报告和条令文件,并标准化"大红按钮"式的人工否决控件;人才上,把 AI 架构、数据科学基础和算法战争伦理塞进从士官领导学院到海军战争学院的各级军事职业教育,扩大 2026 财年陆战队在 NPS 和麻省理工的 AI 研究员计划;联盟上,在盟军 C2 AI 采办里强制执行互操作标准与模块化开放系统方法(MOSA),与北约及日本、韩国等印太伙伴统一数据本体——4.48 亿美元的 Palantir"舰船操作系统"(ShipOS)项目被点名为必须做到"盟友传感器数据和美国传感器一样好用地进来"。
(一)结论
这篇论文的实质贡献,是把"信任"从一句口号变成了一组可测量、可归因的作战参数。它的数据说明:AI 上不上得了一线,取决于透明、问责和可靠性的具体短板能不能补上,而不是取决于宣传和普及;"越懂越不信"的经验悖论说明部队的判断力在成熟,采办和训练体系要适配的恰恰是这种校准过的信任。从中方角度看,值得跟踪的不只是美军的算法性能,而是它围绕信任测量、数据溯源、分级授权和"冻结的中层"组织改造搭建的整套采纳机制——这套机制决定 AI 装备列装后的实际战斗力转化率。
(二)建议
●把人机信任测量纳入装备试验鉴定。借鉴 TAIS 六维度量表思路,在智能体类系统列装前开展操作员信任基线测量与失效模式校准训练,用数据定位透明、问责等具体短板,避免"列装即闲置"。
●预先研究分级授权的条令框架。AUTOCON 式的双门槛委托逻辑提示,自主系统交战权限的界定要按威胁环境与系统可靠性动态划分,并在国际规则讨论前形成自己的法理预案与技术判定标准。
●补齐数据治理与开放架构底座。论文反复显示,信任的短板在数据溯源、密级流转和跨盟友互操作上;对应地,应推进军用数据血缘管理、跨密级安全流转和模块化开放系统接口的自主标准建设。
●持续跟踪美军采纳机制动向。重点观察"超越匹配"迭代节奏、GenAI.mil 使用数据、陆战队数字转型分队运转成效,以及 AUTOCON 概念是否进入正式条令,评估其对西太方向联合作战体系的影响。