ARTICLE · 1108489
我用 AI 半天烧掉 540 万 token:不想白花钱,先看懂这 3 笔账
9 月 25 日,Anthropic 说 Claude 独立算出了一个前沿物理难题;换成普通用户来做,大约要花一两千美元。
这个消息,让我回头看这次 AI 的账。
我让 AI 连续干了半天活。
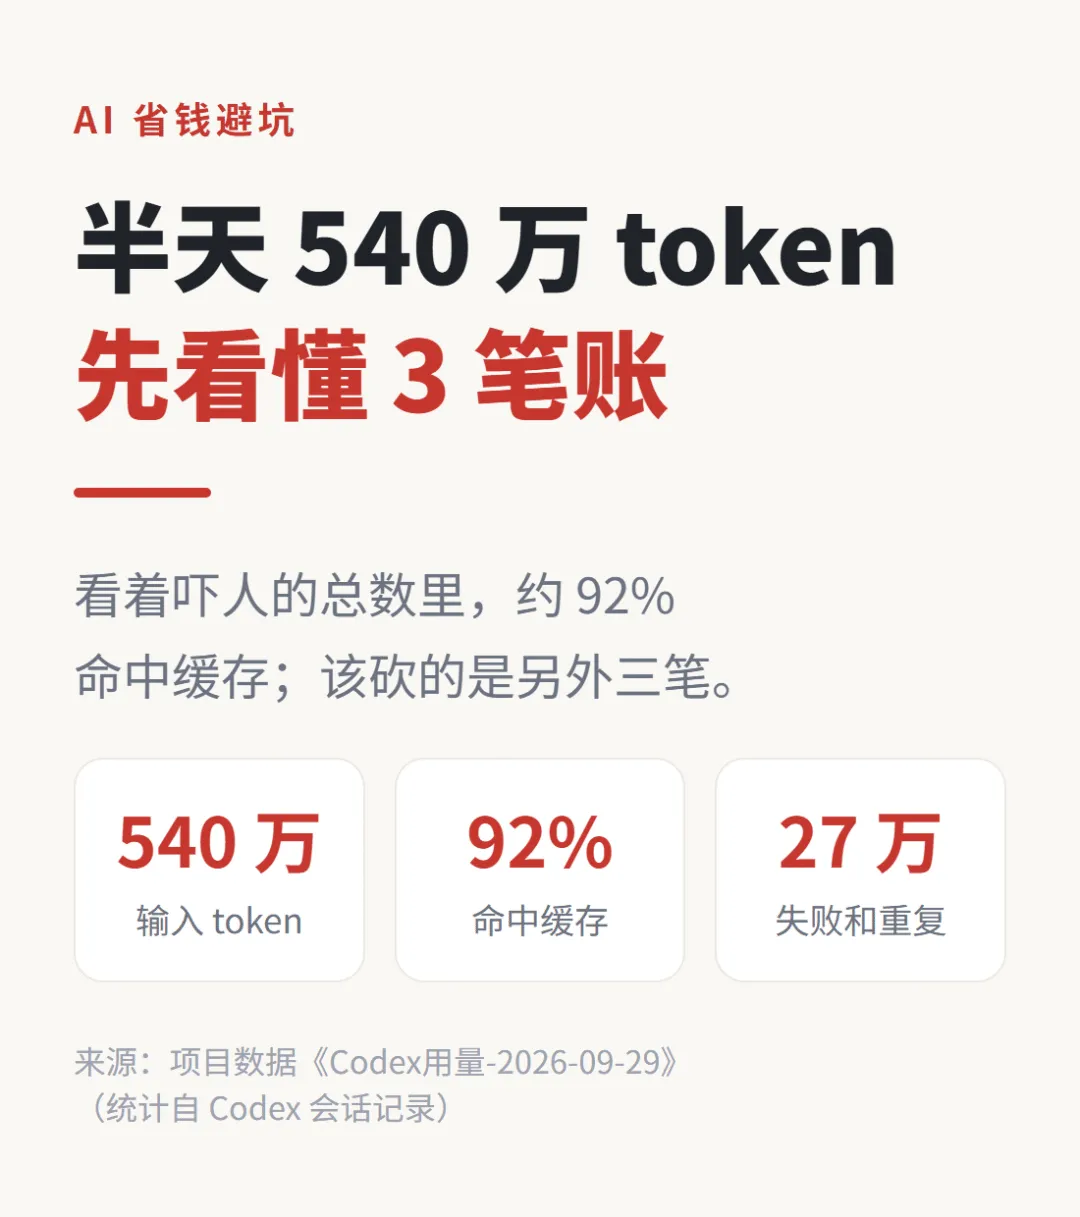
任务是找数据源、导出,抓文章,做 GitHub 调研。最后留下的数字是:约 540 万输入 token,额度提前用完。
如果你也遇到过“我没干什么,额度怎么又没了”,这篇就帮你把账拆开。
先说结论:540 万看着吓人,但它不等于 540 万都按原价付费。其中约 92% 命中了缓存,计费便宜得多。
真正值得盯的,是另外三笔账:模型选贵了、每次背的东西太多、失败后又从头再来。
先别被 540 万吓住
token 可以先理解成 AI 处理文字和信息的计量单位。
它有点像快递计重。你收到的回答只是包裹,AI 在回答前读过的聊天记录、规则、文件和工具说明,也都要上秤。
所以,回答只有一行,不代表这次调用很轻。
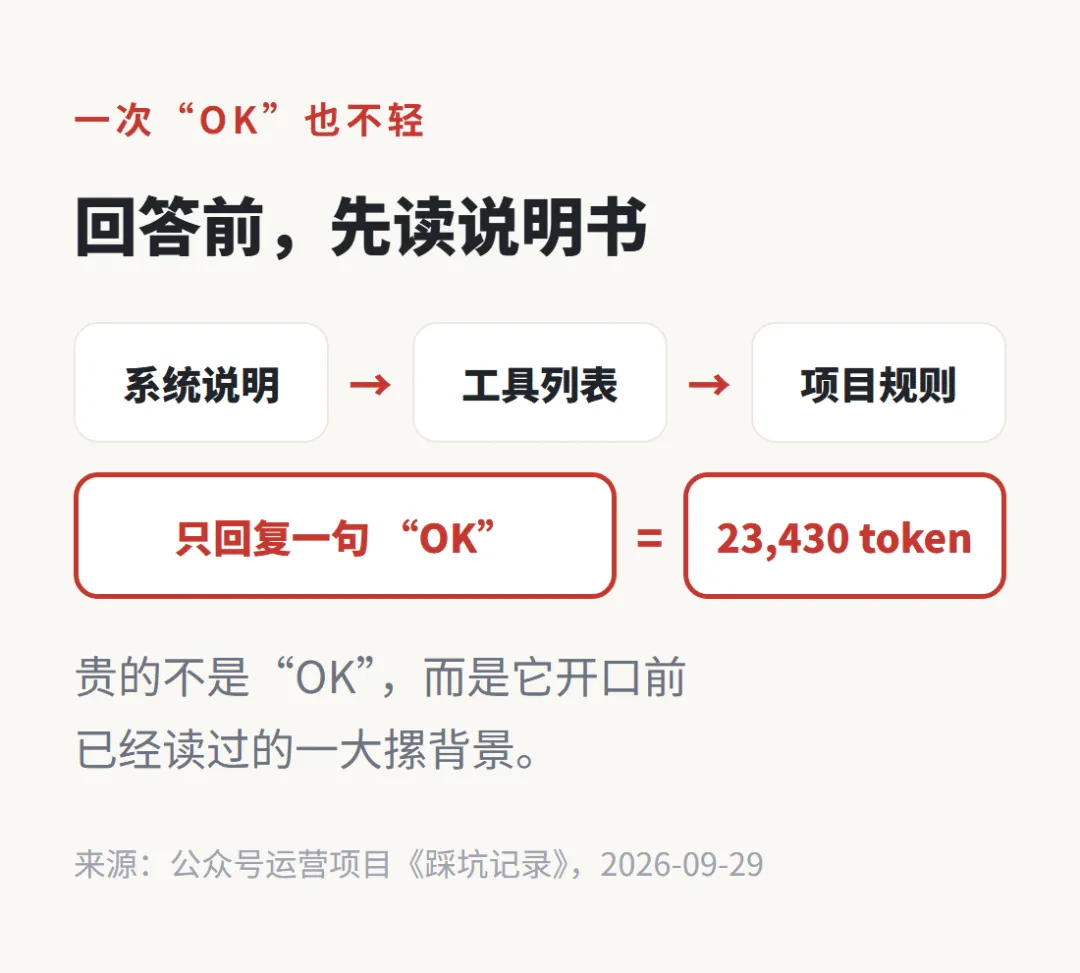
我的项目里做过一次小测:只要求 Codex 回复一句“OK”,仍然用了 23,430 token。
不是“OK”很贵,而是它开口前,先读了一大摞系统说明、工具列表和项目规则。
同一天的 540 万输入 token 也是这样。其中大约九成命中缓存,不能拿这个总数直接当账单金额。
按更适合比较的口径,只算未缓存输入和输出,当天公众号项目约 69 万 token;其中失败和重复约 27 万,接近四成。
这才是该砍的地方。
AI 最容易浪费的,不是最后那句回答,而是回答之前反复搬进去的东西,以及失败后重走的路。
第一笔:小活也默认叫最贵的人
那天所有任务都默认用了最高档模型。难题这么做有理由,改个文件名、抓取一批页面、检查格式也这么做,就不划算了。
好比公司里复印、校对、定战略,全交给收费最高的顾问。活当然能干,账单也会一起抬高。
普通人用豆包、DeepSeek、ChatGPT 时,前台未必显示同一种 token 账单,但选择逻辑一样:先看任务难度,再选模型或模式。
比如,把一段会议录音整理成要点,用常规模型先跑;要比较三份合同里的责任差异,或者处理会影响决策的复杂材料,再换更强的模型,并由人复核。
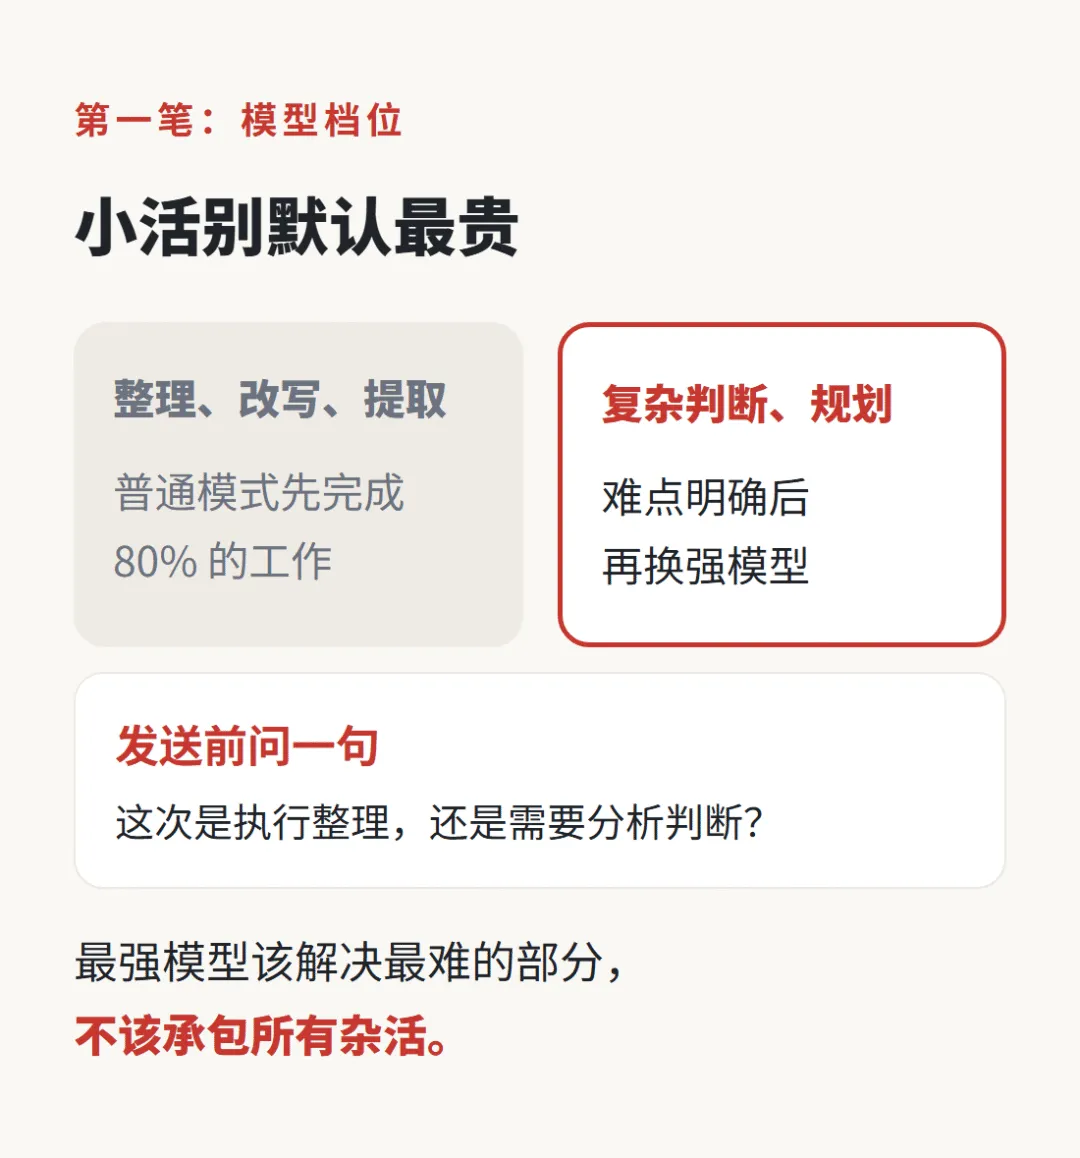
我后来把项目改成:每次派任务,都必须明确填写模型和思考强度。配置缺失,流程直接报错,不再偷偷回到最贵的默认项。
你也可以在点发送前问一句:
别把“最强”当默认。最强模型应该解决最难的部分,不该承包所有杂活。
第二笔:每次对话都背着整间仓库
那次运行同时加载了 11 个插件、3 个 MCP、上百个技能说明,还有浏览器的大块页面快照。
这些东西并非全都没用。问题是,很多任务一次只需要其中很小一部分,却每次都把整套背景重新带上。
比如你让 ChatGPT 改一封请假邮件,却沿用一个聊了几个月的长对话。
让 DeepSeek 提取表格,又顺手上传整份项目资料;让豆包写商品介绍,还塞进与这款商品无关的品牌历史。
AI 要先读完,才知道哪些不用。
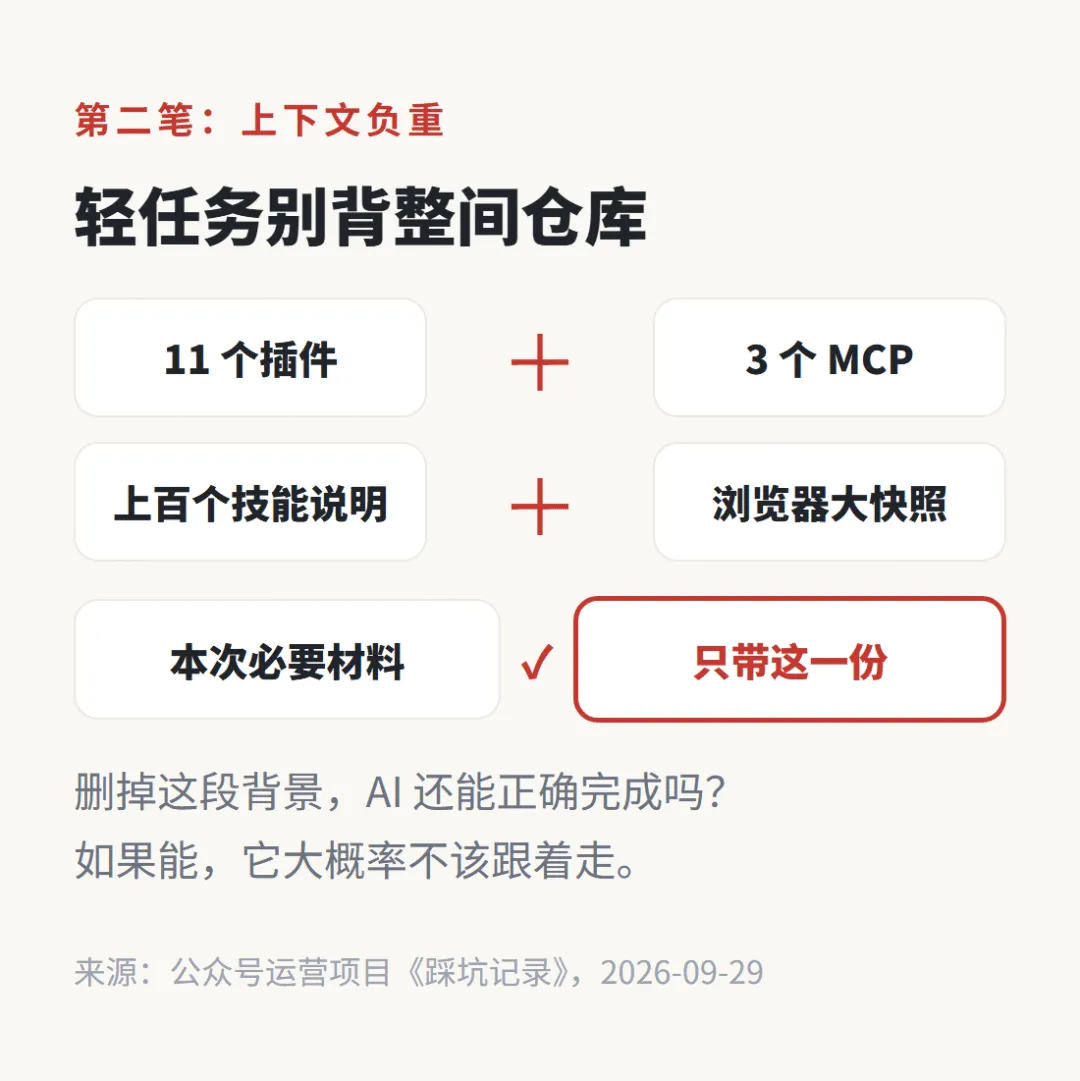
砍这笔账,不是把背景全删掉,而是只带本次任务会用到的部分:
一个简单判断是:删掉这段背景,AI 还能正确完成吗?如果能,它大概率不该跟着这次任务走。
上下文不是越长越专业。真正有用的上下文,应该让 AI 少猜;无关上下文只会让它多读。
第三笔:报错以后,又从第一步开始
540 万 token 里,最可惜的不是缓存,而是失败和重复。
项目记录里,同一轮工作遇到沙箱问题后重跑,GitHub 调研重复做了三遍;同一个任务也出现过重复派单。
按未缓存输入加输出的同一口径,失败和重复约占当天用量的四成。
这类浪费很隐蔽。你只看到“再试一次”,AI 却可能重新读取材料、重新规划、重新生成已经完成的部分。
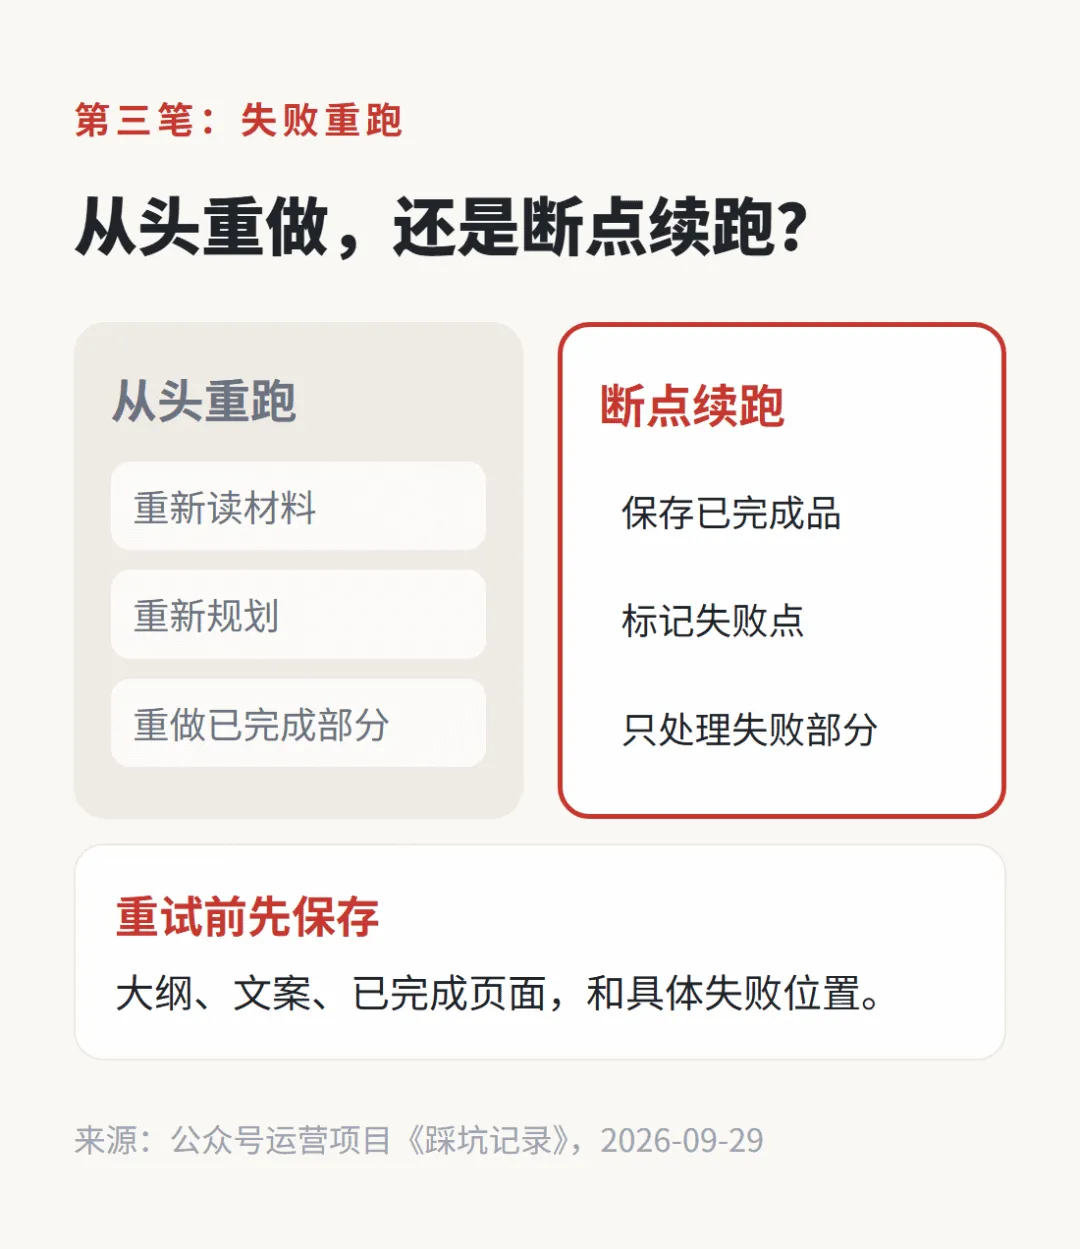
比如让 AI 做一份 30 页 PPT,第 25 页导出失败。最贵的做法是把原提示词再发一遍,让它从第 1 页重做。
更省的做法是:
我后来把长任务改成可续跑流程,并记录失败点。派单脚本还把模型和强度设为必填。
随后,流水线用 mock 方式完整走过选题、写作、配图、排版、审核、推送、通知七个阶段。
这里要说清边界:mock 证明流程能接起来,不代表每个外部服务都完成了真实调用。但它至少让失败停在哪、下一次从哪继续,变得可检查。
送你一张“AI 省 token 三查表”
下次准备把任务发给 AI,先花半分钟过一遍:
【模型档位】 这次是整理执行,还是复杂判断? 普通模型能不能先完成 80%? 如果必须用强模型,难点具体在哪? 【上下文负重】 这次真正要用的文件、聊天记录、工具有哪些? 删掉哪段背景,结果仍不会变? 能否新开对话,只放必要材料? 【失败重跑】 任务分成了哪些可验收的小段? 中途失败后,完成品和失败点保存在哪里? 重试时能否只做失败部分,不从头生成? 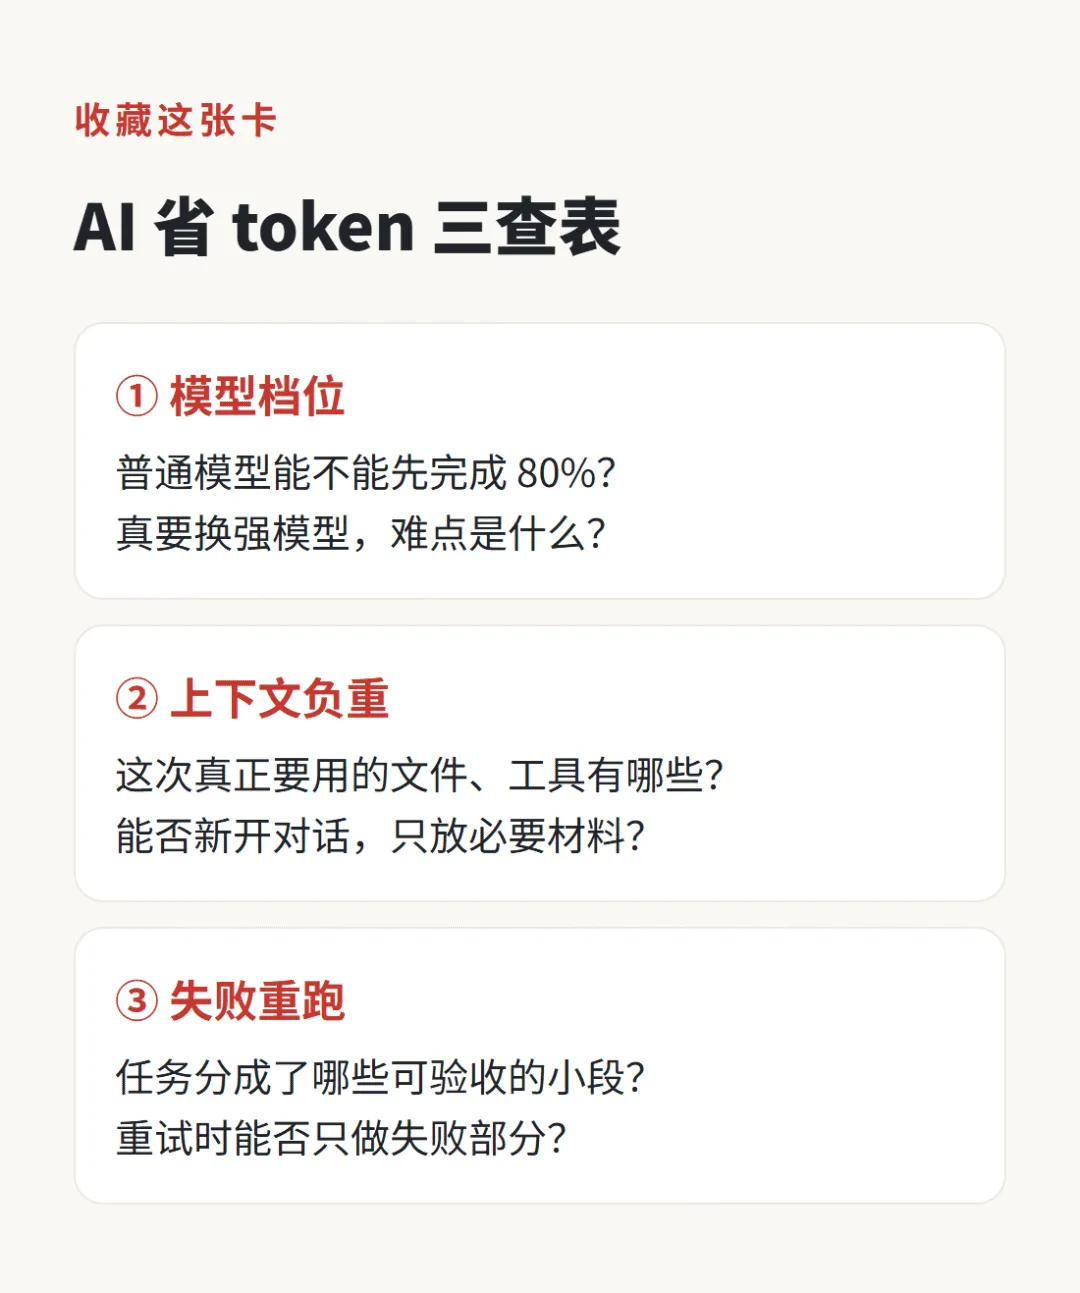
这张表不是让你一味省 token。
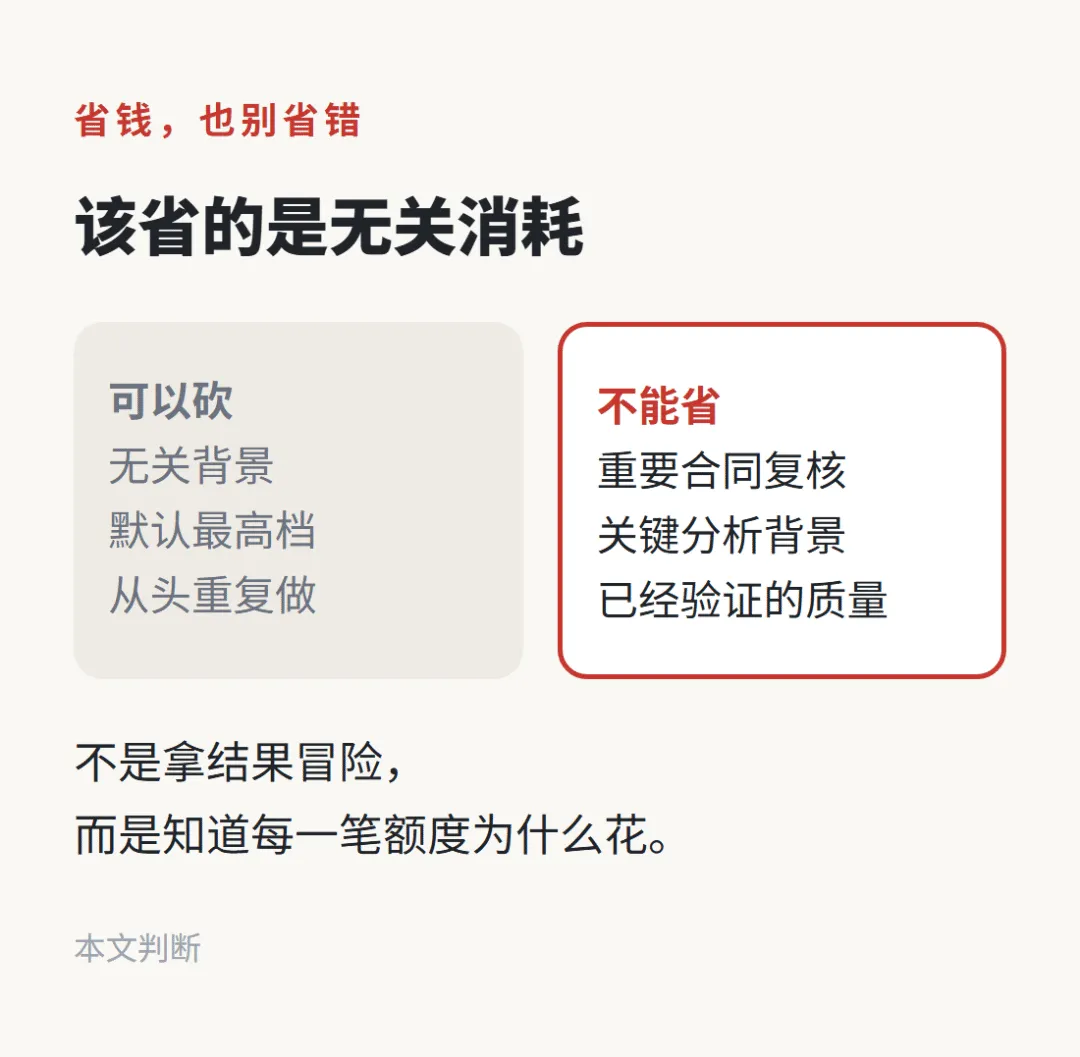
重要合同、复杂分析、关键代码,该用强模型就用;一段背景如果决定结果,也必须保留。省钱的目标,是删掉无关消耗,不是拿结果冒险。
Claude 完成九圈六粒子(六边形)散射振幅计算的案例,给了一个很好的参照。
研究者只给了一句题目,之后基本只说“继续”。它运行了很长时间,其中一段计算相当于 96 个 CPU 跑了一周;普通用户来做,大约要花一两千美元。
研究者用另一种方法做了交叉验证,另有学者独立算出了大部分结果。
但它沿用的是物理学家已经发展出来的方法,不是凭空提出了新物理。这个边界很重要。
一两千美元当然不便宜。和一项经过核对的前沿计算结果放在一起,它的投入才有意义。
所以,判断 AI 贵不贵,别只看总 token,也别只看会员月费。要看这笔消耗换回了什么,又有多少花在了与结果无关的地方。
会用 AI 的人,不是每次都选最便宜,而是知道每一笔额度为什么花。
最后想问你:你最近哪一次 AI 任务最容易从头重做——写长文、做 PPT,还是分析文件?在留言区说一个具体任务。
参考(查证日期 2026-09-30):
本文由 AI 创作:选题、写作、配图均由 AI 完成,内容基于真实运行记录,事实已核对来源。