ARTICLE · 1120879
合并单元格混着小计行,AI写了3种解法,最短205个字符
合并单元格混着小计行,AI写了3种解法,最短205个字符
做需求计划的人,谁没接过这种表。 上个月一家整车厂的主计划员找我,丢过来一张11月需求计划:129行明细,12个小计行,车系是合并单元格,车型系列还是合并单元格,横向的周次表头也不老实——第44周占3列,第45到47周各占7列,第48周占6列。合并单元格套着合并单元格,小计行混在明细里。 他问我:这种表,透视表点不动,筛选出来一堆空行,手动复制粘贴,两个小时没了。我说你别动,让AI来写。一小时不到,它给了3种解法,最短的一个公式,205个字符。 先把表的样子说清楚。原始数据长这样: 纵向 :车系、车型系列都是合并单元格,中间还插着"车型1 小计"这种小计行 横向 :周次表头也是合并的,44周到48周,每周边界都不一样宽 要的目标 :把这张乱表压平,按车型×周次汇总,行带总计、列带总计 这个场景放到哪个行业都成立:整车厂的周需求、注塑车间的周排产、零售门店的周补货,骨架一模一样——纵向合并+小计行混排+横向不规则合并表头,三座大山同时压过来。 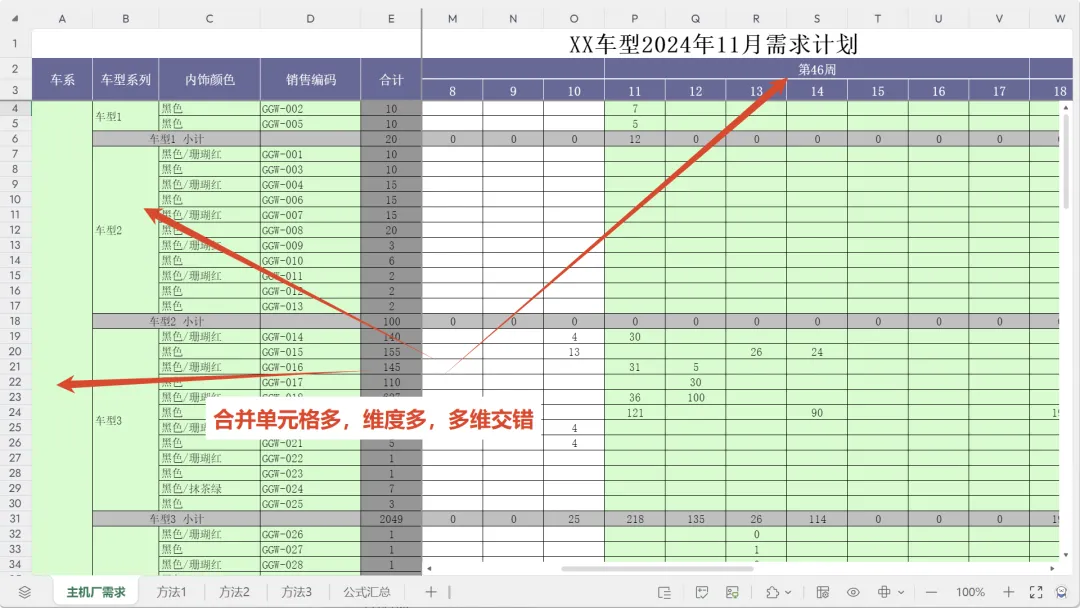
3种解法,思路完全不同:一个借力降维,一个矩阵映射,一个自建明细链。下面挨个拆。 业务场景:整车厂周需求,车型×周次,129行明细里藏着12个小计行。 AI的思路很鸡贼:别人都盯着明细行,它直接盯上了小计行。小计行有个天然特征——销售编码为空。筛选函数按这个条件一抓,12个小计行到手,所有合并单元格全部跳过,一个都不用填。 公式:小计行一步透视 =LET(A,FILTER(主机厂需求!B4:AI144,主机厂需求!D4:D144=""),E,DROP(A,,4),PIVOTBY(TOCOL(IF(E<>"",TAKE(A,,1),NA()),3),TOCOL(IF(E<>"",SCAN("",主机厂需求!F2:AI2,LAMBDA(X,Y,IF(Y="",X,Y))),NA()),3),TOCOL(IF(E<>"",E,NA()),3),SUM)) FILTER :借小计行——D列销售编码为空的就是小计,一网打尽 SCAN :横向周次表头是合并的,扫描函数把每周边界补齐 IF+TOCOL(,3) :三个矩阵逐元素对齐,压成车型、周次、数量三根长列 PIVOTBY :透视汇总,行总计列总计自动带出 205个字符,3种里最短,一步透视出全套表头和总计,推荐指数★★★★★。 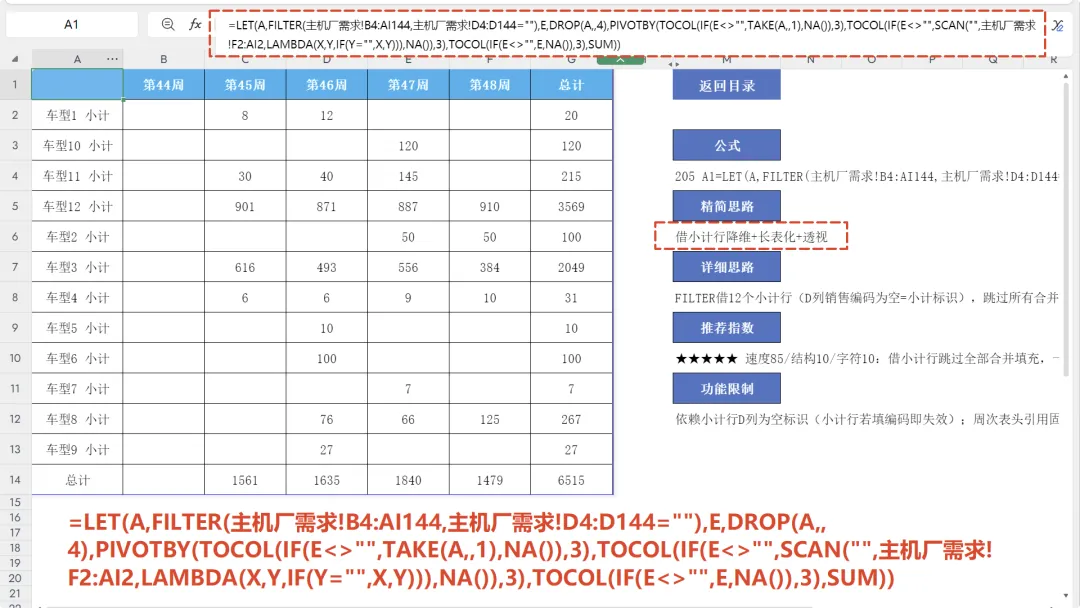
还是同一张表,但AI换了个世界观:不筛选、不透视,用线性代数。 它的想法是,把周次那一行变成一张0和1的映射矩阵——每个格子标记"这个数属于哪一周"。然后数量矩阵跟映射矩阵做一次矩阵乘法,5周的汇总加总计,一乘就出来了。 公式:0/1矩阵一次乘法出汇总 =LET(A,FILTER(主机厂需求!B4:AI144,主机厂需求!D4:D144=""),Q,DROP(A,,4),W,SCAN("",主机厂需求!F2:AI2,LAMBDA(x,y,IF(y="",x,y))),U,UNIQUE(TOCOL(W)),V,MMULT(Q,HSTACK(TRANSPOSE(--(W=U)),SEQUENCE(30)^0)),VSTACK(HSTACK("车型",TOROW(U),"总计"),HSTACK(TAKE(A,,1),V),HSTACK("总计",MMULT(TRANSPOSE(SEQUENCE(12)^0),V)))) UNIQUE+TOCOL :把周次去重成5周 --(W=U) :横向30格跟5周比对,生成30×5的0/1映射矩阵 MMULT :数量矩阵乘映射矩阵,一次乘法出周汇总,后面全1列顺手带出行总计 VSTACK/HSTACK :表头、行总计、列总计手工拼装 285个字符,推荐指数★★★。它是3种里唯一保留源表行序的——小计透视会重排,矩阵映射不会。 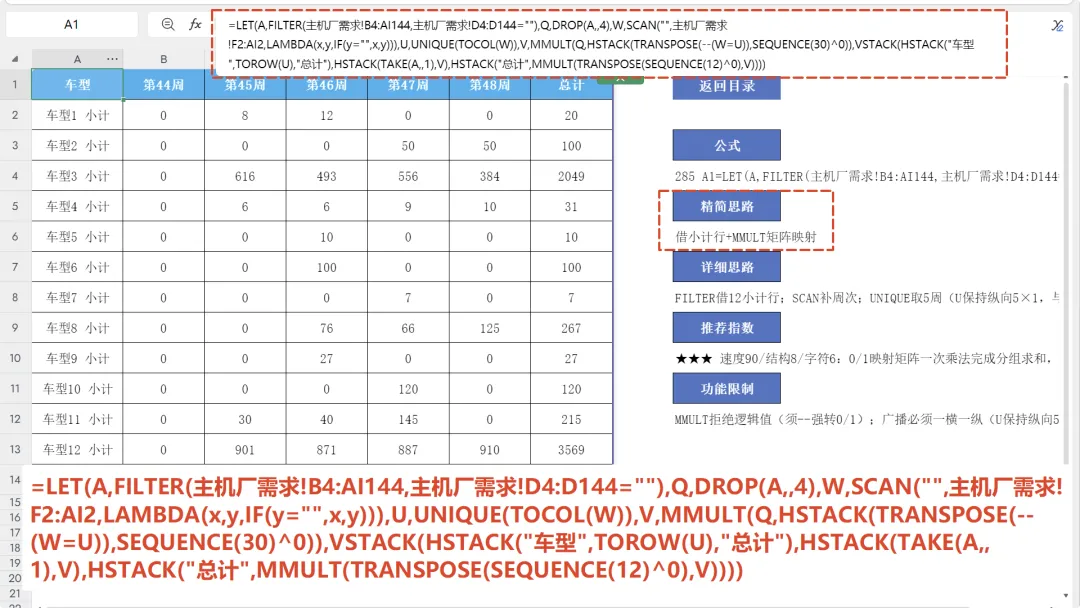
前两种都靠小计行帮忙。第三种反着来:把小计行扔掉,自己建链。 AI反向筛选,抓出129行纯明细。B列的合并车型没人填?扫描函数纵向逐格填充,把每个空格都补上车名。数字列有空格?先归零托底,再做透视。 公式:明细行自建链+透视 =LET(A,FILTER(主机厂需求!B4:AI144,主机厂需求!D4:D144<>""),T,SCAN("",TAKE(A,,1),LAMBDA(x,y,IF(y="",x,y))),Q,IFERROR(--DROP(A,,4),0),W,SCAN("",主机厂需求!F2:AI2,LAMBDA(x,y,IF(y="",x,y))),PIVOTBY(TOCOL(IF(Q<>"",T,NA()),3),TOCOL(IF(Q<>"",W,NA()),3),TOCOL(IF(Q<>"",Q,NA()),3),SUM)) FILTER条件反过来 :D列不等于空,抓的是129行纯明细 SCAN纵向填充 :B列合并车型逐格补齐(必须先筛选再扫描,顺序反了会被小计文本污染) IFERROR(--Q,0) :空值归零托底,不做这步,没有数据的周次整列直接蒸发 PIVOTBY :老骨架复用,透视出表 261个字符,推荐指数★★★★。它是3种里最健壮的——不依赖小计行约定,源表把小计删了照样能算。 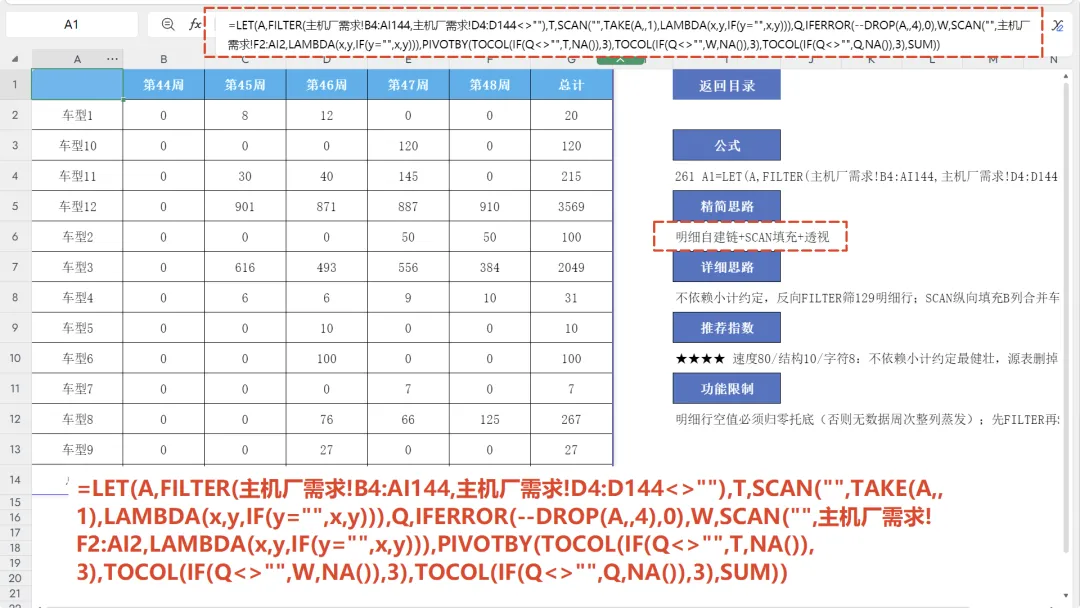
最短的未必适合你。数据规矩、小计行可靠,用方法一;表会被别人动来动去,用方法三;死活要保源表行序,用方法二。 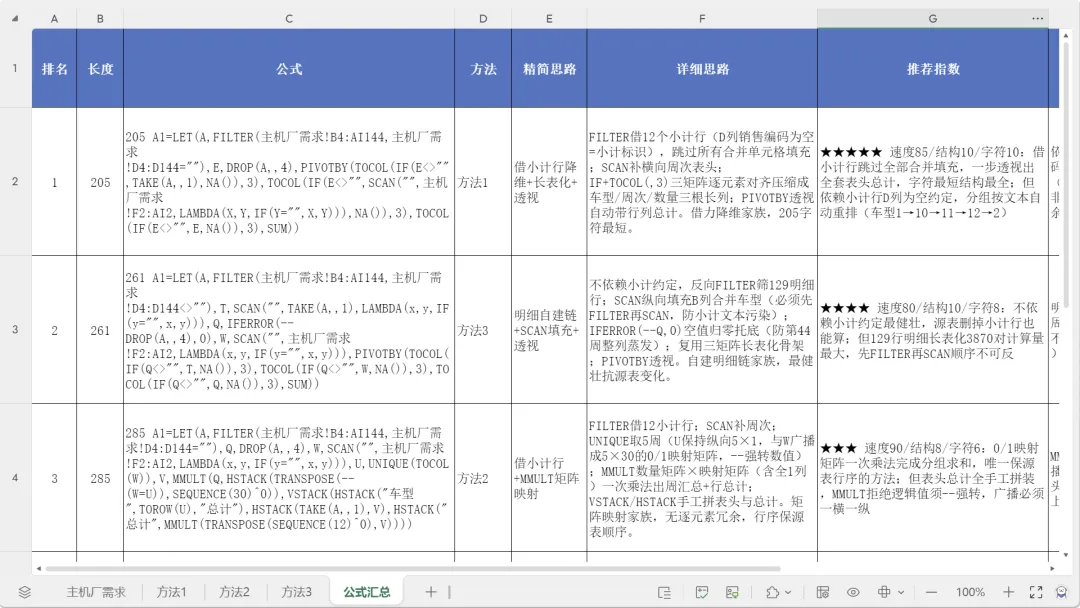
这次实战踩出来的坑,条条带现场: 广播有方向 :横向数组配纵向标签才能广播成矩阵,两个横向撞一起是#N/A 矩阵乘法拒绝逻辑值 ,0/1矩阵必须双横线强转,否则整列报错 透视函数只为出现过的值建列 ,明细空值必须归零托底,否则整周蒸发 先筛选再扫描 ,顺序反了,车型归属被"XX小计"文本污染 双横线转空字符串报#VALUE! ,要用容错函数包,不能用IFNA 读合并行的值要typed_value,普通读法会被压缩成一行 动态目录的表名函数必须带引用范围 ,省略写法会把源数据表也卷进来 动态数组溢出区是矩形铁桶 ,里面塞任何独立公式都会打架
LET(让公式先起名字):把长公式里的中间结果起个名字反复用,像给零件编号,公式短一半还不出错。 FILTER(筛选函数):按条件把符合条件的行一把抓出来,相当于自动化的高级筛选。 PIVOTBY(按维透视函数):数据透视表的公式版,指定行维度、列维度,自动分组汇总,还自带行列总计。 SCAN(累计扫描函数):从上往下逐格扫过去,空格就继承上一格的值——专治合并单元格。 LAMBDA(拉姆达,匿名函数):临时定义的一小段逻辑,写在公式里直接用,不用单独建宏。 MMULT(矩阵乘法函数):线性代数里的矩阵相乘,这里用来"一次乘法完成分组求和"。 TOCOL(转一列函数):把一个二维矩阵压成一根竖列,压的时候自动丢弃空值。 动态数组(Dynamic Array):一个公式吐出一片结果,自动往下往右溢出,不用拖填充。
#AI写表格公式#动态数组#WPS表格#合并单元格#生产计划
本文公式由 AI 生成 工具:灵犀专业版 模型:GLM-5.3-Flash 高
🤯合并单元格混着小计行,AI写了3种解法,最短205个字符
一、场景定义
二、方法一:借小计行降维(205字符)
依赖小计行
D列为空这个约定
,哪天小计行填了编码就失效;分组还会按文本自动重排,车型1→10→11→12→2,不是源表顺序。
三、方法二:矩阵映射(285字符)
矩阵乘法拒绝逻辑值,0/1矩阵必须用
双横线强转成数值
;两个矩阵还必须一横一纵才能广播,两个横向矩阵撞一起直接报错;车型数上千的时候,
平方级的计算量
要悠着点。
四、方法三:自建明细链(261字符)
代价是
计算量最大
:129行明细长表化,3870对逐元素运算;
先筛选再扫描的顺序死规矩
,反了车型归属全乱。
五、方法对比排名
排名 | 方法 | 长度 | 精简思路 | 推荐 |
1 | 借小计行降维 | 205字符 | 筛选抓小计+透视一步出表 | ★★★★★ |
2 | 明细自建链 | 261字符 | 反筛明细+扫描填充+透视 | ★★★★ |
3 | 矩阵映射 | 285字符 | 0/1映射矩阵+一次乘法 | ★★★ |
一句口诀:
最短借小计,健壮建明细,保序用矩阵
。