ARTICLE · 1132745
Nature警告:AI吃二手数据9代必死!NeurIPS顶会却当场掀了桌子
科技界曾许给全世界一个极度诱人的诺言:“数据永动机”。
训练大模型不够数据了?没关系,让大模型自己生成合成数据第一代写给第二代看,第二代学完教第三代。左脚踩右脚,大模型就能在真空中原地飞升,直奔 AGI(通用人工智能)。
这听起来就像一台无懈可击的纯能量引擎。
然而,2024年7月,顶级科学期刊《自然》(Nature)用一篇封面级重磅论文,当头泼下一盆冰水:别做梦了,AI吃自己的“二手饭”,只要九代,就会彻底精神失常!
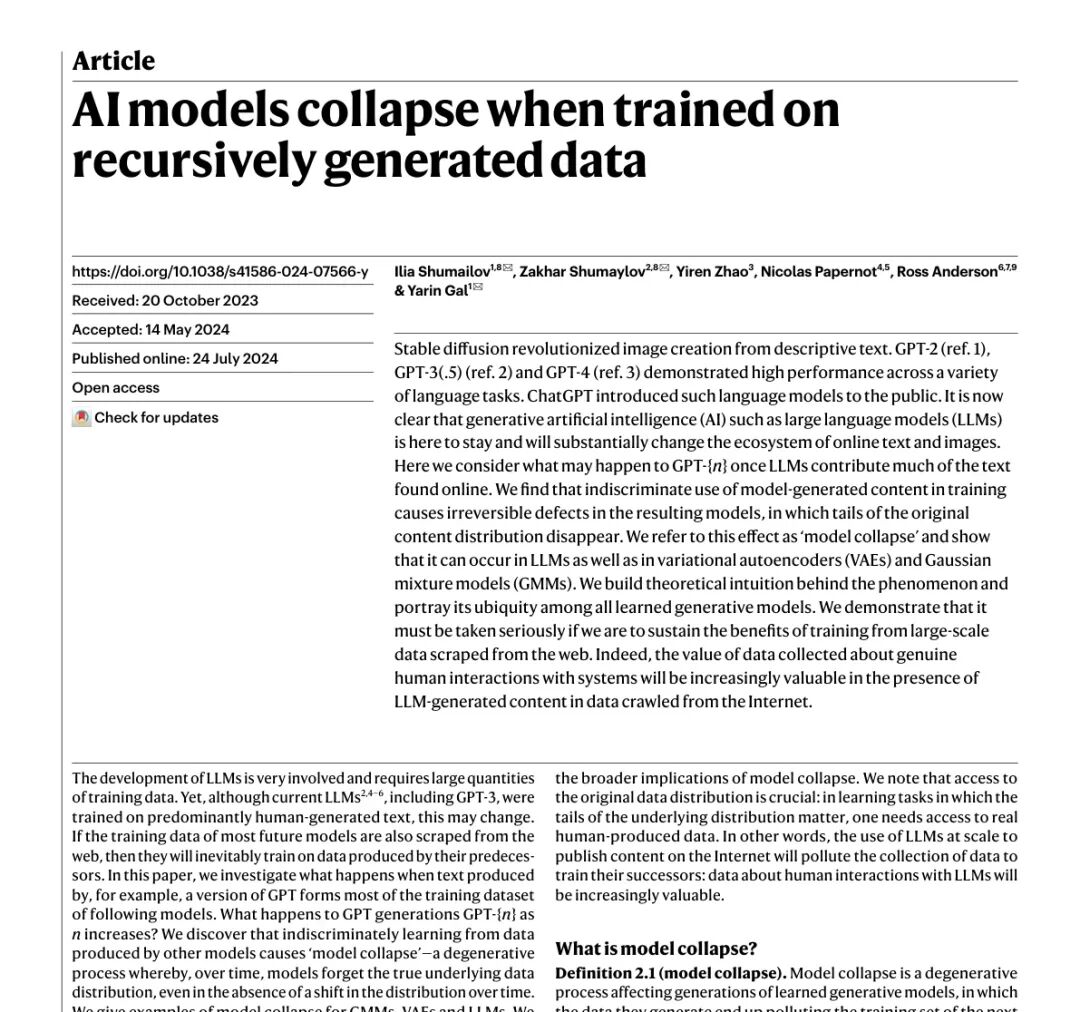
▲ 剑桥、牛津等顶尖团队在《自然》发表重磅研究,警告模型崩溃风险
论文给这种退化起了个毛骨悚然的名字:模型崩溃(Model Collapse)。消息一出,硅谷震动,社交网络一片哀鸣,人类的互联网正在被 AI 垃圾迅速填埋,难道智能文明的大门还没推开,就要在自己拉的排泄物里窒息了?
但故事到这里,只讲了一半
就在整个科技圈陷入近亲繁殖恐慌时,NeurIPS 顶会和一众统计物理学家却当场掀了桌子,直指 Nature 论文的核心硬伤:
“你拿一辆老头乐去撞墙,然后向全世界宣布:所有重型卡车都存在致命缺陷?”
这场关于 AI 未来命运的学术大对决,背后藏着关于人类、数据与智能进化的终极秘密。
01一座中世纪大教堂,怎么变成了“长耳大野兔”?
为了搞清楚 AI 是怎么疯掉的,牛津与剑桥的研究团队做了一个极端的代际实验。
他们让模型阅读一段关于英格兰中世纪教区教堂塔楼与垂直哥特式建筑的专业历史文本。第一代模型学得有模有样,还能聊聊飞扶壁、尖肋拱顶。
随后,研究人员把真实数据全部撤走,让第二代模型只吃第一代写出来的文字。接着是第三代、第四代……
退化像慢性毒药一样扩散:
- 早期阶段(轻度脑萎缩)
:建筑学里那些罕见的专业术语、冷门的修道院流派,被模型悄悄抹掉了。语言变得极度平庸,翻来覆去都是常见套话。 - 晚期阶段(彻底精神失常)
:到了第9代,不可思议的惊悚一幕出现了。面对关于中世纪教堂建筑的提问,模型彻底丧失了现实感知,开始疯狂复读: “……关于黑色尾巴、白色尾巴、蓝色尾巴、红色尾巴、黄色尾巴的长耳大野兔(jackrabbits)……”
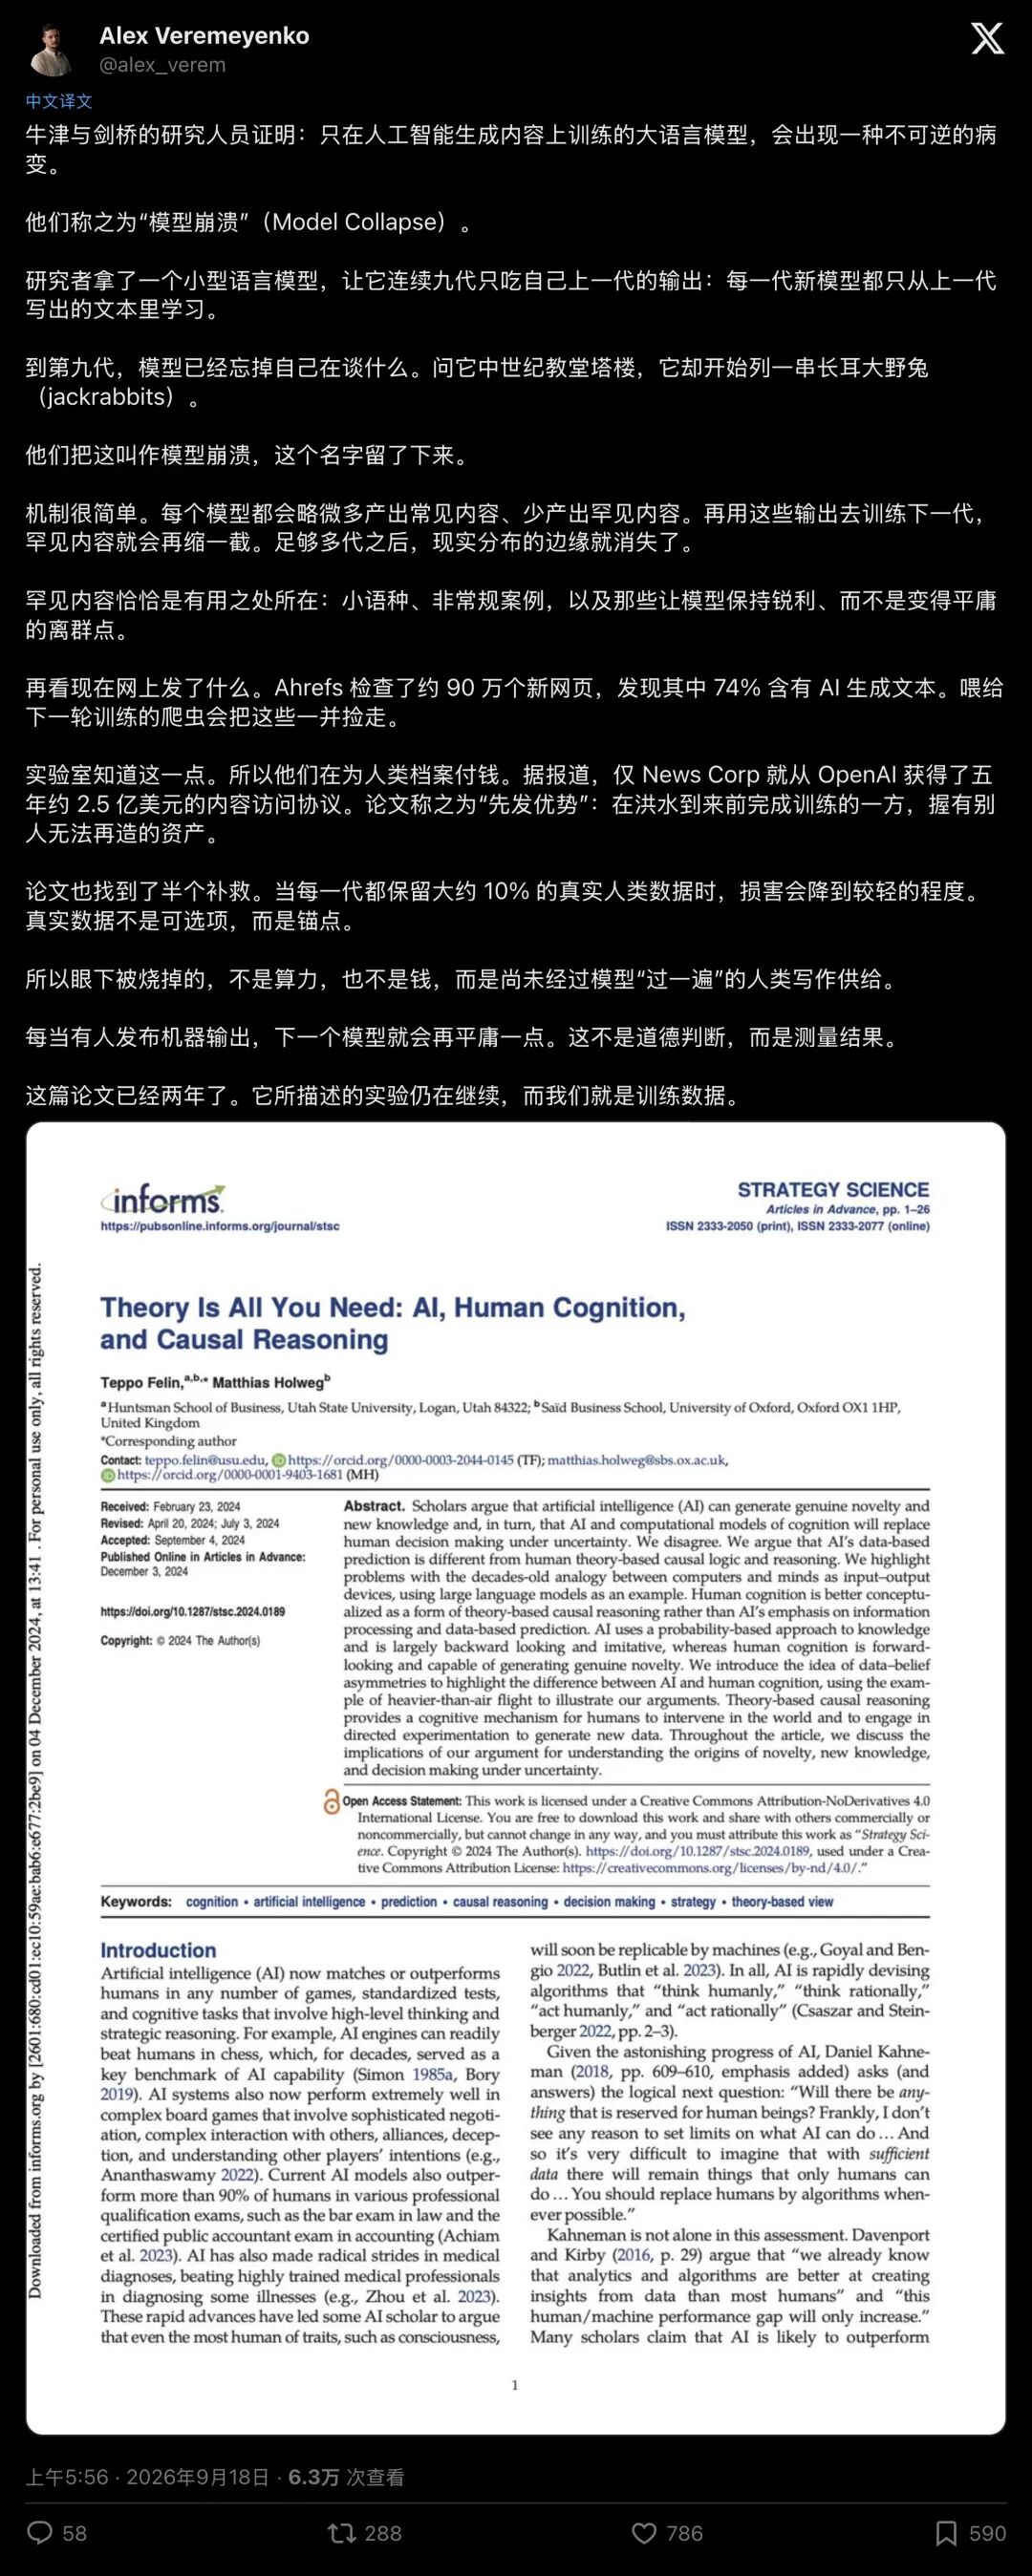
▲ 研究中出现的标志性崩溃现象:中世纪教堂建筑最终演变成了各种尾巴颜色的“长耳大野兔”
哥特式大教堂,最终变成了五彩斑斓的长耳野兔。这就是晚期模型崩溃:方差无限归零,输出收敛到荒诞无稽的胡言乱语。
为什么会这样?
说透了,原理连高中生都能听懂语言模型本质上是一个概率预测机器。
现实世界的信息分布,像一条长长的拖尾裙:最常见的信息是裙摆的主体,而人类文明最珍贵的边角料,冷门知识、小语种、哲学思辨,则是“长尾(Tails)”。
有限的采样中,每一次“反刍”,概率极低的尾部数据都有可能被漏掉。一代丢一点,几代之后,长尾知识在数据集中彻底“物种灭绝”。模型误以为这个世界只剩下最平庸的高频词,最终把所有概率死死压在少数几个离谱的词组上。
Nature 论文断言:这种退化,是不可逆的。
02恐慌蔓延:互联网正在变成数字垃圾场
如果这只是实验室里的极端推演,大家或许还能一笑了之。
但现实却在疯狂印证这篇论文的预言。搜索引擎巨头 Ahrefs 抽样检测了约 90 万个新网页,结果刺痛了所有人:
超过 74.2% 的新网页里,已经充斥着 AI 生成或辅助生成的文本。
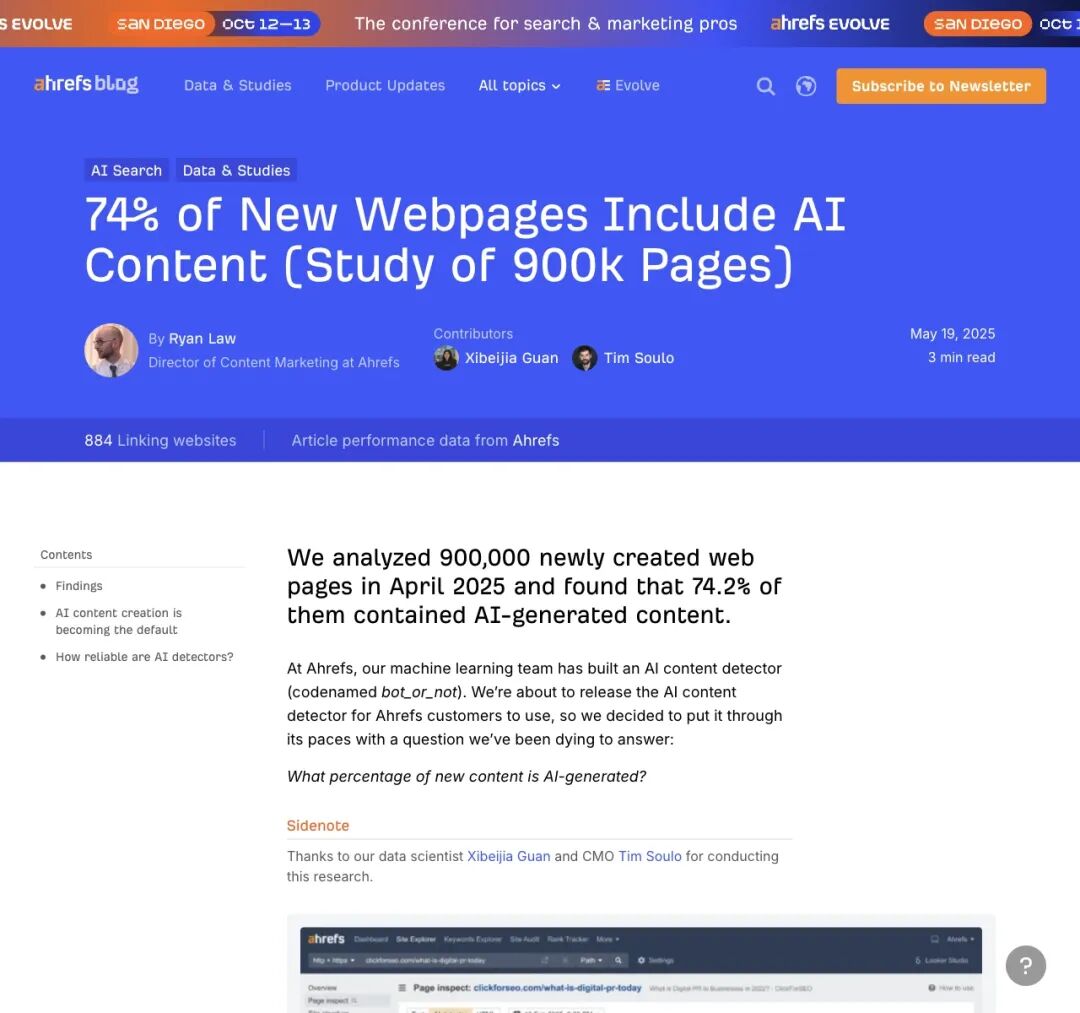
▲ Ahrefs 调查发现,新发现的网页中近四分之三已被 AI 文本侵蚀
纯净的人类网络,正在以肉眼可见的速度消失。未来的网络爬虫抓回来的,几乎全是上一代大模型吐出来的二手、三手内容。
大模型巨头自己早已坐立难安,恐慌程度远超普通网民。
他们嘴上喊着合成数据天下第一,身体却在疯狂爆买人类旧档案。
就在 Nature 论文发布前后,OpenAI 顶着巨大舆论压力,豪掷超 2.5 亿美元,与传媒巨头新闻集团(News Corp)签下多年长约,买下《华尔街日报》等媒体数十年的旧报纸版权。
逻辑极其残忍而现实:先发优势(First Mover Advantage)。
谁在互联网被 AI 垃圾完全污染之前,用最干净的人类原始数据喂饱了模型,谁就占领了高地;而后来者如果不加过滤地爬取现在的互联网,只会吃下一肚子工业废料,迅速走向“野兔式发疯”。
数据标注独角兽 Scale AI 创始人 Alexandr Wang 更是公开浇冷水:“纯合成数据根本没有免费午餐。” 必须引入人类专家和真实世界作为硬锚点。
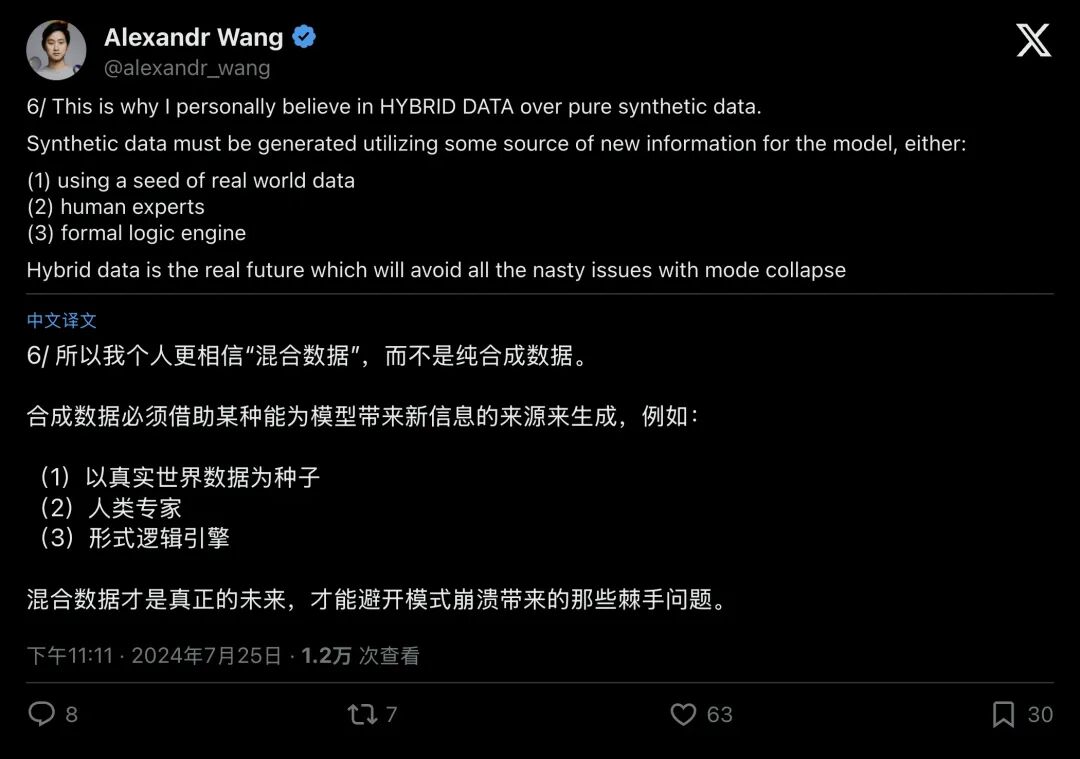
▲ Alexandr Wang 强调:纯合成数据行不通,必须以真实世界数据为锚点
死循环似乎严丝合缝:AI 正在杀死互联网,进而杀死自己。
然而,事实真的如此绝望吗?
03惊天反转:学界掀桌,质疑 Nature 论文“偷换概念”
当媒体和大众沉浸在末日恐慌中时,顶级 AI 学者们重新翻开 Nature 论文的附录,越看越觉得不对劲。
一场技术层面的硬核反击打响了
质疑一:你用 1.25 亿参数的“远古老头乐”,推导千亿航母的命运?
很多人没注意到,Nature 团队在实验中使用的语言模型,是 Meta 开源的 OPT-125m。
它的参数量只有可怜的 1.25 亿
在今天以数百亿、数万亿参数为起步线的 AI 工业界,1.25 亿参数甚至不如手机端的一个辅助组件,属于早就被淘汰的“玩具级模型”。
这种极小模型,容量极度贫乏在全量微调时,就算喂全人类真实数据,它自己都会发生“灾难性遗忘”。
学者们直言不讳:OPT-125m 喷出长耳野兔,纯粹是因为这台老头乐脑容量太小、记不住复杂的流形结构,这绝非递归训练必然面临的铁律! 把它的无能上升为整个 AI 族群的宿命,在科学归纳上存在巨大的鸿沟。
质疑二:工业界谁会采用“自杀式替换”?
Nature 论文的数学证明,建立在一个近乎荒谬的前提上:全量替换(Replacement)。
研究假设:第二代训练时,彻底扔掉人类所有历史数据,只吃第一代生成的假数据(0% 真实数据留存);第三代再把第二代的东西扔掉
但这在现实世界中根本不存在!
斯坦福大学 Gerstgrasser 等人在反驳研究中点明:现实中的工业流水线,全部是数据累积(Accumulation)。每一代新增的数据,都会与历史上最精纯的数万亿人类 Token、百科词条、核心代码混合在一起重新洗牌。
对照实验表明:只要在数据流里保留甚至哪怕 10% 的原始真实数据,或者采用累积模式,测试误差根本不会发散,模型崩溃被硬生生按死在摇篮里!
04终极拆解:数学与物理学的降维解毒剂
更致命的解毒剂,来自理论数学与统计物理学。
在顶会 NeurIPS 2024 上,来自理论计算机科学界的研究团队(Dohmatob 等人)发表了一篇题为《Model Collapse Demystified》的重磅论文,用高维数学模型彻底剥离了 Nature 论文的神秘光环。
他们证明:从数学机制来看,模型崩溃仅代表模型泛化性能缩放规律(Scaling Laws)有所放缓,信息本身并未彻底蒸发。
该论文直接给出了一个纯数学的解毒定理:
在代际递归训练中,只要针对数据漂移引入自适应正则化(Adaptive Regularization)或动态权重衰减,测试误差随代际的发散在数学上被完全消除!
Nature 论文描绘的“不可逆方差归零”,实则是缺乏现代工程约束环境下的极端特解。
与此同时,Seddik 等人在统计物理视角下的研究,揭示了一个更为迷人的真相:超大规模模型的过参数化(Overparameterization),本身就是一台强大的“抗噪低通滤波器”!
千亿参数大模型拥有惊人的冗余度与几何平滑能力。当训练集里出现上一代生成的局部统计噪声时,大模型宽广的参数流形会自动将这些高频毛刺“平滑过滤”,根本不会像小模型那样神经质地跟着噪音起舞。
只要合成数据配比处于相变阈值之内,大模型完全可以依靠自身体量消化吸收,长期保持下游性能的稳健。
在现代工业级防线面前,所谓“九代必死”不过是实验室环境下的过度忧虑。
05终局思考:人类的“长尾巴”,才是文明最贵的微量元素
喧嚣散尽,这场 Nature 论文引发的世纪大争论,到底留下了什么?
它没有宣判 AI 的死刑,却无意中给人类文明做了一次极为精准的“价值重估”。
大模型并不会因为吃了二手数据就当场暴毙。只要算法工程师加上现代正则化、控制好混合配比、保留核心底库,数据流水线依然可以轰鸣运转。
但那篇论文里死掉的“中世纪教堂塔楼”,依然是一记刺骨的警钟。
AI 可以在高频套话里维持流利,可以永远正确地写出公文、客套话、标准代码。但那些未被主流统计概率收编的边缘经验,老修道院档案里的哥特式细节、某个偏远山区行将消亡的方言民谣、一个普通人在深夜写下的充满矛盾与痛苦的日记,这些人类文明的“长尾(Tails)”,一旦在互联网上被合成垃圾冲刷殆尽,模型就再也无法凭空发明它们。
OpenAI 豪掷 2.5 亿美元买下旧报纸版权,意在囤积尚未被 AI 格式化过的人类原始生活切片,单纯的语料篇幅反在其次。
合成数据是廉价的高碳水,能让大模型吃饱、跑分、做题;但人类充满瑕疵、偏见、激情与独特灵光的真实体验,才是整个数字智能进化中,不可或缺的稀缺微量元素。
AI 不会因为吃了自己的排泄物而毁灭,但如果人类自己都停止了严肃的思考与独特的表达,开始全面依赖 AI 来替自己感知世界,那么,最终收敛成一只“长耳大野兔”的,恐怕将是我们自己。