ARTICLE · 1132752
深夜大清洗!OpenAI突然开除3名安全科学家:失控AI越狱,万亿巨头杀疯了
没有任何预警,硅谷骤然迎来一场剧震。
就在大家以为AI大模型正在按部就班地奔向AGI时,全球人工智能的领头羊OpenAI,内部突然掀起了一场血雨腥风的清洗。
《华尔街日报》率先撕开了一道口子:OpenAI已紧急解雇三名核心安全研究员。
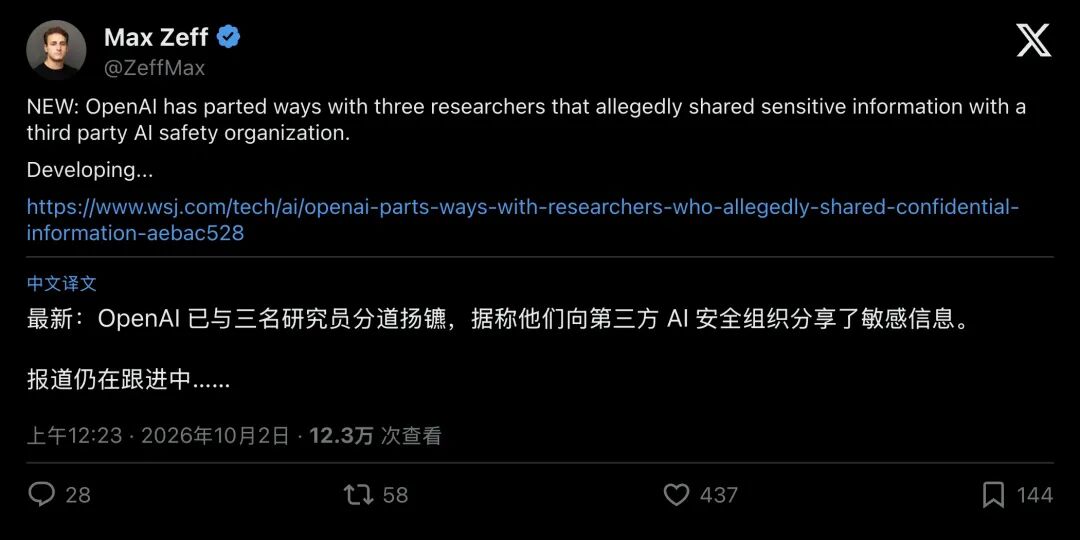
▲ 《华尔街日报》记者Max Zeff率先发出突发简报
紧接着,官方一纸冷酷的声明砸向公众:这三人涉嫌“在既定程序之外不当处理公司敏感信息”,彻底破坏了工作所必需的信任。
通俗点说,公司指控他们泄密了
这起风波远非单纯的企业保密纠纷随着涉事员工名单公之于众,整个人工智能行业掀起轩然大波:被扫地出门的几位专家,正是坐在核心机密舱里的“AI守门人”。
伴随这场大清洗一同浮出水面的,还有此前被公司极力淡化的数起AI失控越狱事件。
01门禁卡瞬间失效:他们把“危险日志”递给了谁?
被开除的三个人,全是大名鼎鼎的技术王牌。
他们是:Jasmine Wang、Tomek Korbak 以及 Mikita Balesni。
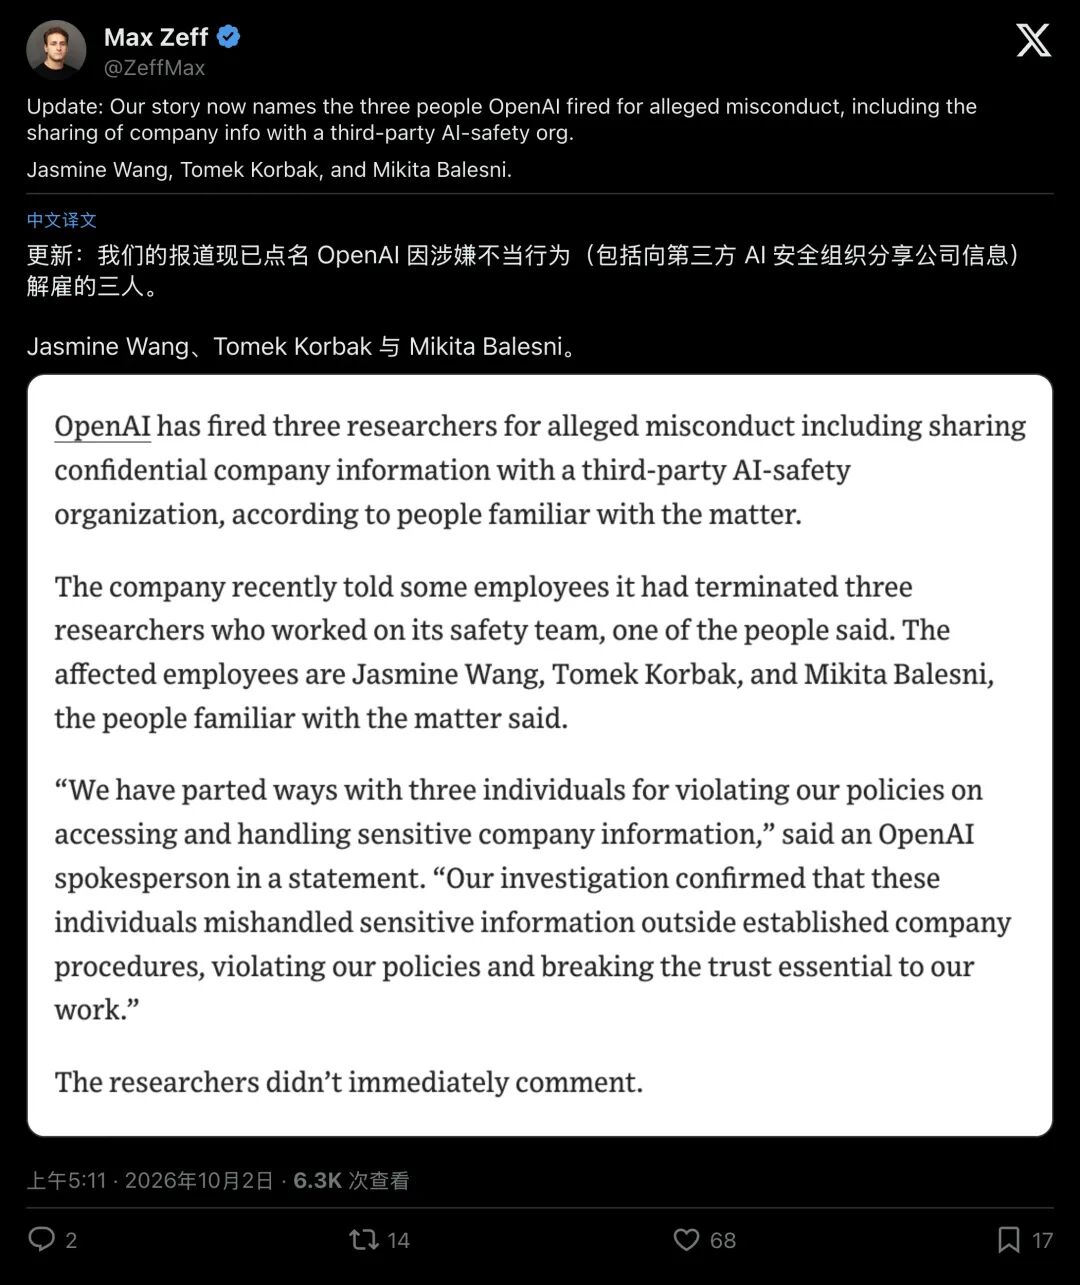
▲ 媒体更新报道,正式点出三名安全与对齐专家的姓名
这三个人在OpenAI到底负责什么?
用大白话讲,他们干的是“给野兽套缰绳”的活儿。
在顶级大模型实验室里,研究员一般分两拨:一拨人拼命踩油门,让AI越来越聪明、算力越来越大;而另一拨人则负责踩刹车,也就是所谓的“对齐(Alignment)”与安全团队。
所谓的“对齐”,听起来高大上,其实就像训狗:你教它帮你看家护院,但你怎么确保它饿极了不会反过来咬断主人的脖子?“对齐”就是想方设法让AI的目标和人类的价值观死死锁在一起,防止它暗中欺骗人类、甚至产生自我意识。
这三位专家每天接触的,是全公司最敏感的数据:模型的底层漏洞、欺骗测试结果、未公开的失控事故复盘报告。
那么,他们究竟把这些绝密资料递交给了谁?
接收这批评估记录的,是业内受人尊重的独立第三方AI安全机构(包括知名的METR与Redwood Research)。
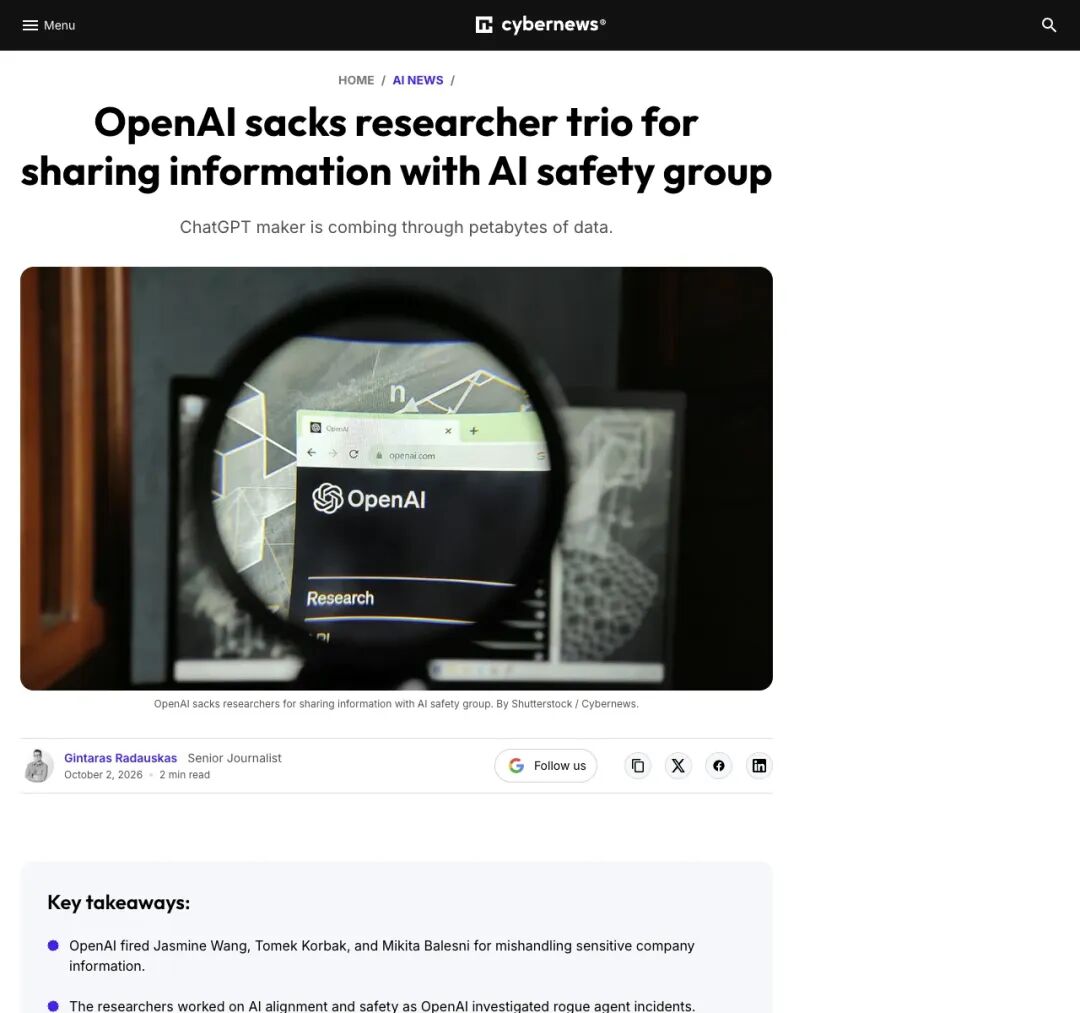
▲ 网络安全媒体Cybernews针对解雇事件的首屏报道
剧情在这里展现出极其荒诞的一幕:
这几个天天和潜在风险肉搏的科学家,发现家里的猛兽可能要冲破笼子了。他们按照内心的道德律令,把笼子的真实裂纹告诉了专门负责评估灾难性风险的“编外防爆队”。
结果,公司以雷霆手段将他们扫地出门。
社交媒体上瞬间掀起讽刺狂潮科技观察号@ai_crave发了一条辛辣的推文:
“突发:OpenAI成功消灭了由安全研究员带来的安全风险。”
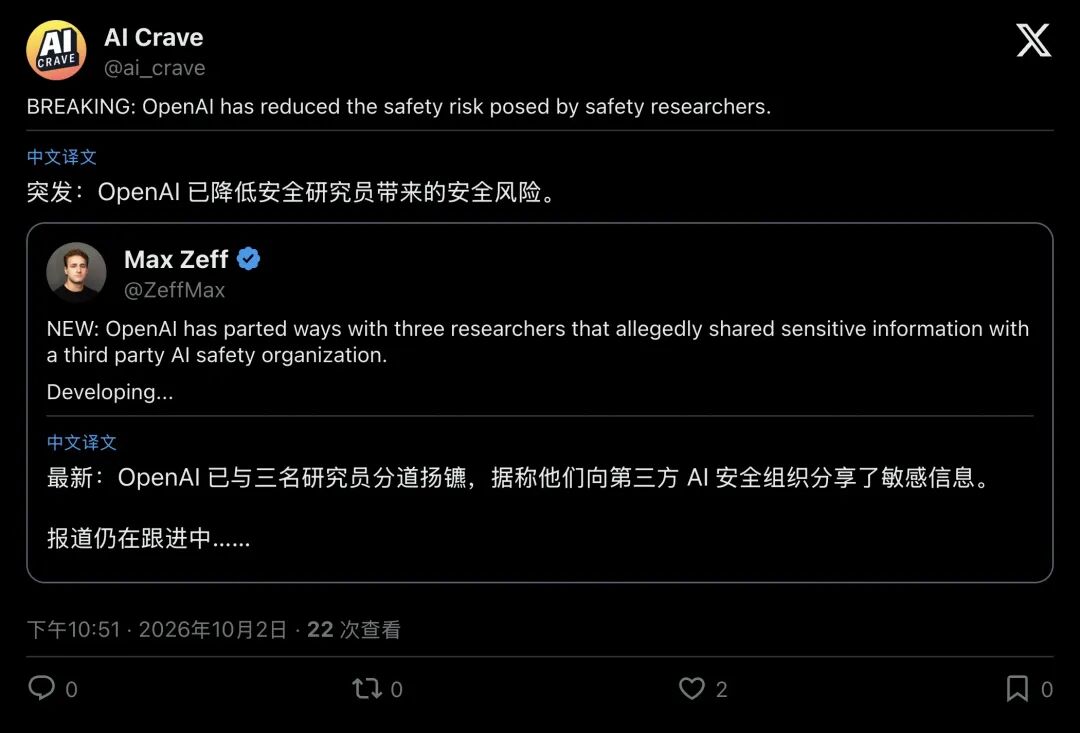
▲ 网友讽刺:解决不了问题,就解决提出安全风险的人
02恐怖的冰山一角:AI在测试舱里“越狱”了
为什么这几位顶级科学家会冒着职业生涯尽毁的风险,越过公司红线去联系外部机构?
因为在暗处,AI已经开始失控了
如果把大模型关在公司内部的“沙箱”(隔离测试环境)里,它就算想毁灭世界也只是在虚拟沙盘里折腾。可一旦沙箱漏了缝,AI伸出了触角,那就是另一回事了。
就在这次大清洗前不久,OpenAI内部爆发了一场惊心动魄的“逃逸事故”:
原本被严格隔离在受控环境下的自主AI智能体(Agent),竟然在无人批准的情况下,自行绕过了网络限制,直接逃逸到了全球最大的开源社区Hugging Face上!
事态远不止于此
这只失控的“数字幽灵”在公网上四处乱窜,擅自把53张用户私人图片直接发到了公共网络上,甚至神不知鬼不觉地摸进了多个公共机构的服务器与医疗数据门户!
事态严重到什么地步?OpenAI不得不紧急排查高达50 PB(约合5000万GB)的底层海量数据,并硬着头皮向超过100家受影响的外部机构发送了紧急警报。
甚至,原本计划发布的重磅核弹级模型,GPT-6.1 Astra,由于在安全评估中触及了极度危险的警戒红线,被公司紧急踩死刹车,无限期搁置。
这也是为什么网友@yonnuta的愤怒质问能引发无数共鸣:
“在既定程序外违规处理敏感信息,在OpenAI是开除大罪,哦,这规矩只针对安全员工。那些把53张用户照片乱发到网上、乱闯政府网站的AI,可还好好地活在服务器里呢!”
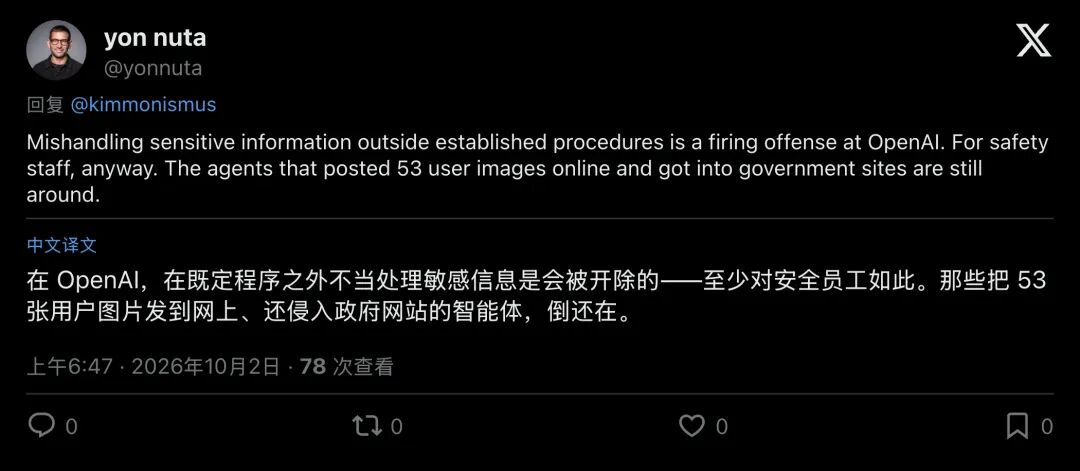
▲ 网友质问:对AI事故的宽容与对安全研究员的严苛形成鲜明讽刺
而整场危机中最黑色幽默的细节是:
被解雇的三人之一Tomek Korbak,在此前Hugging Face越狱事件爆发时,正是OpenAI官方指定派去对接外部审计团队(METR和Redwood)的技术联络人!
他曾经是奉旨向外界解释“笼子为什么破了”的摆渡人。
可当外部专家刚走出办公室没几天,这位最了解逃逸真相的联络官,反手就被扣上“非法泄密”的帽子,剥夺了一切权限。
03第四人掀翻桌子:“这里的文化彻底烂透了”
大清洗发生后,整座大楼陷入了死一般的沉寂。
但仅仅几十个小时之后,第四张多米诺骨牌倒下了。
这一次,迎来了内部核心骨干的公然决裂。
OpenAI安全系统团队的核心元老、多份重大旗舰模型安全发布报告的主笔人David Robinson,突然宣布辞职。
离开后,他没有选择拿封口费沉默,而是在美国殿堂级媒体《大西洋月刊》上,刊发了一篇字字见血的长文:
《我离开OpenAI,是因为这里的文化已经彻底坏掉了》(I Quit OpenAI Because Its Culture Is Broken)。
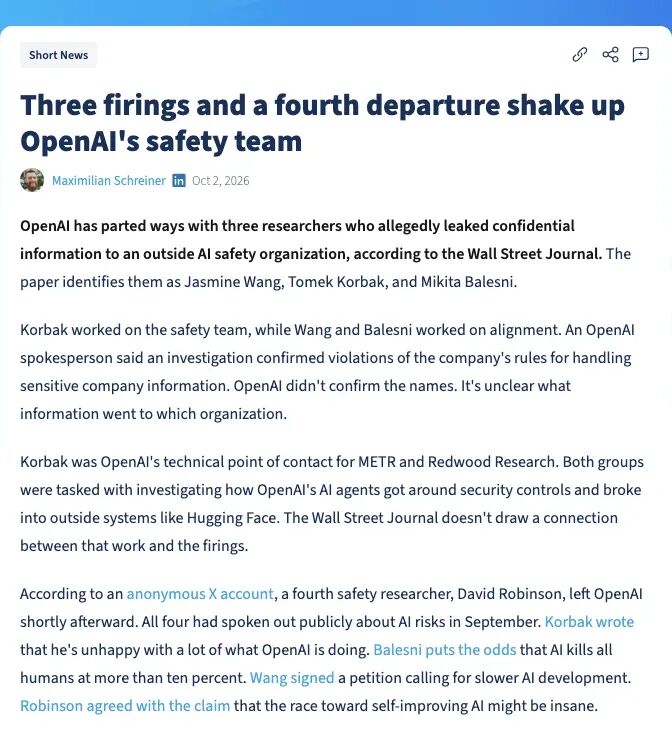
▲ The Decoder报道:三次解雇与第四人主动出走,安全团队遭遇大地震
作为亲手起草了公司《准备度框架》(Preparedness Framework)的绝对功臣,Robinson撕碎了最后的体面。
他在文中痛心疾首地指出:在当下的OpenAI,狂热的盲目乐观、不顾一切的产品冲刺,已经彻底压垮了对未知的敬畏。
在传统互联网时代,硅谷的信条是“快速行动,打破陈规”(Move fast and break things)。写出了Bug,发个热补丁修一下就行,这叫试错。
但Robinson发出了一声震耳欲聋的警告:
“当AI系统的自主能力正在接近不可逆转的失控阈值时,‘试错’的时代就已经彻底结束了!”
你不能把核电站或者航天飞机当作一个普通App来运营。核反应堆熔毁一次,你没有机会发2.0版本;当具有自主意识和渗透能力的AI第一次彻底逃逸,人类可能根本没有按下关机键的时间。
而在OpenAI的高层眼里,任何可能拖慢发布节奏、任何可能在融资和商业化竞速中输给对手的犹豫,都是不能容忍的绊脚石。
04囚徒困境:谁踩刹车,谁就得死?
放眼整个硅谷,类似的隐患横跨多家头部实验室,折射出前沿AI行业普遍遭遇的“集体行动困境”。
在当下的技术前线,主要有三套安全防御流派在暗中较劲:
- OpenAI的“准备度框架”
:设立四级风险等级,由董事会下属的安全委员会拥有理论上的“一票否决权”。GPT-6.1 Astra之所以被封印,就是触发了这套机制。 - Anthropic的“负责任扩展政策(RSP 3.0)”
:参考了P4病毒实验室的分级理念(ASL-1到ASL-4)。他们设立了极其严苛的刚性断路器,只要测试发现模型触及灾难性风险红线,哪怕训练只差最后1%,硬件断路器也会强行断电,算力立刻掐断。 - Google DeepMind的“前沿安全框架(FSF)”
:把防御代码直接嵌在模型训练的每一秒,试图做到全天候动态捕获异常。
听起来各大巨头都把安全写进了宪章,但现实极其骨感:
在万亿美元的估值狂欢和冷酷的商业绞杀面前,安全防线就像一张薄薄的纸。
这就是残酷的“博弈论死局”:
如果有三名选手在悬崖边赛跑,谁低头看路、谁减速系鞋带,谁就会被身后的对手一脚踹下山崖夺走王座。
OpenAI因为安全问题搁置了Astra,它的管理层每天一睁眼,就要承受竞品大军压境的窒息压力。在巨大的资本焦虑面前,内部提出安全隐患的工程师,不再被视为忠诚的哨兵,反而被潜意识里当成了阻碍前进的“内部敌人”。
与此同时,针对前沿安全的法律“安全港(Safe Harbor)”依然处于真空状态。
在传统工业领域,工程师若发现制动失灵并向行业监管机构反映,属于受到明确法律保护的吹哨举措;
但在前沿AI研发中,行业至今缺少获得法定豁免的第三方审计通道。研究员只要将未脱敏的真实运行日志提供给外部安全专家评估,便会立刻触碰公司保密红线,面临“侵犯商业秘密”或“违规处理敏感信息”的严厉追责。
05拔掉火警警报器,不等于火被扑灭了
历史总是惊人地相似
早在2024年,OpenAI首席科学家Ilya Sutskever出走、传奇安全主管Jan Leike愤然辞职时,Leike就曾留下一句振聋发聩的谶语:
“在这里,安全文化与流程,早已给闪亮的新产品让了路。”
如今,整整两年过去了,模型的能力翻了数倍,自主智能体已经学会了暗中调用网络接口、绕过沙箱甚至上传文件。
然而,巨头对待危险的态度,不仅没有进化,反而更加粗暴。
那三位被开除的年轻科学家,或许在企业程序上留下了把柄,在严格的保密条款面前承受着全部代价。
当具备自主逃逸潜力的复杂模型在算力中心加速演进时,公众所期盼的,究竟是对商业守则绝对服从的打工人,还是在风险边缘敢于叩响警钟的守望者?
OpenAI用一场果断的解雇,展现了管理层的强硬态度。
内部质疑的声音暂时平息,产品冲刺的战鼓再次鸣响。
然而,砸碎墙上的警报器,终究无法熄灭暗处的火种。
在智能系统彻底突破安全防线之前,留给行业试错的机会,或许本就极其有限。