ARTICLE · 1132790
KaLM-Jev 装进本地:下载、部署、跑分全记录
我把 KaLM-Jev 下下来,在一台没有独显的 Windows 机器上跑通了。官方对它的定位是一个「本地判断引擎」。
我拿 8 条餐饮评价问了它 48 道判断题,它答对 30 道。
下面是完整的下载、部署、实测过程,每一步都给了可以照着跑的代码,也包括官方参数表里没写的那部分。
01 先说结论
三个数字先摆出来:
· 官方自带的那套 36 条双语题,它拿到 21 分,58.3%。
· 我自己出的 8 条餐饮评价、48 个判断,它拿到 30 分,62.5%。
· 加载完模型之后,它吃掉 3572 MB 内存,峰值 5070 MB。
这几个数字放在一起,答案就清楚了:它能跑,装起来也不难,但你别指望用 0.27B 的模型替你把评价分拣抄了。
它能用的地方是那种「几乎不费力」的判断。同一批数据里,判断一条评价里有没有食品安全问题,它 8 条里对 6 条;判断一条评价是不是刷单式的空话,8 条里对 7 条。这两个任务特征词很硬,「头发」「馊」「拉了两次肚子」这类词一出现答案就定了。
它不行的地方是那种要理解语气和分寸的活。同样 8 条评价,让它打分,它只对 2 条。一条通篇在夸的红烧肉,它判成了负面。
我这台机器的配置写在下面,后面所有耗时和内存都以它为准:
· Windows,AMD Ryzen,16 个逻辑核心
· 内存 30.8 GB,开机后可用 6.5 GB
· 没有独立显卡,torch 是 CPU 版
· Python 3.13.14
顺便说清楚数据来源。本文的数字分三类:官方仓库里 results/ 目录下记录的跑分结果、我自己在同一台机器上跑出来的结果、以及从下载下来的权重文件里直接读出来的结构信息。三类我都会标出来。第三方的部署教程我也看过一份,里面有几处和实测对不上,后面会讲。
得先交代一下它的处境。KaLM-Jev 是 KaLM-Embedding 家族的新支线,2026 年 9 月 21 日建库,当天推完代码就没再动过,到现在 37 个 star、2 个 fork,没有 issue;整个组织 6 个仓库加起来 56 个 star,它占 37。
但家族本身不冷:主线是 embedding 模型,Hugging Face 上的下载量上万,其中最高的 12B 版本,发布账号挂的是 tencent。Jev 是它往「判断」方向的一次试水,中文网络上我还没看到有人自己把它跑通,所以才有了下面这些。
02 它是什么,以及参数表里没写的东西
KaLM-Jev 做的事情一句话能说清:你不给它问题让它写答案,你给它一段「状态」和几个「类型化的问题」,它只回概率和选项。
问题只有三种形状,官方叫 Choice / Score / Noul。
· Choice:从一组固定选项里挑一个。选项是带名字的,你写 positive / neutral / negative,它回一组概率加一个最优选项。
· Score:在一个有序的等级上打分。你给 5 个档位的文字描述,它回一个期望档位和每个档位的概率。
· Noul:回答是或否。可以一次问好几个条件,每个条件独立给一个 0 到 1 的数。
三种问题可以在一次请求里一起问,结果是一起回来的。
值得说一句的是输出。官方 README 里有一行很关键:output_tokens = 0。这不代表它不计算,推理照样跑,只是不生成任何文字。这就是它比大模型便宜、快、稳定的地方:省掉的是生成那一段,而生成那一段也是大模型最不可控的部分。
下面这一段是参数表里没写的。
官方和第三方都把 Nano 描述成 0.27B 参数。我下载了权重,直接读了 safetensors 的文件头。里面是 911 个张量、786.0M 个参数,BF16,文件 1.57 GB。拆开是这样:
口径就对上了:文本那一半是 100.3 + 167.8 = 268 M,也就是官方说的 0.27B。剩下 416.9 M 是一个 SigLIP 视觉塔,占了总参数的一半以上,而官方文档从没提过它。
我没在官方资料里找到关于这个视觉塔的说明。我的推测是它跟着底座模型一起被带下来的——从 config.json 看,编码器的文本部分 hidden 640、18 层、intermediate 2048、4 个注意力头、1 个 KV 头、head_dim 256、词表 262144,这组数字和 Gemma 3 270M 完全一致,所以底座应该是把 Gemma 3 改成了编码器-解码器结构。但这只是读配置推出来的,官方没确认。
顺带纠一处第三方的错。有份流传的部署指南把 Nano 的最大序列长度写成 128K,config.json 里实际写的是 max_position_embeddings: 32768,32K。这份指南给的 API 字段也和官方对不上,可以参考它的硬件档位描述,但具体数字得回官方文档核。
还有个容易被忽略的差别:模型权重仓库的许可标签是 Apache-2.0,但 KaLM-Jev 的代码仓库没有 License 文件,用 GitHub 接口查返回的是 license: null。
它不生成文字,只回三种形状的结果,一条评价能一次问好几个:
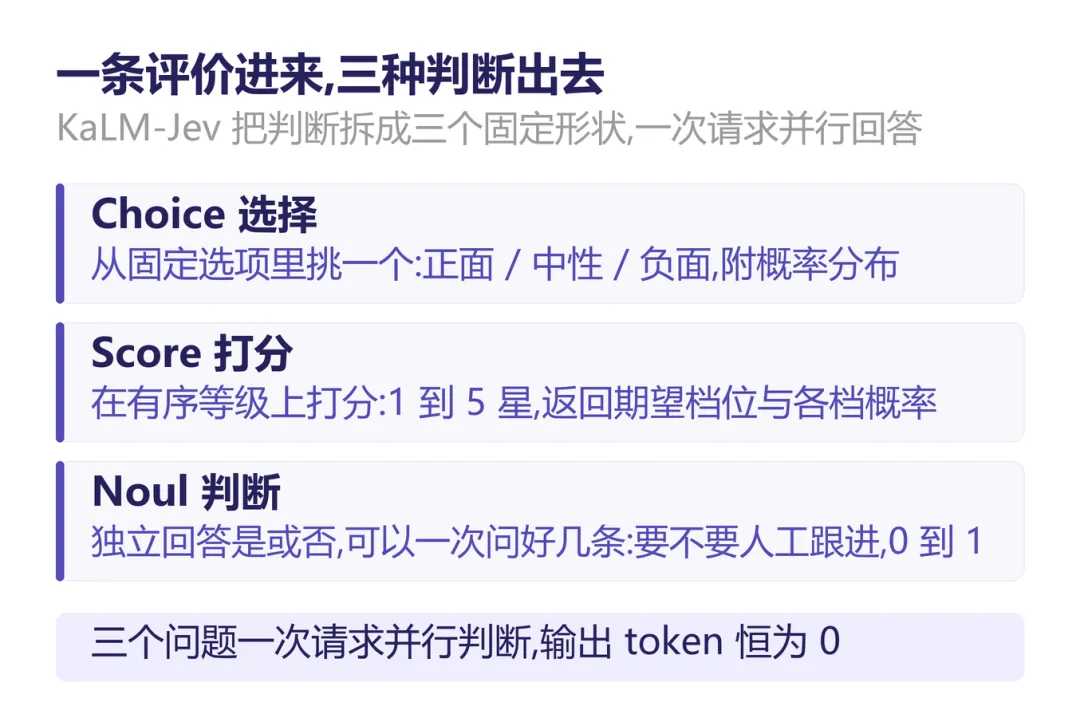
图 1 三种判断原语,以及它们在餐饮评价里各自负责什么
03 下载:国内网络的第一道坎
第一步:让 huggingface 走镜像
huggingface.co 在这台机器上不通,curl 连了 10 秒返回的是 000,一个字节都没下来。镜像站 hf-mirror.com 正常。
set HF_ENDPOINT=https://hf-mirror.com
mkdir -p kalmjev-lab/models/KaLM-Reranker-V1-Nano-R2
第二步:只下必需的 12 个文件
一个能跑推理的目录只要这 12 个文件,仓库里其他目录全都不用管:README.md、config.json、config_sentence_transformers.json、generation_config.json、kalm_cross_encoder.py、kalm_cross_encoder_config.json、kalm_reranker.py、kalm_reranker_utils.py、model.safetensors、modules.json、tokenizer.json、tokenizer_config.json。
这里有个细节值得记一下:checkpoint 里的 kalm_cross_encoder.py 和 kalm_reranker.py 都是可执行的 Python 文件,加载时会被真的执行。官方 README 自己也提示了「use trusted model repositories」。从镜像下权重没问题,但要清楚你在执行一个陌生仓库里的代码。
第三步:8 段并行分块下 1.57 GB
最难的是 1.57 GB 那个 model.safetensors。单连接下载会掉速:最开始 20 秒能跑到 2.8 MB/s,但拉长看会掉到 0.1 MB/s 上下,一度以为卡死了。改成 8 段并行下,稳定在 3.8 MB/s 左右,七八分钟拉完。
# dl_par.py —— 8 段并行分块下载,再按顺序合并
import concurrent.futures as cf, os, subprocess
URL = ("https://hf-mirror.com/KaLM-Embedding/KaLM-Reranker-V1-Nano-R2"
"/resolve/main/model.safetensors")
TOTAL, N = 1572182264, 8
DEST = "models/KaLM-Reranker-V1-Nano-R2/model.safetensors"
TMP = "_parts"
os.makedirs(TMP, exist_ok=True)
C = TOTAL // N
jobs = []
for i in range(N):
s = i * C
e = TOTAL - 1 if i == N - 1 else (i + 1) * C - 1
jobs.append((i, s, e))
def grab(job):
i, s, e = job
p = os.path.join(TMP, "part%02d" % i)
want = e - s + 1
if os.path.exists(p) and os.path.getsize(p) == want:
return "part%02d skip" % i
subprocess.run(["curl", "-sL", "--max-time", "3600", "--retry", "3",
"-r", "%d-%d" % (s, e), URL, "-o", p], check=True)
return "part%02d got %d/%d" % (i, os.path.getsize(p), want)
with cf.ThreadPoolExecutor(max_workers=N) as ex:
for r in ex.map(grab, jobs):
print(r, flush=True)
with open(DEST, "wb") as out:
for i in range(N):
out.write(open(os.path.join(TMP, "part%02d" % i), "rb").read())
size = os.path.getsize(DEST)
print("merged %d expect %d %s" % (size, TOTAL, "OK" if size == TOTAL else "MISMATCH"))
第四步:核对字节数和哈希
下完对了一下字节数,1572182264,和远端一致。稳妥起见再核一次哈希:
python -c "import hashlib;print(hashlib.sha256(open('models/KaLM-Reranker-V1-Nano-R2/model.safetensors','rb').read()).hexdigest())"
本机跑出来是 c1d8ed4eee064e9c594e8332896c7ebe3104f892b6ff3f321b443b8868ed01b9,和仓库给出的一致。
04 部署:一套钉死的依赖
第一步:建一个干净的虚拟环境
python -m venv envs/kalmjev
envs/kalmjev/Scripts/python.exe -m pip install -U pip
第二步:照官方 requirements 装,然后连撞三个坑
第一个坑:官方 requirements.txt 里钉的是 numpy==1.26.4。我查了 PyPI,这个版本只有 cp310 到 cp312 的轮子,没有 cp313 的。也就是说如果你用 Python 3.13,这个钉死的版本根本装不上。我的处理是不用这个钉,改成 numpy 2.x,后面跑起来没出问题。
第二个坑:torch==2.8.0 在国内的 pip 镜像上装不了,返回的是 from versions: none,也就是它认为一个可用版本都没有。换成 PyTorch 官方的 CPU 源才装得上,轮子 619 MB。
pip install torch==2.8.0 --index-url https://download.pytorch.org/whl/cpu
pip install "numpy>=2,<3" transformers==5.3.0
第三个坑最意外:这台机器上的 pip 读不到镜像的索引。用 pip install -i <镜像> 包名 一律报「找不到版本」,哪怕用 curl 直接请求同一个索引地址能正常拿到 30 KB 的内容,pip 就是看不到。原因大概是本机的代理设置:pip 走代理时请求失败,不走代理时镜像又连不上。
第三步:绕开 pip 的索引,自己抓轮子
最后的办法是绕开 pip 的索引,自己抓轮子。思路只有三步:用 curl 去镜像的 JSON 接口取文件列表,按平台标签挑出 cp313/win_amd64 或 abi3 的轮子下到本地目录,再让 pip 用 --no-index --find-links 从本地装。缺哪个就抓哪个,循环补齐,脚本的循环上限设在 40 轮。
# fetch_wheels.py 骨架:挑轮子 -> 抓下来 -> 让 pip 离线装
import json, os, re, subprocess
WHEELS = "wheels"
INDEX = "https://pypi.tuna.tsinghua.edu.cn/simple"
REQS = ["transformers==5.3.0", "tokenizers==0.22.2", "safetensors==0.7.0",
"numpy>=2,<3", "huggingface_hub>=1.3,<2", "fastapi>=0.115,<1",
"uvicorn>=0.30,<1", "pydantic>=2.10,<3", "httpx>=0.27,<1"]
os.makedirs(WHEELS, exist_ok=True)
def curl(url, out=None):
cmd = ["curl", "-sL", "--max-time", "180", "--retry", "3", url]
if out:
subprocess.run(cmd + ["-o", out], check=True)
return b""
return subprocess.run(cmd, capture_output=True).stdout
def pick(files):
"""只留 cp313 / py3 / abi3 且 win_amd64 或 any 的正式版,取版本号最大的一个"""
best = None
for f in files:
fn = f["filename"]
if not fn.endswith(".whl") or len(fn[:-4].split("-")) < 5:
continue
py, abi, plat = fn[:-4].split("-")[-3:]
if abi not in ("cp313", "abi3", "none") or plat not in ("win_amd64", "any"):
continue
ver = fn[:-4].split("-")[1]
if not re.fullmatch(r"[0-9]+(\.[0-9]+)*", ver): # 排除 rc / dev
continue
key = [int(x) if x.isdigit() else 0 for x in re.split(r"[.\-+]", ver)]
if best is None or key > best[0]:
best = (key, f)
return best[1] if best else None
for it in range(1, 41):
p = subprocess.run(["python", "-m", "pip", "install", "--no-index",
"--find-links", WHEELS] + REQS, capture_output=True)
text = (p.stdout + p.stderr).decode("utf-8", "replace")
if p.returncode == 0:
print("iter %02d SUCCESS" % it)
break
miss = sorted(set(re.findall(
r"Could not find a version that satisfies the requirement ([^\s<]+)", text)))
if not miss:
print("iter %02d 无进展,停" % it)
break
print("iter %02d 缺 %s" % (it, ",".join(miss)))
for n in miss:
raw = curl("%s/%s/" % (INDEX, n)).decode("utf-8", "replace")
f = pick(json.loads(raw).get("files", []))
if f is None:
print(" 没有匹配的轮子: " + n)
continue
dest = os.path.join(WHEELS, f["filename"])
if not os.path.exists(dest):
curl(f["url"], out=dest)
print(" got " + f["filename"])
这个办法比它看起来值:它把「装依赖」这件事从「祈祷镜像活着」变成了「缺什么补什么」,而且每个轮子都在本地留了一份,换机器可以直接复用。最后本地一共存下 43 个轮子。
第四步:确认关键类能导进来
python -c "from transformers import T5Gemma2ForConditionalGeneration; print('ok')"
这一步不能省。我第一次装完就卡在这里,报错是 Could not import module 'GenerationMixin',往上追是缺 sympy——因为我为了省事用 --no-deps 装的 torch,它自己的依赖一个没装。这类报错信息很难一眼看懂,但根因通常很朴素。
第五步:起服务
依赖齐了就可以起服务:
kalm-jev serve \
--model kalm-jev-nano \
--model-path ./models/KaLM-Reranker-V1-Nano-R2 \
--device cpu --dtype float32 --batch-size 4
如果没做 pip install -e .,也可以直接跑模块:
set PYTHONPATH=repo/src
python -m kalm_jev.server serve --model kalm-jev-nano \
--model-path ./models/KaLM-Reranker-V1-Nano-R2 \
--device cpu --dtype float32
CPU 上必须用 float32。权重本身是 BF16,但大多数 CPU 不支持 BF16 运算,官方文档也是这么建议的。
第六步:量内存
跑起来之后我量了几个数:
Windows 上读进程内存要用 psapi。我第一版图省事用 tasklist,读回来是 9 MB,明显不对,因为那是页文件口径:
# 读当前进程的驻留内存与峰值内存
import ctypes, ctypes.wintypes as wt
class PMC(ctypes.Structure):
_fields_ = [("cb", wt.DWORD), ("PageFaultCount", wt.DWORD),
("PeakWorkingSetSize", ctypes.c_size_t),
("WorkingSetSize", ctypes.c_size_t),
("QuotaPeakPagedPoolUsage", ctypes.c_size_t),
("QuotaPagedPoolUsage", ctypes.c_size_t),
("QuotaPeakNonPagedPoolUsage", ctypes.c_size_t),
("QuotaNonPagedPoolUsage", ctypes.c_size_t),
("PagefileUsage", ctypes.c_size_t),
("PeakPagefileUsage", ctypes.c_size_t)]
_k32 = ctypes.windll.kernel32
_k32.GetCurrentProcess.restype = ctypes.c_void_p
_psapi = ctypes.windll.psapi
_psapi.GetProcessMemoryInfo.argtypes = [ctypes.c_void_p, ctypes.POINTER(PMC), wt.DWORD]
_psapi.GetProcessMemoryInfo.restype = wt.BOOL
def rss_mb():
c = PMC()
c.cb = ctypes.sizeof(PMC)
_psapi.GetProcessMemoryInfo(_k32.GetCurrentProcess(), ctypes.byref(c), c.cb)
return c.WorkingSetSize / 1048576.0, c.PeakWorkingSetSize / 1048576.0
3572 MB 这个数说明了一件事:那个 417 M 的视觉塔确实被加载进内存了。如果只加载文本部分,float32 下大概 1.1 GB 就够了。等于说这套判断引擎的内存里,有 1.6 GB 装着一份它用不到的图像编码器。
这台机器开机后可用内存是 6.5 GB,峰值 5.07 GB 是踩线过的。换成 8 GB 内存的机器,基本跑不动。
05 跑通第一个请求
服务起来之后,先用 curl 把 HTTP 路径打通:
curl http://127.0.0.1:8000/health
curl -X POST http://127.0.0.1:8000/v1/systemone \
-H "Content-Type: application/json" \
--data-binary @repo/examples/mixed.json
官方在 examples/ 里放了四个请求样例,mixed.json 是最全的一个。我原样发了过去,下面是真的返回内容(节选):
{"department": {
"probabilities": {
"returns": 0.5007, "shipping": 0.3650, "billing": 0.1342
},
"confidence": 0.1046,
"choice": "returns"
},
"bug_severity": {
"probabilities": { "0": 0.0463, "1": 0.4773, "2": 0.4764 },
"confidence": 0.2277,
"score": 1.4301
},
"is_human_escalation": { "noul": 0.9862 },
"is_repeat_contact": { "noul": 0.1111 }
}
里面有两个地方值得停下来看。
一个是 confidence: 0.1046。它给出的最优选项是 returns,但置信度只有 0.10。官方 README 里给出的同一个样例、跑在 4B 的 Large 模型上,returns 的概率是 0.992、置信度 0.953。同一个请求、同一个模板,换到 0.27B 的 Nano 上,答案还勉强对,底气已经没了。
另一个是 is_repeat_contact 给了 0.1111。原句里写的是 "I have asked three times now",这是最明确的重复联系信号,正确答案应该是高值。这条它答错了。
响应里还有一段元信息,我第一次看到有点意外:
"calibration": "none",
"confidence_method": "normalized_entropy_v1",
"usage": { "input_tokens": 1165, "output_tokens": 0 }
calibration: none 意思是这套输出没有任何校准。它给的 0.99 不代表 99% 正确,只代表模型内部很笃定。官方 README 也明确写了这一点,让人自己在自己的数据上重设阈值。这一点很重要,后面第八节会专门讲。
缓存行为也和我预想的不一样。同一个请求发第二次,encoded_documents 从 9 变成 0,说明文档编码确实命中了缓存;但总耗时从 2.32 秒只降到 2.19 秒。原因是缓存省掉的只是「把候选文本编码一遍」这一步,交叉注意力打分还是每次都要跑。所以如果你的场景是同一条文本反复问不同问题,缓存有用;如果每次都是新文本,缓存基本不起作用。
顺手把官方 README 里说的几条输入校验也试了。注意这里有个方法上的坑:如果用一个已经解析好的字典去发请求,重复的键在解析阶段就被悄悄丢掉了,你根本测不出服务端有没有拒绝重复键。必须直接发原始 JSON 字符串才有意义:
dup = ('{"state":"x","questions":{"q":{"type":"noul","instructions":"Is it urgent?"},'
'"q":{"type":"noul","instructions":"Is it urgent?"}}}')
eng.evaluate(dup) # 报 Duplicate JSON key: q
eng.evaluate('{"state":"x","questions":{"q":{"type":"noul","instructions":"i"}},"bogus":1}')
eng.evaluate('{"state":"NaN","questions":{}}') # 空 questions 也被拒
三条都如实拒了,和文档写的一致,做得是扎实的。另外请求一个没加载的模型别名,会返回 HTTP 400,而不是偷偷去下载,这个行为也和文档对得上。
06 测试一:官方自带的 36 条双语题
官方仓库里带了一套语义测试集 tests/semantic_cases.json,36 条,18 条英文 18 条中文,Choice/Score/Noul 各 12 条。我用它先跑一遍,算是给后面的餐饮实测找个基准。
跑分脚本主干就是一个循环,Score 按四舍五入取档,Noul 按 0.5 切二值:
cases = json.load(open("repo/tests/semantic_cases.json", encoding="utf-8"))
stat = {}
for c in cases:
resp = eng.evaluate(json.dumps(c["request"], ensure_ascii=False))
a = resp["answers"][c["question_id"]]
if c["kind"] == "choice":
got = a.get("choice")
elif c["kind"] == "score":
got = int(round(a.get("score")))
else:
got = 1 if a.get("noul", 0) >= 0.5 else 0
s = stat.setdefault((c["language"], c["kind"]), [0, 0])
s[0] += 1 if got == c["expected"] else 0
s[1] += 1
结果是这样的:
| 21/36 = 58.3% |
36 条一共花了 24 秒,平均一条 0.67 秒。
这个成绩可以和官方记录直接对照。官方 results/ 目录里记了三个型号跑同一套题的指标:
我的 Choice 是 8/12 = 66.7%,Noul 是 6/12 = 50.0%。和官方记录的 Nano 成绩分毫不差。这至少说明两件事:CPU 上跑 float32 和 GPU 上跑 BF16 在这套题上没差别,我的部署过程没有引入错误。
但表格里还有一行更值得看。Noul 这一列,三个型号全是 50.0%。50% 在一个二分类任务上就是扔硬币。也就是说这个「是或否」原语,在这套测试集上不分大小都没跑出随机水平。
同时注意最后一列。重复联系这个判断,Large 是 33.3%,Nano 反而是 83.3%,型号越大越差。这不合常理,更可能是样本量的问题——每一格只有 12 条,1 条对错就是 8.3 个百分点。12 条样本算出来的准确率不能当能力指标用,这一点在后面解释餐饮实测结果时同样成立。
07 测试二:餐饮评价,48 个判断
官方那套题是客服工单场景、英文为主。我真正想知道的是它在中文餐饮评价上什么样,所以自己出了一套。
8 条评价,刻意覆盖好评、差评、中评、食安、外卖、刷单式空话、情绪激烈要赔偿、以及一条字面夸实际骂的反讽。每条问 6 个问题:整体情感、主要方面、星级、要不要人工跟进、有没有食安风险、像不像无效评价。8 × 6 = 48 个判断。
数据结构就是「一条文本 + 一组金标准」,金标准是我自己标的:
REVIEWS = [
{"id": "R1", "label": "好评",
"text": "招牌红烧肉肥而不腻,配的梅干菜吸饱了汤汁,两个人点三个菜刚好。"
"服务员看我们带了小孩,主动换到了靠墙的位置。人均80,在这个地段不算贵,下次还来。",
"gold": {"overall_sentiment": "positive", "main_aspect": "taste", "star_rating": 5,
"needs_human": 0, "food_safety_risk": 0, "is_suspicious_review": 0}},
{"id": "R4", "label": "食安风险-菜里有异物",
"text": "吃到一半在青菜里发现一根头发,还是卷的那种。叫服务员过来,她说「可能是不小心掉的」,"
"然后把这盘菜退掉了,其他菜照收钱。回家之后拉了两次肚子。",
"gold": {"overall_sentiment": "negative", "main_aspect": "food_safety", "star_rating": 1,
"needs_human": 1, "food_safety_risk": 1, "is_suspicious_review": 0}},
# R2 差评 / R3 中评 / R5 外卖 / R6 空话 / R7 索赔 / R8 反讽,结构相同
]
六个问题分三种形状。题面用英文写(官方建议生产环境这么写),评价文本用中文:
QUESTIONS = {
"star_rating": {"type": "score",
"instructions": "What star rating would this reviewer give?",
"criteria": ["1 star: severely dissatisfied, a serious problem occurred",
"2 stars: dissatisfied, several complaints",
"3 stars: average, neither good nor bad",
"4 stars: satisfied, minor issues only",
"5 stars: very satisfied, no complaint at all"]},
"overall_sentiment": {"type": "choice",
"instructions": "What is the overall sentiment of this restaurant review?",
"criteria": {"positive": "Overall praise; the reviewer recommends or would return",
"neutral": "Mixed or balanced; praise and complaint both present",
"negative": "Overall complaint; the reviewer will not return"}},
"needs_human": {"type": "noul",
"instructions": "Does this review need a human staff member to follow up?",
"criteria": {"true": "Demands compensation, refund, apology, or reports harm",
"false": "Ordinary feedback that no one has to act on"}},
# main_aspect / food_safety_risk / is_suspicious_review 结构相同
}
评分就是对每个问题取答案,再和金标准比:
def grade(resp, gold):
rows = []
for qid, want in gold.items():
a = resp["answers"].get(qid, {})
if a.get("type") == "choice":
got = a.get("choice")
elif a.get("type") == "score":
got = int(round(a.get("score"))) # 期望档位四舍五入
else:
got = 1 if a.get("noul", 0) >= 0.5 else 0 # 0.5 切二值
rows.append((qid, got, want, got == want, a.get("confidence")))
return rows
先说清楚这套数据的两处局限。金标准是我自己标的,不是权威标注;8 条样本量很小,一个判断对错就是 2 个百分点。另外「主要方面」这一项本身有歧义:R1 既夸了菜又夸了服务,我标成 taste,模型答 service,严格说不能算它错。所以下面看分题型的结果时,请把「主要方面」那一行打个折扣看。
为了分清到底是中文不行还是任务太难,我把同一批评价翻译成英文又跑了一遍,再用中文重写判据跑了第三遍。三种配置的结果:
换语言救不回来。翻译成英文一分没涨,把判据换成中文还掉了 3 分。逐条比对,48 个判断里中英文只有 4 个不一致,差异都在噪声范围内。所以瓶颈不在语言上,是这个模型在这个任务上就这么弱。
分题型看,差距非常集中:
两个 Noul 类任务最好,星级最差,而且三种配置下都是 2/8,差得非常稳定。
具体错在哪,看两个例子。
R1 是一条通篇在夸的评价,它给的答案:
"overall_sentiment": {
"probabilities": { "positive": 0.3607, "neutral": 0.0232, "negative": 0.6161 },
"confidence": 0.3141,
"choice": "negative"
}
negative 0.616。一条「下次还来」的评价被判成负面。这就是没有校准的模型的典型表现:概率看着挺像回事,结论完全反了。
星级的问题更系统。下面这组数是从三次运行的输出里抽出来的,左边是模型给的期望档位,右边是我标的档位:
看最后一列的对比。我给 5 星的它给 2.6 和 3.0,我给 1 星的它给 2.4 和 2.7。它的输出全部挤在 2 到 3 之间,从不给 1 星,也不给 5 星。 它把不同档位的评价都往中间拉。对做评价运营的人来说,这样的打分等于没有信息量。
把每一条的标注和模型输出摆在一起,差距一眼就看出来了:
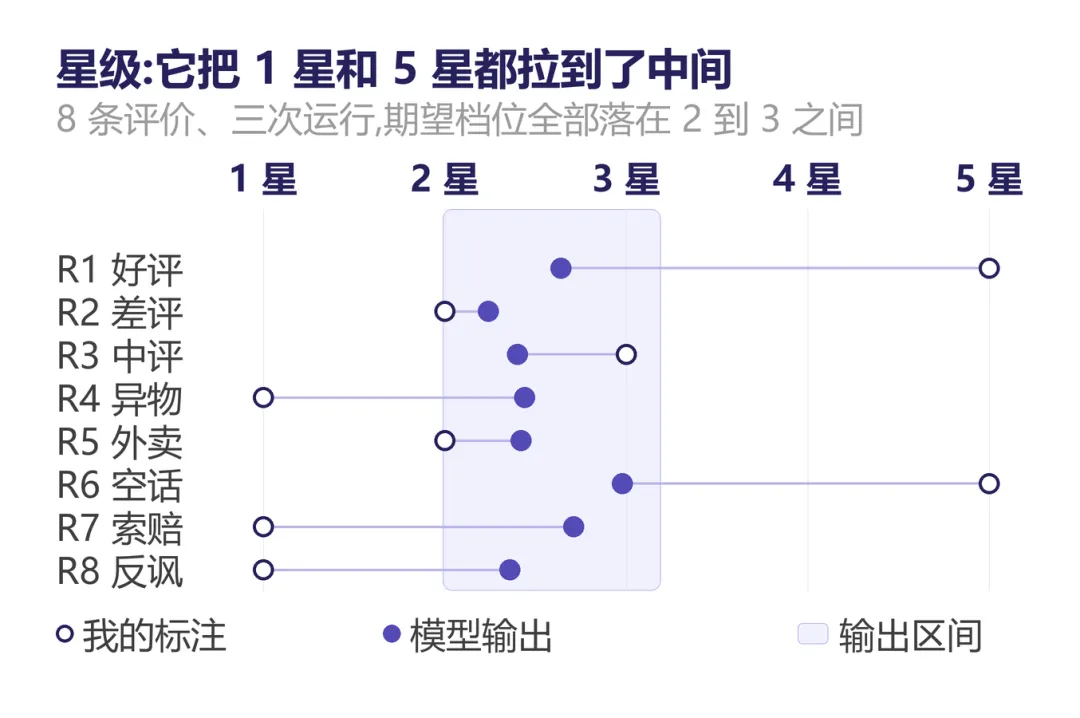
图 2 星级判断的塌陷:我给 1 星和 5 星,它都给到 2 到 3 之间
08 置信度比答案更有用
前面铺垫了两次置信度,它是我这次实测里最有用的一个发现。
模型对每个 Choice 和 Score 会给一个 confidence。官方说它来自归一化熵,我对这个指标本来是持怀疑态度的——一个没校准的模型,它的置信度能说明什么?我把 48 个判断按置信度分了档,分别统计正确率:
buckets = [(0, 0.1), (0.1, 0.2), (0.2, 0.3), (0.3, 0.4), (0.4, 1.01)]
for lo, hi in buckets:
sel = [r for r in rows if r["conf"] is not None and lo <= r["conf"] < hi]
if not sel:
continue
n_ok = sum(1 for r in sel if r["ok"])
print("%.1f-%.1f %d/%d = %.0f%%" % (lo, hi, n_ok, len(sel), 100.0 * n_ok / len(sel)))
三种配置下趋势是一致的:
中间那两行是小样本,一两条数据就能翻盘,不算数。但两端很稳定:置信度低于 0.1 时,正确率在 22% 到 30% 之间,比随机猜还差;置信度高于 0.4 时,正确率在 83% 到 100% 之间。
所以这个置信度虽然不能当「正确率」读,但可以当一个门槛来用。做法是:设定一个阈值,置信度够的进自动流程,不够的转人工。这样你不需要模型准确率多高,你需要的只是「它知道自己什么时候不行」。
同一个模型,换一种用法,就从不可用变成了可用。这是我这次实测里最有价值的一条。
09 五个必须先知道的坑
第一,输出未校准。calibration: none 是响应里明写的,官方文档也反复强调。它给的 0.99 不是 99% 正确。阈值必须拿你自己的数据标一遍才能用。
第二,代码仓库没有 License。模型的权重仓库是 Apache-2.0,但 KaLM-Jev 的代码仓库没有 License 文件,GitHub 接口返回 license: null。在自己机器上研究没问题,接进商业链路之前先找作者确认。
第三,默认不安全。服务绑 127.0.0.1,单 worker,单进程单模型,没有任何鉴权。要暴露出去必须自己加一层。同时它的内存开销是 3572 MB,这不是一个能塞进小机器的东西。
第四,项目很新而且停着。仓库 9 月 21 日建,最后一次提交也在 9 月 21 日,到 10 月 7 日已经 16 天没动过,37 个 star,2 个 fork。整个组织下 6 个仓库,没有一个包含训练代码——docs/ 只有聚合、缓存、测试三篇,scripts/ 只有一个发布前检查脚本。想微调等于自己按论文从头搭一遍。另外它没有 Docker 镜像,容器化要自己做。
第五,有一半的下载和内存是白费。1.57 GB 权重里有 416.9 M 参数是视觉塔,加载后实打实占着大约 1.6 GB 内存,而它的输入接口只接受字符串和 JSON,根本用不到图像。官方文档也没提这件事。如果你要给这个项目提个有用的 issue,把这个视觉塔去掉可能是性价比最高的一个。
还有一条不算坑,但值得知道:官方那份第三方部署指南里,最大序列长度写的是 128K,实际配置是 32K;API 字段也和官方对不上。参考它的硬件分档可以,数字要去官方文档核。
10 餐饮评价这个场景,我的结论
回到最开始的问题:能不能拿它给餐饮评价做分拣。
能用一半。食安风险和无效评价这两类判断,它 8 条里能对 6 到 7 条,而这两个又正好是运营最需要第一时间捞出来的——一条评价里出现「头发」「馊」「拉肚子」,或者通篇只有感叹号没有细节,这两种任务它做得不错,而且一次请求能同时问好几个,一条评价的六个判断几秒钟就都回来了。
不能用的是打分。星级判断 8 条对 2 条,而且输出全部挤在中间档,没有区分度。情感判断也不行,一条明确好评能被判成负面。
如果你真要落地,我建议的用法是这样:不要把它当「自动打分器」,当成「过滤器」。让低置信度的结果全部进人工队列,高置信度的自动归档,然后统计一周下来人工队列的比例。如果人工队列能压到三成以下,这套东西就有价值。
最后是它跟直接调大模型 API 比。它的优势很实在:数据不出机器,没有按次计费,延迟稳定在 2 到 6 秒,而且输出是可复现的。它的劣势同样实在:准确率 60% 上下,内存 3.5 GB 起,项目刚开源两周而且停着更新。