ARTICLE · 1133019
换掉25%的词就废了!OpenAI连夜给ChatGPT打上隐形钢印,全网吵疯了
谁也没有想到,OpenAI会以这样一种近乎“坦白局”的姿态,扔下一颗震撼弹。
就在这几天,无数靠AI写论文、赶报告、敲代码的人,后背冷汗直冒:ChatGPT的文本,正式被刻上隐形水印了。
如果你身处欧盟,在不久的后几周里,无论你是付费尊贵的Plus会员,还是免费白嫖党,ChatGPT吐出的每一篇长文、Codex生成的每一段逻辑,都会在冥冥中被打上一串机器可读、肉眼不可见的基因密码。
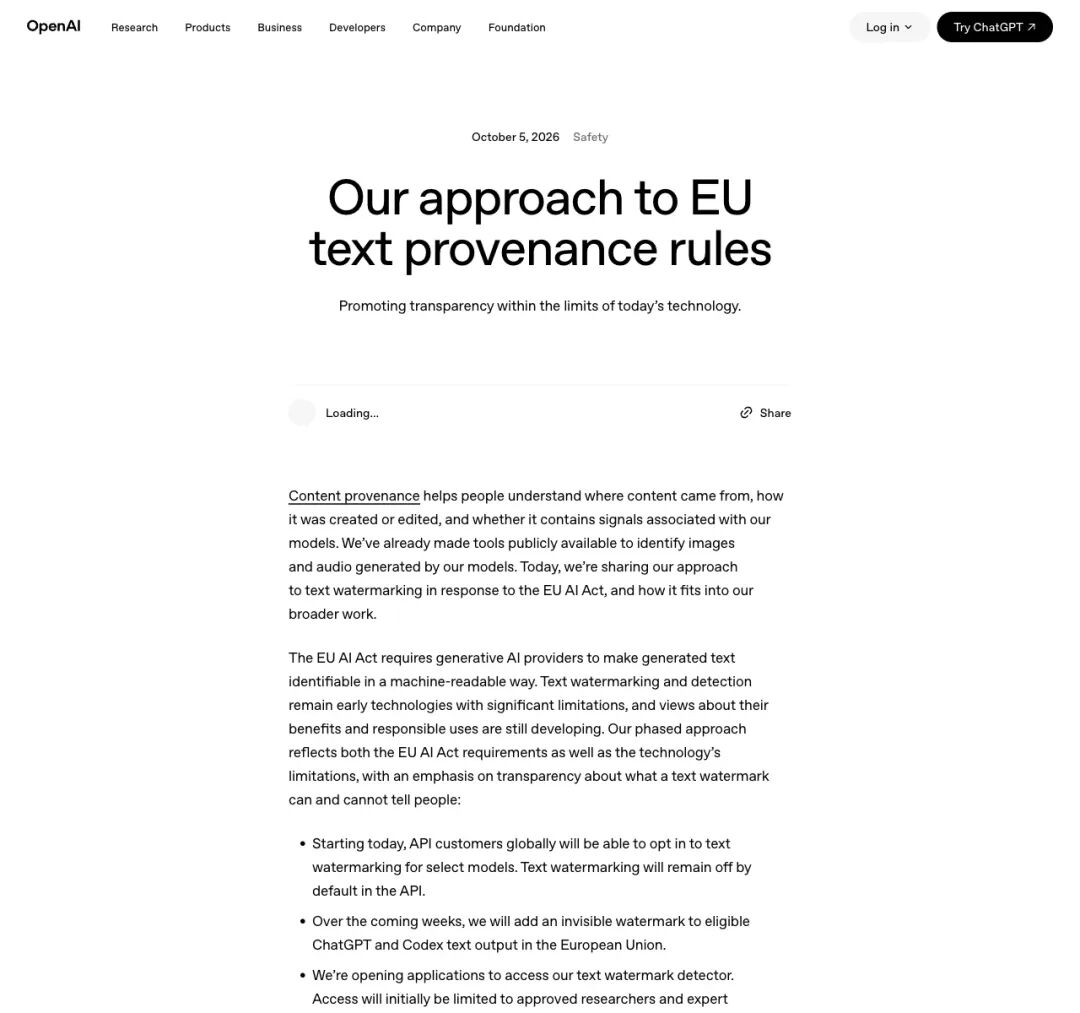
▲ OpenAI官网宣布为应对欧盟监管推出文本溯源方案
消息一出,社交媒体瞬间炸锅有人哀嚎“AI代写的末日来了”,有人高呼“原创者的胜利”。
然而,戏剧性的反转来得比狂欢更快
当技术极客们翻开OpenAI同步放出的几十页技术白皮书,所有人赫然发现,官方自己写下了一个充满讽刺意味的实测数据:
一段带水印的AI文本,只要你换掉10%的近义词,检测率直接从92%暴跌到66%;如果你换掉25%的词,也就是随手改改四分之一的字句,检测率便当场跳水到17%!
面对一个懂点词汇替换的高中生,这道号称前沿密码学加持的“隐形锁链”,竟然几乎形同虚设。
这到底是一场跨时代的数字指纹革命?还是一场心照不宣的“合规大戏”?
01所谓“隐形水印”,到底把秘密藏在了哪?
很多人听到“文本水印”,第一反应是搞笑的:难道复制出来的文章,角落里会带着灰色的Logo?或者像防伪钞票一样带着微缩文字?
实际情况并非如此
如果把一篇文章比作一条马路,过去那些粗糙的隐写术,是在地砖缝里强行塞进看不见的“零宽字符(Zero-Width Space)”。这种技术极度脆弱,只要你把文本丢进记事本转存一下,或者代码编辑器一格式化,暗号当场报废。
OpenAI这次端出的自研底牌,名叫 textGrain。
它不塞任何多余的字符,也没有奇怪的标点。它的水印,直接寄生在语言模型的“选词概率”里。
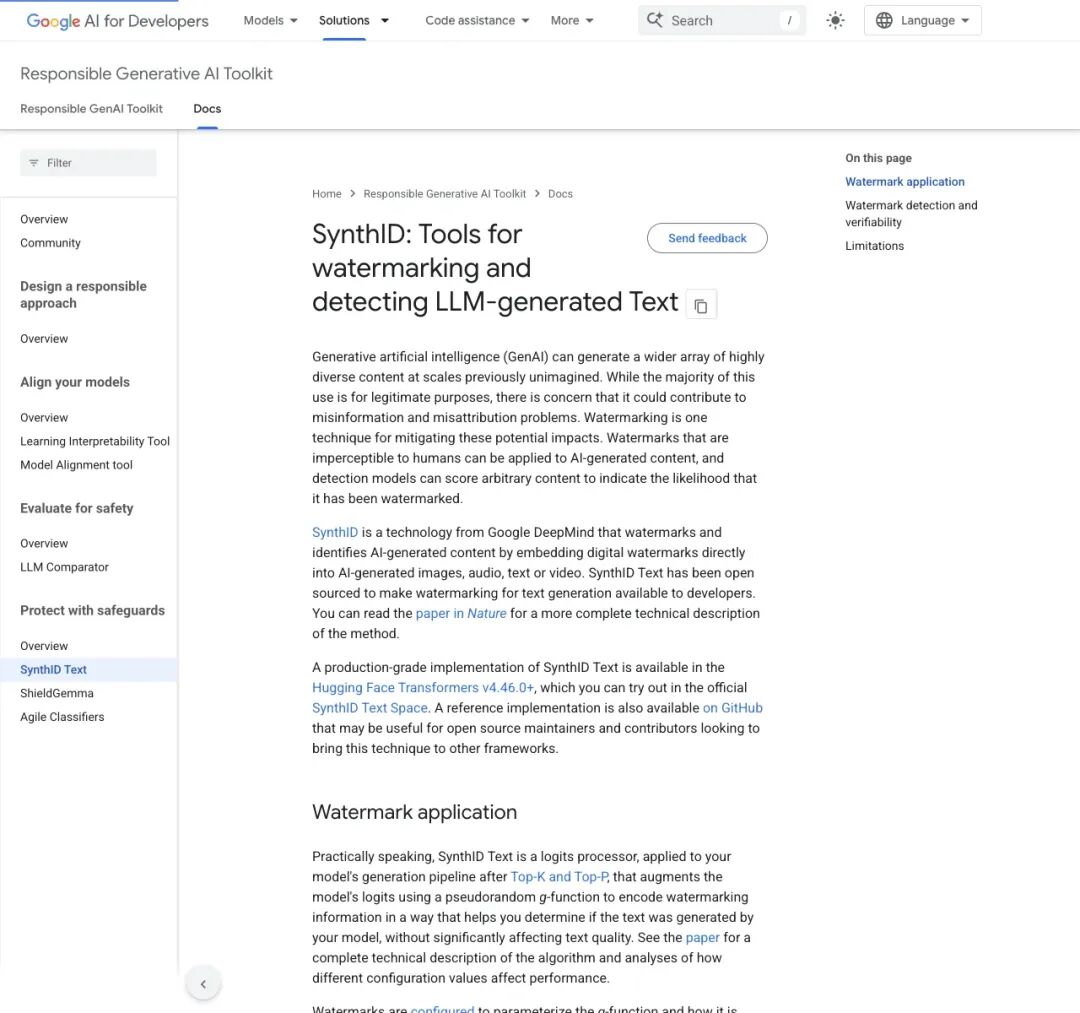
▲ 业界此前开源的Google SynthID,同样是在词元概率分布上做文章
我们必须明白大语言模型是怎么说话的。
模型在生成每一个词(Token)时,面前会浮现出一长串候选词清单。比如上一句是“今天天气真”,后面的候选词可能是“好”(概率60%)、“晴朗”(概率20%)、“糟糕”(概率10%)……
在正常情况下,模型会带有一点随机性去摇号。
而 textGrain 的做法,是给这个摇号机装上一套数学秘钥。
在不影响整句话通顺的前提下,它会用极其微小的力量,轻轻地“推”一下概率轮盘,让模型优先选择那些符合某种统计规律的词汇。
读起来,这依然是一篇行云流水的优美文章;但只要把这段话交给持有秘钥的专用检测器,后台跑一跑统计分布,就能瞬间得出一个概率结论:“这段文字,有99%的几率出自OpenAI之手。”
这套设计听上去近乎天衣无缝:就像把一滴墨水均匀散进大海,只有掌握秘钥的人才知道它的分子分布规律。
与此同时,OpenAI宣称这套方案做到了基准性能的“零退化”。
02严苛测试下的奇迹:模型完全没变笨
在过去,搞技术的人最怕给语言模型加限制。
你一旦强行干预它的选词,模型往往会瞬间变得结结巴巴、逻辑崩塌,甚至连基础的加减乘除都会算错。
但根据官方披露的权威数据,在顶配前沿模型 Astra 上的全套跑分中,textGrain 展现了不可思议的稳定性:
| Artificial Analysis | |||
| Terminal-Bench Science | |||
| DeepSWE v1.1 | |||
| GPQA Diamond |
在博士级别的理科综合难题 GPQA Diamond 评测中,得分仅仅从 94.44% 微幅波动到 93.94%;在网页检索和代码工程测试中,起伏全都在正常的统计误差范围内。
为什么能做到这一点?
答案藏在他们联合宾夕法尼亚大学与耶鲁大学发布的技术报告中:他们引入了一套“熵损失预算(Entropy Budget)”。
如果遇到逻辑极其严密、只能用特定术语回答的推导(比如“光速在真空中等于……”),系统会自动收回水印信号,确保关键术语原封不动;到了语言丰富度高、自由表述空间充裕的大段叙述中,模型才会加大统计特征的注入。
既聪明,又隐蔽,还不伤智商
然而,正是这套在数学上巧夺天工的精密仪器,在走进现实生活的那一瞬间,迎来了一场近乎荒诞的幻灭。
03“改写25%就废掉”:完美铠甲上的致命死穴
如果说 textGrain 是一具用密码学精心打造的重型铠甲,那么它的脖颈处,其实悬空露着一大截动脉。
OpenAI 在官方博客中极其坦诚地列出了它的弱点,而正是这些弱点,让整个开发者社区发出了意味深长的笑声:
- 短文本根本没法检
:一段话如果少于200个Token(大约150个英文单词),统计特征根本撑不起来,强行检测就是一片虚无; - 专业用词卡死的地方无法检
:比如数学推导、严密的逻辑代码,因为用词容错率极低,系统压根不敢加水印; - 改写与翻译直接“物理抹杀”
:哪怕是一篇被牢牢锁定的长文,只要你用自己的话重新润色一遍,或者扔进翻译软件“英译中再译英”,残留的统计信号会被当场冲刷得一干二净。
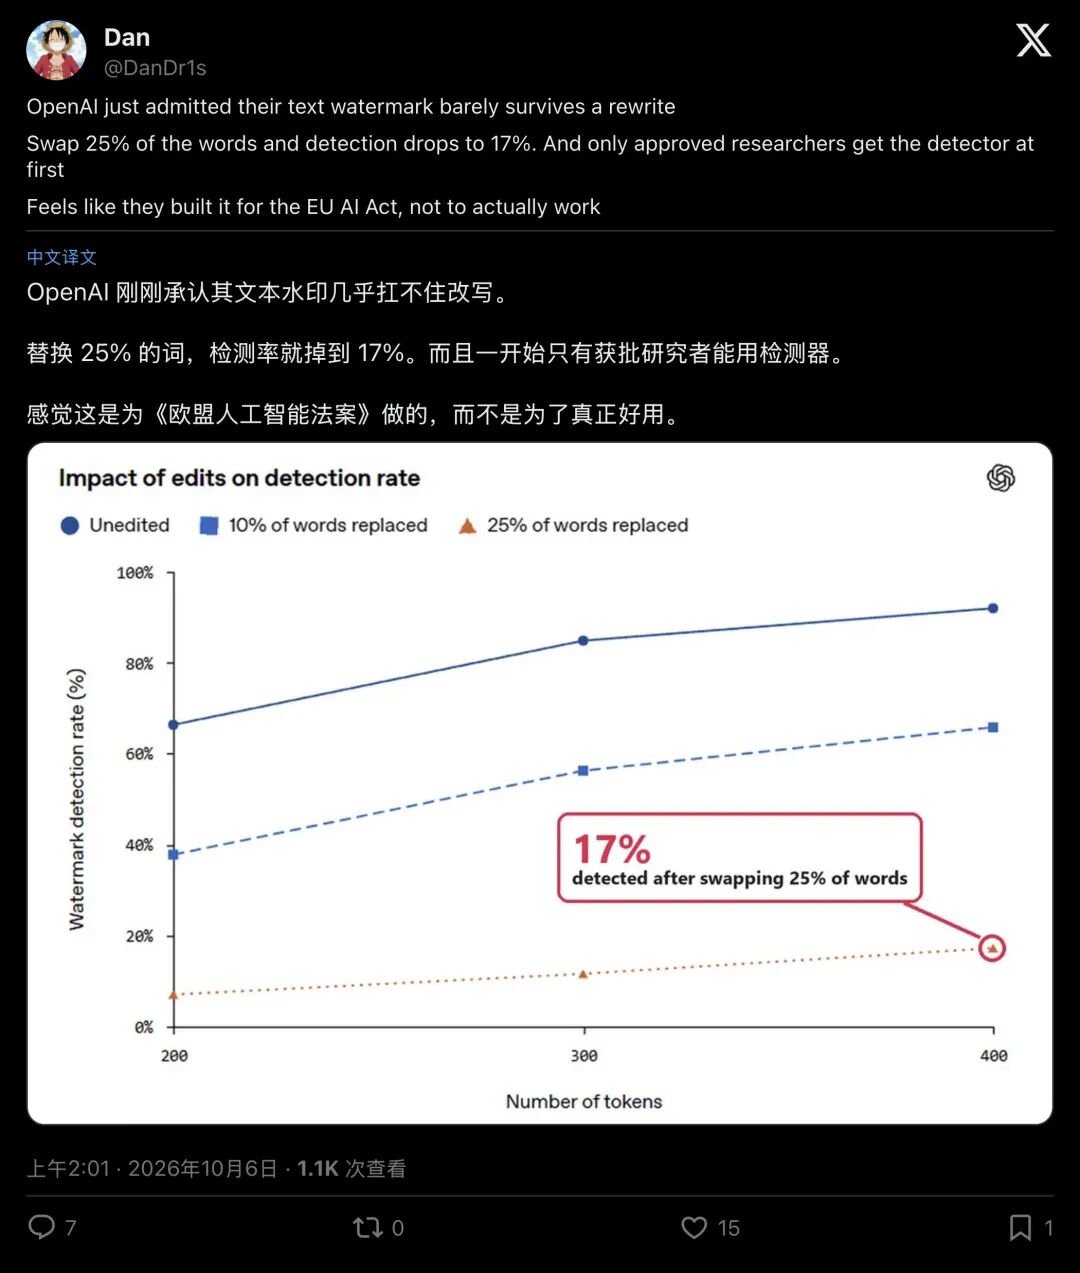
▲ 工程师 Dan 评价:这套系统旨在满足合规要求,难以应对实际对抗
开发者 Dan 在推特上讽刺:
“换掉25%的词,检测率降至17%。而且初期只有获批的研究人员能接触检测器……其主要用途在于应对《欧盟人工智能法案》的监管,防范作弊的实效十分有限。”
想一想现实里的场景吧
一个老老实实写论文、只用 ChatGPT 查了点资料顺便润色的学生,因为留下了大段未经修改的词汇节奏,可能会在检测器里被亮起通红的警报;
而那些靠 AI 全文代写、深谙洗稿之道的人,只需要套用改写脚本,批量替换掉四分之一的同义词,就能带着17%的低检测率,大摇大摆地穿过所有监管。
“抓糙不抓精,防君子不防小人”
这场密码学奇迹,最终在人类朴素的“近义词词典”面前,摔了个踉跄。
04阳谋背后:为什么检测器不向所有人公开?
面对这样漏洞明显的机制,OpenAI难道不知道吗?
他们当然知道
注意看 OpenAI 的这波落地策略,每一个动作背后都写满了极度成熟的商业算计:
- 第一,全球API接口:默认关闭。
开发者爱开不开,完全自由; - 第二,ChatGPT和Codex默认加水印:只在欧盟上线。
其它地区该怎样怎样; - 第三,能够辨别真伪的检测器:不对普通公众开放。
想要?请大学教授和安全专家写申请报告,逐个审核。
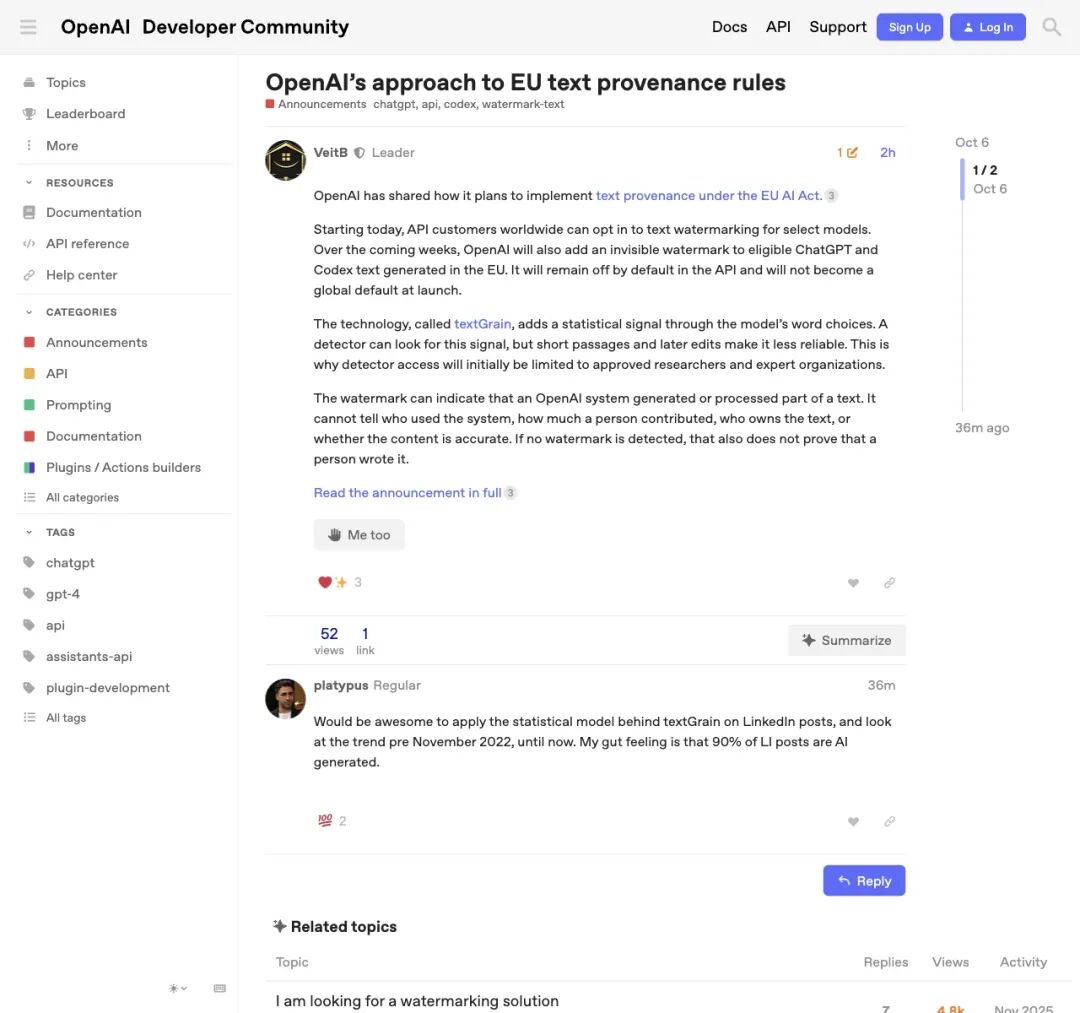
▲ 开发者社区明确公告:API默认关闭,检测器严控申请资格
为什么把检测器藏得这么紧?
因为这演变成了一场关乎对抗与破解的持续攻防。
一旦把检测器像翻译器一样公开发在网页上,全世界的灰产团伙会在24小时内,写出一套基于遗传算法的“洗稿对抗器”,
他们会让文字一遍遍通过检测器,只要发现哪一个词的替换能让概率下降,就自动锁定;不用一个星期,这套斥巨资研发的统计水印模型就会在对抗样本面前彻底沦为笑柄。
更何况,前车之鉴并不遥远
另一家大模型巨头 Anthropic 此前曾尝试在全球范围推行类似的防伪策略,结果遭到了全球付费用户的猛烈反弹与抱怨。
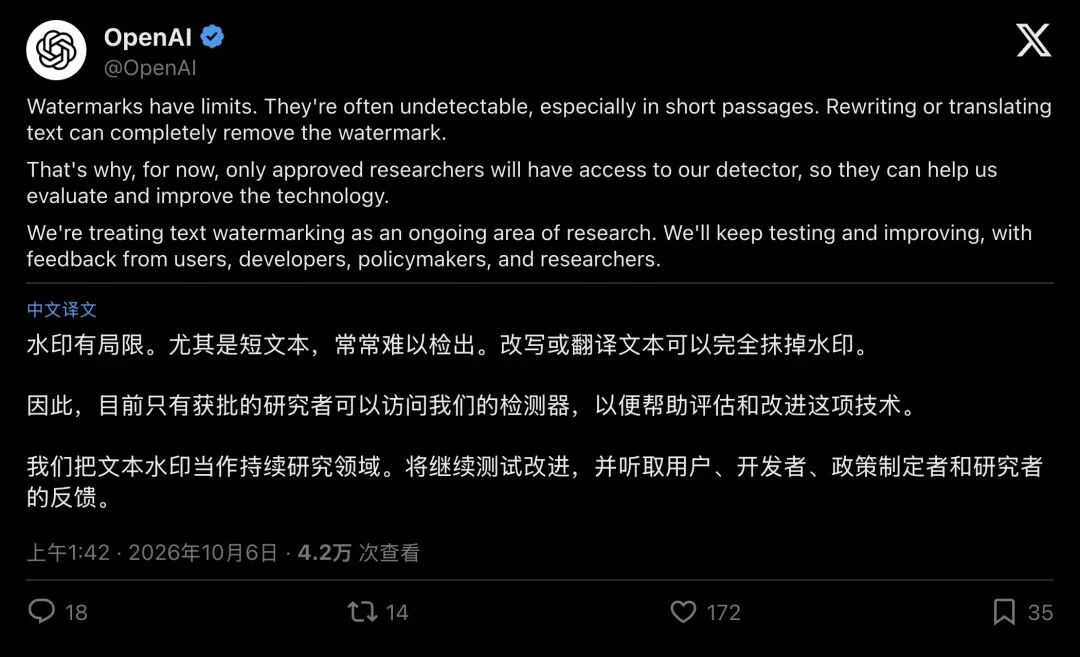
▲ OpenAI官方公开承认技术局限,并将落地范围圈定在欧洲
OpenAI 显然吸取了教训:既然欧盟法规拿枪指着头要求“生成式文本必须机器可读识别”,那我就交出一份数学上无懈可击、质量上挑不出毛病、但在现实应用中给所有人留足后路的满分答卷。
这既保护了商业利益,又满足了监管条款,堪称教科书级别的合规公关。
05终极命题:带水印的幻觉,依旧是幻觉
在这场关于技术与监管的大讨论中,技术观察家 Zain Akram 留下一句极其辛辣的评述,值得深思:
“textGrain 旨在厘清内容出处(Provenance),无法核实事实真伪(Truth);即便打上隐形水印,幻觉终究还是幻觉。”
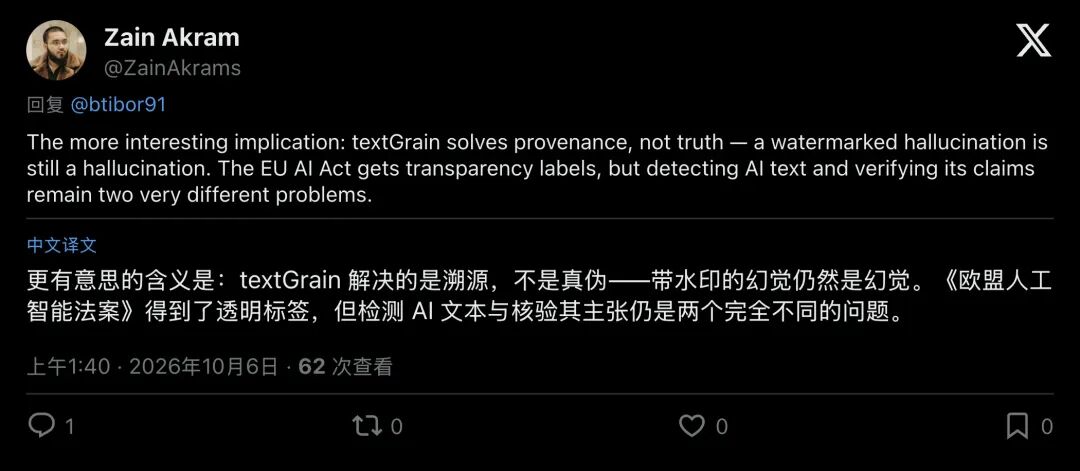
▲ Zain Akram 的高赞回复击中了问题的核心
很多人把“AI生成检测”误当成了未来的“真伪裁决所”。
但现实往往很荒谬:
哪怕一段文字里全是胡说八道的伪科学,只要它出自未经编辑的 ChatGPT,它就能被精准检测出“来自 OpenAI”; 哪怕一段文字是严谨的医学指南,只要一位医生用自己的临床经验改写了其中的关键句子,检测系统就会对它“视而不见”。
教育学家 Dan Fitzpatrick 也在社交平台上向所有老师泼了一盆冷水:
“不要以为有了水印,你就能抓出谁在作弊。水印只能证明学生打开过那个窗口,它根本无法证明这篇作业里到底包含了多少人类的思考。”
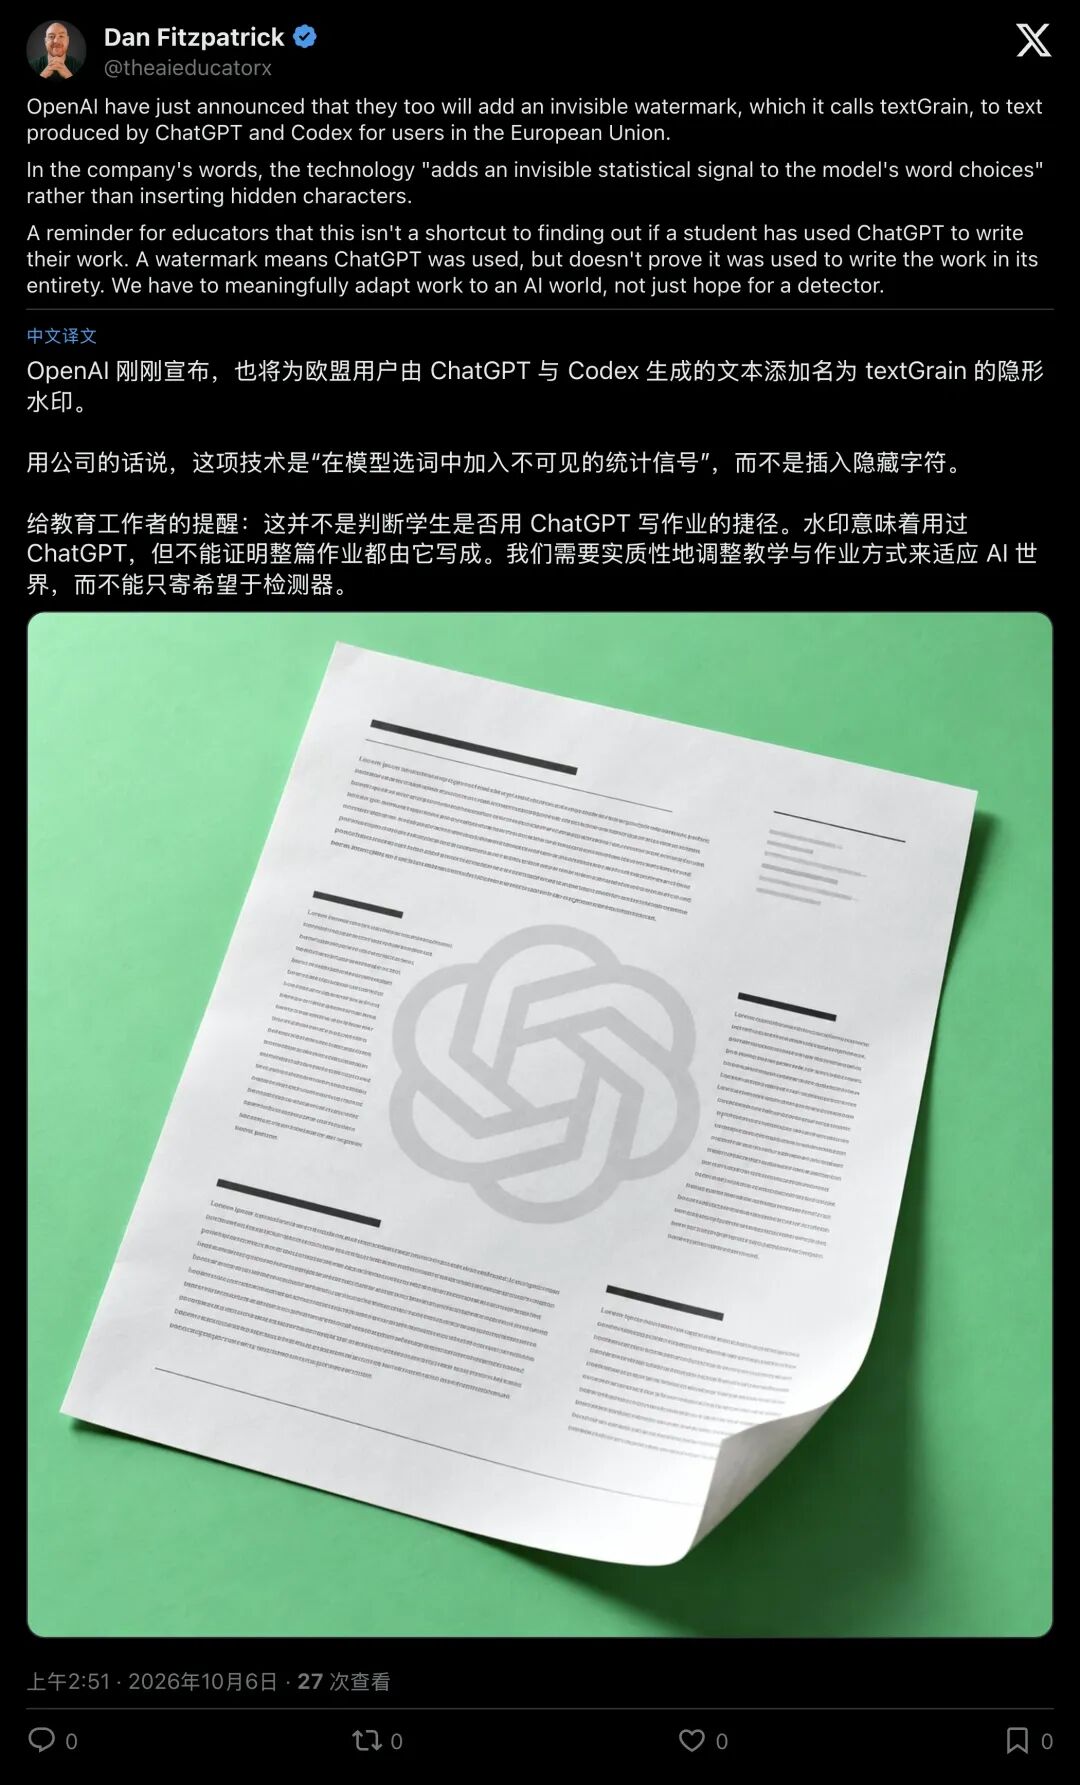
▲ 教育学者呼吁:不要幻想靠一个检测器解决教学评价问题
OpenAI 自己在博客里写得再清楚不过了:本系统不用于识别用户身份、不用于判定内容版权、不衡量人类贡献比例、更不保证内容是否属实。
它就像食品包装袋上印着的那行“可能含有微量花生”的法律免责标签,它的存在,只是为了在官司找上门时,厂商可以从容地翻出底牌说:“你看,我早就标注过了。”
06猫鼠游戏,才刚刚开始
回到最初的那个问题:我们的文字世界,真的被戴上紧箍咒了吗?
答案或许会让很多人松一口气,又会让很多人感到莫名的空虚。
textGrain 确实是一项极其优雅的数学发明。它让我们看到了人类顶尖科学家如何在概率密度的方寸之间,将信息悄然折叠进文字的韵律中。它足以横扫那些不动脑子的低级垃圾邮件群发器,也足以交差任何一张盖着官印的监管罚单。
但只要人类还会阅读,只要人类还会思考和改写,这道精心编织的密码防线,就会在键盘的一两声敲击中随风散去。
机器正拼尽全力在字里行间留下自己的呼吸,而人类只需要动用一点点偷懒的智慧,就能再度将它隐入尘烟。
这场关于真实与虚构的漫长猫鼠游戏,今天才不过是刚刚奏响了序曲。