ARTICLE · 1136326
七页文档,三套页码
课程纲要写到第七页,卡在目录上。
内容早就写完了,六章二十节,一个字不缺。麻烦出在前面:要加封面,要插目录,目录里的页码还得跟章节对得上。手改一遍,过两天动一个字,页码全乱。
这份东西要交到教导处装订成册。封面不编号,目录用罗马数字,正文从 1 开始。三个要求,一套页码搞不定。
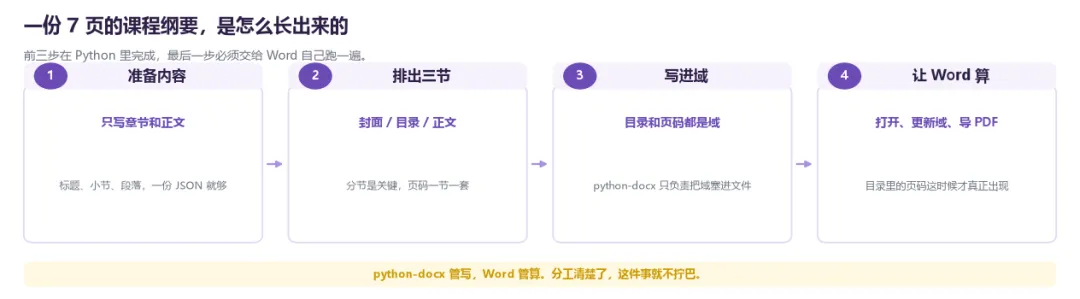
一份 7 页的课程纲要,是怎么长出来的
页码不是全篇一套
最容易想错的地方在这里。以为页码是整篇文档的一个设置,其实它是每一节一个设置。分节之后,每一节可以有自己的一套:用哪种数字、从几开始、放不放页眉。三节分得清清楚楚,封面那一节压根不放页码,自然就没有。
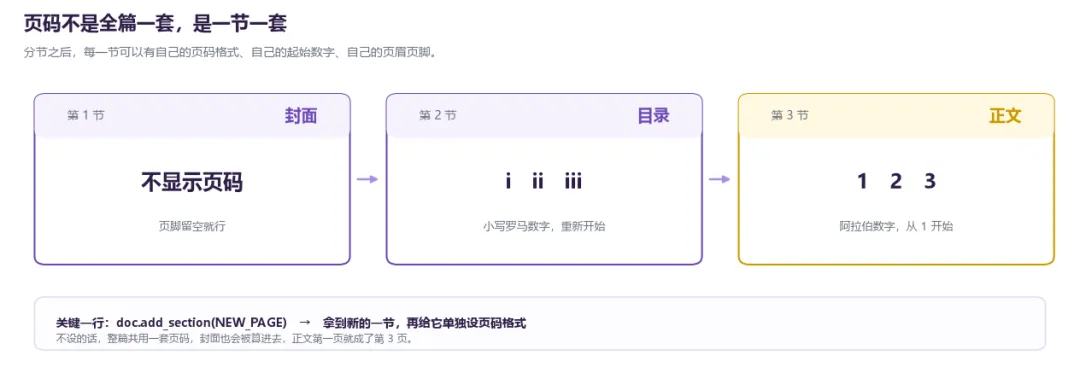
页码不是全篇一套,是一节一套
在 python-docx 里,分节就是一句话:
sec = doc.add_section(WD_SECTION.NEW_PAGE)
新节会把上一节的页面设置抄一份过来,边距、纸张都继承,唯独页码格式要自己设。不设的话,本节跟着上一节走。封面、目录、正文三节连着一路数下去,正文第一页就成了第 3 页。
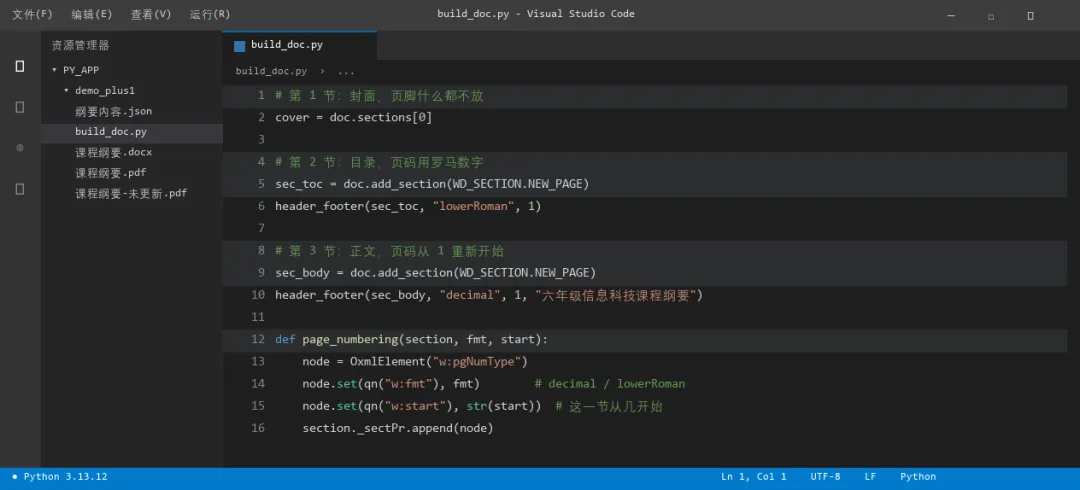
分节与页码格式
真正干活的函数不长。往 w:pgNumType 里写两个属性:w:fmt 决定用哪种数字,w:start 决定从几开始。
def page_numbering(section, fmt, start):
node = OxmlElement("w:pgNumType")
node.set(qn("w:fmt"), fmt) # decimal / lowerRoman
node.set(qn("w:start"), str(start))
section._sectPr.append(node)
decimal 是阿拉伯数字,lowerRoman 是小写罗马数字。目录那一节写 lowerRoman 配 start=1,正文那一节写 decimal 配 start=1。同一个 1,在两节里长得完全不一样。
顺便区分两个容易混的东西。分页符只是把后面的内容挤到下一张纸,前后还是同一节,页码格式、页眉页脚一概共享。要换页码格式,必须用分节符。doc.add_section() 加出来的就是分节符,默认从新的一页开始,看起来跟分页符很像,实际是两回事。分错了,页码怎么调都不对。
还有个容易忽略的地方:section._sectPr 上的设置是节级别的,跟段落级、字符级的设置各管一段。很多人调不好页码,就是把它当成全文属性在改。
目录和页码都是"域"
第二件要弄清的事:目录在文件里不是一段固定文字,页码也不是。
它们在 Word 里都叫域。域的意思是一条等着被算出来的指令。你写进文件的是一句"去把一到三级的标题收集起来,按顺序排好,后面接上页码"。至于页码到底是几,得看第一章实际落在哪一页。
一个域在 XML 里是五段结构:
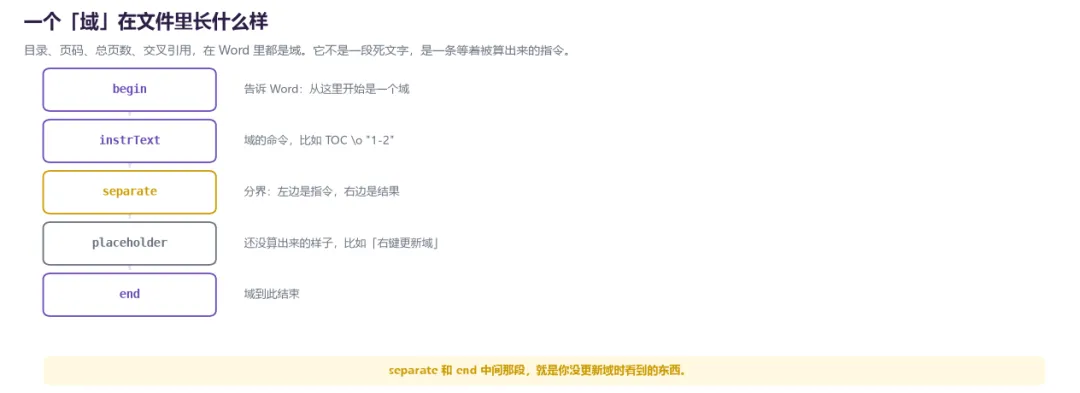
一个「域」在文件里长什么样
begin 和 instrText 之间放命令,separate 把指令和结果分开,end 收尾。中间那段占位文字,就是你没更新域时看到的东西。
拿目录举例,那句命令是 TOC \o "1-2" \h \z \u 。四个开关各管一件事:\o "1-2" 说收集一级到二级标题,三级不要;\h 把每一项变成能点的超链接;\z 在网页视图里藏掉页码;\u 把自定义样式的标题也算进来。想要三级标题就改成 \o "1-3",不要超链接就删掉 \h。这套写法跟你在 Word 里按 F9 更新域时看到的一模一样,不是 python-docx 另造的东西。
写进 python-docx 是这样:
def add_field(para, instr, placeholder="1"):
r = para.add_run()._r
f_begin = OxmlElement("w:fldChar")
f_begin.set(qn("w:fldCharType"), "begin")
f_instr = OxmlElement("w:instrText")
f_instr.set(qn("xml:space"), "preserve")
f_instr.text = f" {instr} "
...
注意 instrText 上那句 xml:space="preserve"。不挂它,命令里的空格会被当成格式空白吃掉, TOC \o "1-2" 变成 TOC\o"1-2",Word 就认不出来了。这个坑很安静,报错都没有,只是目录一直空着。
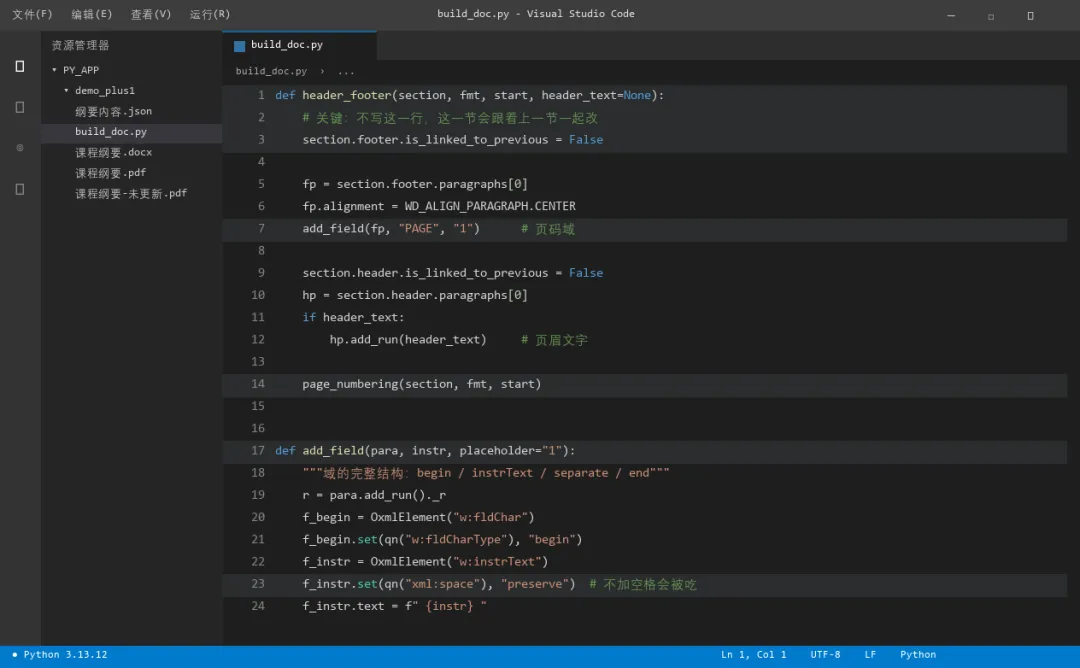
页眉页脚那几行
页眉页脚也不是全文一套。每一节都有自己的,而且默认跟上一节连着。改一节,三节一起变。
所以动手之前先断开:
section.footer.is_linked_to_previous = False
这一行不写,前面分节的功夫全白费。断开之后再往这一节的页脚段落里放一个 PAGE 域,页码就活了。页眉同理,放一行文字加一条下划线。
页眉页脚与域
再顺手记一个中文字体的坑。python-docx 里 font.name 设的是西文字体,中文走的是另一个属性,两个都要写:
run.font.name = "宋体"
run._element.rPr.rFonts.set(qn("w:eastAsia"), "宋体")
只写前一行,中文会悄悄掉回默认字体。文档打开看着像"差不多",细看字形不对,拿到手上就知道不是认真排的。
做出来是什么样
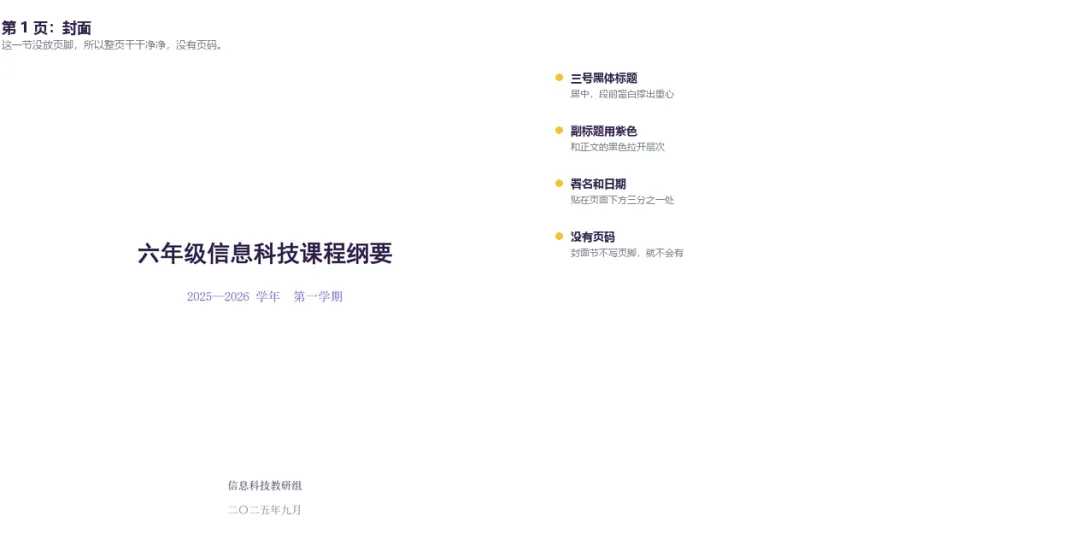
封面这一节没放页脚,整页干干净净。标题三号黑体居中,署名和日期贴在下方三分之一处,重心落在上三分之一。这一页不参与编号。
第 1 页:封面
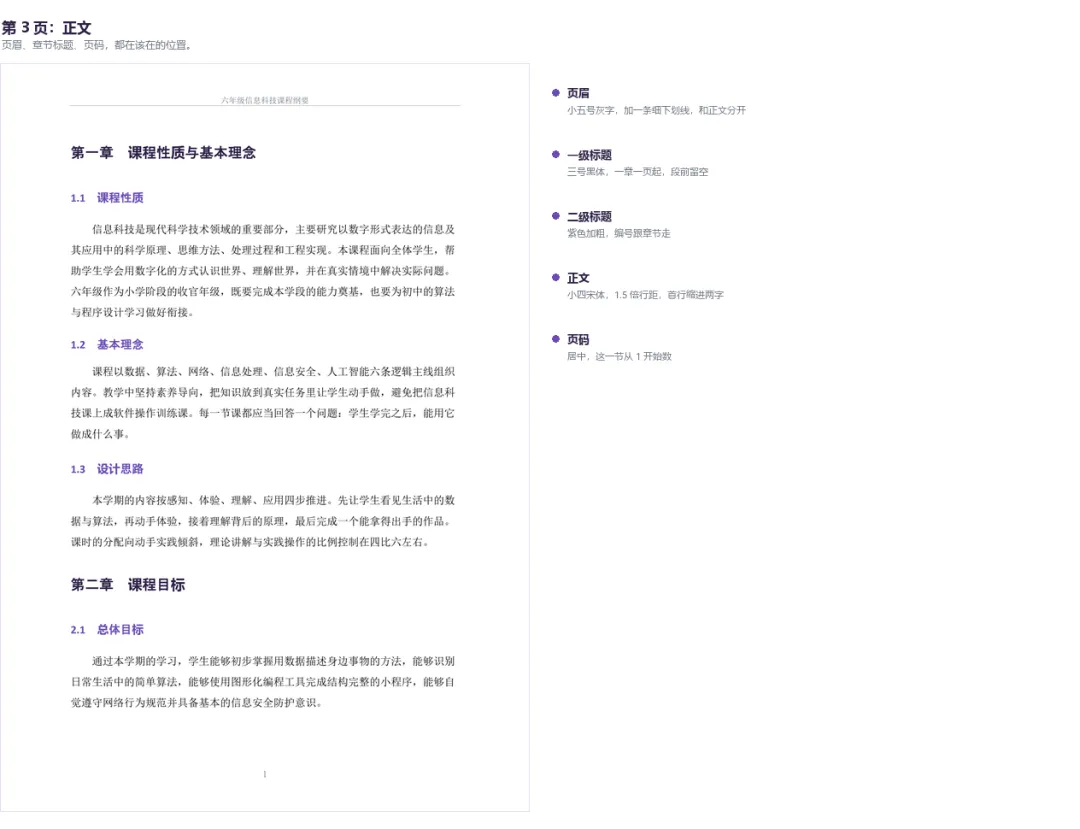
正文从第 3 张纸开始,页面上有页眉、有章节标题、页脚中间一个"1"。这个 1 是这一节的第一页,跟整册的第几张纸没关系。
第 3 页:正文
最关键的一步,得交给 Word
走到这里会有一个错觉:文件存好了,打开一看,目录怎么是空的。
因为 python-docx 只负责把域写进文件,它不负责算。它不知道哪一章会落在哪一页,压根没这个能力。算这件事只有 Word 会。
所以脚本最后要加一步,把文件交给本机 Word,让它打开、更新域、导出 PDF。用 pywin32 调 COM 接口,几行就够:
app = win32com.client.DispatchEx("Word.Application")
app.Visible = False
doc = app.Documents.Open(src)
doc.Fields.Update()
for i in range(1, doc.TablesOfContents.Count + 1):
doc.TablesOfContents(i).Update()
doc.ExportAsFixedFormat(pdf, 17) # 17 = PDF
doc.Close(0)
app.Quit()
Fields.Update() 管全部域,TablesOfContents(i).Update() 再单独把目录算一遍。两句都写上比较稳。启动对象用 DispatchEx,每次都起一个新的 Word 实例。用 Dispatch 有概率连到上一次没退干净的残留进程,紧接着就报"对象已与其客户端断开连接"。
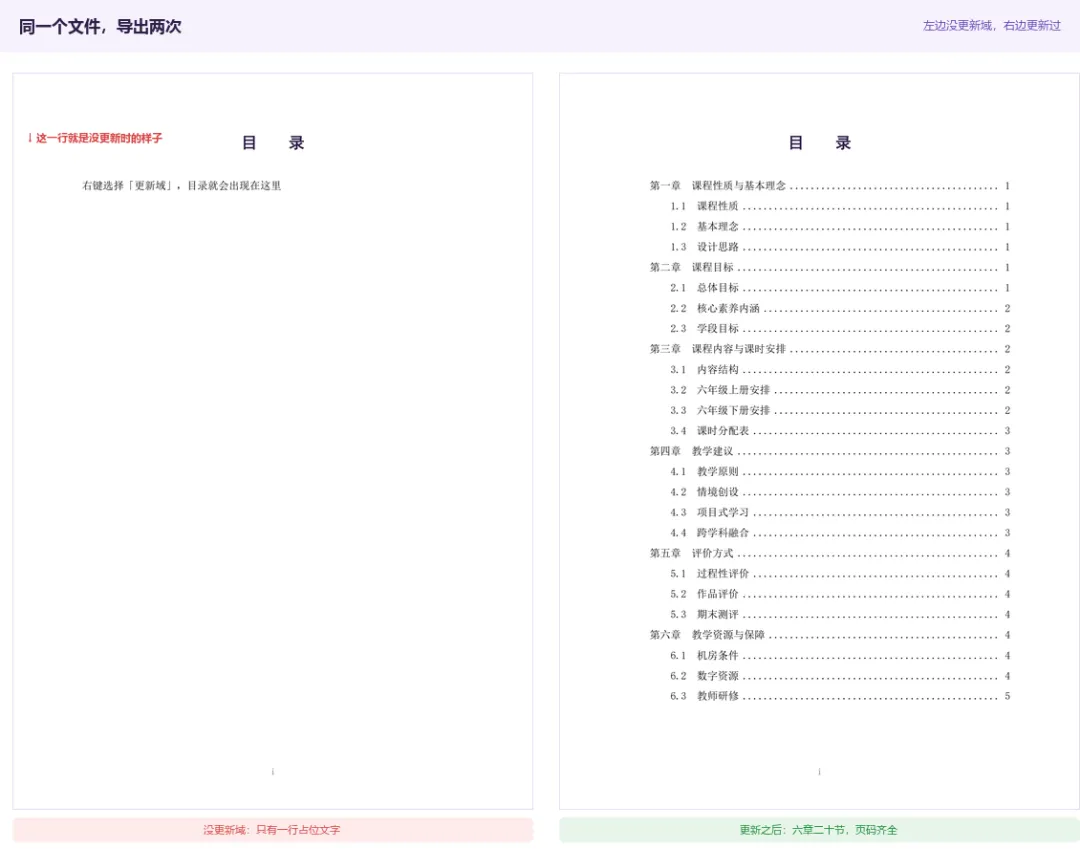
不更新的版本和更新之后的版本,差别是这样的:
同一个文件,导出两次
左边那行占位文字,就是 separate 和 end 之间的内容。右边的六章二十节和页码,是 Word 算完填进去的。
有意思的是耗时。前面在 Python 里搭完结构只用了一秒多,后面这一趟 Word 来回要十秒。
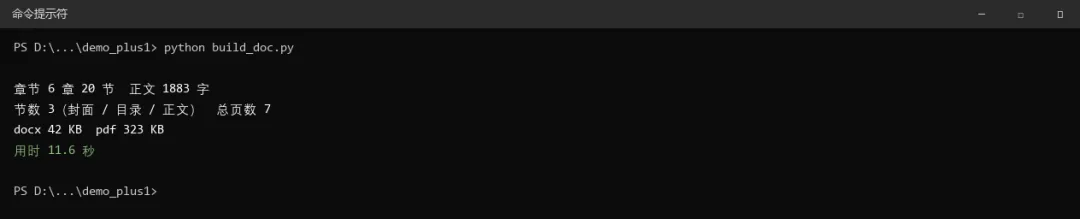
运行输出
这套骨架还能用在哪
把内容换掉,结构不用动。教研报告、学校制度汇编、期末总结、课题申报书,凡是"封面、目录、正文"这个形状的,都是同样的三节、同样的域,区别只在标题层级有几种。
验收的时候也别只看 Word 里的样子。Word 一打开就自动更新域,看着一切正常。真正要确认的是导出的 PDF:翻到目录标的第 4 页,看看第四章是不是真在那儿。这一步花十秒,能省掉交上去之后被打回来的麻烦。
机器上装的是 WPS 也没关系。WPS 注册了同样的 Word.Application 接口,DispatchEx 拿到的就是它,导出 PDF 的命令照样跑通。只是排版引擎不完全一样,行距和字距会有细微出入,正式交之前自己翻一遍。
另外,脚本负责的是"每一次都按同一套规则排",它不管这份纲要写得好不好。章节怎么分、课时怎么配、评价怎么设计,这些还得人来定。工具能省掉的是重复动作,省不掉判断。
最后
三个数字:7 页、3 节、正文 1883 字。docx 42 KB,导出的 PDF 323 KB。
这套做法有个前提,机器上得装着 Word。没有 Word 就没有最后那一步,域永远停在占位文字上。反过来看,正因为有 Word 在,代码才能只做它擅长的事:把结构搭对,把域写进正确的位置,剩下的交给排版引擎。
目录和页码这两样,手加一次不算麻烦,麻烦的是改完之后还得再对一遍。交给脚本之后,动一个字,重跑一次,页码自己就跟上了。