ARTICLE · 1137513
雪藏4年,OpenAI终于给ChatGPT打上隐形水印!但改一个词就失效
作者知遥
编辑远瞳
谁也没想到,OpenAI 压箱底压了整整四年的“核武器”,会在这个秋天以一种极其微妙的姿态被端上台面。
就在近日,OpenAI 突然发布公告:正式上线一套名为 textGrain 的文本隐形水印技术。未来几周内,欧盟境内的所有 ChatGPT 和 Codex 用户,生成的每一段长文本,都将被打上一串肉眼不可见的“数学烙印”。
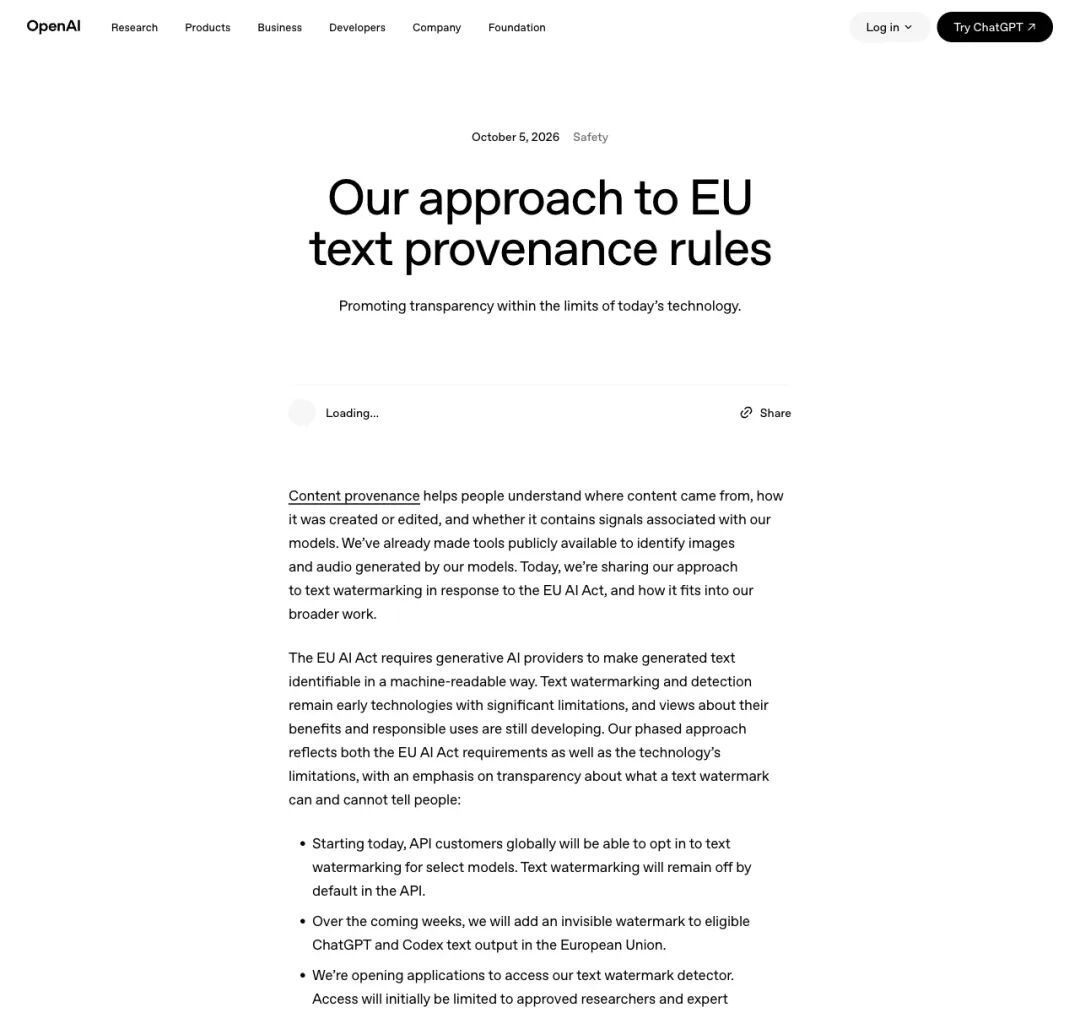
▲ OpenAI 官方公告《Our approach to EU text provenance rules》
只要拿出特制的检测器扫上一眼,哪怕你把格式清空、字体换掉,它也能以极高的置信度当场指认:“这段话,就是出自 OpenAI 之手。”
一时间,全网高校教师和内容审查平台拍手称快。大家以为,那个让全世界头疼了三年的“AI 论文作弊与洗稿狂潮”,终于要迎来终结者了。
然而,撕开这层体面的技术外衣,背后的故事却充满戏剧性与讽刺:
这项号称能“抓包 AI”的神级技术,在 OpenAI 内部其实早在四年前就已成型。但因为一份绝密的内部调研,它被高管们死死压在箱底雪藏了四年;
在这个耗费诸多顶尖数学家心血的“密码级水印”面前,破解手段却格外朴素:随手改几个词,或者扔进翻译软件倒手一次,整套防御瞬间土崩瓦解。
这到底是一场终结混乱的学术打假革命,还是一场迫于法规压力的天价合规秀?
01惨败的旧方案:那个准确率 26% 的“赛博算命先生”
要搞懂今天的隐形水印有多激进,必须先回头看看 OpenAI 当年摔得有多惨。
大模型刚爆发时,全世界的老师都在发疯:满屏都是 ChatGPT 代写的作业,到底该怎么抓?
面对滔天的舆论声浪,OpenAI 在 2023 年初曾仓促上线过一个旧方案,AI Text Classifier(AI 文本分类器)。
▲ OpenAI 帮助中心关于内容溯源信号的历史与现状说明
这个旧方案走的是典型的“事后诸葛亮”路线。模型生成文字时什么记号都不留,等文字流传到市面上,再训练一个二分类神经网络,像老中医把脉一样去反向推断:“这段话一股子 AI 味,大概率是机器写的。”
结果,这个旧方案沦为科技史上的一场史诗级灾难:
- 抓不到贼
:官方自测的真阳性率只有惨淡的 26%。也就是说,抓四篇 AI 代写的论文,能漏跑三篇。 - 冤枉好人
:高达 9% 的假阳性率同样引发众怒。大量非英语母语的留学生与海外学者,辛辛苦苦自己手敲出来的学术长文,因为句式严谨规范,被无情打上“AI 剽窃”的耻辱烙印。
仅仅苟延残喘了 6 个月,OpenAI 就顶不住全球学界的声讨,在 2023 年 7 月以“准确率过低”为由,灰头土脸地把该工具彻底下线。
这次惨痛的翻车让 OpenAI 内部彻底认清了一个数学现实:光凭文本表面特征去“事后反向推断”,在统计学上纯属死路一条。要想抓贼,必须在模型开口说话的那一毫秒,从源头上亲手把暗号打进去。
02降维打击的新方案:在概率分布里悄悄“灌铅”
既然事后检测行不通,新的 textGrain 是怎么在完全不改变文字内容的情况下,神不知鬼不觉地打上烙印的?
很多人一听到“水印”,往往会联想到图片角落的半透明 Logo,或是排版里偷偷塞进去的“零宽不可见字符”。
但 textGrain 绝非这种低端把戏。它不插入任何奇怪符号,不加多余空格,也不改动任何标点。整段文本干干净净,全是地地道道的常用汉字与英文。
那么暗号到底藏在哪?答案就藏在词与词之间的“微观偏好”里。
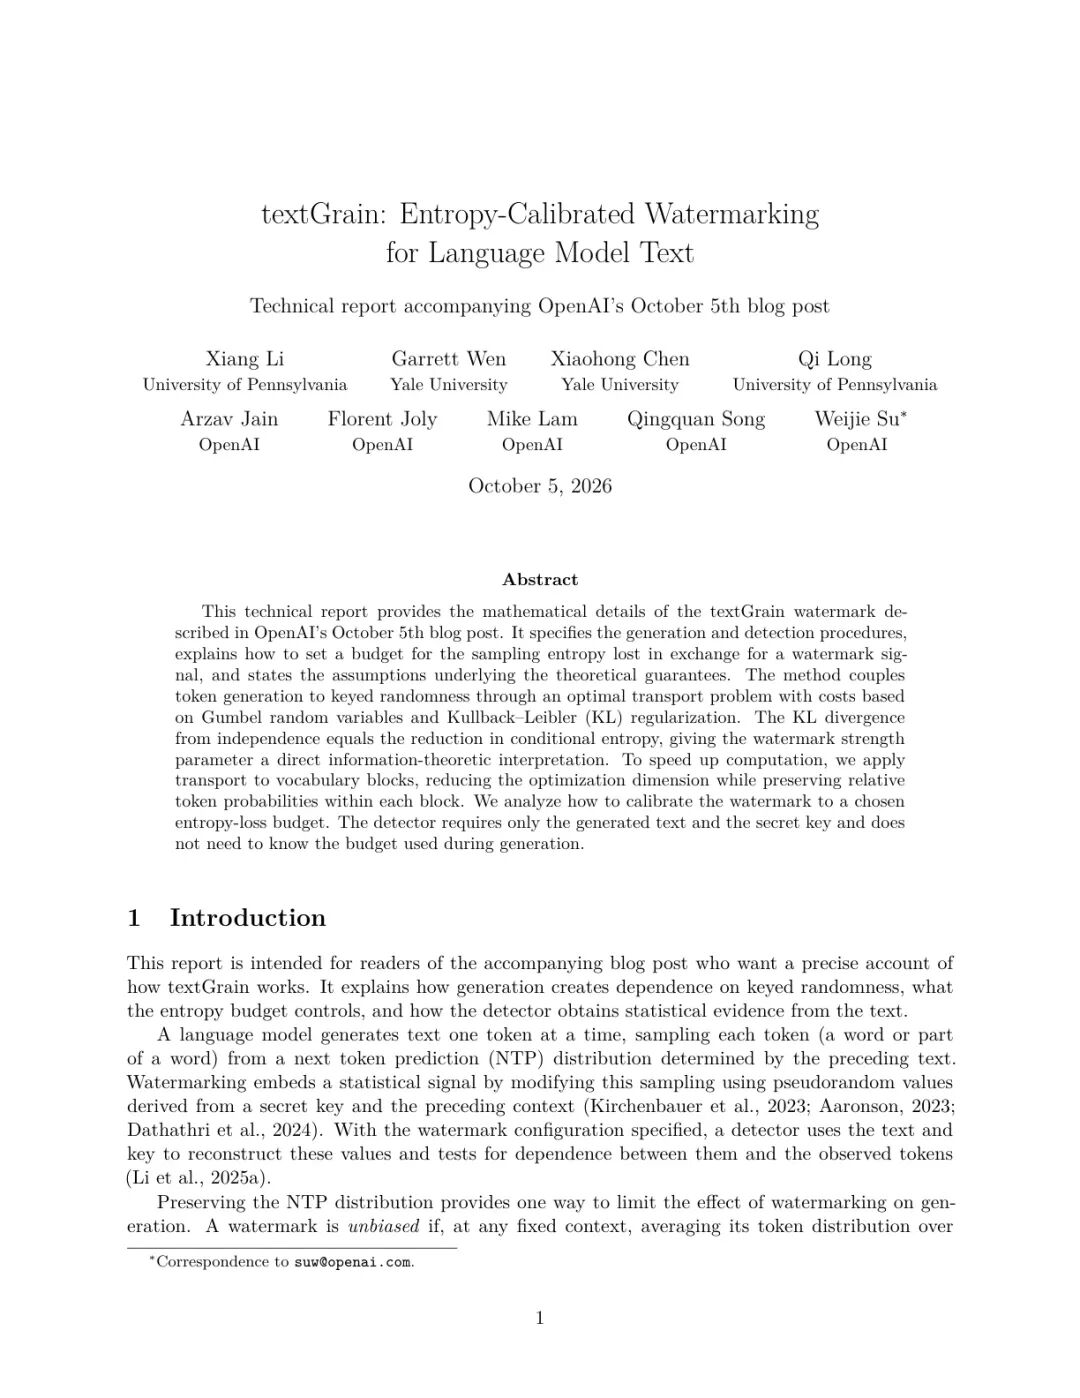
▲ textGrain 技术报告:由宾夕法尼亚大学、耶鲁大学与 OpenAI 联合完成
高中语文老师都讲过,同一个意思往往有多种词汇表达。大模型在输出文本时,其实是在玩一场概率游戏。
比如句子写到“今天的天气真……”,模型脑海里的候选词池可能会跳出好几个候选项:
晴朗(概率 40%) 好(概率 35%) 舒服(概率 25%)
如果没有水印,模型就会按照常规概率随机摇号。但有了 textGrain,系统手里握着一把绝密的密码学数学密钥。
在决定吐出哪一个词的瞬间,系统会根据密钥,把所有合理候选词悄悄切分成不同的“秘密区块”,并利用最优传输理论对采样进行极其微小的有偏倾斜,在不破坏语意连贯的前提下,模型会更偏向于选择符合密钥规律的那个词。
这就好比一个神级赌徒,在掷骰子时每一把都看似随机,六个点数全都能掷出来;但在千百次投掷之后,后台用专用的数学检测器一统计,就会发现骰子被极其隐蔽地“灌了铅”,其数字落点严格遵循着某种只有庄家才知道的统计周期。
文本本身没有变,变的是词元组合之间的微观统计纹理。
这就是 textGrain 的恐怖之处:拿肉眼去看,它行云流水,挑不出任何毛病;但只要把两三百个 token 扔进检测器,后台的统计置信度瞬间就会像警报一样拉响。
03内部调研受阻:为什么它被雪藏了四年?
看到这里你一定会困惑:既然新技术如此优雅强大,为什么直到 2026 年的今天才拿出来?
其实,早在 2022 年夏天,也就是 ChatGPT 席卷全球的前几个月,著名理论计算机科学家 Scott Aaronson 在 OpenAI 进行学术休假期间,就已经联手工程师 Hendrik Kirchner 把这套统计水印的核心数学原型敲出来了。
当时内部测试的准确率甚至冲到了惊人的 99.9%。
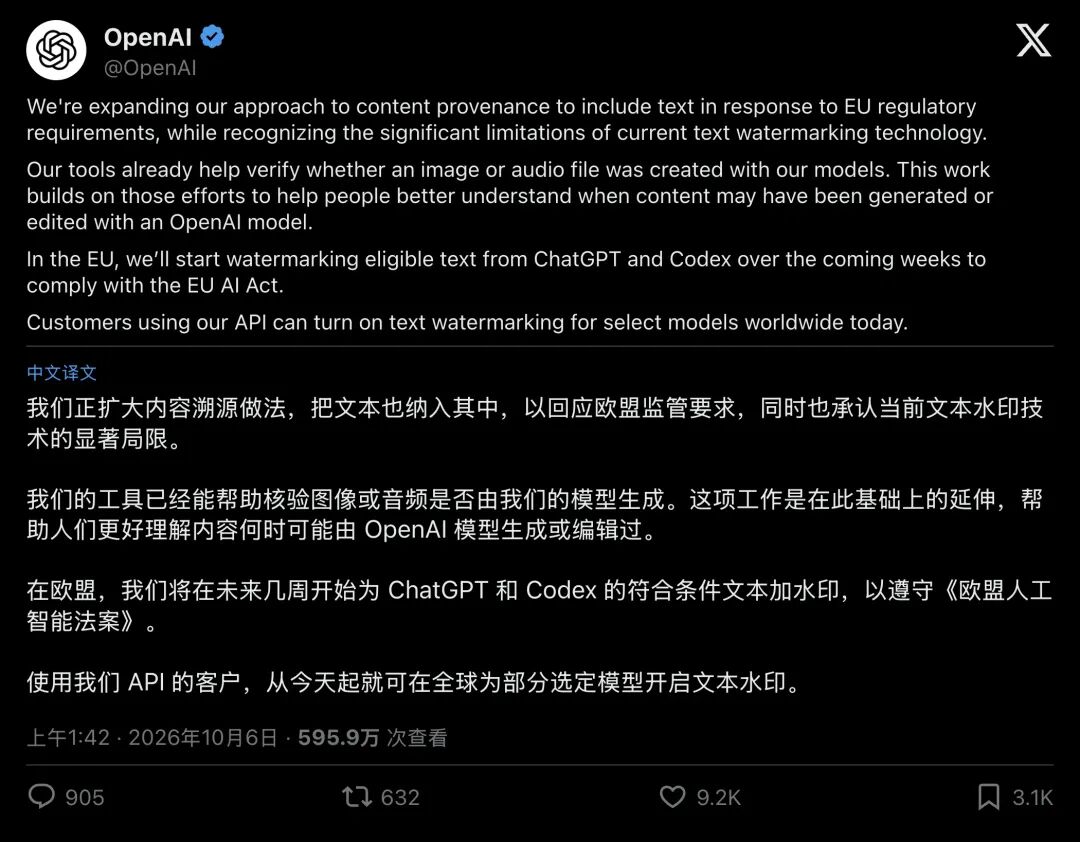
▲ OpenAI 官方发帖承认扩大内容溯源,并明确指出当前文本水印的技术局限
技术本身早已成熟,阻力完全来自商业利益引发的极度恐慌。
2024 年 8 月,《华尔街日报》(WSJ)抛出过一篇轰动科技圈的重磅调查报道,揭开了这段被尘封的内幕:
OpenAI 的增长与市场团队曾悄悄做过一次高度保密的付费用户调研。结果如同一记闷棍,直接把管理层打蒙了,
近 30% 的 ChatGPT 付费订阅用户明确警告:一旦你们敢上线文本水印,我们将在 24 小时内立即退订,并火速转投竞品(如 Claude、开源的 Llama 等)的怀抱!
在商业扩张的狂热军备竞赛中,谁敢亲手砍掉自己近三分之一的营收命脉?
安全团队主张“践行技术伦理”,产品团队怒吼“这是自杀行为”。两派激烈博弈的结果,是奥特曼和高管层按下了暂停键。这个足以改变生成式 AI 版图的工具,就此被无情锁进了冷宫。
04刺刀见红的死局:欧盟法案强制破冰
把 OpenAI 从贪婪的商业避风港里一脚踹出来的,是来自布鲁塞尔的监管重拳。
2026 年 8 月,《欧盟人工智能法案》(EU AI Act)全面生效。法案白纸黑字写得清清楚楚:所有通用人工智能提供方,必须以“机器可读”的方式明确标识其生成的文本内容。
违者将面临顶格高达 1500 万欧元或全球年营业额 3% 的天价罚单!
更让 OpenAI 坐不住的是,竞争对手 Anthropic 率先打破囚徒困境,在 8 月份顶着骂声直接上线了水印体系。
眼看监管红线逼近,合规的丧钟终于敲响。2026 年 10 月,OpenAI 只能把雪藏四年的技术重新打包,换上 textGrain 的新马甲推向台前。
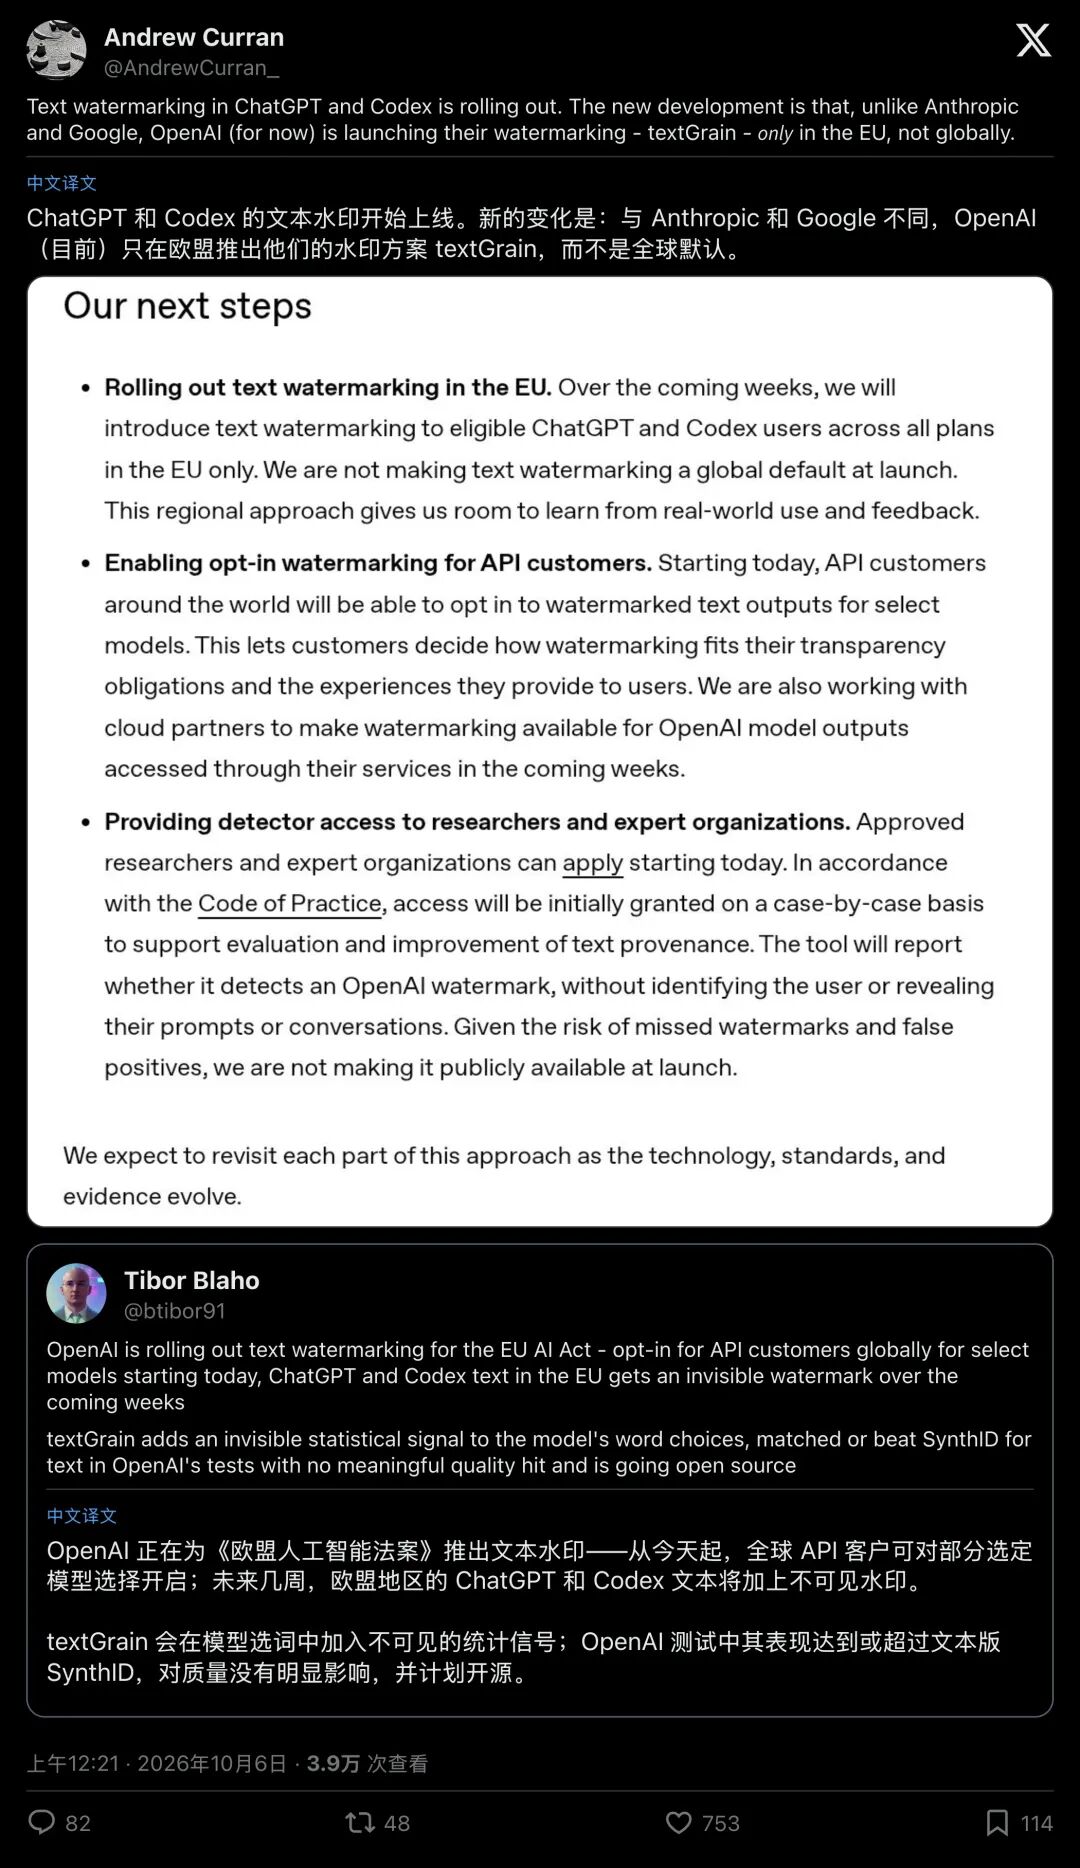
▲ 科技评论员指出:与全面铺开不同,OpenAI 极其鸡贼地将该功能锁死在“欧盟特供”范围内
但在上线策略上,OpenAI 依然展现出了教科书级别的“商业精明”:
- 死守存量市场
:水印只在欧盟境内的 ChatGPT 和 Codex 上默认开启,美国本土和全球其他地区,一律不默认上线! - 保护企业金主
:全球开发者最依赖的 API 接口,虽然技术上线,但默认状态依然是关闭。你想合规你就自己手动开,不想开绝不强求; - 把控裁决大权
:检测器不对公众开放,普通老师和老板根本拿不到,初期仅通过个案审批向极少数受信任的专业科研机构开放。
既应付了欧盟的法条免挨天价罚单,又把全球绝大多数付费用户的流失风险降到了最低。这一手“合规太极”,打得不可谓不纯熟
05荒诞的现实反转:改写两个词,水印全报废
然而,这套经历四年沉淀、凝聚顶尖密码学与概率论智慧的防御系统,在现实世界的实测表现到底如何?
OpenAI 官方在自评报告与说明推文中,非常罕见地说了大实话,直接揭开了这套“防伪护甲”脆弱的一面:
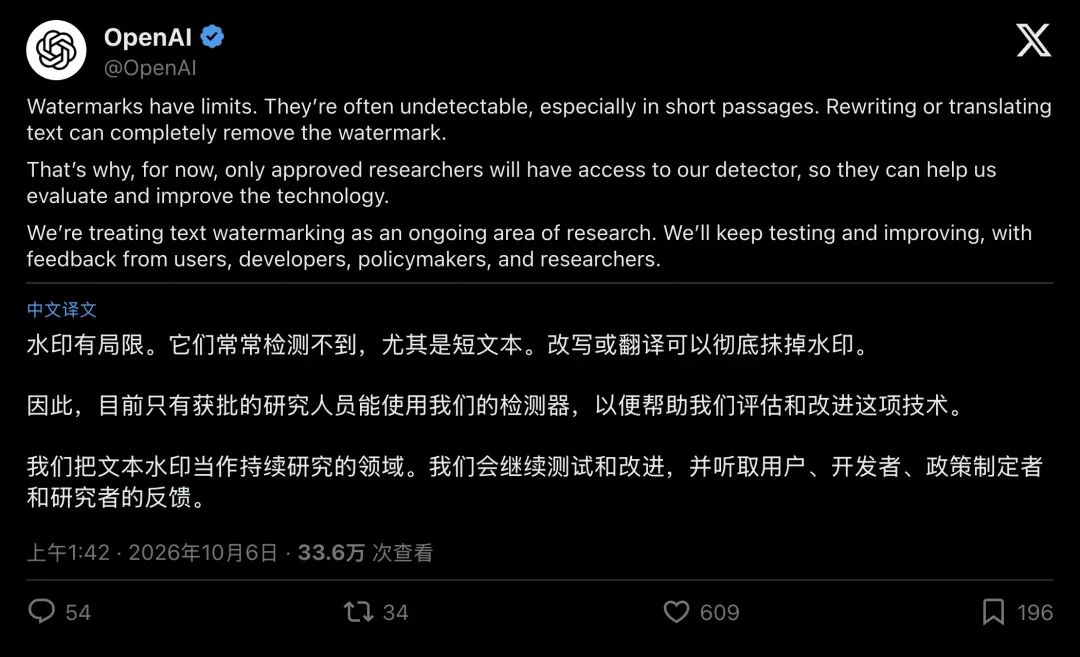
▲ OpenAI 官方推文直言当前技术局限:短文本难以检出,改写与翻译会彻底抹除水印
- 短文本直接瞎火
:如果你的文字较短(比如一两句话或两百字以内),选词空间极其有限,检测器基本无法判定; - 死穴是数理逻辑
:在心理学、社科等同义词丰富的长文章中,200 到 400 个 token 的检出率能达到 80% 到 95%;但一旦遇到数学推导或严密代码,由于能用的变量和符号被锁死,检测率断崖式下跌; - 换几个词彻底废掉
:在一段约 400 token 的标准段落中,只要你做大约 10% 的同义词替换,检出率就会从 92% 骤降至 66%;一旦你替换掉 25% 的词,检出率直接暴跌到可怜的 17%!
海外科技博主 Kai 在推特上一针见血地点破了真相:
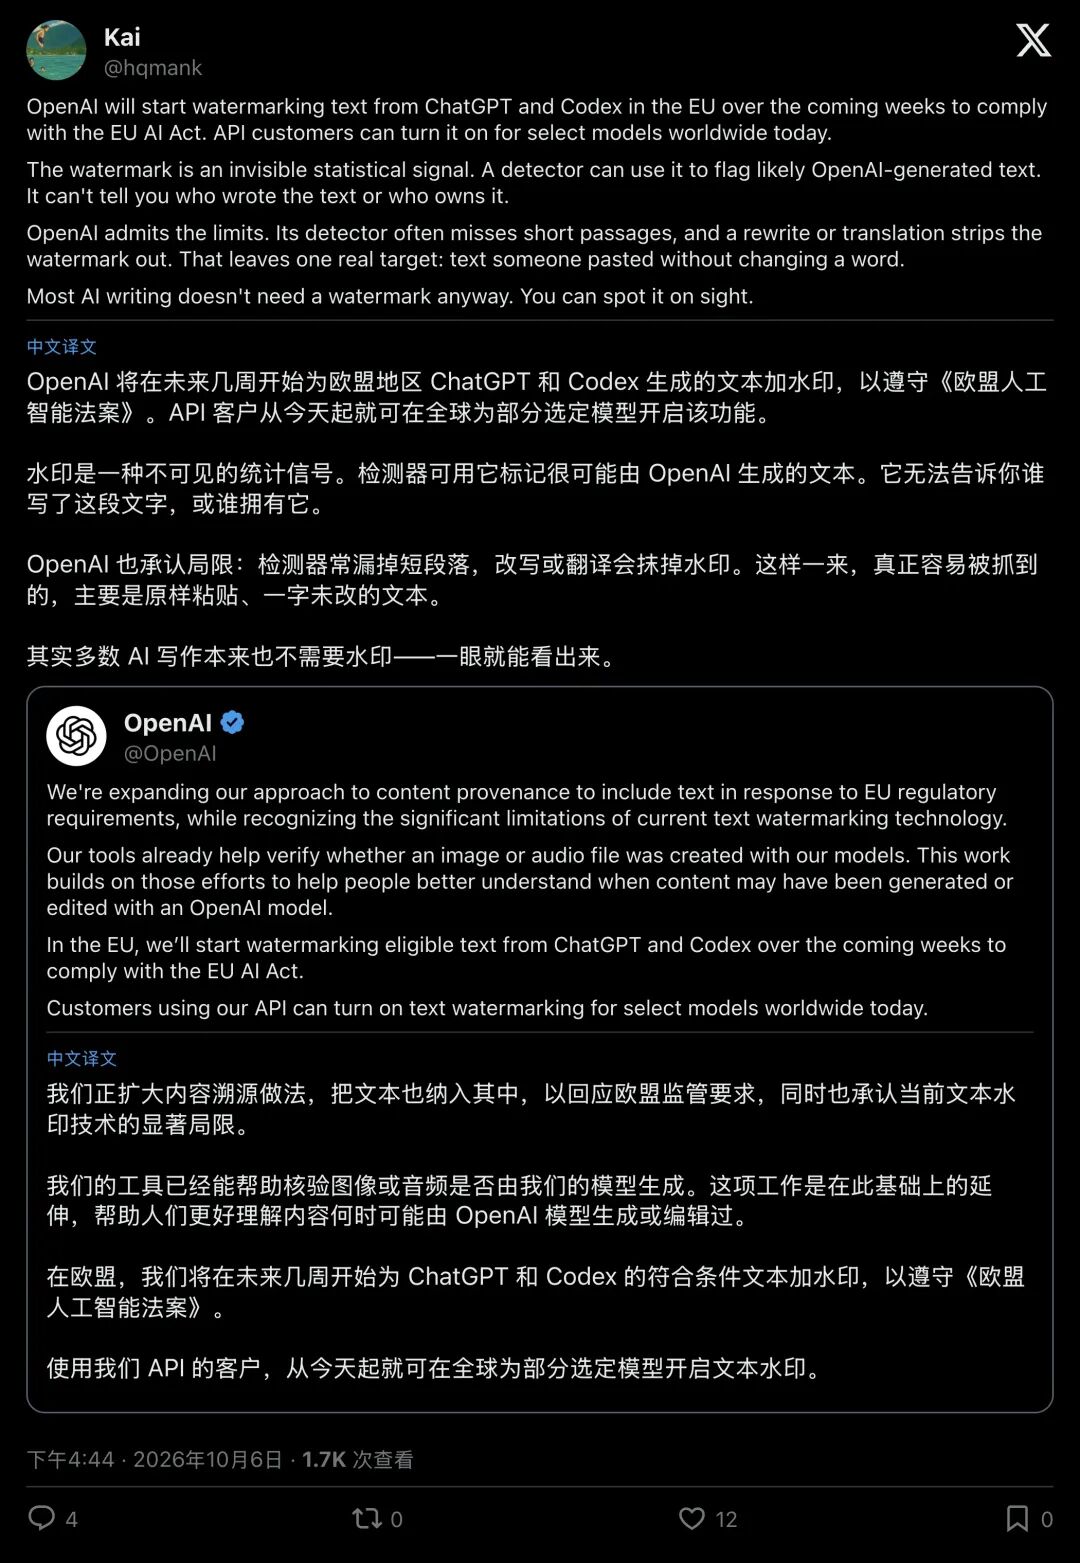
▲ 科技推主 Kai 评价:改写或翻译直接剥离水印,它唯一能抓到的只有原封不动的粘贴犯
“OpenAI 自己都承认了局限。短文本漏检,稍微改写或者翻译一遍就能彻底抹掉信号。
这套机制兜兜转转,最终只能约束一个群体:那些偷懒到连一个字都懒得改、纯原样复制粘贴的人。”
更有网友在官方评论区留下了嘲讽拉满的锐评:
“AI 水印听起来高端大气上档次,直到你发现干掉它最简单的方法是……随手编辑一下文本。”
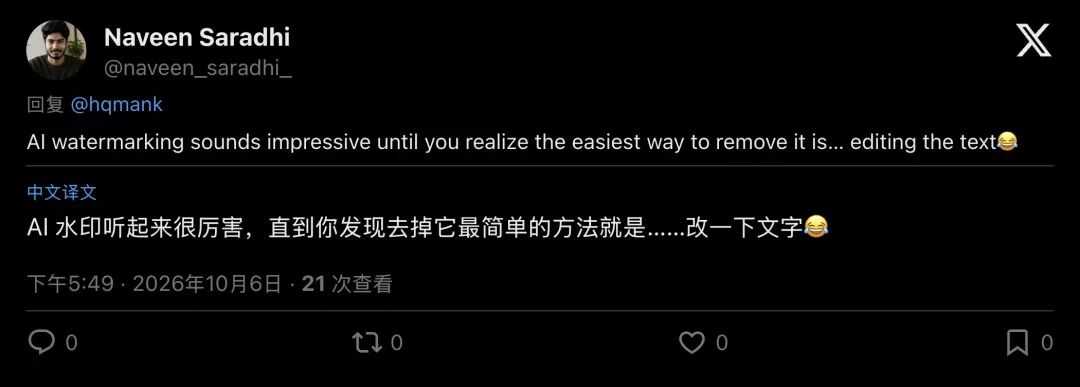
▲ 网友锐评:干掉高科技水印最简单的办法,竟然是小学生都会的改字
06终局拷问:我们到底在标记什么?
至此,整场事件走向了一个哲学层面的荒诞闭环。
一方面,无数创作者在哀嚎被“误伤”有人在论坛控诉:自己花三个通宵手写了三千字长文,仅仅丢给 ChatGPT 帮忙理了理排版、抓了抓标点,整篇文章就被打上了“AI 制造”的统计水印。
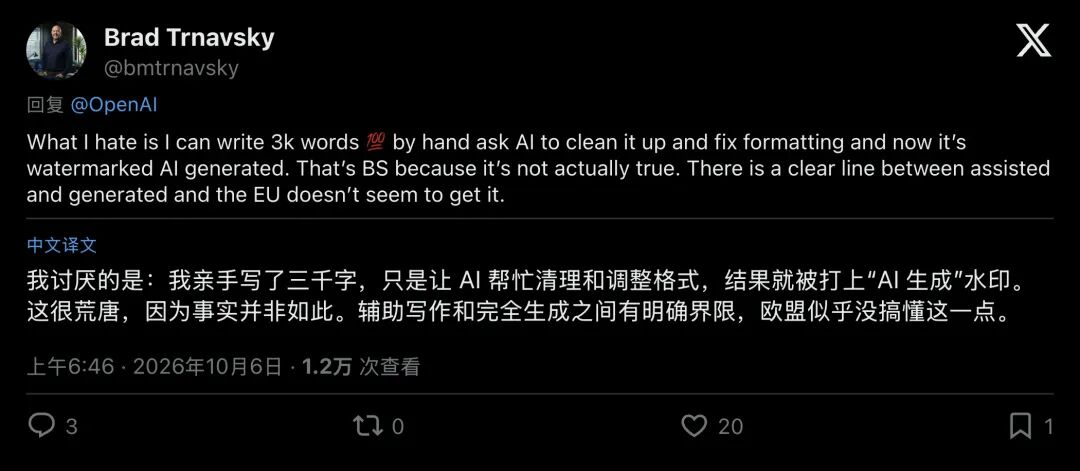
▲ 网友抱怨:自己写好的长文仅让 AI 调整格式,界限却被彻底模糊
另一方面,蓄意作弊者与黑产洗稿团伙,只需用自动化脚本把 AI 生成的文本扔进翻译器倒一手(英文翻德文再翻回英文),就能轻松洗去全部数学印记,大摇大摆地穿行在监管视线之外。
从 2022 年理论诞生的意气风发,到 2023 年事后分类器的狼狈下线;从 2024 年商业利益面前的隐秘雪藏,再到 2026 年面对法规刺刀时的被动妥协,textGrain 的诞生史,就是生成式 AI 狂奔四年的一面照妖镜。
它让我们看清了一个冰冷的事实:在数字时代,“绝对的技术真实”或许本身就是一个伪命题。
当机器生成的语言已经与人类思考的肌理深度嵌合,试图通过操纵几个骰子点数来划清人机界限,注定是一场按下葫芦浮起瓢的猫鼠游戏。
隐形水印拦不住作弊者,它只是在这个狂奔的时代,为惊慌失措的人类监管者,递上了一剂免除法律责任的安慰剂。