ARTICLE · 1137524
月费200榨出9万算力!OpenAI紧急腰斩,硅谷最疯狂的“薅羊毛”暗战杀疯了
你敢相信吗?
你每个月咬牙掏出 200 美元(约合人民币 1400 元)买的 AI 会员套餐,如果把里面的额度彻底“榨干”,实际能从厂商手里硬生生薅出高达 12,529 美元(近 9 万元人民币)的算力!
60 多倍的账面杠杆
这相当于你花了一张经济舱的机票钱,结果航空公司不仅把你升到了头等舱,还顺便送了你一架私人飞机的一周使用权。
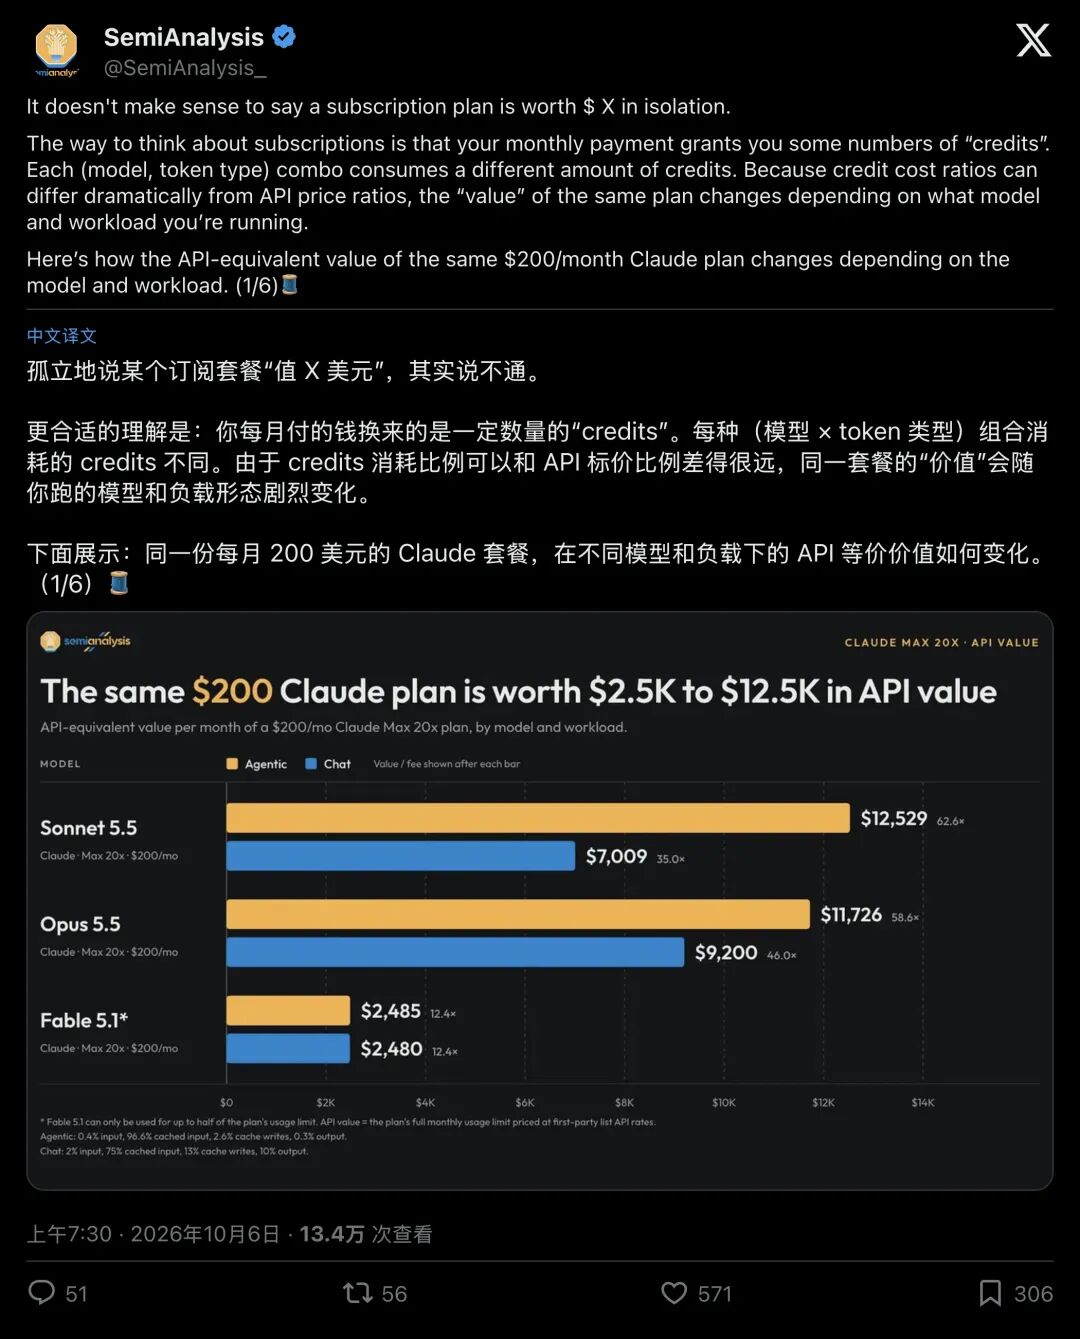
▲ SemiAnalysis 实测数据:同样是 200 美元月费,在 Claude Max 上最高可跑出折合 1.25 万美元的公开 API 标价算力
然而,就在所有羊毛党开发者狂喜的时候,另一边的 AI 霸主 OpenAI 却毫无征兆地掀了桌子。
他们不仅没有跟进补贴,反而直接掏出剪刀,把自家 200 美元档位的老套餐额度,一夜之间当场砍半。
一边是 Anthropic 仿佛做慈善般的“算力大放送”,另一边是 OpenAI 毫不留情的“深夜背刺”。
全球顶尖半导体智库 SemiAnalysis 随后发布了一份长篇调查,用详实的测试数据测算出惊人差距:在主力中端模型的较量上,Anthropic 订阅给用户的等价算力,竟然直接达到了 OpenAI 的 5.6 倍!
但这场狂欢的背后,真有免费的午餐吗?
当研究员们拿着放大镜层层拆解,一个充满“印钞障眼法”、“话痨模型陷阱”与巨头算力流血的残酷真相,终于浮出了水面。
01一夜砍半!OpenAI 为何突然痛下杀手?
这场大乱斗的导火索,始于 2026 年 9 月底 OpenAI 官方发出的一封公开信。
发帖人是负责 Codex 与 ChatGPT 核心产品的 Tibo。他的语气听起来极为温和,但内容却让所有高阶开发者倒吸一口凉气:
每月 200 美元的 Pro 订阅重新开放,但底层的用量算法变了,折算下来,新套餐给你的 API 额度,只有过去的一半。
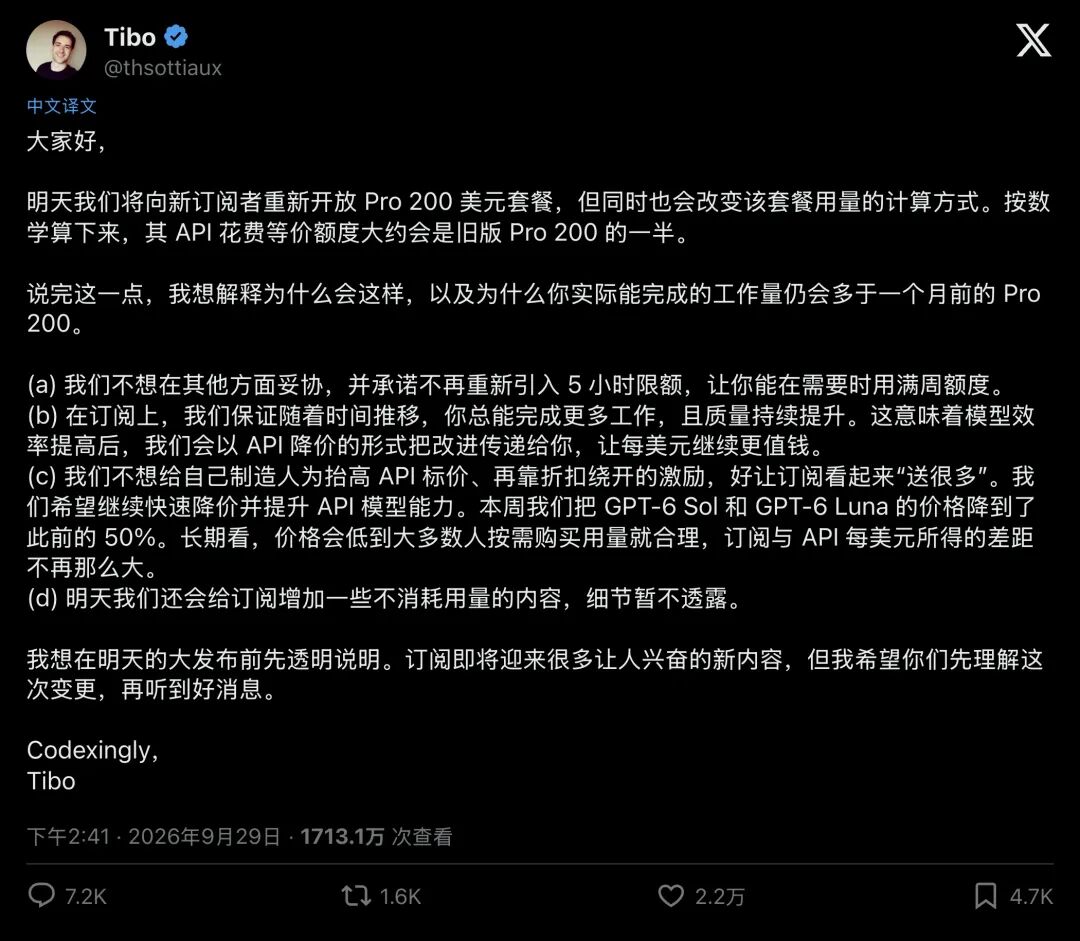
▲ OpenAI 核心高管 Tibo 发文解释为何将 Pro 200 美元订阅的实际额度砍掉 50%
为了平息社区怒火,官方列出了长长一串理由:
我们承诺不加回恶心人的“5小时限制”; 我们的模型越来越聪明,单次解决问题的效率越来越高; 我们不屑于像友商那样“虚抬 API 标价来制造优惠假象”; 我们接下来会送一些不扣额度的新功能。
但开发者的账本是无情的
无论官方话术多么动听,事实摆在眼前:花同样的钱,能调用的模型物理次数直接缩水了 50%。老用户的待遇只能苟延残喘保留到 10 月 29 日,新用户进门就得挨这一记闷棍。
而就在 OpenAI 紧急筑墙防守的同时,他们的死对头 Anthropic 却在隔壁大开城门。
SemiAnalysis 的横向评测显示,在开发者日常最依赖的“中端主力模型”对决中(Anthropic 的 Opus 5.5 对阵 OpenAI 的 GPT-6.1 Sol):
同样花 200 美元,Claude 能跑出折合 11,726 美元 的 API 标价算力; 而 OpenAI 砍额后,只能跑出 2,084 美元。
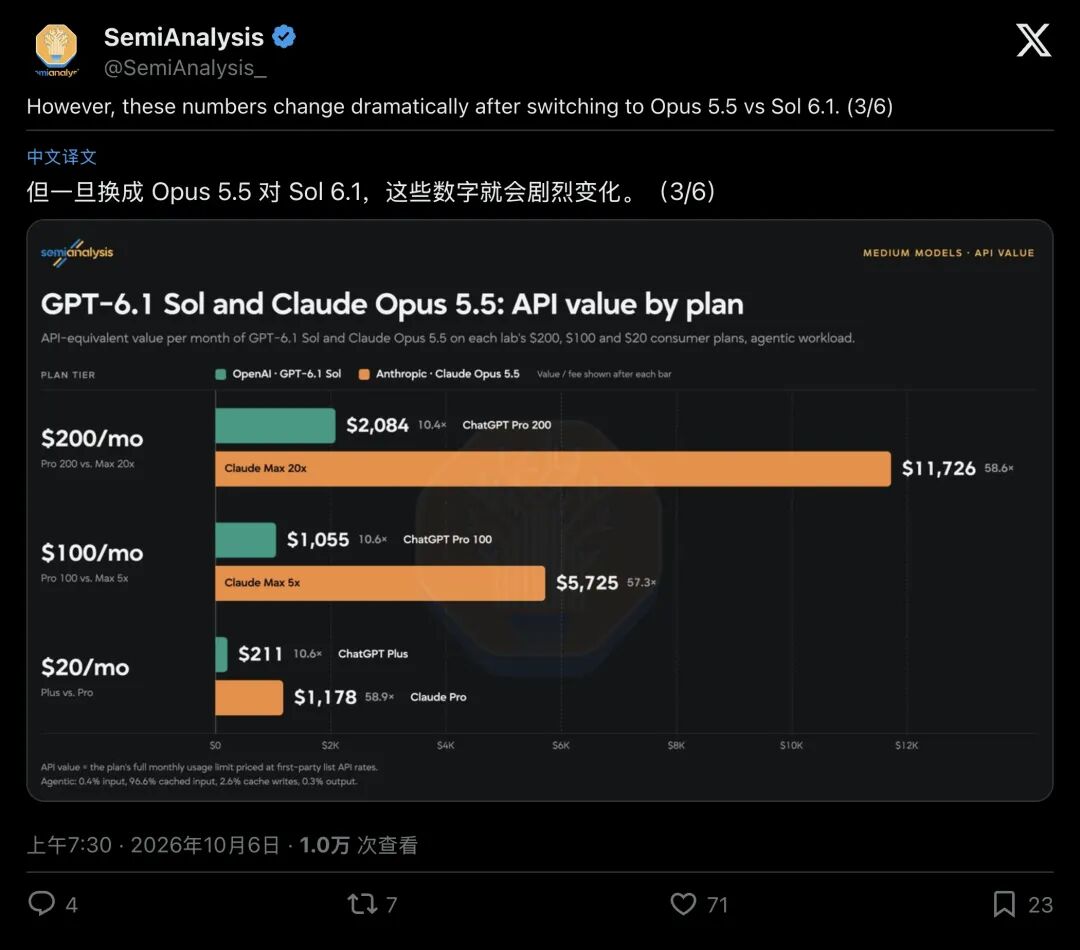
▲ 200 美元套餐在中端主力模型下的悬殊差距:Claude Opus 5.5 相比 OpenAI Sol 展现出约 5.6 倍的账面优势
整整 5.6 倍的鸿沟!
消息一出,技术社区一片哗然人们纷纷调侃 OpenAI 的小家子气,甚至开始准备收拾行李,集体转向 Claude 的阵营。
然而,事情真的有这么简单吗?
02拿《战争与和平》测黑盒:神仙数据是怎么来的?
要看懂这场数字游戏,我们得先知道 SemiAnalysis 的数据到底是怎么测出来的。
大模型的订阅界面,向来是个极度不透明的“黑盒”。
厂商通常不会在前端明示“还剩多少 Token”,只在界面提供一根从 0% 走到 100% 的进度条。许多时候,用户连续提问好几次,进度条纹丝不动;偶而敲一段代码,进度条却突然跳了一大格。
为了撕开这层伪装,SemiAnalysis 的研究人员用上了堪称“数字黑客”的硬核手段。
他们发现,如果你给 AI 喂毫无意义的乱码,现在的安全对齐机制会直接拒答(Refusal)。于是,研究员们搬出了列夫·托尔斯泰的皇皇巨著,《战争与和平》。
他们把这本文学名著切成长篇片段塞进输入端,既保证了物理上下文被巨量填满,又完美绕过了模型的安全过滤机制。
接着,他们利用“连续台阶累积法”,耐心地记录用量条从一个整数刻度跳到下一个刻度之间的完整账单 Token,把边缘误差强行收敛到了 ±5% 以内。
在这场极限施压测试中,他们甚至抓到了各大平台的“暗箱操作”:
他们拿了 3 个配置完全相同的账号同时跑测试,结果发现其中 1 个老账号的额度居然暗中低了整整 20%; 抓到现行后官方才承认:这是他们针对部分批次用户偷偷进行的“配额平衡 A/B 测试”。
各大平台随时握着静默修改配额的闸门,这已经是公开的秘密。
但更关键的秘密在于:那个折合 12,529 美元 的惊天数字,是在极度苛刻的“极端工况”下才成立的。
它要求你跑的是 Agentic(自主代理)负载,也就是让 AI 扮演全天候自动编程助手,在代码库里疯狂读写。在研究员设定的模型中,高达 96.6% 的用量都是命中缓存的读取(Prompt Cache Read)。
如果你只是一个普通的文字工作者,平时只是拿它写写邮件、改改公文,这个所谓的“1.2 万美元超值大礼包”,你可能一辈子也摸不到门槛。
03悖论一:旗舰打平!为什么 Anthropic 只在二线模型上大方?
如果我们不看中端模型,直接看两家最顶级的王牌旗舰呢?
反转立刻发生了
当测试换成双方的最高智商代表,Anthropic 的 Claude Fable 5.1 对决 OpenAI 的 GPT-6 Astra 时,那道耀眼的“5.6 倍神话”,在瞬间崩塌得无影无踪。
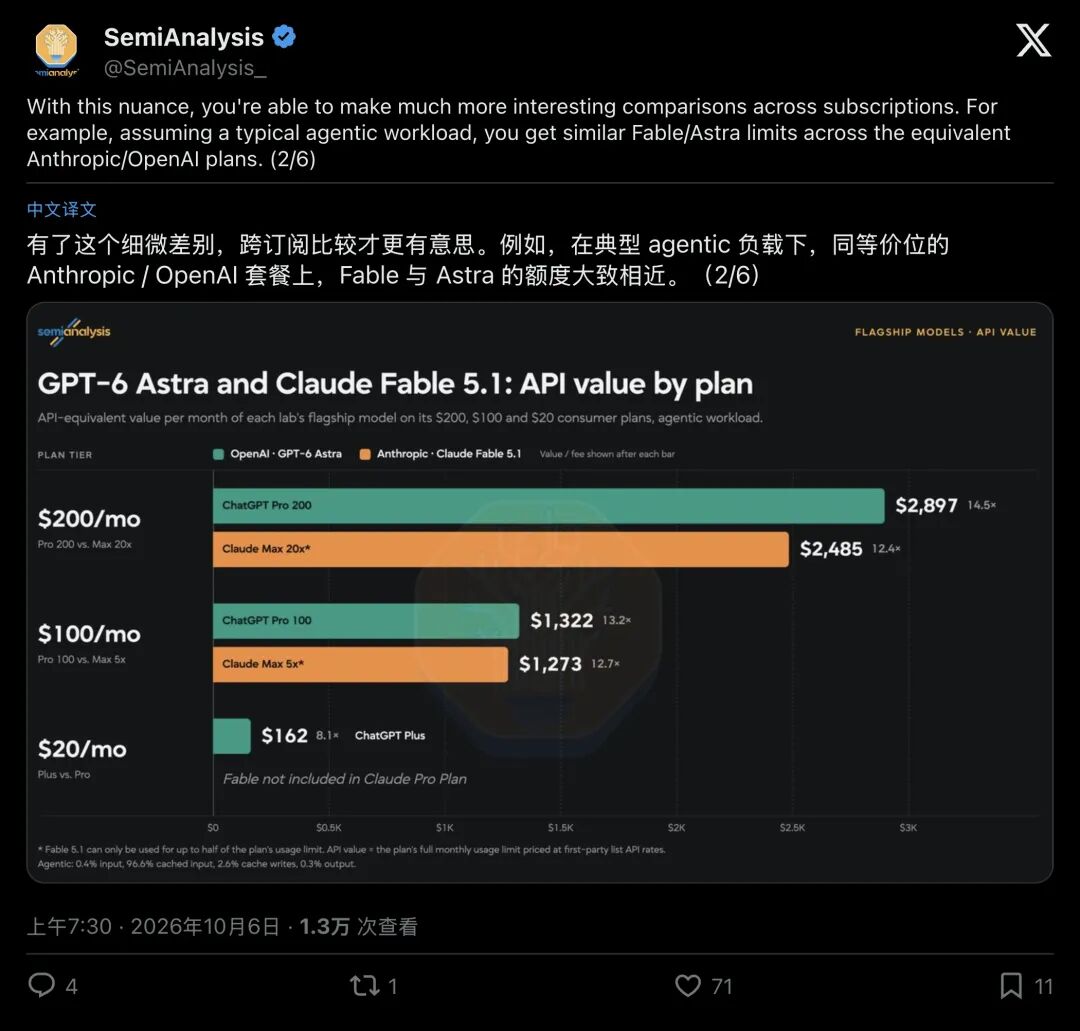
▲ 当切换到最高等级的旗舰模型时,两家 200 美元套餐给出的等价价值几乎完全拉平在 2500 至 2800 美元区间
在 200 美元套餐下:
OpenAI 的旗舰 Astra 能跑出 2,897 美元 的 API 价值; Anthropic 的旗舰 Fable 5.1,算力价值只有 2,485 美元。
不仅数字极为接近,Anthropic 甚至还悄悄藏了一道极其隐蔽的铁门:Fable 的额度被锁死在整个套餐的 50% 上限上。
也就是说,即便你把 Fable 的额度彻底打满,你最多也只能用掉套餐的一半能力,剩下的额度你必须换去跑别的轻量模型,否则就是白白浪费。
你看,这就是巨头精心设计的商业迷宫:
- 在最昂贵、推理成本最恐怖的王牌模型上,两家其实一样抠门,算盘打得噼啪响;
- 所谓的“超值 5 倍”,全靠二线中端模型在大水漫灌。
这就好比一家自助餐厅打着“价值一万元海鲜任吃”的招牌,等你走进去才发现:顶级黑松露和帝王蟹限人限次,只有二楼的三文鱼炒饭在无限量供应。
04悖论二:“纸币陷阱”与越蠢越超值的黑色幽默
在热搜评论区里,无数开发者一针见血地指出了这场“价值换算”中最大的逻辑漏洞。
网名为 @JesusIsGod 的用户留下一句高赞神评:“这只能证明一件事:Claude 的官方 API 定价实在太虚高了,哈哈!”
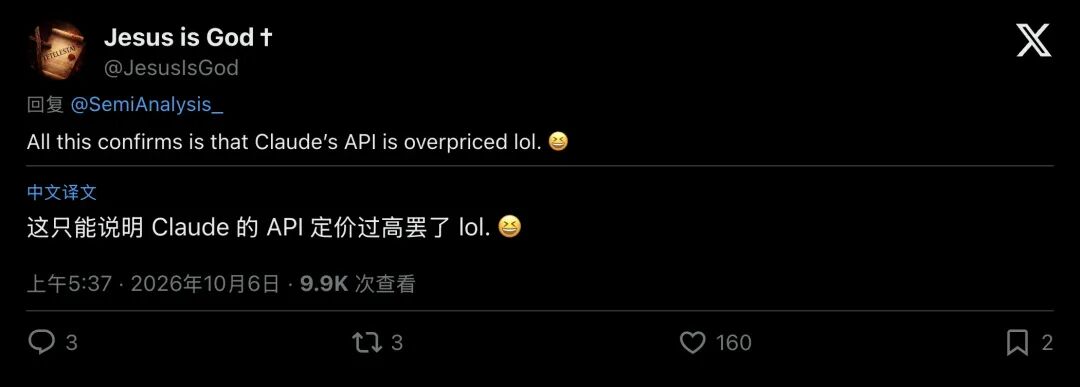
▲ 评论区直击本质:如果 API 标价原本就虚高,折算出来的“超值美元”就是空中楼阁
这就是所谓“API 等价价值”标尺的荒诞之处:尺子本身,就是厂商自己印刷的纸币。
API 标价从来谈不上客观物理常数,往往由各大实验室单方面拟定为“官方指导价”。
只要一家厂商把自家的 API 标价随意调高一倍,哪怕订阅里的实际可用 Token 毫无增加,套餐在纸面上也会显得“价值翻倍”。拿厂商自己定的标价来证明厂商送了多少福利,本质上就像一场循环自证。
更可怕的黑色幽默,来自于独立评测机构 Artificial Analysis 提出的“Token 效率悖论”。
在真实的软件工程排错(SWE-bench)测试中,不同大模型的表现天差地别:
- 模型 A(聪明干练)
:逻辑缜密,一眼看穿 bug,输出一段精炼的代码,只用了 6 万个 Token 就完美搞定任务; - 模型 B(废话连篇)
:思维链疯狂打转,反复报错,疯狂撞墙重试,洋洋洒洒吐了 50 万个 Token,才勉强通过测试。
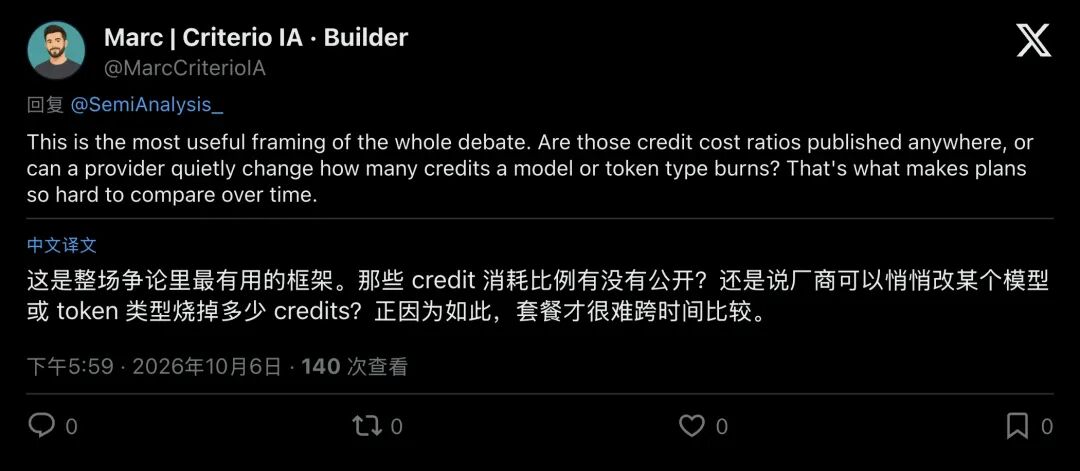
▲ 社区开始意识到:比起账面上的 Token 数量,底层的扣费规则与完成质量才是核心
如果按照纯 Token 标价来算账:模型 B 因为消耗了海量算力,在账面上折算出了极其庞大的“等价美元”;而格外高效的模型 A,账面折算金额反而显得少得可怜。
一个模型越笨、越话痨、越爱走弯路,它在统计表里反而显得“越超值”!
这堪称 AI 工业界最讽刺的景象:你付了 200 美元,买到的到底是一头能帮你迅速解决问题的千里马,还是一台疯狂空转、除了刷账单别无所长的耗电机器?
05算力围城:大模型补贴时代的倒计时
拨开喧嚣,这场风暴的核心始终聚焦于成本核算。
商业机构终究要考虑利润SemiAnalysis 在付费报告里披露了一组引人注目的财务数据:
对 Anthropic 而言,订阅会员带来的收入,仅仅占到公司整体盘子的 10% 左右;但为了喂饱这群狂热的会员,他们竟然砸进去了整整 40% 以上的推理算力!
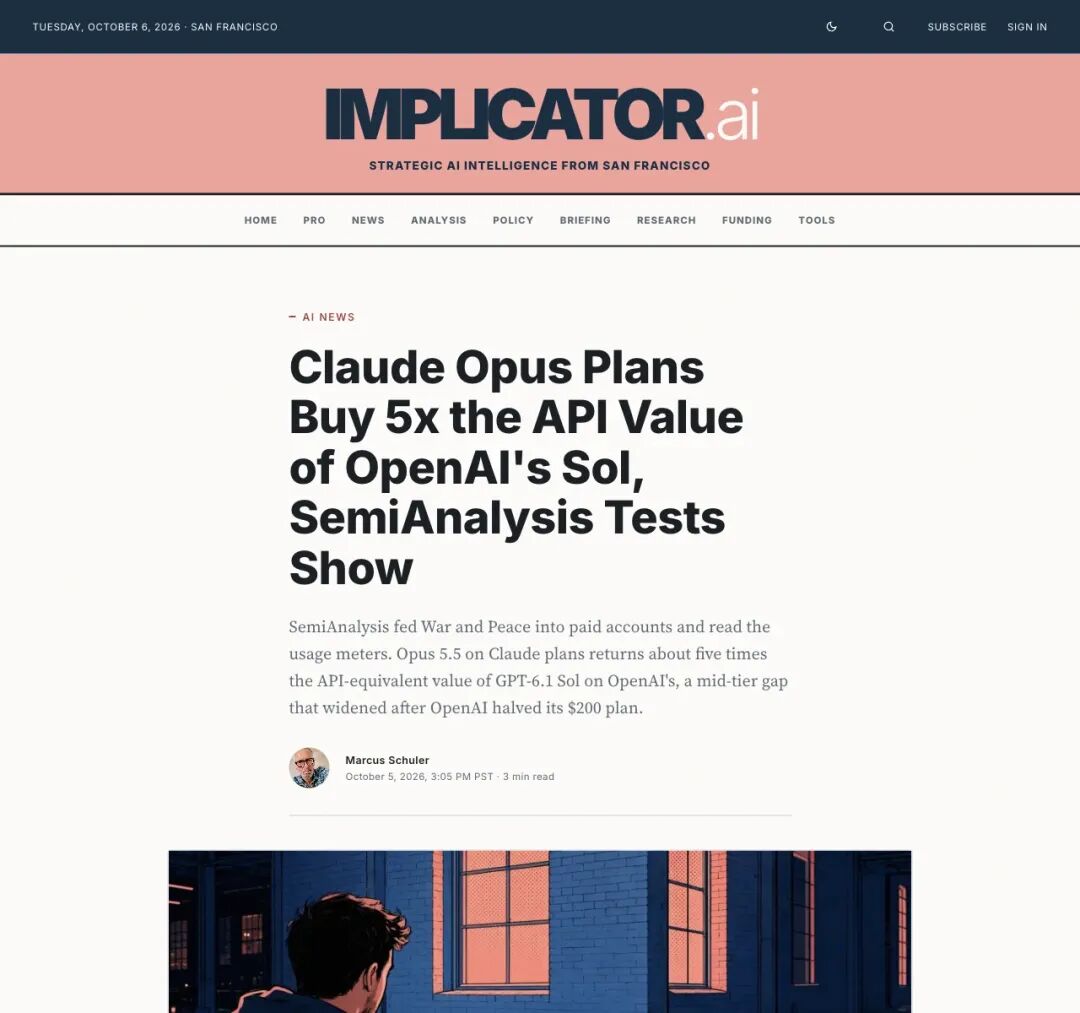
▲ 行业媒体深刻指出:大模型订阅的虚高价值背后,是各大实验室不可持续的算力流血
如果每一个购买了 200 美元套餐的用户,都像 SemiAnalysis 的自动化探针那样整天挂着编程代理、把周额度彻底吃干抹净,Anthropic 这一单的毛利率是深度负几十甚至上百的血亏状态。
他们之所以现在还敢咬牙撑着,赌的就是绝大多数普通用户并不会天天高强度榨取算力(平均利用率通常只有 20% 甚至更低)。他们在用轻度用户的月费,交叉补贴那群核心极客。
但 OpenAI 已经撑不住了
拥有庞大用户基数的 OpenAI,早已过了靠流血倾销来圈地的初级阶段。当数以百万计的开发者真把 ChatGPT 和 Codex 当成全天候打工人使用时,算力黑洞足以吞噬任何虚妄的估值。
Tibo 顶着全网骂名把额度腰斩,看似是商业信誉的滑铁卢,实则是撕下温情面纱后、极其理性的止血求生。新推出的 500 美元更高档位,更是赤裸裸地告诉市场:想要无限畅饮的生产力,得加钱。
这场由 200 美元套餐引发的行业地震,正在加速埋葬那个靠“数 Token 薅羊毛”的原始蛮荒时代。
整个评测界正在全面转向一个新的维度,单任务完成成本(Cost per Task)。
未来的核心竞争点,在于谁能用更少、更精炼的推理步骤,干脆利落地攻克真实的工程难题。
对于坐在屏幕前的开发者而言,面对各家眼花缭乱的“等价上万美元”宣传,更需要看清一个朴素道理:
当所有人都在宣称某样工具便宜了数倍时,最值得警惕的,恰恰是那些在不知不觉中被套牢的时间与注意力。