ARTICLE · 1145654
AI 助手一关就失忆,claude-mem 补上记忆
AI 助手一关就失忆,claude-mem 补上记忆
跟 AI 助手说清楚一个项目的规矩,要花掉你半小时:代码放在哪、命名习惯是什么、哪几个文件不许碰。第二天早上新开一个会话,它一脸茫然,还得从头再讲一遍。
这不怪模型。它的记忆只在当前会话里活着,窗口一关,上下文清零,连“你昨天来过”都不剩。
claude-mem 就是冲着这段空白来的。它跟着你干活,把过程记下来,等你下次开会话,再把用得上的那部分塞回去。到 10 月 8 日,它在 GitHub 上已经有 9.8 万颗星。
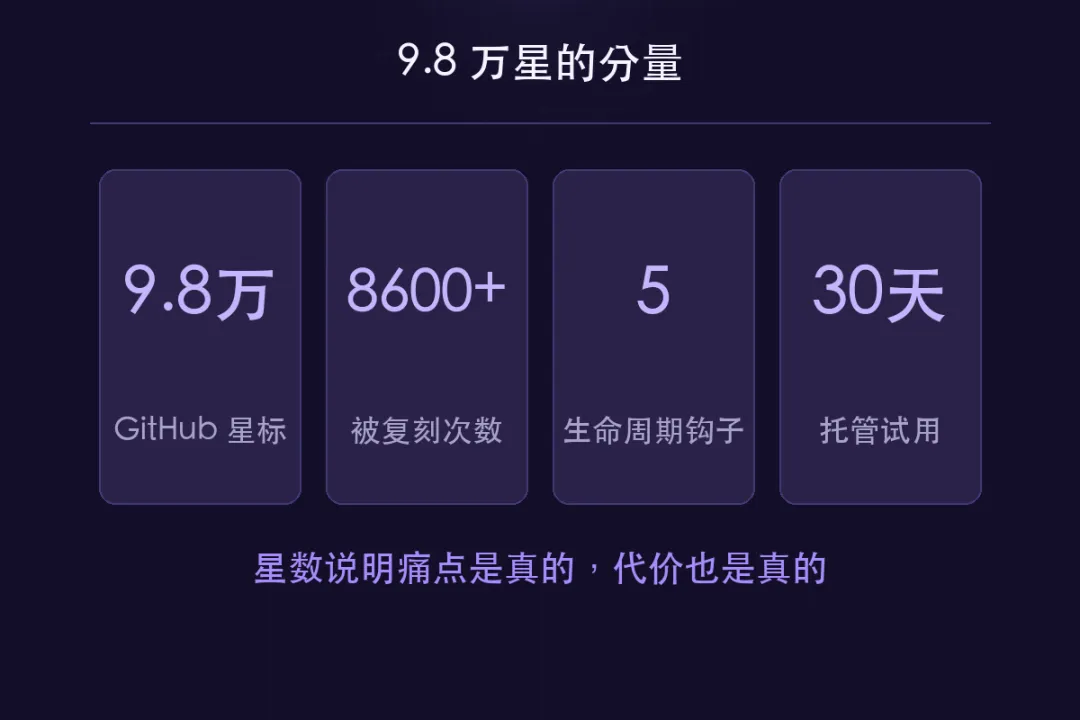 claude-mem 的规模:9.8 万星标、8600+ 复刻、5 个生命周期钩子、30 天托管试用
记忆是怎么被接上的
做法不复杂,但每一步都有取舍。
它挂在助手的工作流程上,用五个钩子抓取:会话开始、你提交问题、工具调用结束、助手停下、会话结束。抓下来的东西经过筛拣,留下的是“观察”:调了什么工具、读了哪个文件、得出什么结论。
钩子方案比事后翻日志聪明一点。日志是流水账,从头读到尾也未必知道哪句是结论;观察被筛过一遍,只剩动作和结果,压缩起来省事,日后捞起来也准。
观察先被另一个模型压成语义摘要,再存进本地数据库,向量检索交给 Chroma。等到下次开会话,它按需把相关片段注入上下文,不做成把历史一股脑倒进去。
按需这两个字是关键。项目管它叫渐进式披露:先给结论,需要细节时再逐层展开,顺便把每一层花掉的词元成本也摆给你看。
检索这一层也不只认关键词。Chroma 跑的是语义加关键词的混合搜索,你用自己的话问“上次那个改到一半的配置挪到哪去了”,它照样能捞回来。
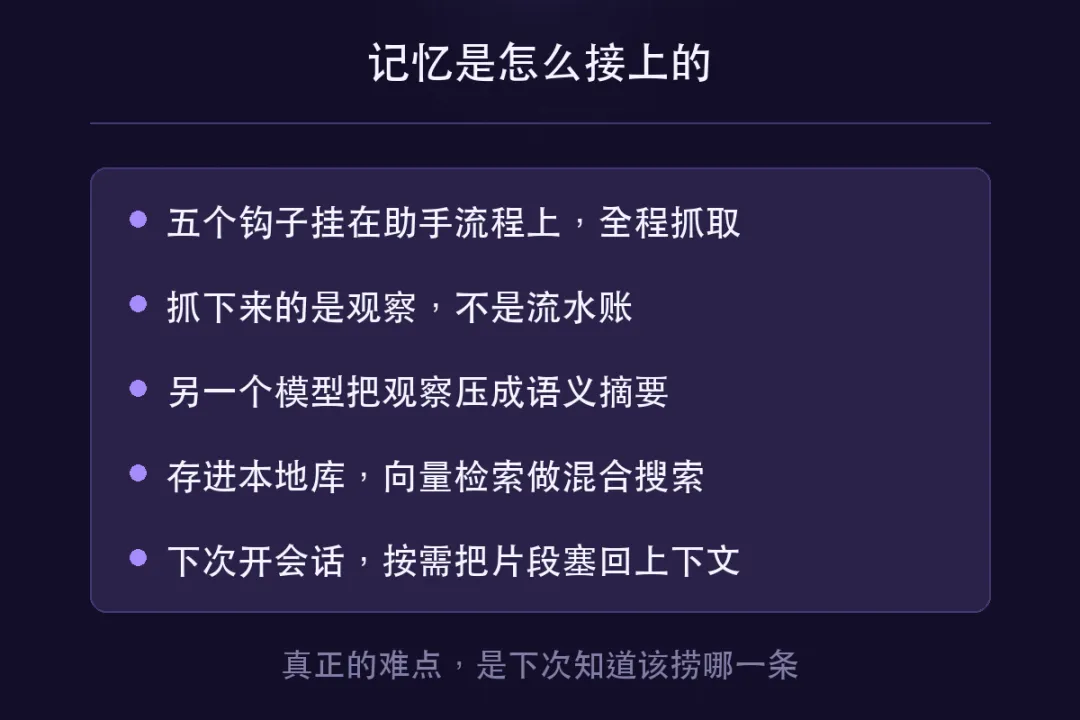 记忆是怎么接上的:钩子抓取观察,模型压成摘要,本地库存+向量检索,下次按需注入
星数之外的三层代价
9.8 万颗星说明“AI 失忆”确实扎到了很多人,可星数不等于没有坑。装它只要一行命令,Claude Code、Codex、Gemini、Copilot、OpenCode 这几类助手都能接,接得越多,记忆复用得越广,这大概也是它涨星快的原因之一。
第一层是钱。压缩记忆那一步得单独跑一遍模型,这次调用不算在订阅额度里。项目把这套能力打包成托管记忆,送 30 天试用,试用结束就回落到你自己的 Anthropic 计划,或者你自己填 OpenRouter、Gemini 的密钥。
第二层是隐私。它默认记录助手干过的每件事,包括读过的文件内容。想排除敏感文本,得自己动手在内容上套一层 private 标记。
第三层是多了一个常驻进程。本地要一直跑一个后台服务,顺带提供网页查看器,让你能实时看到记忆流。东西不多,但已经不是装完就忘的那类插件。
真正难的不是记住
说实话,“给 AI 装记忆”这件事被高估了。存下来不难,谁都能把对话记录扔进一个数据库,需要的时候再捞出来。
难的是下一次知道该捞哪一条。捞多了,上下文被无关内容撑满,词元烧得飞快,模型还容易被带偏;捞少了,等于没记。claude-mem 把赌注押在分层上:先给摘要,再按需展开,用检索的精度换上下文的空间。
它赌的是,记忆的价值取决于什么时候想起来。同一套逻辑放到人身上也成立:笔记记了几百条,从没回看过,那和没记区别不大。
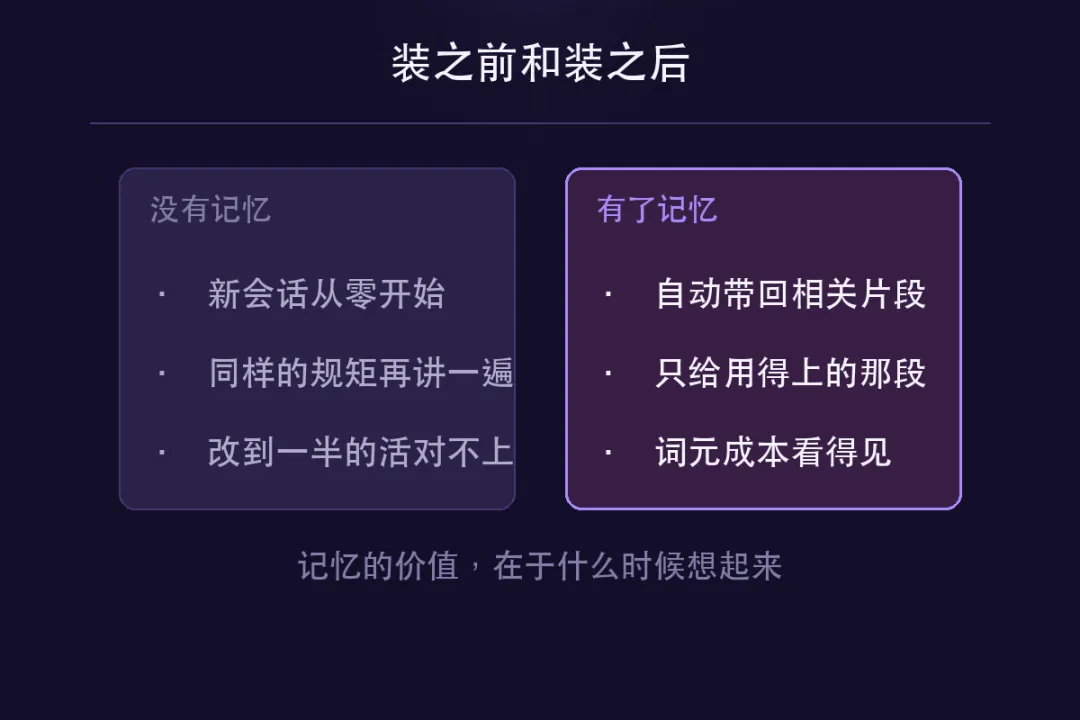 装之前和装之后:从每次重讲、活在会话里,到自动带回相关片段
说两句
这类工具还暴露了另一件事:记忆正在从模型的内置能力,变成一件外挂的服务。厂商自己在做,社区也在做,而且做得越认真,越说明现在的模型原生就记不住。
claude-mem 能不能一直火下去不好说。但它至少把问题问对了:真正好用的助手,得知道该忘什么。
AI 最像人的地方,是它也会忘事。
你的 AI 助手,让你重复讲过多少次同样的话?