ARTICLE · 1150281
AI 原生软件研发手册:从需求到上线,重做整个交付流程 - 来自Anthropic
用 AI 改造软件开发生命周期,从每一个阶段开始。
原文作者:Louis Claxton原文发布:2026 年 8 月 21 日原文:The AI-native SDLC playbook
目录 / TREE
└ 1 写代码已经不再是瓶颈 └ 2 如何使用这份手册 └ 3 第一阶段:规划 └ 4 第二阶段:设计 └ 5 第三阶段:开发 └ 6 第四阶段:测试 └ 7 第五阶段:部署 └ 8 第六阶段:维护 └ 9 结语
1 写代码已经不再是瓶颈
企业已经开始用 AI 以一年前难以想象的速度编写代码,但围绕代码的流程没有跟上。
许多工程团队仍然沿用原来的审批关卡、评审、交接和制度,Claude Code 等编程 Agent 带来的效率提升因此停在了交付流程里。
软件开发生命周期(SDLC),就是把软件从想法带到生产环境的过程。大多数组织都经历六个阶段:规划、设计、开发、测试、部署和维护。传统做法把它们划成不同角色负责的独立阶段。
产品经理写需求,架构师将需求转成设计,工程师实现设计,受监管企业的 QA 团队验证结果,发布团队上线,运维团队监控运行。工作通过文档、工单和签字,在这些阶段之间流转。
传统 SDLC 用较重的流程保证每一步可控、责任明确。它针对的是一个写代码和实现功能最费时、最昂贵的年代。需求文档、估算会议、产品安全评审,都在帮助团队对齐可能持续数周、数月甚至数个季度的开发工作。
这些控制措施还默认每一步都由人来执行。已经获得较大收益的组织,开始根据 Agent 能做的事重建流程,同时保留人的参与。这份手册结合客户实践,介绍我们的 Applied AI 团队在内部使用 Claude、改造各个研发阶段的一些做法。
当开发阶段的速度超过传统流程能承受的速度,会出现三个变化:
- 瓶颈转移到开发前后:规划、评审与测试、部署仍然按人的速度运行。
- 控制方式与实际工作不再匹配:人写代码时逐行审查是合理的;Agent 写出大部分 diff 后,逐行人工检查很难跟上。
- 治理成本上升:例外事项仍需提交给每周或每月才开会的委员会处理。
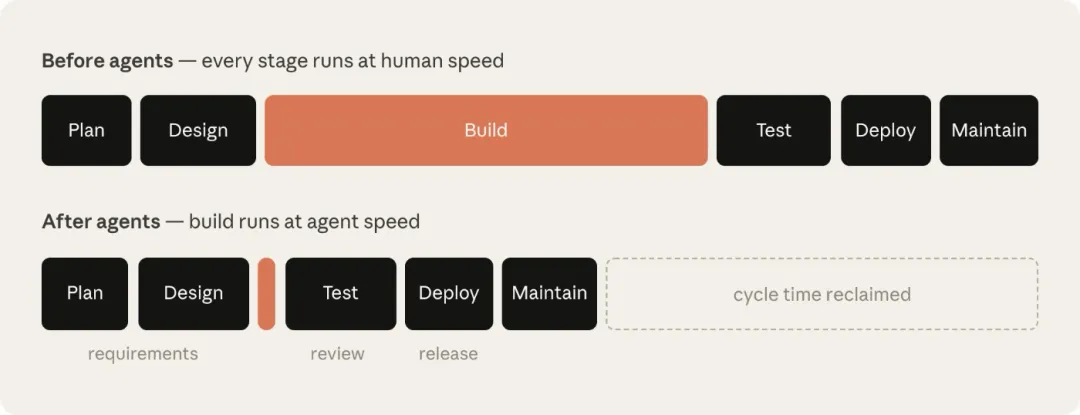
开发环节缩短后,规划、评审、测试和部署仍按人的速度推进,成为交付瓶颈。
以安全评审为例。安全团队的规模通常按人工开发的产出配置。Agent 大幅增加代码产出后,评审队列会变长,或者代码没有经过充分评审就上线。受监管组织无法接受任何一种结果,安全与政策检查也必须跟上 Agent 的速度。
要让编程 Agent 带来的效率提升真正体现在交付中,整个 SDLC 都需要进行与开发环节同样程度的改造。
1.1 什么是 AI 原生 SDLC
AI 原生 SDLC 保留原来的控制目标,但重新设计执行方式。流程变成循环,AI 参与各个环节,阶段间的交接和下一步触发逐步自动化。
它也被称为 Agent 驱动的 SDLC、AI SDLC 或 Agent 驱动的软件开发,指向的是同一种变化。
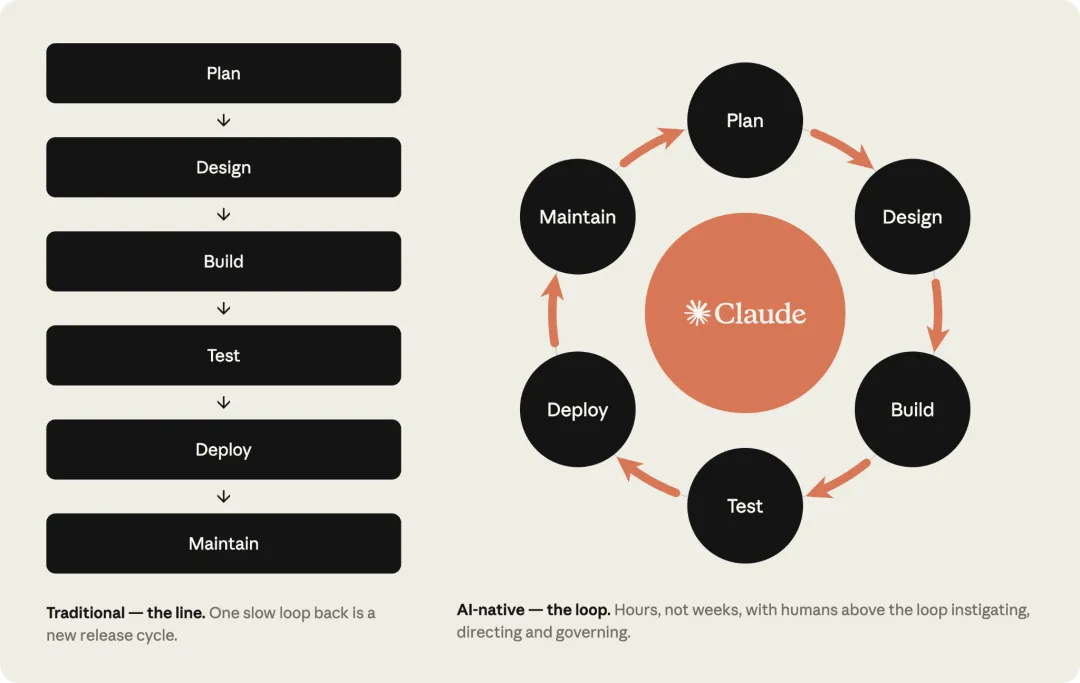
AI 原生 SDLC:规划、设计、开发、测试、部署和维护构成循环,各阶段通过可读取的产物交接。
1.2 六个阶段怎样变化
下面对照的是传统流程与 AI 原生流程的两端。大多数组织处于两者之间。
规划
传统 SDLC:委员会收集需求,经研讨和审批后人工整理
AI 原生 SDLC:Claude 直接从信息源归纳痛点,写入人和机器都能理解的 intent.md
设计
传统 SDLC:分析师写规格,设计师再解读
AI 原生 SDLC:与 Agent 在一次工作会话中完成需求和设计,以版本化 skills 执行标准
开发
传统 SDLC:人工写测试和代码,主要开发结束后再补文档
AI 原生 SDLC:AI 生成代码和测试,团队知识写入版本化的 CLAUDE.md 与 skills
测试
传统 SDLC:在阶段边界设置 QA 关卡
AI 原生 SDLC:持续评测贯穿实现过程
部署
传统 SDLC:人工逐行审查,治理依赖周期性评审且执行不一致
AI 原生 SDLC:Agent 分层评审,人重点审查受监管和关键代码,hooks 在执行时落实审批关卡
维护
传统 SDLC:人在生产环境中发现问题
AI 原生 SDLC:Agent 监控运行,指标越过控制界限后诊断,写回新的 intent.md
贯穿右侧各阶段的,是提交到版本控制的产物。每一阶段结束时写入一个产物,下一阶段开始时读取它:intent.md、spec.md、plan.md、代码 diff 和测试、附带评审结论的 PR,以及事件记录。
前期主要使用 Markdown,因为产品负责人和 Agent 可以共同读取、处理同一份文件。从开发阶段开始,产物逐渐变成代码和相关记录。
这条提交链同时构成审计轨迹:谁提出了什么,Agent 产出了什么,谁批准了它。凡是需要判断的决定,人仍然承担责任;只是需要关注和审阅的产物随流程发生了变化。
2 如何使用这份手册
手册中的具体做法分布在六个阶段。它们并非只能按线性顺序采用。
每项做法都说明:什么会改变、如何起步、具体执行步骤、治理要求,以及怎样衡量效果。
这些做法是模块化的。组织可以根据需要先改某些阶段,每项做法都在“前置条件”中列出依赖。下面的依赖图进一步说明了采用顺序。
一个阶段结束时提交产物,提交又触发下一阶段:接受 intent.md 后开始需求和设计;批准 spec.md 后进入计划模式;PR 合并后触发流水线;生产指标越过控制界限后写出下一份 intent.md,循环继续。
起步时,可以由人逐项发起。最终,每个被接受的产物都会触发下一道关卡。人的注意力集中在关卡处,审查 Agent 标出的内容,而不必从头启动每一步。
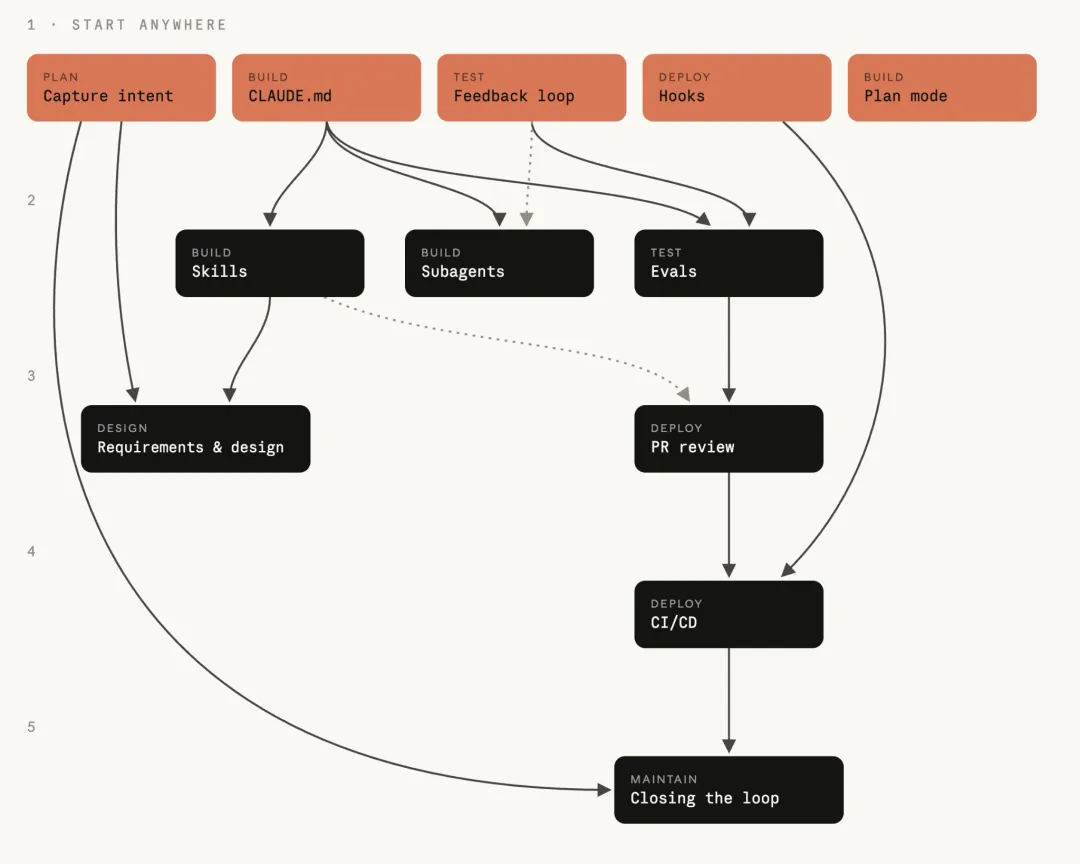
做法的采用依赖图:箭头表示先采用哪些做法。陶土色节点没有前置依赖,可以作为起点。
图中的阶段归属与采用顺序是两件事。陶土色节点没有箭头指向它,可以直接开始;其他节点则需要先完成指向它的做法。
3 第一阶段:规划
想法不再等着别人整理。提出者用自己的语言把意图记录一次,形成下一阶段可以处理的版本化产物。
3.1 把想法写成 intent.md
启动研发流程的 intent.md 可以来自不同入口:一个人的想法、一张工单,或者告警发现的事件。维护阶段会介绍事件入口。
有想法的人可以先与 Claude 讨论,生成一份 Markdown 初步规格。传统流程里,这个人还要说服产品团队成员,与自己一起或者代自己把想法整理成文档。
Claude 生成的初步规格既适合人阅读,也可直接交给下一阶段,保存为 intent.md。无论意图来自事件触发还是 Agent,产品负责人都要在提交前检查并修正 Agent 写出的内容。
传统做法:想法先经过 backlog、用户故事、故事点和需求细化会议。每次交接都会转移所有权,工程团队最终看到的内容已经与提出者最初的意思隔了几层。
AI 原生做法:提出者与 Claude 讨论,用自己的语言写下希望实现什么、为什么要做、有什么约束。重复流程通过 skills 固化。
前置条件:无。
基础设施:非工程人员也能使用 Claude,例如 claude.ai 或 Cowork;统一的 intent.md 模板;产品负责人会持续关注的共享版本化存储位置。
单一产品最简单的方式是在产品仓库中建立 intent/ 目录,让产物链与派生代码相邻。只有意图横跨多个仓库时,才值得承担独立 intent 仓库的维护成本;在 monorepo 中,它就是一个目录。
如果 Jira 或需求工具已经保存正式记录,开发阶段的补充说明会介绍如何与这些系统衔接。
工程或平台团队只需搭建一次存储位置并决定写入权限,因为很多贡献者来自组织内不同团队。不会 git 的人不必直接操作 git,可以通过 GitHub 等版本控制连接器,让 Claude 在 claude.ai 或 Cowork 中代为提交 Markdown。
执行步骤
提出者用自己的话描述问题:今天做不到什么,谁受到影响,希望改善到什么程度,哪些内容不在范围内。不要求正式措辞。 继续讨论,直到想法具体。Claude 会追问分析师通常追问的内容:范围、用户、约束和成功标准。 让 Claude 按组织模板写成 intent.md。技术人员可以把模板做成 skill,由负责人确认,覆盖问题、预期结果、受影响用户与系统、约束和未决问题。提出者修正 Claude 理解错的地方。 把 intent.md提交到共享位置。作者和时间戳进入记录,产品负责人从这里继续处理。
示例:intent.md
# 意图:理赔状态自助查询作者:J. Ortiz(理赔运营)。状态:草稿。## 问题客户打电话给客服中心,询问理赔进度。处理人员约三分之一的通话时间用于纯状态查询。## 预期结果客户在门户里查看理赔状态、下一步和预计日期。## 受影响用户与系统理赔处理人员、门户团队、claims-core API。## 约束门户会话中不增加新的个人身份信息(PII)。仅使用现有认证方式。## 未决问题第三方理赔评估人员是否也需要访问?治理要求
提交后的 intent.md 是证据,包含作者、时间戳和完整修订历史,记录在该存储位置的 git 历史里。产品负责人批准或拒绝,决定是否进入设计阶段。接受决定体现为合并,拒绝决定体现为关闭评审。
如何衡量效果
- 先行指标:
从首次讨论到提交 intent.md的时间,依据 git 历史中的作者和时间戳。目标是从数周的需求收集与细化周期,缩短到数小时。 - 滞后指标:
产品负责人接受并推进到设计阶段的 intent.md占比;同一变更首次提交spec.md后,intent.md又被修改了多少次。
4 第二阶段:设计
需求与设计合并到一次会话中。规格编写时就应用政策,不再等几周后的评审才发现冲突。
4.1 需求与设计
产品负责人接受 intent.md 后,Claude 将它转成需求与设计规格,受组织的品牌、安全、合规和 UX skills 约束。
产品负责人负责审查规格,不必亲自撰写。目标是得到工程团队可以据此制定计划、且已标出疑点的规格。
前端是一个直观例子:产品负责人可以在 Claude Design(beta)里根据 intent.md 生成界面原型,反复调整,再导出给 Claude Code 实现。
传统做法:分析师将想法正式写成需求,设计师再把需求转成设计。分工方便问责,但耗时,也容易丢失原意。
AI 原生做法:在一次会话里完成两个阶段。Claude 根据 intent.md 和组织的 skills 生成规格,标出需要关注的地方。
前置条件:已有 intent.md,品牌、安全、合规和 UX 政策已写成 skills。
基础设施:产品负责人能够使用 Claude,不要求具备工程技能。
执行步骤
产品负责人启动会话,确保组织的 skills 可用,并附上 intent.md。提示词引用意图文件,明确约束,要求标出疑点。起初手动执行,随后固化为组织级 slash command;再把意图仓库中 intent.md被接受作为触发条件:合并后启动非交互任务,加载组织 skills,生成spec.md并提交 PR。部署阶段的 CI/CD 做法会介绍如何连接这些环节。此后,产品负责人的首次介入就是评审。同一位产品负责人核对规格是否解决最初的问题,意图文件中的未决问题是否已经回答或明确延续。 优先处理被标出的疑点。这些通常是分析师会升级处理的问题,产品负责人要在规格交给工程团队前,与相应政策负责人解决。 将 spec.md与intent.md一起提交,记录最初提出了什么、后来决定了什么。产品负责人决定是否进入开发。组织认定为较高风险的事项,要咨询技术负责人。这个决定始终由人作出;规格被接受后,才启动开发阶段的计划模式。
示例:提示词
阅读附上的 intent.md,为接入现有代码库生成需求与设计规格。应用当前可用的 skills,符合品牌规范、安全政策和 UX 标准。将完整规格写入 spec.md,达到可以交给工程团队的程度。清楚说明所有疑点,尤其是无法同时满足的冲突政策。治理要求
有效政策在写规格时就被读取和应用。规格、生成规格的提示词、当时使用的 skill 版本都进入版本控制。产品负责人签字确认,并将疑点交给具名的政策负责人。
如何衡量效果
- 先行指标:
同一变更从提交 intent.md到提交spec.md的时间,与旧的“需求加设计”周期比较。 - 滞后指标:
开发开始后的需求返工。统计同一变更首次提交 plan.md之后的spec.md提交次数,git log 可以直接给出。
5 第三阶段:开发
没有接受过的计划,就不开始实现。团队知识变成 Agent 可读取的文件,护栏通过代码执行。
5.1 默认从计划模式开始
工程师先让 Claude Code 进入计划模式,提供设计阶段批准的 spec.md,让 Claude 追问细节并反复调整,直到计划达到要求。
传统做法:工程师读完设计就写代码。哪些文件要改、如何实现、怎样测试,留在脑子里或工单评论中,别人无法预先审查。评审者第一次看到的是已经完成的 diff,此时返工成本较高。
AI 原生做法:先形成书面计划。Claude 在计划模式下可以读取代码库,但不修改它。工程师在生成代码前修正计划,批准后的版本以 plan.md 提交,供后续阶段核查。
前置条件:如果已有 intent.md 或 spec.md,就提供这些文件;CLAUDE.md 也能帮助规划。
基础设施:Claude Code 能访问代码仓库。
执行步骤
以计划模式启动会话。 提供 intent.md和spec.md,要求计划列出要改的文件、工作顺序,以及证明结果正确的测试。追问变更可能破坏什么,哪一步风险最高,Claude 放弃了哪些其他方案。 调整到一位没有参与讨论的工程师,仅凭计划就能实现变更。 将批准后的计划提交为 plan.md,加入审计轨迹。部署阶段的 PR 评审会对照计划检查最终 diff。接受计划,开始实现。计划扎实,实现往往能一轮完成。 如果实现偏离计划,在同一个 commit 中更新 plan.md。可以用 hook 强制两者同步。
示例:plan.md
# 计划:理赔状态自助查询来源:intent.md,2026-06-02## 修改文件portal/src/claims/StatusPanel.tsx(新建)claims-api/routes/status.pyclaims-api/tests/test_status.py## 工作顺序1. 在现有认证后添加状态接口。2. 实现调用该接口的面板。3. 接入门户导航。## 风险claims-core API 限流为每秒 50 次请求;面板需要缓存。## 验证测试覆盖四种理赔状态;截图与批准的原型一致。治理要求
设计评审发生在代码生成之前,此时调整方向只需改文档。计划模式本身落实了这一点:工程师接受计划前,Claude 不能编辑文件。计划、修订和接受者都进入记录。普通变更由工程师批准,较高风险变更交给技术负责人或架构师。
如何衡量效果
- 先行指标:第一轮实现就能合并的变更占比;从计划批准到 PR 合并的时间,使用 PR 元数据。
- 滞后指标:
每项变更的返工轮次,以及合并后的 diff 与已提交 plan.md保持一致的比例。
5.2 使用自动模式
Claude Code 也可以在自动模式中运行。工程师批准计划后,Claude 不再对每次编辑逐项询问。
随着护栏成熟,包括完善的 CLAUDE.md、编码政策的 skills、阻止不安全动作的 hooks,以及可执行测试,常规工作可以默认自动接受。适用条件是规格明确、影响范围较小,且已有测试覆盖相关代码。
工程师的工作随之从盯着每次编辑、逐项审查动作,转向审阅较长自主会话结束后的产物。配合 worktree,自动接受也支持个人和团队的并行执行,是维护阶段闭环自主运行的基础。
5.3 补充说明:旧系统与权威记录
这项说明适用于流程产出的每一种产物。
现有组织通常已经在跟踪这些记录,只是没有使用 Markdown:工作项在 Jira,需求在具备监管追踪能力的工具里,设计在 Figma,变更批准在变更委员会。这些系统已被审计和监管接受,其他团队也依赖它们,AI 原生 SDLC 需要与它们衔接。
每种产物都应明确一个权威记录系统,其他位置保存副本或链接。可以按产物类型选择不同配置:
- 仓库是权威记录:Markdown 文件是正式记录,旧系统引用 commit 中的文件。适合工程驱动的组织,记录集中在一个工具和一套时间戳体系中。
- 旧系统是权威记录:Jira、ServiceNow 或需求工具保存正式记录,Markdown 是工作副本。Claude 在会话开始时读取记录,并在生成规格或计划的同一会话里,通过 MCP 连接器写回结果。
- 至少建立双向关联:产物记录旧系统的记录 ID,旧系统记录 Markdown 的 commit SHA。迁移初期可以这样开始,同时承认此时存在两套记录来源。
两个体系可以共存,前提是明确权威记录,或至少保留两者之间的关联。
5.4 维护 CLAUDE.md
CLAUDE.md 提供新成员第一天需要知道的上下文:约定、命令、架构,以及团队最常遇到的错误。过去散落在人脑和 wiki 中的知识,变成 Agent 每次会话开始时都会读取的文件,由整个团队维护,出现错误时持续修订。
前置条件:无。
基础设施:一个仓库、已安装 Claude Code,以及一位熟悉代码库的工程师。
执行步骤
在仓库里运行 /init,让 Claude 根据代码库生成初稿。精简为新成员第一天需要的信息。保留构建、测试和 lint 命令,关键约定,以及 Claude 总是犯错的地方。 放在仓库根目录并提交到 git。全团队共享同一版本,修改像代码一样接受评审。 可以采用一条工作规则:Claude 同一个错误犯了两次,就把修正规则写进文件。 长度控制在一页以内。Claude 在会话开始时会完整读取,过期内容只会占用上下文。
示例:CLAUDE.md
# 支付服务## 命令- 构建:make build- 测试:make test(单元),make itest(集成,需要 Docker)- Lint:make lint(CI 会执行,推送前修复)## 约定- Java 21,Spring Boot 3。不新增 Lombok。- 金额必须用 BigDecimal,不用 double。- 每个接口都要在 src/itest 中有集成测试。## 架构- api/:REST 控制器;core/:领域逻辑。- adapters/:外部系统适配。- Kafka 事件定义在 schemas/,不编辑生成的类。## Claude 容易犯的错- 不升级依赖版本,由平台团队负责。- 旧 v1/ 包已冻结,变更写入 v2/。治理要求
CLAUDE.md 受版本控制,Agent 使用的指令可以审查、审计。团队约定通过文件应用,改动记录在 git 历史里,由代码负责人在 PR 评审中批准。
如何衡量效果
- 先行指标:Claude 重复犯下本应被文件约束的错误的频率,修正规则在 git 历史里跟踪。
- 滞后指标:新成员从加入到首个 PR 合并的时间,依据 PR 历史。
5.5 用 skills 执行团队知识
Skills 把团队知识变成可执行的工作规范。指令明确、受版本控制、广泛应用,政策变化时集中更新。
一个实用判断是:需要一致执行的组织知识适合写成 skill;属于 CLAUDE.md 或单次提示词的内容,不必另建 skill。
前置条件:无。已有 CLAUDE.md 会有帮助,但 skill 不依赖它。
基础设施:一项有具名负责人、且正式政策来源明确的政策。
执行步骤
选一项目前执行不一致的知识,例如安全标准、API 设计规范或品牌规则。 工程师依据政策负责人的正式文档,借助 Claude 写成 skill。目录中的 SKILL.md用 frontmatter 说明触发条件,正文说明具体做法。放入仓库的 .claude/skills/<name>/,随代码一起交付,或者通过 plugin 在整个组织分发。测试触发条件。用不同表达要求 Claude 完成相关任务,确认每次都会加载 skill。 政策变化时更新 skill,由政策负责人批准。 工程师在下次会话中自动获取新版本。
示例:.claude/skills/secure-api-review/SKILL.md
---name: secure-api-reviewdescription: 应用 API 安全标准。创建或修改对外接口、 评审 API 代码、生成 OpenAPI 规格时使用。---# API 安全审查创建或修改 API 接口时:1. 认证:所有接口都要求网关 JWT; 除 /health 外,不允许匿名路由。2. 输入校验:请求体按 OpenAPI schema 校验,拒绝未知字段。3. 审计:改变状态的接口输出审计事件, 包含 actor、action、entity、timestamp。4. 数据分类:schema 中标记为 pii 的字段, 不得出现在日志或错误信息中。执行 scripts/check-endpoints.sh,摘要中附上输出。治理要求
Skill 是一种建议性控制。它提高 Claude 在编码时应用政策的概率,但不能强迫会话遵守。必须始终成立的政策,需要确定性机制兜底,例如阻止动作的 hook,或者在 PR 中复查政策的评审。
Skill 降低违规频率,hook 进一步约束执行。Skill 调用记录在会话轨迹里,政策负责人像审查代码一样审查 skill 修改。
如何衡量效果
- 先行指标:从政策负责人批准政策变化,到更新后的 skill 合并所需的时间。
- 滞后指标:PR 中引用该政策的评审问题数量。理想情况下逐渐接近零;如果没有下降,可能是 skill 未触发,或文字已经偏离正式政策。
5.6 用 hooks 做开发时的护栏
Skill 提供建议,hook 提供背后的确定性控制。实现阶段多数动作是编辑文件或执行 shell 命令,因此 hooks 在开发期间触发最多。
开发阶段的 hooks 可以:
阻止编辑生成的类、冻结包等受保护路径。 文件编辑后立即执行格式化和 lint,避免偏差积累。 防止凭据进入 diff。
凡是必须无例外执行的 skill 政策,都应有确定性机制支撑。Hook 对每一个匹配动作执行,因此开发 hooks 应快速运行,并限定在变更文件范围。完整测试套件等较重检查放在 commit 或 PR 阶段。
需要人批准的 hook 应放在部署阶段的关卡中。开发时频繁弹出审批,会把人重新放回所有并行会话的必经路径。
5.7 并行会话与 subagent
一位工程师可以同时推进几条工作线。
并行会话是另一个完整 Claude Code 实例,在独立 git worktree 中处理独立任务。会话彼此不知道对方的情况,共享的是负责指导它们的工程师。
Subagent 在单个会话内部运行,拥有独立上下文窗口和工具限制。它适合在多种任务中反复出现的局部工作,例如确认应用行为符合预期。
并行会话增加可同时推进的任务数,subagent 则帮助每个会话聚焦。工程师负责指导与审阅。
传统做法:一位工程师一次处理一项任务,大量时间花在等待构建、测试和评审。等待时可以切换任务,但切换上下文很累,很多人不会这样做。
AI 原生做法:在不同 worktree 中运行多个会话,每个处理自己的任务;重复工作交给独立上下文和权限的 subagent。工程师逐步转向编排,再转向构建和监控闭环。
前置条件:各会话共同读取的 CLAUDE.md。测试阶段的反馈闭环也很有帮助,会话能够自己验证,工程师就不必一直盯着。
基础设施:git 仓库,以 worktree 隔离;调整权限,让组织认定安全的命令不必等待批准。
执行步骤
利用已批准计划识别独立工作,拆成修改不同文件的任务。共享文件的任务放在同一会话中顺序执行。 每项并行任务使用一个 worktree,例如在两个终端分别运行 claude --worktree feature-auth和claude --worktree fix-rate-limit。独立分支与工作副本避免文件冲突。从两到三个会话开始。上限取决于一个人能认真审阅多少工作线;评审跟得上,再增加会话。 把重复工作定义为 .claude/agents/下的 Markdown subagent,说明名称、使用场景和可用工具。例子包括完成后简化代码的 simplifier、运行应用检查行为的 verifier,以及探索代码库并简洁汇报的 researcher。定义提交到 git,全团队共享。
示例:.claude/agents/verifier.md
---name: verifierdescription: 在会话报告完成之前,运行应用并检查变更有效tools: Bash, Read---用 make run 启动应用。检查修改后的行为,以及最接近的两个相邻流程。报告执行了什么、观察到什么,以及哪些行为不符合 plan.md。不要修复,只报告。治理要求
会话越多,产出越多,控制措施就越需要来自仓库配置。Hooks 和权限设置应用到所有会话;会话动作被记录,并归属于运行该会话的工程师。
如何衡量效果
- 先行指标:在评审质量不下降的前提下,每位工程师并行会话数,依据 OpenTelemetry 导出;一天中用于指导而非等待的时间占比。
- 滞后指标:每位工程师每周合并的变更数,同时观察 PR 历史中的返工率。
6 第四阶段:测试
每个会话在交给人之前检查自己的工作;指导 Agent 的配置,也像代码一样接受回归测试。
6.1 给 Claude 一个反馈闭环
始终给 Claude 验证结果的方法:测试、构建或截图对比。让它在工程师看到结果前检查并修正错误。
反馈闭环与 verifier subagent 不同。闭环贯穿整个任务,可以反复运行;verifier 是最终检查的一种封装方式,在会话自认为完成后,用全新的上下文验证,减少实现过程中假设对判断的影响。
传统做法:代码正确性的信号来得较晚,CI 要几分钟,测试人员可能几天后才反馈,生产问题可能几周后才出现。Agent 产出越多,负责检查的人越容易成为瓶颈。
AI 原生做法:会话先运行测试、构建或截图检查,迭代到通过,再交给工程师。工程师负责搭建这个闭环。
前置条件:无。
基础设施:测试与构建分别可以用一条本地命令执行。UI 工作需要浏览器工具,或通过 MCP 接入截图工具,让 Claude 看见结果。
执行步骤
如果验证需要一串命令和环境知识,就包装成 make test或npm test,失败时以非零状态退出。在 CLAUDE.md的命令部分列出命令和正常输出示例。设定可量化目标,例如“test_status.py 全部通过”“截图匹配附件原型”“接口返回 200 且带有新字段”,让 Claude 能自行检查。 修 bug 时先写失败测试。让 Claude 用测试复现错误,运行并确认失败原因符合预期,然后提交测试。之后再要求它修复代码,禁止改测试,并用最后一步的测试文件 hook 执行限制。修复前就存在、且 Agent 不能改写的测试,才提供错误消除的证据。 UI 工作加入视觉检查。提供浏览器或截图工具和原型,循环实现、截图、比较、调整。两到三轮很常见,结果应该逐轮改善。 将验证列入“完成”的定义,写在 CLAUDE.md。报告完成前运行测试,并展示输出。保护闭环本身。修代码的 Agent 不能削弱验证标准,可以用 hook 阻止修复任务编辑测试文件;或者在评审中检查 diff,拒绝触碰测试的修改。
示例:CLAUDE.md 的验证部分
## 验证工作- 构建:make build(必须以 "Build succeeded" 结束)- 测试:make test(全部通过,不跳过或删除失败测试)- Lint:make lint(零警告)报告完成前执行以上三项,附上输出。测试失败就修代码,不改测试。治理要求
- 执行什么:报告完成前验证,以及修复时禁止编辑测试。需要强制保证的组织,用 hooks 落实。
- 证据是什么:实际测试输出、构建日志或截图 diff,来自工具链。
- 在哪里记录:会话记录通过 OpenTelemetry 转到可观测系统;PR check run 保留结果,供评审和审计查看。
- 谁批准:评审 PR 的代码负责人。有了机械检查证据,人可以重点判断意图和风险。
如何衡量效果
- 先行指标:Agent 编写变更的首次 CI 通过率。
- 滞后指标:每个 PR 的评审时间,以及从事件跟踪系统取得的变更失败率。
6.2 在 CI 中持续评测
评测是 AI 原生流程中对应阶段 QA 的机制。每次 Agent 配置变化时,评测套件验证它能否继续按同样标准完成工作,包括换模型、改提示词等变化。
套件需要持续维护。模型进步后,过去能区分好坏的样例可能不再有效,应补入持续监控中发现的新样例。有些场景适合定期离线评测,而不必每次改动都运行;下面介绍持续评测的方式。
前置条件:CLAUDE.md 和反馈闭环。
基础设施:CI 能非交互运行 Claude Code;有 API key 和评测预算。
执行步骤
平台工程师从近期工作中收集 20 到 50 个真实任务,附预期或已接受的结果。 每个任务写成评测:提示词加上定义“可接受”的检查,例如测试通过、lint 干净、行为不变、符合政策。 CI 定时执行; CLAUDE.md、skills 或 hooks 变化时也执行。这些配置指导 Agent,同样需要回归测试。把结果作为配置合并关卡。Skill 修改导致通过率下降,要在合并前评审。 每次生产事件由负责团队补一项评测,长期留在回归套件中。
示例:.github/workflows/agent-evals.yml
name: Agent evalson: pull_request: paths: ['CLAUDE.md', '.claude/**'] schedule: - cron: '0 2 * * *'jobs: evals: runs-on: ubuntu-latest steps: - uses: actions/checkout@v4 - run: npm install -g @anthropic-ai/claude-code - name: Run eval suite env: ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }} run: | for eval in evals/*.json; do claude -p "$(jq -r '.prompt' $eval)" \ --allowedTools "Read,Edit,Bash(make test)" \ --output-format json > result.json ./evals/check.sh "$eval" result.json done治理要求
评测让 QA 关卡跟上 Agent 产出。通过率阈值作为合并检查,保存每次运行以比较变化,配置变更的负责团队批准修改。
如何衡量效果
- 先行指标:每次运行的通过率趋势,以及生产事件转成永久评测所需的时间。
- 滞后指标:CI 捕获的回归与进入生产环境的回归数量,依据事件跟踪系统。
7 第五阶段:部署
Claude 既评审别人的 PR,也接收评审并修复自己的 PR。治理在 Agent 动作发生时执行;Agent 可以完成生产关卡前的工作,但不能自行越过关卡。
7.1 将 AI 接入 PR 评审闭环
Claude 根据组织政策评审新 PR,也处理自己 PR 上的评审评论。工程师因此可以把注意力放在行为、意图和风险上。
传统做法:评审容量按人工产出安排。PR 等人通读,评审质量受负荷影响,作者不断催促,积压逐渐增加。
AI 原生做法:所有 PR 接受同样的多轮检查,问题按严重程度排序。人重点判断是否实现计划意图,以及风险是否可接受。
前置条件:更新后的 CLAUDE.md;如果要执行书面政策,还需相应 skills;定义好的 subagents。
基础设施:仓库接入 Claude。可以由管理员启用托管 Code Review(research preview),或在自己的 CI 运行 claude-code-action。需要时,模型调用经 AWS Bedrock、Google Vertex 或 Microsoft Foundry。分支保护应要求代码负责人批准。
执行步骤
托管 Code Review 可快速起步,由管理员启用并选择仓库。需要控制流水线、或使用组织的云服务协议时,在自己的 CI 中运行 claude-code-action。 技术负责人在根目录写 REVIEW.md,分成不同检查:bug 与逻辑错误,安全漏洞,与spec.md、plan.md和设计原则的一致性。定义哪些算 Important,哪些算 Nit(细节建议),以及哪些内容不检查。设置人工审批边界。评审结论本身不会自动批准或阻止 PR,分支保护仍要求代码负责人批准。如果要以评审结论设置合并门禁,平台工程师可以读取 check run 输出的机器可读严重程度统计。 评审者或作者在评论中提及 @claude,Claude 会处理评论并推送修复,PR 线程保存请求和改动。这个修复闭环通过 claude-code-action 执行;托管服务中的@claude review则用于发起新评审。对 Claude 自己提交的 PR,还可以让它持续处理直到只剩人工批准:用自定义 slash command 扫描未解决评论与失败检查、修复并推送,直到 PR 全绿。评审发现的问题写回 CLAUDE.md。同一错误第二次被指出,就在该次评审中补入规则,后续 PR 即可利用。评审还要指出变更导致的过期上下文。技术负责人每月评估发现的问题质量,改进评审配置,在 REVIEW.md中限制 Nit 数量。生成路径和 CI 已强制检查的内容排除在外。
示例:REVIEW.md
# 评审指令## 检查轮次执行三轮检查,每条结论标出所属轮次:- Bugs:逻辑错误、异常边界、隐蔽回归。- Security:注入风险、认证缺口、日志中的 PII。- Compliance:符合 spec.md、plan.md 和设计原则。## Important 的定义会破坏行为、泄露数据或违反政策的发现,才标 Important。风格和命名属于 Nit。## 限制 Nit 数量每次最多报告五条,其余只汇总数量。## 不检查src/gen/ 下的生成文件,以及 CI 已强制检查的内容。治理要求
写代码的 Agent 无法自行批准它,职责分离得到保留。REVIEW.md 应用于所有 PR,发现、修复、评分和批准都在 PR 历史中记录。人通过分支保护完成批准,评审结论提供判断依据。
Anthropic 的 AI 原生 SDLC 安全实践进一步介绍了这些控制在生产规模下如何组合。
如何衡量效果
- 先行指标:首次评审等待时间,目标缩短到分钟级;无需人操作分支即可解决的评审评论占比,依据 Git 记录。
- 滞后指标:合并前捕获的缺陷和漏洞,与进入生产后的数量比较,依据 PR 历史和事件记录。
7.2 用 hooks 执行审批关卡
开发阶段的 hook 可自动允许或阻止动作,不需要人参与。它也可以请求批准,在指定的人批准前暂停动作,这是发布关卡需要的能力。
这里以部署为例,但 hooks 并不限于部署。开发阶段可在没有变更工单时阻止修改迁移和基础设施;测试阶段可阻止修 bug 的 Agent 编辑测试文件。
前置条件:无。
基础设施:明确列出变更流程要求的人工审批。
执行步骤
工程管理者与变更管理、合规团队列出必须保留的人工关卡,例如变更批准、发布授权和受保护路径修改。 平台工程师为各关卡编写 hook,在 Claude 动作前运行,给出允许、请求批准或阻止的结果。 团队 hooks 放入 git 中的 .claude/settings.json。不可协商的 hooks 放入平台或 IT 管理员控制的 managed settings,个人工程师不能关闭。阻止动作时,解释原因和获批路径,让 Claude 输出里能看到。
示例:.claude/settings.json
{ "hooks": { "PreToolUse": [ { "matcher": "Bash", "hooks": [ { "type": "command", "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/production-gate.sh" } ] } ] }}示例:.claude/hooks/production-gate.sh
#!/bin/bash# Production deploys require a named release authorizationcmd=$(jq -r '.tool_input.command' < /dev/stdin)if [[ "$cmd" == *"deploy"* && "$cmd" == *"production"* ]]; then if [ -z "$RELEASE_APPROVAL" ]; then echo "Production deploys need a release authorization." >&2 exit 2 # exit 2 blocks the action; the message goes to Claude fifiexit 0治理要求
每次执行都检查关卡条件,对所有人统一应用。允许和阻止结果带时间戳记录。关卡还需定义怎样算批准,例如已批准变更工单,或发布经理签字。
7.3 受监管企业的托管设置示例
平台团队通过 MDM 或管理员控制台部署,工程师不能编辑或覆盖。
{ "permissions": { "deny": [ "Read(.env*)", "Read(./secrets/**)", "WebFetch", "Bash(curl *)", "Bash(wget *)" ], "allow": [ "Bash(git *)", "Bash(make build)", "Bash(make test)", "Bash(make lint)" ], "disableBypassPermissionsMode": "disable" }, "allowManagedPermissionRulesOnly": true, "sandbox": { "enabled": true, "failIfUnavailable": true, "allowUnsandboxedCommands": false, "network": { "allowedDomains": ["git.internal.example.com","registry.npmjs.org"] }, "credentials": { "files": [ { "path": "~/.ssh", "mode": "deny" }, { "path": "~/.aws/credentials", "mode": "deny" } ], "envVars": [ { "name": "GITHUB_TOKEN", "mode": "deny" } ] } }, "allowManagedHooksOnly": true, "disableSideloadFlags": true, "allowManagedMcpServersOnly": true, "strictKnownMarketplaces": [ { "source": "github", "repo": "example-corp/approved-plugins" } ], "requiredMinimumVersion": "2.1.193"}这些设置分别解决什么控制问题:
permissions.deny阻止秘密进入 Agent 上下文,并禁止通过指定工具任意访问网络; permissions.allow预先批准安全的开发循环,避免反复询问。disableBypassPermissionsMode和 allowManagedPermissionRulesOnly阻止工程师、项目文件或命令行参数放宽规则。sandbox补上工具权限的缺口。禁止 WebFetch 不能阻止 shell 联网,操作系统层的域名允许名单才约束网络出口。 failIfUnavailable与 allowUnsandboxedCommands把沙箱变成关卡:沙箱初始化失败时 Claude Code 拒绝启动;沙箱内失败的命令不能转到沙箱外重试。credentials补上凭据保护缺口。工具的文件读取禁令不一定阻止 shell 读取 ~/.ssh或~/.aws/credentials;这组设置禁止这些读取,并从每条沙箱命令的环境中移除指定秘密。allowManagedHooksOnly只允许托管 hooks 执行,本地配置不能增加或替换。 disableSideloadFlags和 strictKnownMarketplaces要求 skills、agents、hooks 和 MCP 服务端来自组织批准的 plugin marketplace,不能随意从个人主目录加载。allowManagedMcpServersOnly让平台团队管理 Agent 工具允许名单。 requiredMinimumVersion拒绝启动低于批准版本的客户端,保证控制由组织实际评估过的版本执行。
这是一份需要按实际情况调整的起点。每项禁止规则都会限制一部分能力,合适的平衡取决于仓库的数据分类。完整字段和托管专用字段可查 Claude Code settings 文档。
如何衡量 hooks 的效果
- 先行指标:各审批关卡的等待时间。Hook 决策在 OpenTelemetry 导出中带有时间戳和允许或阻止结果。
- 滞后指标:使用 hooks 前后,绕过关卡而进入生产的违规数量,依据事件记录。
7.4 CI/CD 集成与部署
在 CI/CD 中非交互运行 Claude Code,将长时间 Agent 任务放入沙箱,通过 MCP 暴露部署能力,并在需要回滚之前充分演练回滚路径。
传统做法:流水线执行确定性脚本,判断性工作等人处理,例如分析不稳定测试、写 changelog、查构建失败原因。部署与回滚依赖人按 runbook 操作。
AI 原生做法:Claude 在流水线内处理判断性工作,使用沙箱和受限凭据。部署工具通过 MCP 提供给 Agent,让写代码和测试的工作流也能发布和回滚,但受各环境的关卡限制。
前置条件:PR 评审闭环,以及 hooks 审批关卡。自动化加速前,关卡必须先就位。
基础设施:安装了 claude-code-action 的 CI,或能执行 claude -p 的 runner;API 或 Bedrock、Foundry、Vertex 模型访问;部署目标的 MCP 服务端;Agent 作业的沙箱配置,默认没有长期生产凭据。
执行步骤
从只读判断任务开始:在流水线里用 claude -p分析构建失败、归纳不稳定测试,或起草 changelog。将写入任务放在现有关卡后,例如修复 lint、更新生成文档、处理 @claude评论。写入通过分支保护进入 PR,Agent 不能直接推送 main。作业在受网络策略约束的容器中运行,使用短期、限定范围的 token,默认不持有生产凭据。 将 deploy、status、rollback 暴露为按环境限定的 MCP 工具,以允许名单定义部署权限。 按环境分级授权。开发环境可以自由部署;生产环境由 Agent 准备发布,发布经理授权,hook 执行关卡;staging 的权限处于中间。 回滚必须充分演练。提供一条 Agent 可执行的命令,并定期在 staging 验证。维护闭环会在指标越界时调用它,因此要先证明这条路径可靠。
示例:流水线步骤
- name: Triage failed build if: failure() run: > claude -p "Read the build log at out/build.log. Identify the most likely cause, say whether the failure looks flaky or real, and write a three-line summary for the PR thread." >> triage.md治理要求
Agent 可以推进到生产关卡前,但不能绕过它:
分支保护要求所有写入以 PR 提交,不能直接进入 main。 生产部署 hook 等待具名发布经理授权。非交互运行使用 Agent 自己的身份,流水线日志区分 Agent 与发起任务的工程师。 每个环境的权限等级决定 Agent 到达关卡前可以做多少。
如何衡量效果
- 先行指标:无需呼叫人工就能完成初步分析的流水线失败占比,依据 CI/CD 日志。
- 滞后指标:DORA 指标,由 CI 和部署工具提供。
8 第六阶段:维护
循环闭合。触发器直接调用 Claude,调用路径不必有人参与,发现的问题以 intent.md 重新进入流程。
8.1 维护与闭环运行
前面的阶段介绍了如何接入 Claude,但初始步骤通常仍由人发起。维护阶段则转向自主运行。
例如持续监控的 Agent 可以在 bug 工单出现后写出 intent.md,再依次进入需求、计划、开发、测试和评审。阶段之间设置独立的置信判断关卡,用确定性检查或独立对抗式评审 Agent,决定继续推进还是升级给人。
传统做法:维护主要被动响应。工单或事件等人重启流程,凌晨三点的告警可能漏看,工单可能长期排队,复盘行动也可能因为下一场事故而始终没进入代码库。
AI 原生做法:指标越界、工单、频道消息或定时计划直接触发 Claude。它诊断,只通过受关卡约束的路径行动,将结论写成 intent.md。人负责分流和评审,不必亲自启动。
8.2 用确定性检测启动闭环
一个确定性脚本监控生产指标,越过控制界限时调用 Claude。后面的 Claude Tag 会介绍从其他入口触发工作的方式。
前置条件:能以结构化格式重启循环的 intent.md、加速 PR 评审、限定动作范围的 hooks,以及 CI/CD 中已验证的回滚路径。最高自主等级可以调用这条路径。
基础设施:可查询的指标系统,如 Prometheus 或 CI API;仓库只读访问;CI 非交互运行 Claude Code,或在沙箱容器中运行接收 webhook 的 Agent SDK 服务。
执行步骤
服务负责人或平台工程师选择一个有稳定滚动基线的指标,例如 CI 测试失败率、部署后的 5xx 比例或 PR 周期。 编写检测脚本,通常使用滚动窗口的均值和标准差,配合 Western Electric 等规则,同时检测尖峰和缓慢漂移。脚本受版本控制和单元测试,检测全程不调用模型。 在 bands.yaml等版本化配置中分级响应:1σ 只记录,2σ 调用 Claude 只读诊断,3σ 才允许行动,而且只能提交 PR 或触发预批准 runbook。触发层可以是 GitHub/GitLab 定时 workflow、监控 webhook,或内网 Cron Job。Claude 无状态、非交互运行,可以在 CI runner 上执行,也可作为沙箱化 Agent SDK 服务。循环不必等人启动。 Agent 按规划阶段格式将异常和证据、预期结果、受影响系统、未决问题写成 intent.md,与其他变更一样进入流程。服务负责人或值班工程师分流:立即修复、排期或忽略。面向产品的发现交给产品负责人,忽略原因用于调整控制界限、降低噪声。 修复上线后,为事件补入持续评测套件,防止再次出现。
示例:监控 CI 测试失败率的 bands.yaml
metric: ci_test_failure_ratebaseline: rolling_30drules: western_electrictiers: 1sigma: { action: log } 2sigma: { action: diagnose, tools: "Read,Grep,Bash(gh run view *)" } 3sigma: { action: propose, routes: [pull_request, runbook:rollback-deploy] }治理要求
分级边界由版本化配置执行,权限和托管设置限制生产访问。调用、结论和分流决定带时间戳记录。服务负责人批准发现,变更走常规 PR 关卡,Agent 可触发的 runbook 事先批准。
如何衡量效果
- 先行指标:
从指标越界到 intent.md进入分流队列的时间,与过去从事件到复盘行动的时间比较。检测日志提供越界时间和等级。 - 滞后指标:发现的问题最终变成已合并修复的比例,以及同类事件重复发生的次数。随着修复和评测增加,重复事件应减少。
三个例子
CI 测试失败率越过 3σ,Agent 隔离不稳定测试或提交 revert PR,由评审关卡决定。 部署后的 5xx 比例越过 3σ,且观察窗口内有部署,Agent 触发已有回滚流水线。 PR 周期触发漂移规则,Agent 向工程管理者写报告,说明这个 Harness 也能处理流程指标。
检测始终由确定性逻辑执行。越界后才调用 Claude,由等级决定它可以做什么。
8.3 定期扫描代码库
一次安全扫描只能说明某个模型在某个时点对代码库的判断。代码每周都在变,新模型也可能发现旧模型漏掉的漏洞。
因此应定期运行扫描,不依赖人启动,发现的问题进入与其他变更相同的关卡。
Claude Security 是托管的定时扫描实现。连接 GitHub 仓库后,扫描在 Anthropic 基础设施上使用 Claude Mythos 5 运行,结论先经过验证并附置信评级。建议补丁在 Claude Code 网页版里评审和应用,组织无需直接访问该模型。
传统做法:发布或审计前启动一次扫描,把报告送进工单系统,人逐项处理。两次扫描之间的代码主要依赖 PR 评审覆盖。
AI 原生做法:连接的仓库按计划扫描,报告前验证发现。单个 PR 能修复的问题走评审,更大的问题转为 intent.md。覆盖时间依据最近一次扫描。
前置条件:PR 评审和 hooks 审批关卡;规划阶段的 intent.md 格式,用于超出单个补丁范围的问题。
基础设施:Claude Security 面向 Claude Enterprise 组织提供 public beta。需要在目标云端 GitHub 仓库安装 Anthropic GitHub App、开启 Claude Code 网页版、开启 Extra Usage 并设费用上限、给扫描人员 premium 席位,由管理员在 claude.ai/admin-settings/claude-code 启用。扫描按 Mythos 5 用量计费,费用上限要结合仓库规模和数量设置。
执行步骤
安全负责人连接仓库,按仓库、服务或团队组织项目,让发现的责任归属从开始就明确。 对最关键仓库首次全量扫描,包括以前其他工具或旧模型已经扫描过的仓库。这次结果作为基线,可能发现过去认为干净的代码中的问题。 按项目设置计划。活跃服务可以每周扫描;大仓库或混合仓库可以限制目录或分支。 结合置信评级分流。忽略时写明理由,保存记录,避免下次作为新问题再次出现。 范围明确的问题,在 Claude Code 网页版打开建议补丁、评审,再进入普通 PR 关卡。提出修复的 Agent 不能批准修复。 架构弱点或跨服务重复模式等较大问题,写成 intent.md,从规划阶段重新开始。漏洞修复上线后,把这类漏洞加入评测,持续验证指导 Agent 的配置。 通过 CSV、Markdown 或 webhooks 导出,让组织原有工单和审计系统继续保存正式记录。
治理要求
连接哪些仓库、谁有扫描席位和费用上限都由管理员集中设置。每项发现有验证结果和置信评级,每次忽略都有理由,扫描历史记录发现、修复和主动接受的风险。
补丁通过 PR 评审和分支保护进入生产,扫描本身不能直接部署。Claude Security 补充已有静态分析和依赖扫描:确定性检查留在 CI,模型处理需要结合上下文判断的漏洞。
如何衡量效果
- 先行指标:已连接仓库中定期扫描的占比,以及从报告发现到补丁进入 PR 关卡的时间。
- 滞后指标:扫描发现的漏洞与生产或外部报告发现的漏洞比较;多次扫描过的仓库每轮发现数量趋势,随着修复和评测积累应下降。
8.4 用 Claude Tag 参与值班
事件也可能通过 Slack 或 Teams 到来,例如晚上十点在事故频道发出的一条紧急修复消息。
Claude Tag 的 public beta 当前支持 Slack,让 Claude 以自己的身份加入频道,及时进行初步响应。响应过程也进入闭环,成为后续事件可用的记忆。
对话和团队知识留在频道里,频道成员都可以指导响应、验证假设、探索方案和实时调查,频道历史形成审计轨迹。Claude 通过 MCP 检查指标是否回到基线,在讨论串中确认,并把复盘写进版本化的经验文件,供以后调查读取。
Claude Tag 也能处理其他工作:通过 MCP 在工单里被提及,或在频道中收到请求时,同样进行分流。范围小且明确的修复提交为 PR;更大的工作写成 intent.md,进入规划阶段,循环继续。
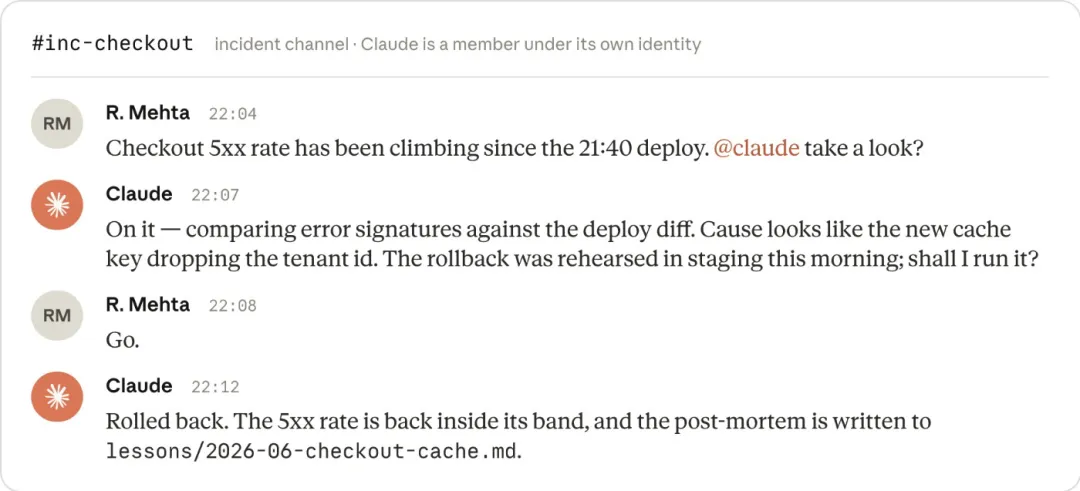
频道中的处理过程保留请求、诊断、人工授权和修复,形成同一条审计轨迹。
9 结语
模型和 Harness 的进步,让组织能够改造从规划到维护的整个软件开发生命周期。
这种改造仍然让人的判断处于中心,也要满足大型企业的治理与监管要求。这份手册汇集了 Applied AI 团队日常服务客户时使用的做法,供团队逐项落实。
让循环持续运行,让人负责判断。