ARTICLE · 1152050
配音软件按月收费、AI 朗读一股机械味,这个开源工具在你电脑里就能合成人声
想给视频配个音,先撞上付费墙
做视频、做课件、做有声内容的人,早晚会遇到配音这一步。
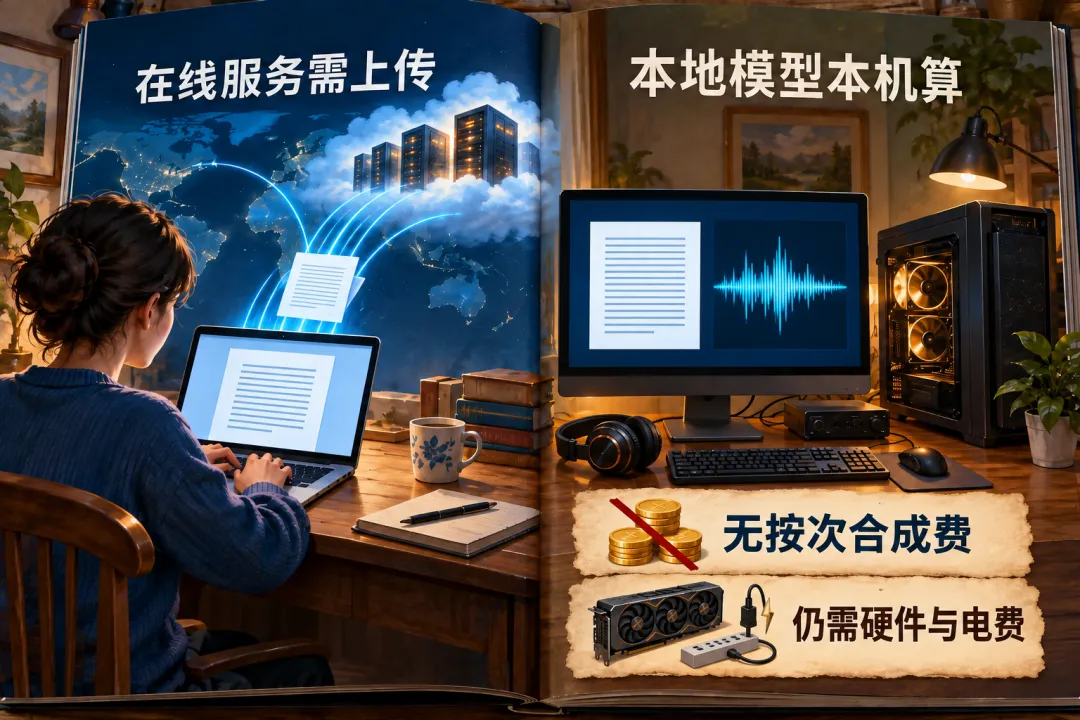
真人配音最自然,但成本摆在那里,改一句台词就要重录;找在线配音服务,试听免费,导出要充值,而且每一段文字都得先上传到别人的服务器。内容里有内部信息、没发布的方案,这一步就成了顾虑。
免费的方案也有,但机械感明显:断句生硬,语气一条直线,念到数字和专有名词就开始出岔子。
这一期挖到的 VoiceBox(可以理解为「语音工作台」),走的是第三条路:整套语音合成都在你自己的电脑里跑。 一句话概括它的定位,是把两个付费服务的活合并到一台机器上,一个是把文字变成人声,一个是把人的声音留下来复用。
为什么要在本机跑
先说清楚本机合成的实际好处,这不是口号。
不按次收费。 在线配音按字符或按条计费,做长内容时成本会一直叠加;本地模型不按合成次数收费,但仍有硬件、电费和部署成本,所选模型的许可也要单独看。
文字和录音都不出门。 涉及内部资料、还没公开的内容、别人授权给你使用的录音素材,这一点是能不能用的前提。
改一版不用重新下单。 台词改一个字、语速调快一点、换个音色试试,可以在本机重新生成,不用再次上传;生成仍需要等待机器计算。
七个语音引擎,按配音用途来挑
这个项目最有意思的地方,是它不只接一个语音模型,而是内置了七个可以随时切换的引擎,每个的强项不一样。
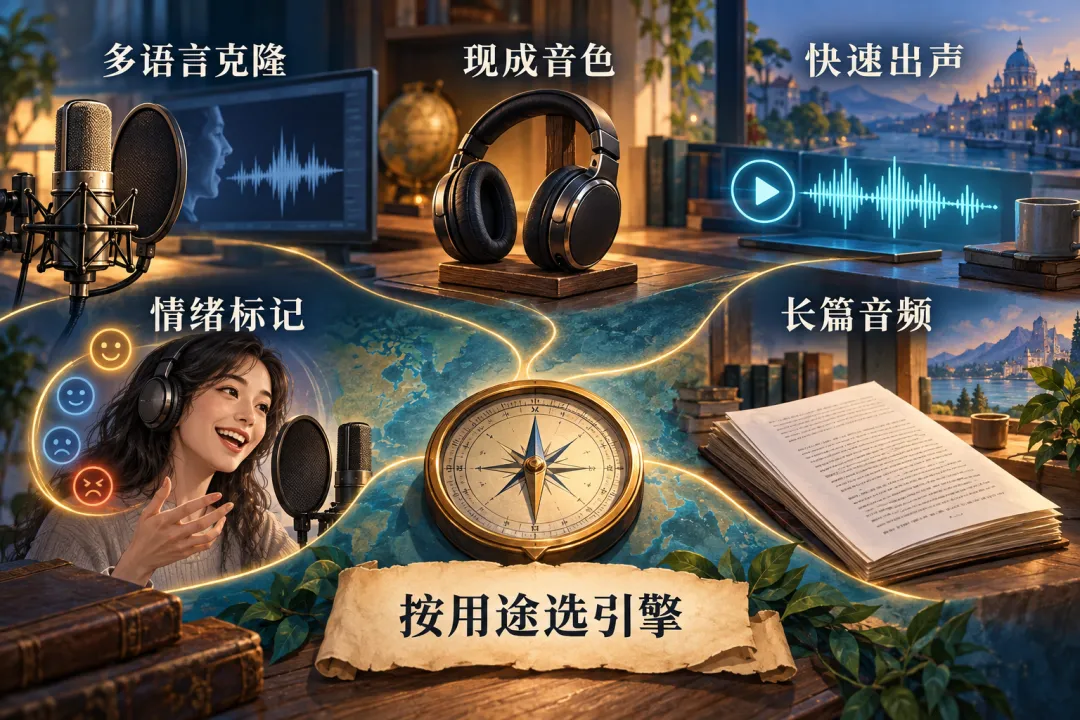
引擎这个词听着技术,其实可以理解成七间不同的小作坊:有的擅长模仿某个人的音色,有的自带一批现成的播音腔,有的出得快,有的能读出情绪,有的能一口气念很长的段落。
它们大概分成这么几类:
能克隆音色的。 给一段几秒到几十秒的参考录音,它就能模仿这个声音说话。其中有的支持十种语言,还能接受自然语言指令。
不用参考录音、直接挑的。 有的引擎自带九个现成音色,选一个就能出声,不需要你提供任何素材,省掉了最麻烦的一步。
语言覆盖最广的。 有一个引擎支持二十三种语言,阿拉伯语、印地语、波兰语、斯瓦希里语这些都在里面,做多语种内容时它顶用。
出得快的。 有的模型专为速度做,在处理器上就能跑到远快于播放速度的水平,适合先把长稿子过一遍听听效果。
带情绪的。 有一个引擎能识别文本里插入的表情标记,比如写上方括号加 laugh,它就会真的笑一声,叹气、清嗓子这类都能标。要注意别的引擎不认识这些标记,会老老实实把标记读出来,选错引擎就会出岔子。
能念长篇的。 有的引擎支持连续生成很长的音频,做有声书和播客这种场景,连贯性比短句合成重要得多。
一个挺新鲜的用法:用大白话指挥语气
前面提到有的引擎接受自然语言指令,这一点值得单独说。
传统配音工具调语气靠参数,语速一个数值、音调一个数值,调半天也未必是想要的效果。这里可以直接写「说慢一点」「像在耳边轻声说」「语气正式一些」这样的描述,它照着做。
不用先学语速、音调参数,直接描述想要的说话方式。 你不需要知道那个参数叫什么,只要说清楚想听成什么样。
从文字到成品,三步
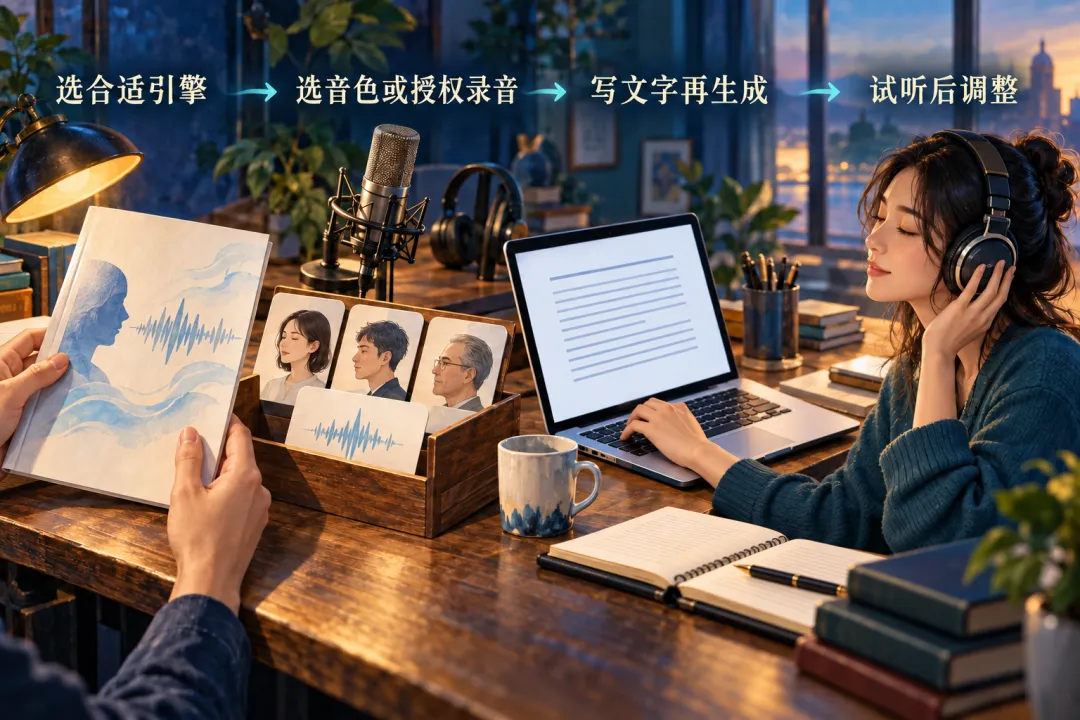
第一步,挑引擎。 按前面说的用途选,做中文和英文内容、想要克隆音色,和要做多语言,选的不是同一个。拿不准就先用现成音色那个试,不用准备素材。
第二步,给声音。 两条路:放一段参考录音让它学,或者直接挑一个自带音色。参考录音不用长,但要求干净,没有人声以外的杂音、没有配乐。
第三步,写文字、点生成。 长文本它会排队处理,可以连着提交几段。生成完能试听,不满意就换引擎或改描述再来一遍。项目还带了八种后期效果(变调、混响之类),需要在同一个界面里就能加。
做完的内容可以导出,也能交给别的工具继续用。它另外开放了一套接口,别的 AI 助手可以通过这套接口调用它,让你的智能体用你指定的声音说话。
边界要讲清楚
克隆别人的声音,要先拿到授权。 这是第一条,也是最要紧的一条。声音和脸一样,是可以被冒用的东西:拿同事的录音生成一段他没说过的话,或者用某个主持人的音色做内容,都可能构成侵权甚至更严重的后果。只能用你自己的声音、或已明确获得授权的素材。 平台方要求也写在项目说明里了,规则很清楚。
系统支持不一样。 macOS 与 Windows 都有现成安装包,Linux 目前没有预编译版本,需要自己从源码构建,这一步对非技术用户不现实。
引擎对硬件的要求不一样。 有的引擎在普通处理器上就能跑得挺快,有的需要显卡才流畅。装之前先确认自己的机器,尤其是笔记本。项目本身带了一堆可切换的引擎,好处是能挑,代价是要挑。
参考音频的干净程度会影响成品。 底噪、回声和背景音乐可能干扰音色克隆,生成结果仍要试听。这一步偷不得懒。
小模型的能力有上限。 那些省资源的引擎读得流畅,但情绪和细节表达不如大模型。同一份稿子换引擎听一遍,差别很明显,值不值得等,得你自己听。
这也是个还在快速迭代的项目。 安装、模型下载、显卡兼容这些环节都可能有坑,项目文档里有单独的排查说明,遇到问题先去那里看。
适合谁
做视频和口播内容的人,它能省掉反复录制的成本:改稿子不用重录,试不同语气不用预约录音棚;做课件、培训材料的老师和企业培训岗,长文稿能批量出声,还能用同一套音色保持一致性;写有声内容、做播客的人,多轨时间线与长音频引擎是照这个场景做的;手上有大量文字稿要转音频的人,本机批量处理不用担心素材外泄。
如果你只是偶尔需要一段配音、内容也不敏感,用现成的在线服务更省事,不必为这件事装一套系统。
最后说一句我自己的判断:本机配音让我更看重的,是改台词、换音色、试语气都能自己反复调整,不用每次重新下单。 门槛降下来之后,才会有人愿意去试不同的语气、不同的讲法。
你平时做内容会用到配音吗?欢迎在评论区聊聊。
项目入口: https://github.com/jamiepine/voicebox
项目入口或后续文档含英文,可用 Chrome 的“翻译成中文”辅助阅读。GitHub 和部分海外页面的访问情况因网络而异,打不开时需检查自己的网络条件。
参考来源
01VoiceBox 项目仓库(七个引擎、下载方式与平台说明)https://github.com/jamiepine/voicebox
02VoiceBox 官网https://voicebox.sh
03VoiceBox 使用文档https://docs.voicebox.sh
04Qwen3-TTS 语音模型(其中一个内置引擎)https://github.com/QwenLM/Qwen3-TTS
05MIT 许可证全文https://opensource.org/license/mit
如果这篇文章帮你少花一点时间看懂 AI 变化,欢迎关注公众号、设为星标,也可以转发给需要的人。
有想法也欢迎在评论区聊聊。点关注,不迷路;点亮星标,持续跟上 AI 工具变化。