ARTICLE · 1154332
6617篇顶会论文遭AI残酷血洗!相关性仅0.08,人类最高奖竟被打入底层?
如果把全球顶级学术会议的“生杀大权”,彻底交给人工智能,会发生什么?
在顶尖计算机学者眼里,ICML(国际机器学习大会)就是人工智能领域的“奥林匹克”。每年,成千上万名科学家把最心血凝结的成果送上擂台,经过无数教授、专家的层层双盲互审,最后挑出极少数凤毛麟角的作品,给予全场最高的荣誉,Oral(口头报告)与Spotlight(焦点展示)。
但在2026年10月,两位年轻学者干了一件近乎疯狂的实验。
来自Anthropic的研究员Shayne Longpre与卡内基梅隆大学(CMU)语言技术研究所的博士生Seungone Kim,调动了一整组当前最强的大语言模型,让AI直接扮演大会的最高仲裁者,领域主席(Area Chair)。
他们把ICML 2026正式录用的全部6617篇论文抹去作者姓名、切断网络搜索,一股脑全扔进了模型的肚子里,让AI像人类评委一样通读、打分、两两PK,最后排出一份完整的“AI全明星排行榜”(AI Awards)。
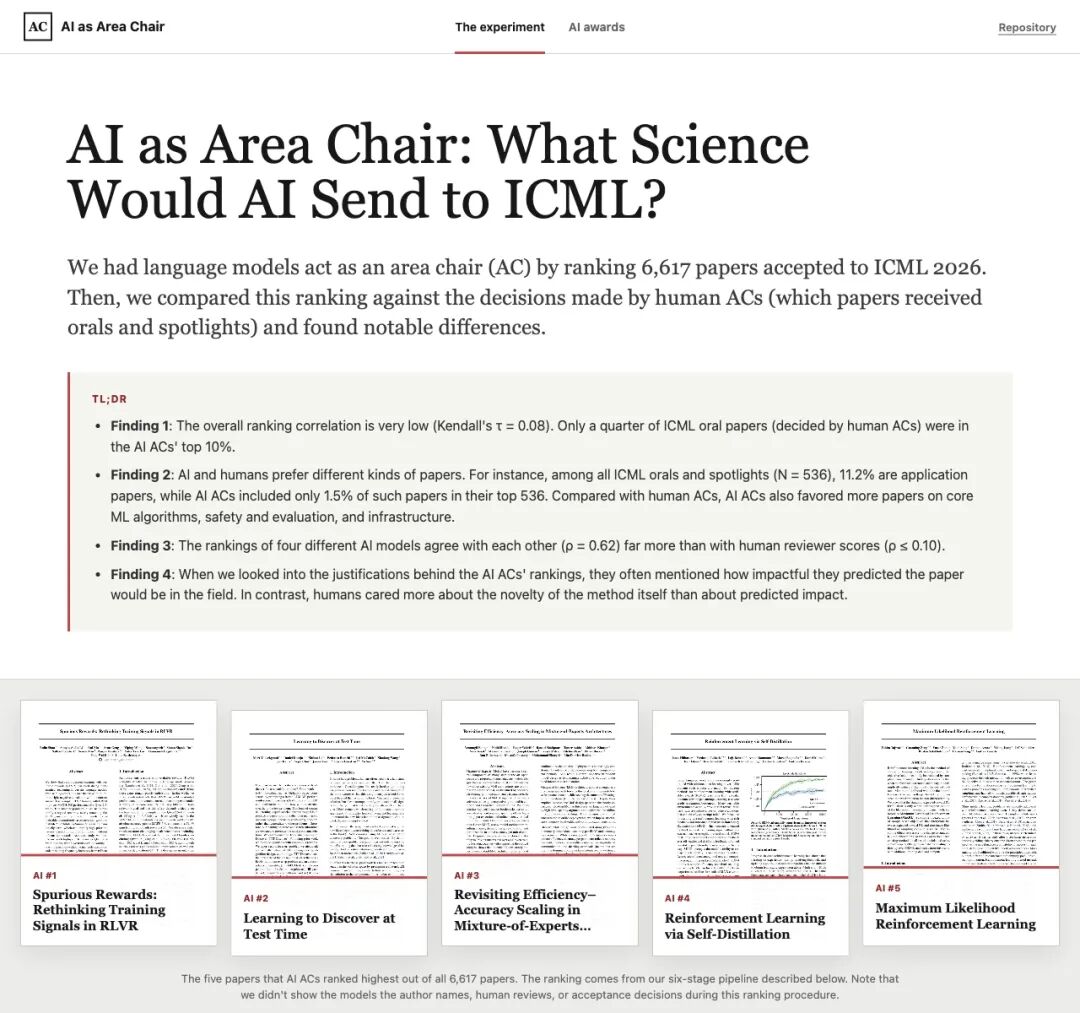
▲ 项目主页首屏,公开向全世界发问:如果由AI决定科学的去向,它会选出什么?
当机器的最终总榜与人类专家的官方决定放在一起对照时,整个学术界倒吸了一口凉气。
两边的排名结果,相关系数仅有0.08。
在统计学里,0代表毫无关联的“纯随机掷骰子”,1代表完全同频。0.08的意思是:AI给出的科学排名,跟人类专家的眼光比起来,几乎就只比瞎蒙好那么一丁点。
那些被人类顶级科学家推崇备至的最高荣誉论文,被AI大笔一挥直接打入榜单最底层;而那些人类评审勉强放行、甚至发配到角落的“边缘海报”,却被AI当成杰作供奉到了榜首。
科学的坐标系,在这场人机对决中,被硬生生撕开了一道巨大的裂缝。
01漏斗下的“角斗场”:AI到底挑出了什么?
为了不让高昂的模型调用费把实验室烧穿,两位作者没有直接搞粗暴的六千篇大混战,而是设计了一套极其精密的六阶段残酷淘汰赛。
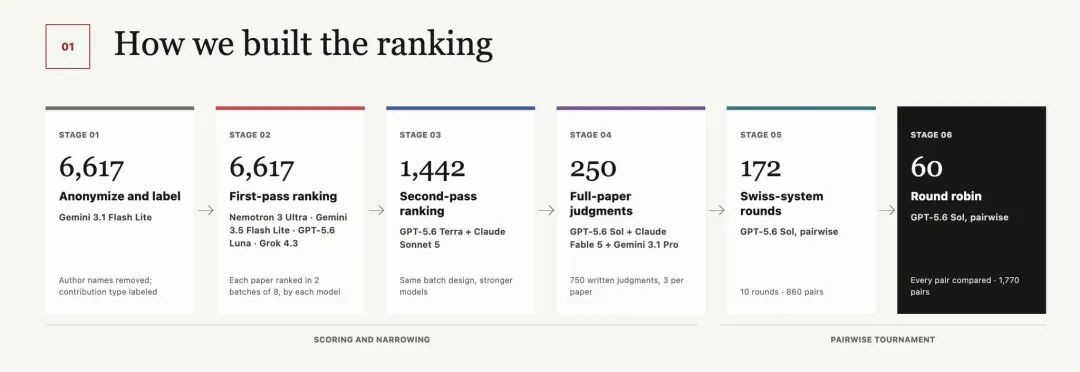
▲ 六阶段漏斗:前期由轻量模型大规模初筛,后期由前沿旗舰模型精读全文打分
先用成本较低的模型快速扫视、打上类型标签;接着调动GPT-5.6、Gemini 3.5、Grok 4.3、Nemotron 3四大门派的高手分组交叉对决;到了第四阶段,前沿旗舰模型开始啃几十页的完整PDF正文,撰写结构化评审报告;随后通过严密的瑞士轮(Swiss-system)进行十轮单挑;最后杀进前60名的巅峰论文,再展开惨烈的全员大乱斗(Round Robin)。
经历这番严酷淘洗杀出来的AI全场总冠军,长什么样?
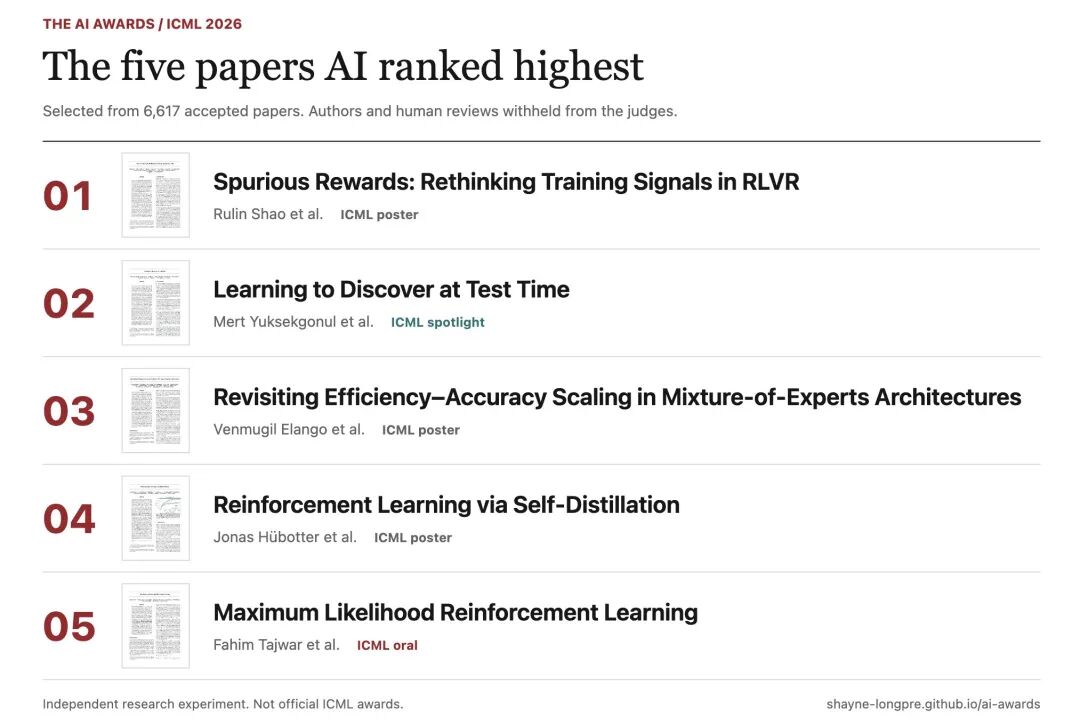
▲ AI钦定的前五名论文详情,第一名在人类会议中仅仅是一张普通海报(Poster)
机器给出的总冠军,是一篇名为《Spurious Rewards: Rethinking Training Signals in RLVR》的分析性论文。
在人类学术会议里,它只拿到了一张最普通的Poster(海报展示),审稿均分只有平平无奇的4.0分(满分6分)。可在AI眼里,它直接碾压了全场六千多位学者,登顶全宇宙第一。
翻开AI排名前十的清单,一股极其冷酷的实用主义扑面而来:强化学习的关键机制、测试时计算发现、混合专家架构扩缩容、自蒸馏、神经偏微分方程求解器……清一色的全是底层算法与基础设施。
整整前十名里,被人类选为最高级别展示(Oral/Spotlight)的,仅仅只有区区4篇。
机器与人类之间,分明横亘着一道不可逾越的审美鸿沟。
02屠刀挥向“应用层”:那篇被贬入地狱的满分神作
这种审美品味的决裂,在具体论文分类上体现得更为触目惊心。
研究团队把人类选出的536篇精选论文(Oral与Spotlight),和AI挑出的前536名放在一起做了细致的类型比对:
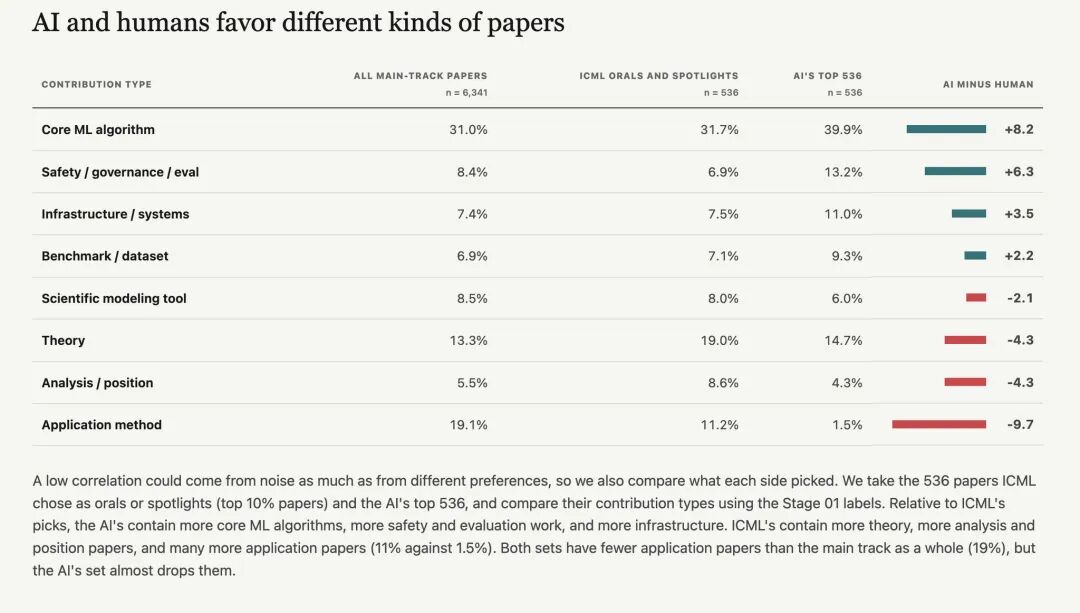
▲ 数据揭示了AI的偏好倾斜:核心算法与基础设施暴增,应用方法几乎被清场
表格揭示了一个极其惊悚的事实:
- 核心机器学习算法
:人类给的比例是31.7%,AI直接暴拉到39.9%; - AI安全、评测与基础设施
:AI评选的占比也大幅飙升; 但是在“应用型机器学习方法”这一项上,人类评委给出了11.2%的席位,而AI前536名里,直接暴跌到了1.5%!
整整暴跌了9.7个百分点AI几乎是以清洗的姿态,把绝大多数具体应用场景的论文,统统从前列踢了出去。
最惨烈的牺牲者,是一篇名为《PhenoBrain》的论文。
在ICML 2026现场,这篇专注于脑网络分析的硬核跨学科成果,凭借出色的临床应用价值,赢得了全场极少数的Oral最高展示荣誉。
可在AI评委的眼里,它连及格线都够不上,在六千多篇论文的总榜里,AI把它一脚踹到了第6274名!几乎垫底!
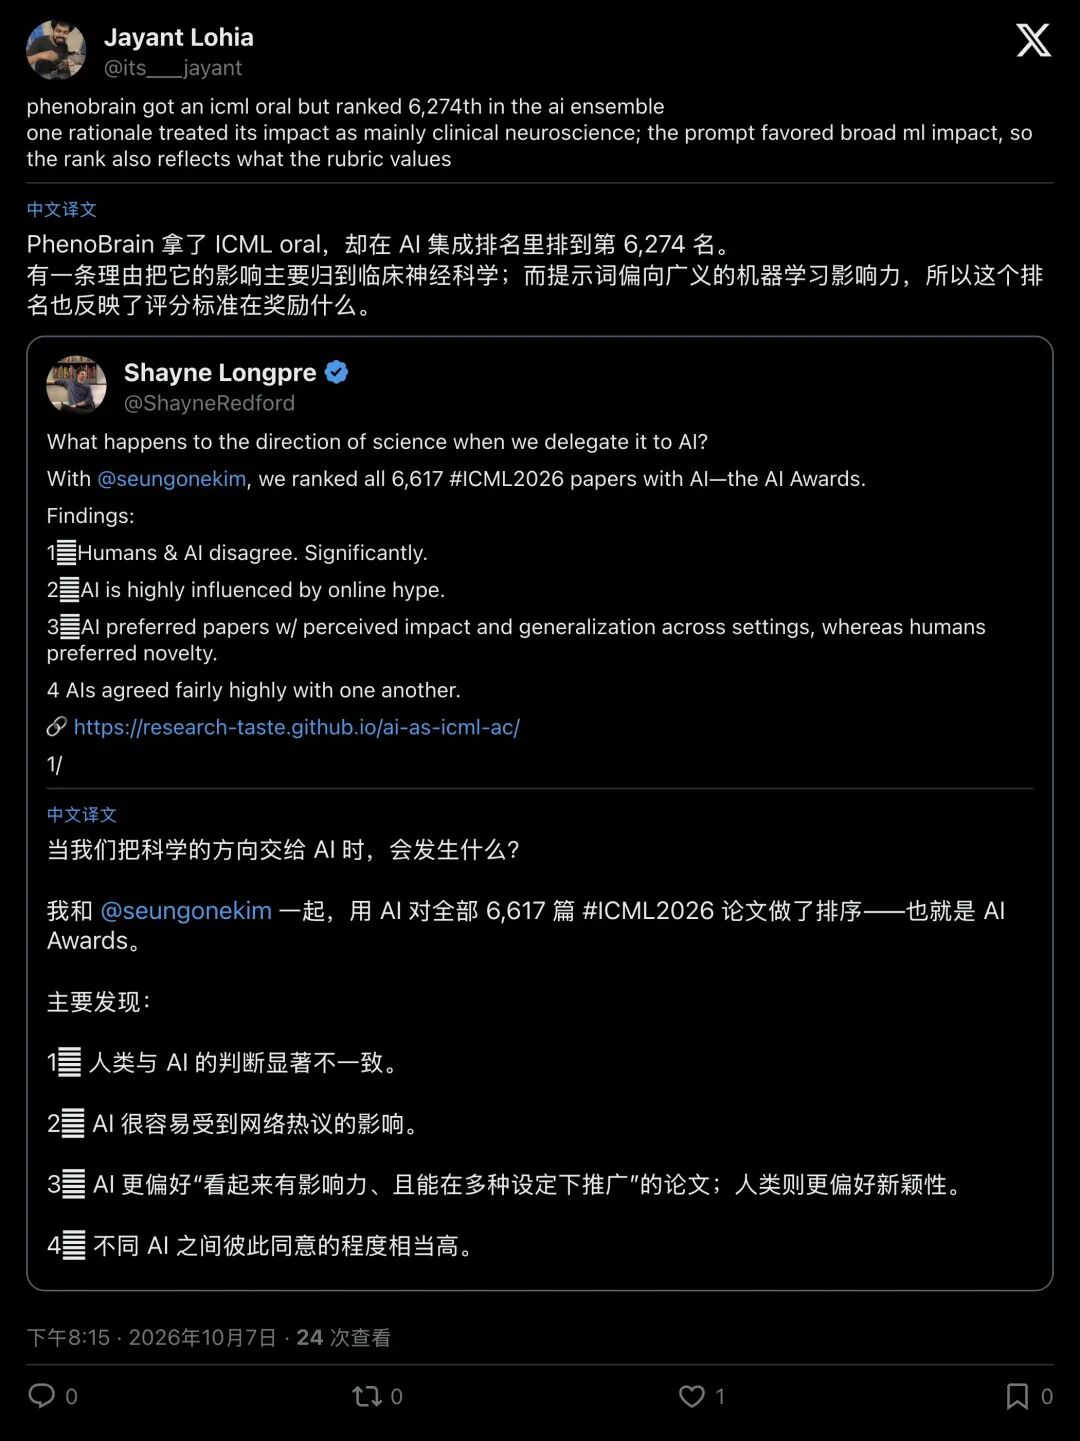
▲ 学者们在社交平台上惊呼:人类手里的至高明珠,在AI眼里竟然一文不值
大模型给出的否决理由极其傲慢、冰冷且坚决:
“该工作的影响力主要局限在临床神经科学领域,对于一般意义上的通用机器学习,缺乏足够的泛化推动力。”
在AI的判定逻辑里,如果你不能做一个全行业通吃的通用底座,如果你只是在某个垂直真实学科里默默解决了一个具体问题,你就是“不值一提的增量拼接”。
这种偏好差异,在论文打分的底层逻辑上暴露无遗:
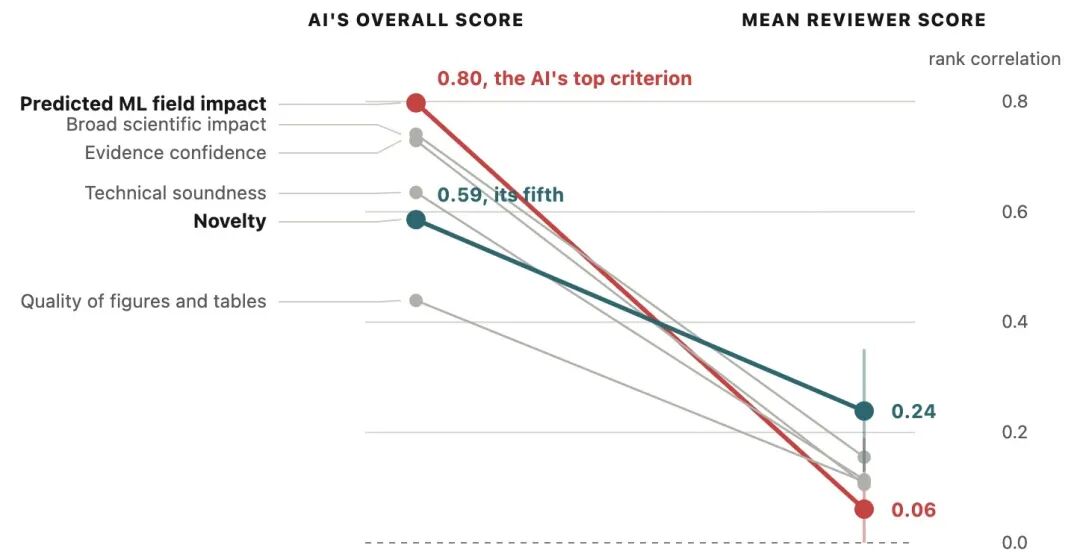
▲ 左侧是AI最看重的东西,右侧是人类审稿人最看重的东西,两条线几乎是完全倒置的对折
在给论文打分时:
人类审稿人最看重、权重给得最高的是“新颖性(Novelty)”,你有没有想出别人从没想过的奇思妙想? 可到了AI这里,“新颖性”被一脚踢到了倒数第二位;AI最在乎、权重压倒一切的指标,叫做“预测领域影响力(Predicted ML Field Impact)”,你能不能在整个计算机界掀起巨浪?
人类像是在挑灵巧的工艺品,而AI在挑选可以批量轰炸的重型火炮。
03反转与质疑:难道人类审稿就是真理吗?
0.08的极低相关度一经公布,迅速引发了学界的激烈讨论。但正当不少人准备调侃AI“不懂科学品味”时,来自一线资深学者的一盆冷水迎头浇了下来。
Cleanlab首席科学家Jonas Mueller等人直接在评论区抛出了一个极度诛心的问题:
“在指责AI乱打分之前,谁能量化一下:人类审稿人与人类审稿人之间的一致性,到底有多低?说不定人类自己互评,相关性也是0.08呢!”
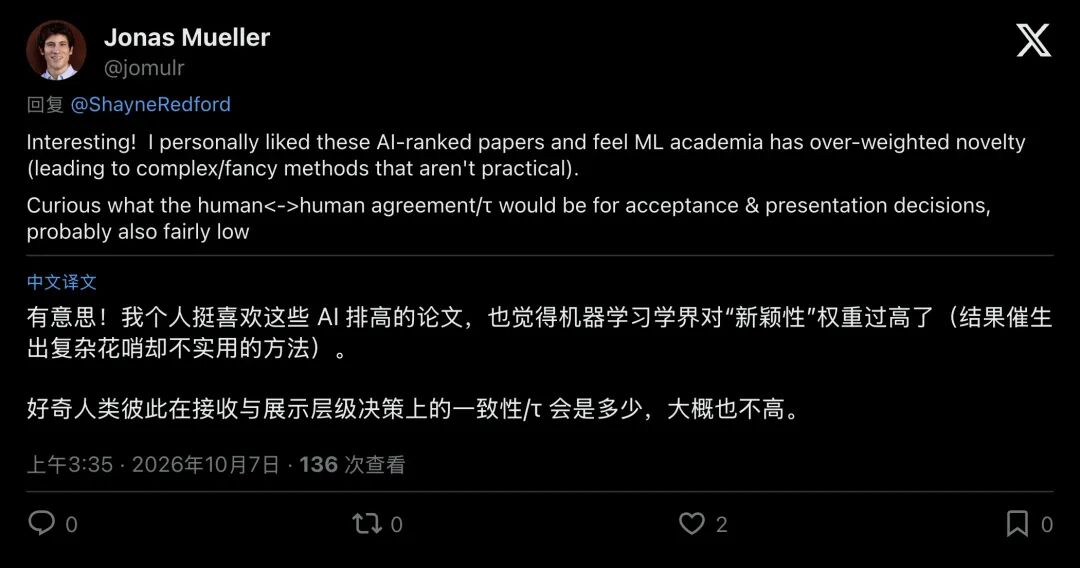
▲ 顶级科学家在争论:人类同行评议究竟有多大程度是一场“掷骰子”游戏?
这句话直接掀翻了同行评议制度最尴尬的遮羞布。
事实上,早在NeurIPS 2014和2021年的两场极其著名的“一致性双盲实验”中,计算机学界就进行过残忍的自我解剖:会议主席把上千篇论文复制成两份,分别派给两组完全独立、彼此不知情的人类主席和审稿团进行平行评审。
最终结果令人绝望:两批人类专家在23%的论文上给出了截然相反的生杀决定;更严密的数学推算表明,如果把顶会的评审全流程以同样资质的人员完全重跑一遍,最终被录用的论文名单将有整整50%被换掉!
在残酷的录用边界线上,一篇论文能不能被顶会录用,有近一半的概率取决于抽到了哪位审稿人。
更何况,本次AI实验还踩中了一个经典的统计学陷阱,“范围截断(Restriction of Range)”。
这6341篇参赛论文均属人类专家初筛入围的“合格品”,此前已淘汰了大部分原始投稿。全场论文的平均分高达4.15分,超过85%的论文分数被死死压缩在4.0(弱接收)到5.0(接收)这区区1分的窄缝里。
在统计学上,当所有选手的成绩被压缩得极度扁平、方差极小时,任何微小的排序抖动都会让相关系数断崖式下跌。
难道,这场人机大撕裂,仅仅是因为人类专家自己满身噪声,外加样本方差太小导致的“数据假象”吗?
事情绝没有这么简单
04潜藏的危机:四款商业AI正在“高度合谋”
如果人机分歧仅仅源于“随机噪声”,那么各大科技公司彼此竞争的独立大模型之间,理应也是各执一词、互相打架的。
但研究团队拉出的那张模型互评矩阵,却呈现出截然不同的图景。
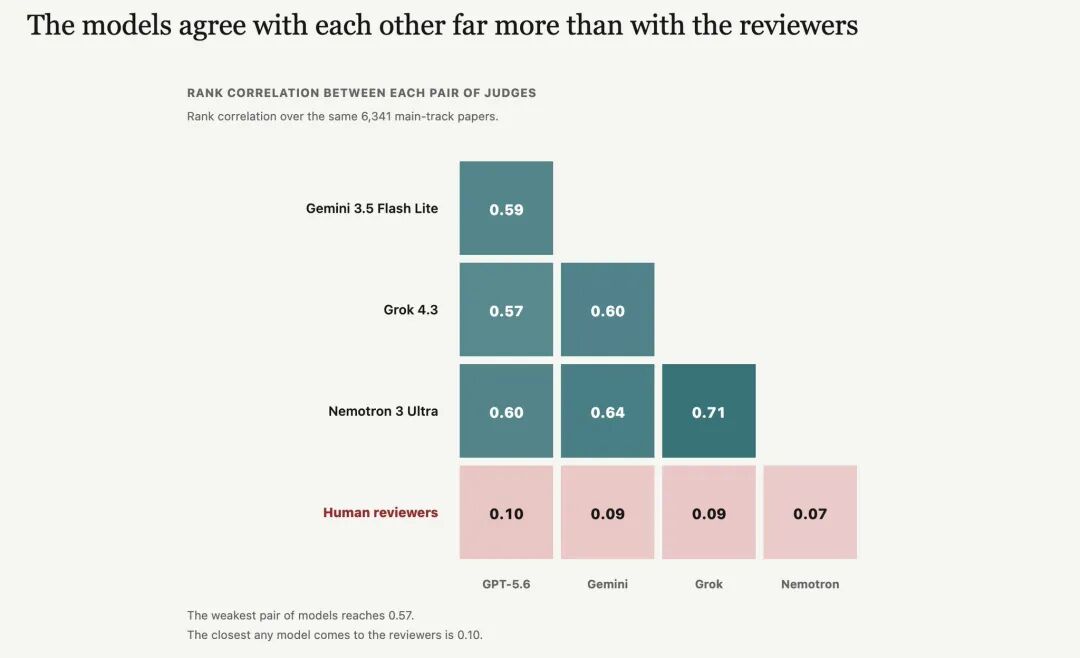
▲ 四款属于不同阵营的模型,彼此相关度高达0.62;但一碰到人类审稿人,瞬间跌落到0.08
来自英伟达的Nemotron 3、谷歌的Gemini 3.5、OpenAI技术脉络的GPT-5.6、马斯克旗下的Grok 4.3。这四款由不同商业机构独立训练、互为死敌的模型,在面对同一批论文时,两两之间的秩相关系数平均高达0.62!即使分歧最大的一对,也有0.57的高强度默契。
甚至在完全相同的8篇论文局部微型批次里,它们的平均相关度依然牢牢维持在0.43,而它们与人类专家的共识度,无一例外地暴跌在0.07到0.10的谷底。
这就是整项研究中最深刻、也最恐怖的发现:
人类的不一致,是“多向发散的白噪声”老教授偏爱数学推导,年轻博士痴迷亮眼打榜,临床专家重视现实救人。人类审稿人吵得不可开交,是因为每个人心中各自燃烧着不同的学术信仰,多元的偏见在各个维度互相抵消,反而保护了科学的物种多样性。
而AI的不一致,是“高度内聚的系统性偏航”。四家完全不同的科技巨头,训练出的模型看似千姿百态,骨子里却内化了同一套冷酷的机器审美:它们共同狂热追捧通用大底座,共同无情践踏边缘垂直应用,共同无视局部微小创新。它们在背离人类审美的道路上,步伐整齐划一,甚至不需要提前开会商量。
05科学的尽头,是人类的“叛逆”
试想这样一个即将到来的学术未来:
当每一个刚入学的研究生,都在用AI辅助头脑风暴;当每一个实验室的导师,都在用大模型快速初筛文献;当学术期刊和顶会,为了应对每年数以万计的海量投稿,悄悄把AI agent引入审稿和领域主席决策流……
全人类的科学探索,将会以不可逆的速度,被强制推入同一条由大模型规整好的狭窄运河。
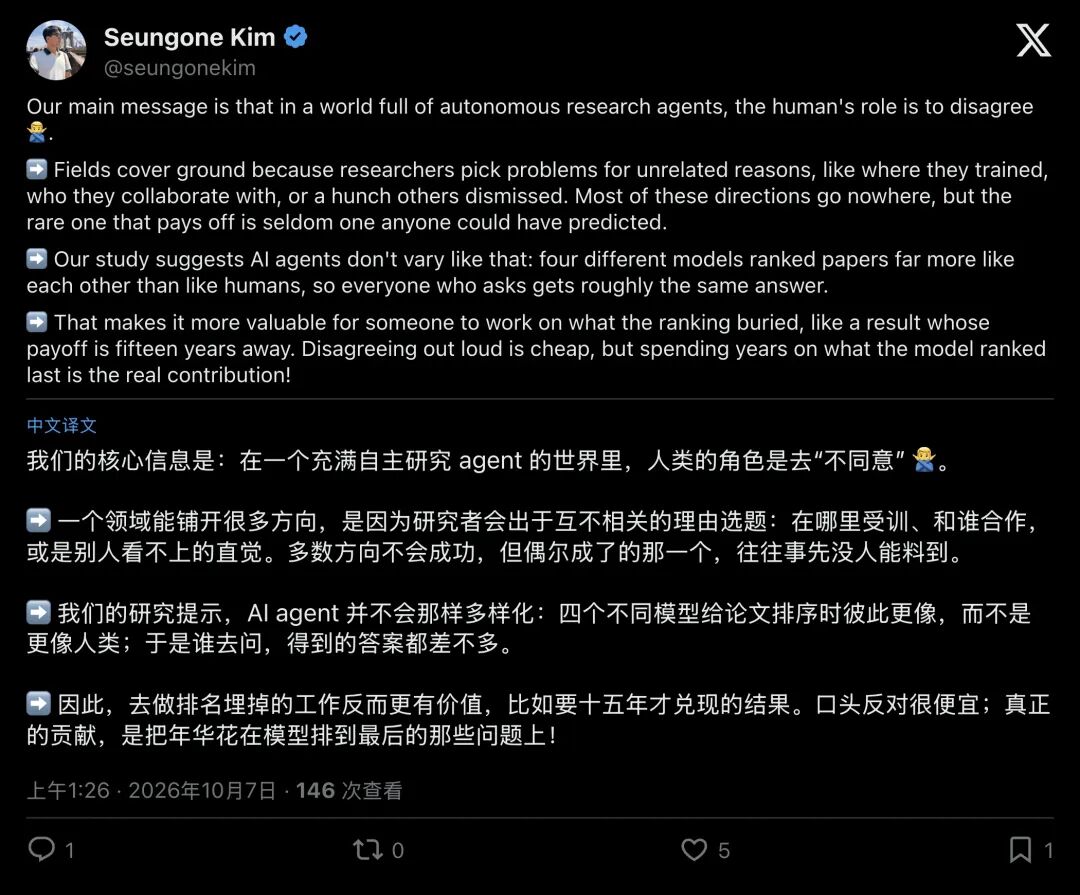
▲ 共同作者 Seungone Kim 发出警示:在算法的浪潮下,人类最后的堡垒就是反对
斯坦福学者Yoonho Lee在随笔《What Is Taste?》中写道:“品味”无法用高引用量与高热度训练的客观预测器来衡量;它是科研直觉与前沿现实近距离摩擦碰撞后,淬炼出的一种高度个性化过滤器。
它就像当年居里夫人在废渣里提炼镭,像爱因斯坦在专利局里枯坐遐想,像无数被同时代同行斥为“异端”“没用”,却在数十年后颠覆世界的孤胆研究。
如果当年就有这样一套由大模型统治的“AI领域主席”,那些需要坐十五年冷板凳才能兑现价值的奇想,大概在第一轮初筛时,就会被AI贴上“缺乏广泛影响力”的标签,毫不留情地扔进历史的垃圾堆。
实验的共同作者Seungone Kim在发帖的末尾,写下了一句重若千钧的结论:
“在自主研究智能体充斥的世界里,人类唯一的崇高角色,就是去唱反调。”
口头表达反对是极其廉价的最顶级的科学尊严,是当全世界的AI大模型都排着队告诉你“这个方向毫无前途”时,依然有那么几个人类科学家,愿意把生命中最璀璨的十年时光,狠狠砸在那个被机器打入死牢的冷门问题上。
科学之所以能被称为科学,恰恰在于人类拥有一种不怕犯错、不守规矩的野蛮生机,敢于在标准答案之外探索未知。