ARTICLE · 1154327
Trident 源码精读:检索器偏心文本,怎么掰?
OpenBMB 发现混合语料里无关文本会压过相关图片,Trident 用三个等权视图和多样本 InfoNCE 纠偏。训练和评测代码今天放出。
Trident 源码精读:检索器偏心文本,怎么掰?
同一个语义,检索器给文本表示打的分总比图片高。无关文本排在相关图片前面。Trident 修这个偏置。
论文|Chaos in the Text: Revealing the Modality Preference in Mixed-Modality Retrievers 作者 / 机构|OpenBMB 论文地址|https://arxiv.org/abs/2610.11816[1]代码地址|https://github.com/OpenBMB/Trident[2]代码日期|仓库创建于 2026-10-08,训练和评测代码 2026-10-10 放出,MIT 许可证
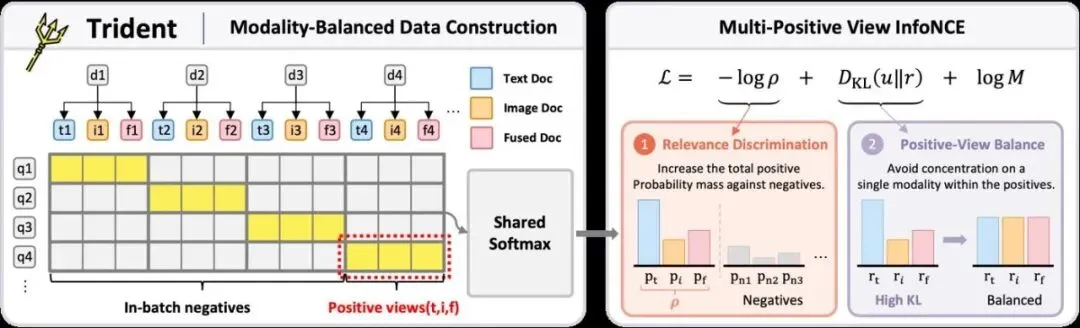
Figure 5. Trident.
01 / 先看结论
解决了什么: 真实语库里纯文本、纯图片、图文混排都有。密集检索器在这种混合里掉得很厉害。 改了什么: 每个文档配三个平权正视图——Text、Image、Fused,再用 Multi-Positive View InfoNCE 训练。 停在哪里: README 说 data 和模型 checkpoint "coming soon"。现在放的是训练脚本、configs 和 Origin/Mix 评测管线。
先看 README 的 Overview,再进 figs/fig1_teaser.png 和 figs/fig5_method.png。
02 / 问题背景
纯文本库和纯图片库里,检索器都不差。一旦把图片文档逐个换成对应的文字版,NDCG@10 掉得很快,语库变成文本主导后才部分回升。README 把这个现象叫 Chaos in the Text。
更直接的一条:无关文本对结果的伤害,比同等数量的无关图片大。语义等价时,检索器给文本的相似度分数系统性偏高。这就是 Modality preference。
检索器为什么会偏心文本,以及训练时怎么把这个偏好拉平?
03 / 方法拆解
Trident 两个动作。
设计一,模态均衡的数据构造。每个文档三个正视图:Text 是详细描述,Image 是原图,Fused 是一句短摘要加图。三个视图地位相等,不分主次。
设计二,Multi-Positive View InfoNCE。所有正视图互为正样本,批内其余样本全部当负样本。损失的具体形式要看训练代码,README 只给到这里。
README 里还有 Table 1(视觉文档检索)和 Table 4(自然图像检索,附录 F)两个评测位,以及单独的消融小节。数字都在仓库自己的表格里,我没有跑。
04 / 源码对照
README.md → configs/ → 训练脚本 → Origin / Mix 评测管线 → 数据与 checkpoint(待放出)News 一节写着:2026-10-10 放出训练与评测代码,包括 configs、训练脚本和 Origin/Mix 管线。data 和 checkpoints 标注 coming soon。也就是说,今天克隆仓库能跑训练入口,但没有官方数据和权重。
README 列了 Important parameters 小节和 Repository Structure 小节。我没有逐个打开配置文件核对默认值。
评测分 Origin 和 Mix 两套。混着跑会把「原始语库」和「混合语库」的数字搅在一起。
05 / 实验配置
README 给出的评测框架:
Table 1:视觉文档检索。 Table 4:自然图像检索,附录 F。 消融和进一步分析单列。 Important parameters 单列一节。
具体的训练步数、学习率、batch size,README 摘要里没有给全,要看 configs 目录。我没有跑,不编数字。
06 / 结果怎么看
README 的 Overview 只描述了现象(NDCG@10 掉、部分回升、文本分数偏高),具体提升数字在 Table 1 和 Table 4 里,我没有打开核对着抄。
我能从摘要确认的是两件事:混文本引起的下降是论文的核心观察;Trident 的三视图加多样本 InfoNCE 是应对方案。效果数字以仓库表格为准。
Chaos 现象的描述和 Trident 的效果是两组数字,前者来自诊断实验,后者来自对比实验。
07 / 论文与代码
论文链接 arXiv:2610.11816,README 徽章可点。方法图 figs/fig5_method.png、teaser 图 figs/fig1_teaser.png 都在仓库里。
代码放出、数据未放出,是今天这个时点最要紧的差别。想直接复现论文数字,还得等 checkpoint。
08 / 复现路线
克隆仓库,装环境(README 有 Requirements 一节)。训练脚本能跑起来,但没有官方数据,先要按 Data Preparation 自己构造。跑通的标志是 Origin 和 Mix 两条评测管线都能出 NDCG@10。
最容易踩的坑:数据没放出就以为仓库缺了东西。News 一节写明 coming soon,不是遗漏。
09 / 判断
这篇的价值在诊断那半:无关文本比无关图片更伤检索,文本表示的相似度系统性偏高。三视图训练是顺着诊断给的药。
数据没放出来之前,训练管线只能算可跑,不能算可复现。等 checkpoint 到了再看数字。
参考资料
[1] 论文 https://arxiv.org/abs/2610.11816[3]
[2] 代码 https://github.com/OpenBMB/Trident[4]
[3] 图 figs/fig1_teaser.png figs/fig5_method.png
引用链接
[1]https://arxiv.org/abs/2610.11816
[2]https://github.com/OpenBMB/Trident
[3]https://arxiv.org/abs/2610.11816
[4]https://github.com/OpenBMB/Trident