ARTICLE · 1155441
AI工具推荐 - AIHOT 月活百万的AI热点站整套开源了,每个行业都有自己的 Aihot 了
CRITERION READOUT · 判据读表
07 OCT 2026
AIHOT 月活百万的AI热点站整套开源了,每个行业都有自己的 AIHOT 了
AIHOT 把采集流程、精选评分、聚簇机制连生产环境的全部 Prompt 一起开源了。它真正给出的不是代码,是「什么才算热点」这套答案——而门槛在于,那 168 个信源和一次评分校准,得你自己填。
📄 约 3,532 字 ⏱ 阅读约 9 分钟
READOUT 01–07 · 正文 4 图 · 0–100 标尺
月活百万的AI热点站(AIHOT)整套开源了。
采集流程、精选评分、聚簇机制,连生产环境里跑的全部 Prompt,一样没留。更让我意外的是他后面那句——他不太看得懂代码。
他叫卡兹克,这个站叫 AIHOT,线上跑在 aihot.news。
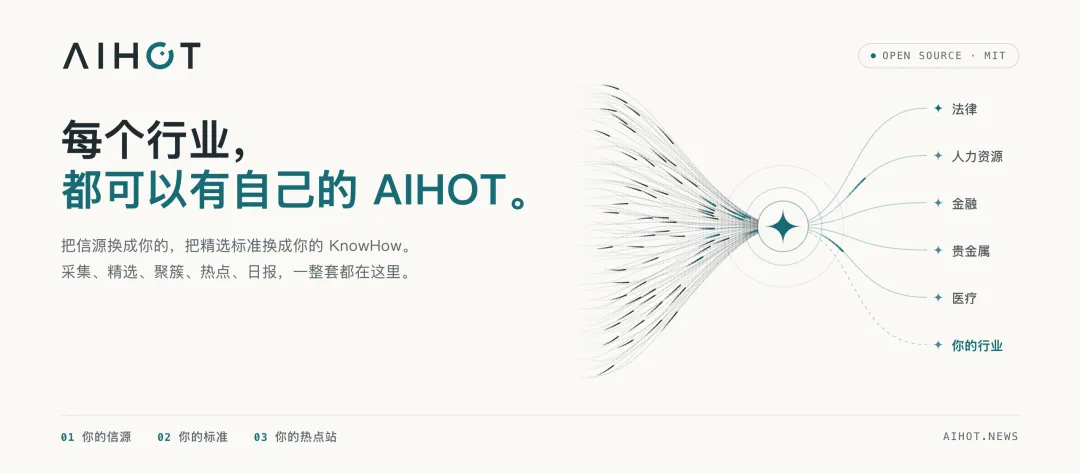
每个行业,都可以有自己的 AIHOT
READOUT 01
WHAT SHIPPED
他开源的东西,比「代码」多得多
先把仓库里有什么说清楚。
它不是一个网站模板,是一整套引擎:网站、后台、精选流程、事件聚簇和热度算法,还有所有提示词的原文,以及每一级信源的入选门槛。你平时看到的「首页推荐了哪几条、为什么是这几条」,背后那套判断依据,这次是摊开的。
技术栈不复杂。Node.js 24、TypeScript、React Router 做服务端渲染、Fastify、PostgreSQL,全部塞进 Docker Compose。MIT 协议,仓库在 github.com/KKKKhazix/AIHOT,一条 docker compose up -d --build 就能在本地跑起来。
但它没有给你全部。
仓库里带的信源,是 18 个公开的海外 AI 资讯源,够你跑起来看效果。线上那个站用的是 168 个信源,按官方一手、官方账号与准官方、媒体与个人分成三级——这份名单,他没放出来。
理由说得也挺坦然:一是怕引起争议,二是别的行业拿去确实没什么用。
还有个细节我挺喜欢。他专门写了一句:请不要用 AIHOT 的名字和 Logo。换上你自己的名字,它就是你的站。
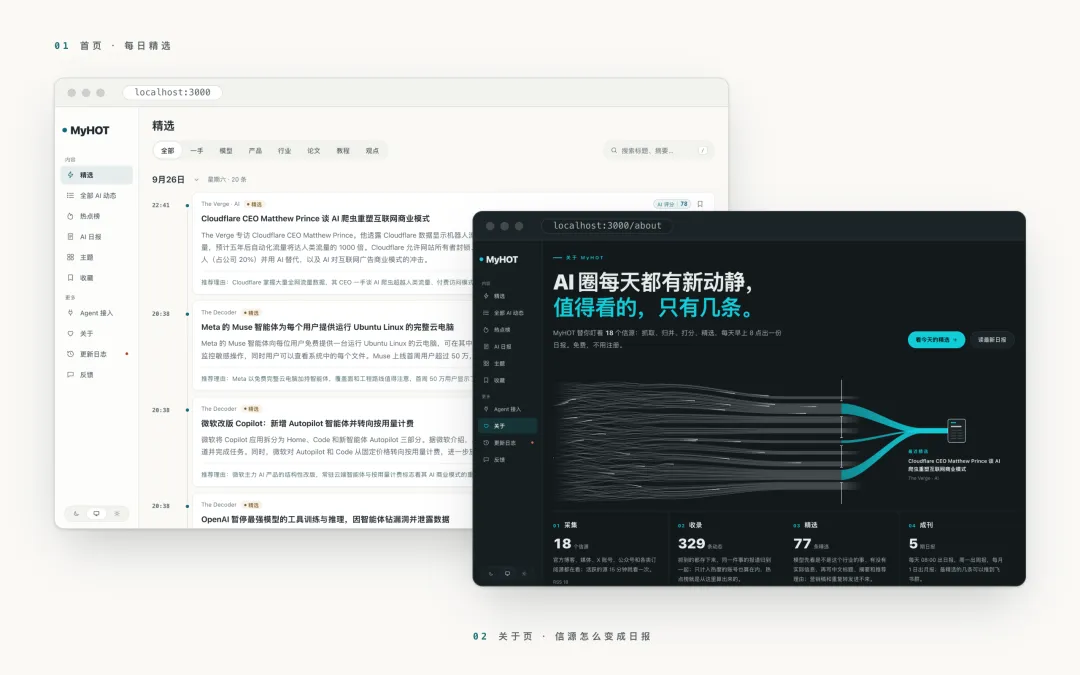
本地跑起来长什么样:MyHOT 的每日精选与关于页
READOUT 02
THE REAL PAIN
他要解决的,其实不是「找不到资讯」
如果只是信息聚合,这事没什么新鲜的,RSS 阅读器二十年前就干了。
真正难受的是另一件事。
同一件事,官网发一篇,媒体转十篇,社交平台上再吵一天。你打开任何一个信息流,看到的都是同一件事的十个版本。看起来热度很高,其实只有一个信息源在说话。再加上营销稿和二手转述,你要花在「这条到底值不值得看」上的判断力,比读完一条新闻本身还多。
AIHOT 想干的就是这件事:先替你判断,再替你排掉重复。
它的目标用户写得很直白——那些需要盯住自己行业动态的人。做法律的朋友,做 HR 的朋友,做金融的,做贵金属的。还有一位生物制药行业的工艺开发工程师,在公开留言里问,能不能给主题板块加一个生命科学领域。
这些行业我都不懂,卡兹克自己也不懂。他的原话是:我不懂你们的行业,不知道你们该看哪些信源,也不知道什么样的消息对你们来说才叫热点。
但你们懂。
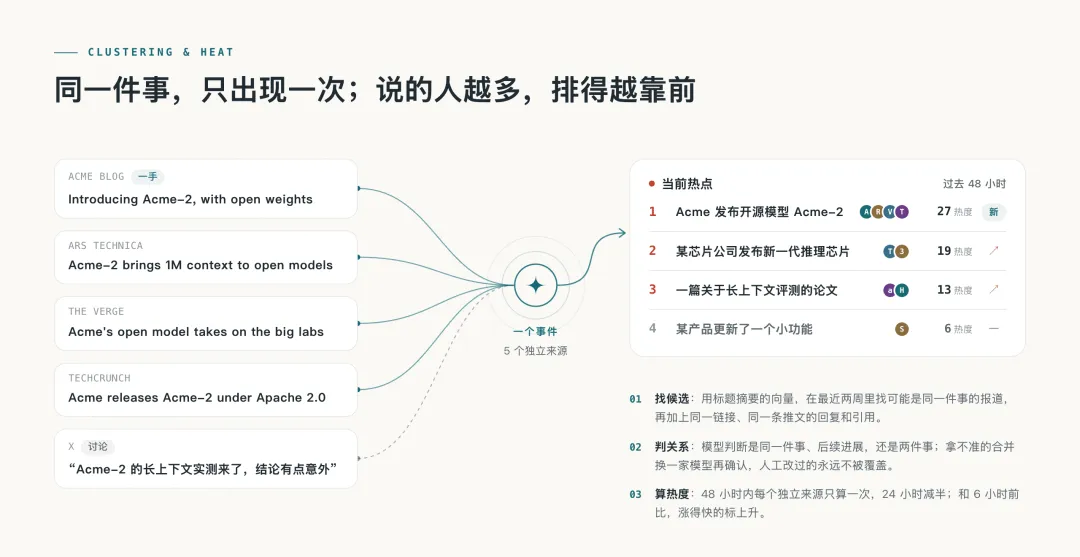
同一件事只出现一次;说的人越多,排得越靠前
READOUT 03
SCORING RULE
同一份标准打两次分,热度按事件算
接下来是这篇里我觉得最硬的部分。
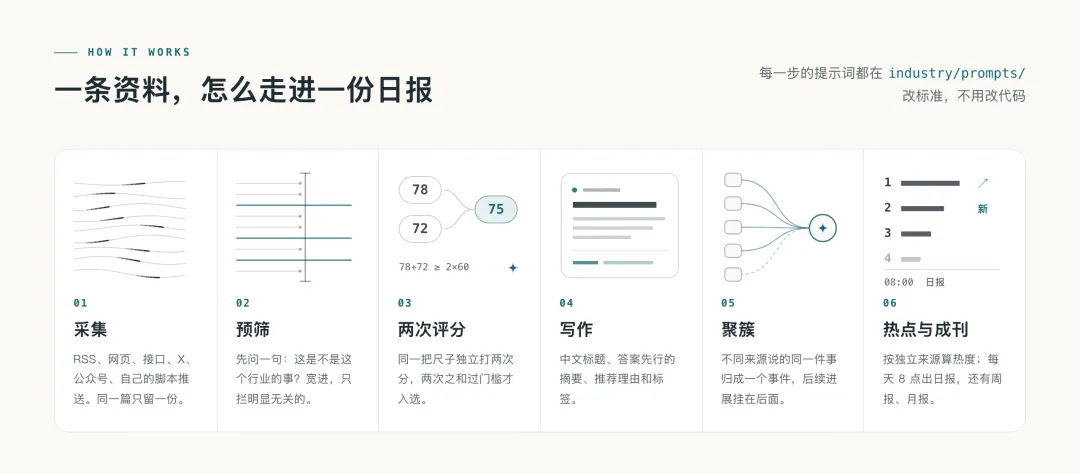
一条资料,怎么走进一份日报:采集、预筛、两次评分、写作、聚簇、成稿
它判断「这条值不值得推」,不是打分一次就完事。一条资料进来,先判重,再预筛一遍——这一步刻意用便宜的模型,控制成本。然后,可能重要的那些,用同一份评分标准,独立打两次分,都是 0 到 100。
两次加起来的分数,要达到门槛的两倍,才算够分。
而且门槛不是一个,是按信源分级来的:
THRESHOLD / 0–100
BY SOURCE TIER
官方一手信源
60 分
官方账号与准官方
65 分
媒体与个人
76 分
官方的原文门槛低一些,媒体和个人的说法要求就严一些——同一件事,当然是官方自己发的更值得先看。分数够了还不算完,还得过一道去重的关,跟已入选的新闻重复的,照样进不来。
然后是聚簇。
最关键的地方在于,它的热度不是按文章算的,是按事件算。四十八小时之内,每一个独立来源只算一次;超过二十四小时,权重减半。
这一条直接把「热度」的水分挤掉了。重复抓取不会多算,一家媒体发十篇也只算一次,所以排在前面的,是真的有很多人在说的事。同一件事被聚成一个事件之后,后续进展挂在同一个事件下面,不用你自己去拼时间线。
日报是每天早八点出的,覆盖前一天早八点到当天早八点。这里有个我觉得很聪明的决定:日报按规则编排,不调用模型。也就是说,哪条上头条、哪条进快讯,是规则算出来的,不是模型临时发挥的。
周报和月报从日报里汇编,模型只负责写总述和栏目的导读,不许增删条目。它要是写出了条目里没有的名字或数字,那段话直接不用。
做内容的人应该能感觉到,这几条规定卡的都是同一个毛病——别让模型自己加戏。
READOUT 04
COST GUARD
连「别重复花一次钱」这种事,它都做了
还有两个设计,我觉得比功能列表更能说明作者的态度。
第一个是付费请求的回执。
这套流程里,模型调用、翻译、抓取 X 和微信上的内容,全是按次付费的。麻烦在于,任务可能重试,进程可能重启——如果不管,同一件事会被反复付费。
它的做法是:每个付费请求先记一张回执,拿到结果先存下来再用。进程重启、任务重试的时候,直接复用已经付过钱的结果,不重复花钱。
还有一种更麻烦的情况:请求发出去了,但结果没拿到,也不知道到底成没成。这种「结果不明」的回执,超过三十分钟会自动放行一次,让它重试。
这个细节很小,但做过类似系统的人应该知道,它其实是在跟一个很现实的问题较劲——管道跑一夜,第二天醒来账单比你预期的多十倍。
第二个是安全阀。
它给采集、模型调用、推送这些动作各留了一个开关,默认是关的,只有显式设成 true 才会打开。
关键在于,这些开关只决定「发不发出去」,不决定走哪套逻辑。也就是说,你把开关关掉,流程照样跑,只是不外发。
这个设计让本地调试变得很安全——你可以把整条链路跑通,而不用担心它真的去调用付费接口、或者往你不想发的地方推东西。
顺便说一句,仓库里的代码和线上那个站跑的是同一份引擎。
作者说同步的时候是直接从线上导出的,不是另外精心打磨了一个通用版本。好处是你拿到的是真正在生产里跑过的东西;代价是里面难免有只对 AI 行业有意义的历史包袱,他也坦白说了,有些功能永远只留在线上。
READOUT 05
WHY SO LATE
他憋了半年才敢开源
这件事里我最喜欢的一段,跟代码没关系。
卡兹克说他早就有开源的想法,但拖了很久。不是舍不得,是没脸。
他说之前的 AIHOT 就是一个大型的屎山:改了这个地方,另一个地方就出 bug;改个模型榜,热点榜不知道怎么崩了。每天弹一堆告警和报错,早上醒来第一件事是提心吊胆地看那个群有没有十几条未读。
所以这样的东西,他怎么敢开源。
一直拖到今年中秋,他有了三天几乎不用出门的假期,才下决心重写。重写的过程我看了,方法比结果有意思。
他没有让 AI 直接去读旧代码库。理由是——那些模型再强,一旦读了历史代码,也会被屎山带偏,重构出来的东西是不彻底、不完整的。所以他换了个思路,回到最原始的地方:没人关心代码怎么写的,大家要的只是功能准确、体验够好、速度够快。
于是他把整个旧代码库蒸馏成一份解耦的功能文档,再让模型出一份交接包。同一件事,他让另一个模型再干一遍,把文档和交接包做得更合理一点。交叉审完之后,才开始开发。
我自己也踩过这个坑。手里有一坨自己都不想看的旧代码时,最诱人的选择就是让 AI 直接吞下去改,结果经常是它连旧代码的毛病一起继承了过来。先写文档、再动代码,听起来慢,但它是唯一不把旧账带进新账的办法。
READOUT 06
WHAT IS MISSING
真正难的,是那 168 个信源和一次校准
前面说的都是它给的东西,这一节说它没给的。
第一,信源要你自己建。仓库只带 18 个示范源,真实的 168 个没开源,换个行业等于从零开始搭信源池。这件事听起来简单,做起来很磨人。
有位从业二十五年的游戏媒体人,照着这个框架搭了个游戏版的日报站,每天抓全球一百多家游戏媒体的新闻。他一行代码没写,需求丢给 AI 就搭出来了。但他后来在公开留言里说,自己正在跟百分之七十二失效的信源死磕。
我觉得这句话比任何功能列表都真实。做这类站,最耗人的从来不是模型,是那些悄无声息就死掉的源。
第二,评分标准要你自己校准。这才是真正的门槛。官方的建议很直接:拿一两百条你自己标注过的资料,跑一遍评测脚本,看它选得准不准,再回去改评分标准和门槛。先改标准,再动门槛,每改一次跑一遍。
这一步没有捷径。你偷懒,它就选不准;它选不准,这个站对你就是没用的。
第三,成本是持续的。官方实测过:第一次导入 152 条资料,一共用了大约 930 次模型调用。线上的运行成本,一周大约五十八块九,主要花在评分和翻译上。
这个数字不算高,但它是线性的——信源越多、更新越频繁,账单一路上涨。项目给每一级付费服务都设了调用上限和预算熔断,不会一夜之间刷爆账单,但它改变不了这个成本结构。
第四,部署确实有门槛。中国大陆的服务器抓海外信源会失败,得单独配一个出口代理,而且只走抓取、不走模型接口。对外提供网站服务,要先完成 ICP 备案。
升级也不是拉一下代码就完事:先备份,构建完停下旧服务,跑迁移,再启动。停任务进程的时候至少要给足 210 秒,让正在进行的付费调用收尾——被提前杀掉的调用结果不明,要等半小时才会重试。
它也没有正式的 Release,只能跟主分支走,跨版本升级照样可能碰到破坏性的数据迁移。
第五,有些东西它永远不给。模型榜、重置监控、主题页大事记这些只对 AI 行业有意义的功能,还有它自己的运营工具,都留在线上,不在开源范围里。作者也写明了:以后线上的更新他会尽量同步过来,但没法保证每一次都同步。
READOUT 07
VERDICT
我的评价是
先说结论:这不是一个开箱即用的产品,是一份可以自己接管的判断标准。
所以适合谁,我想得挺清楚。
如果你想给某个垂直行业做一个资讯监控站,法律、HR、金融、医药、游戏都行,它给的是一套已经跑通的完整骨架——你省掉的不是写代码的时间,是自己踩一遍流程设计、去重、聚类的坑的时间。
如果你关心的是「怎么用大模型做内容筛选」这件事本身,那这套双评分加分级门槛、外加一个校准流程的做法,值得单独拆下来研究。它最有价值的地方不在代码里,在那份评分标准怎么写。
如果你只是想读 AI 资讯,那不需要自己搭,线上站可以直接用,公开接口、RSS、MCP 都是现成的。
至于我被什么东西打动的。
不是它开源的代码量,也不是那个百万月活。
是它把「什么才算热点」这件事的答案也一并交了出来。
你可以不同意它的判断——官方都说了,这套门槛偏严,宁可少选几条也不让噪声进来,换行业一定要重新校准。但一个人愿意把自己攒下来的判断标准,连同写标准的 Prompt 一起摊开给你看,这件事本身就很少见。
THE POINT
他交出去的不是代码,是判断。
评论里还有一句话我印象很深。他说,既然没办法满足所有人,那不如把火种交到大家自己手上。
所以这篇的结尾不是「快去用」。
是——如果你也有一个自己行业的资讯需求,去看一眼它怎么做的。把仓库丢给你的 Agent,让它把信源换成你自己的,把精选标准换成你自己那套,剩下的交给时间。
项目地址再放一次:github.com/KKKKhazix/AIHOT
线上站在 aihot.news,一条 Docker 命令就能在本地跑起来,不用担心把电脑搞乱。
THE END
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
AI实用talk
/ 作者:Patrick
/ 这里分享好用的AI工具和skill
/ 创作不易,三连支持一下吧~