ARTICLE · 1158473
自我改进的软件,终将到来
摘要: AI 已经能写代码,生产环境里的反馈却仍靠人搬运。Boris Tane 主张把运行信号接回 Agent,让软件持续改进;人的职责则转向定义目标、约束与取舍。
本文编译自 Boris Tane 的「Self-improving software is inevitable」,原文发表于 2026 年 10 月 10 日。文中的第一人称指原作者,编译补充另行标明。
你今天早上发布的版本,已经暴露了自身的问题。它一整天都在通过不同渠道告诉你哪里出了错。生产环境之所以还在出问题,唯一的原因就是你。
如今,绝大多数软件已经由 Agent(智能体)编写。它们能在你的咖啡凉掉之前,一次生成一个应用,把它部署上线,再接好可观测性工具,用来查看它的运行状况。
但这是一条单行道。Agent 产出更多软件,软件产生更多信号,而这些信号几乎没有回到 Agent 手里。把数据手动送回 Agent 的,仍然是我们。
编译注: 原文未给出「绝大多数软件」的统计口径。一次生成、部署并接好工具的描述,也没有附上具体应用、测试结果或成功率;此处保留的是作者对能力现状的概括。
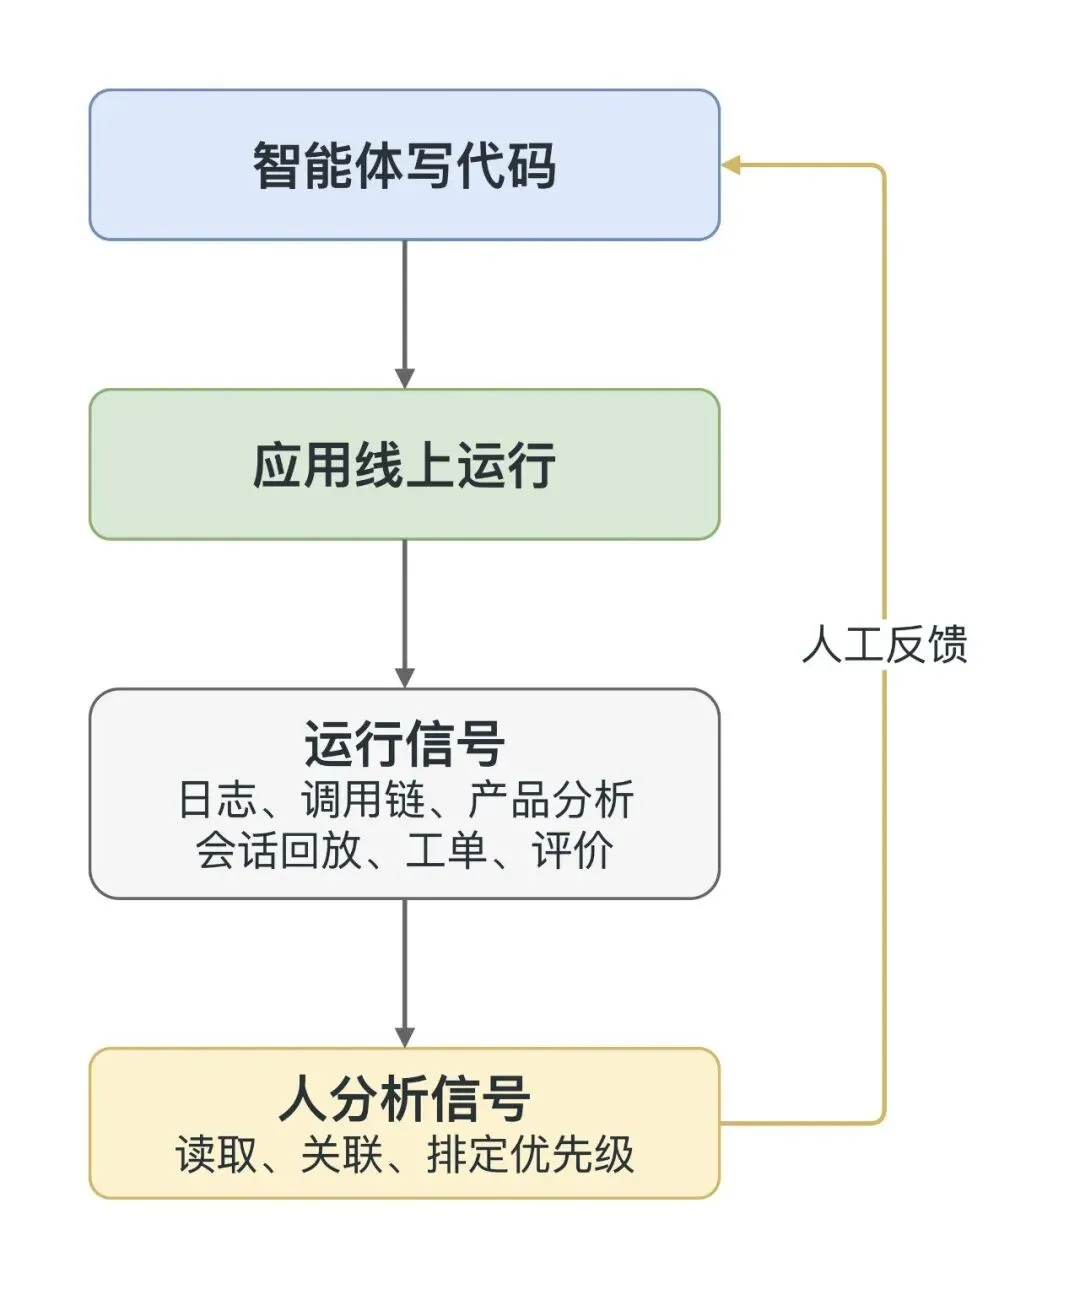
图 1:Agent 写出代码后,生产环境产生的信号仍由人读取、关联并排定优先级,再人工反馈给 Agent。(据原图中文重绘)
我们做了不少工具,帮助查询、可视化、整理这些信号,对问题进行分流并排定优先级。我也是其中一员:过去近十年里,我把大部分时间都花在了可观测性工具的开发上。但到最后,还是需要有人读懂数据,决定哪些地方需要改进。
能够自我改进的软件,终将到来。 应用会读取自己产生的信号,决定该改什么,发布改动,再检查是否有效。一旦软件能够改进自身,它还可以改进那套帮助自己改进的机制:更好的可观测性、更敏锐的检测、更深入的调查、更有效的修复。每一轮循环,都让下一轮运转得更好。
要做到这一点,我们就得放下主导权。工程师、产品经理、设计师,所有人都一样。我们得停止充当「人肉中转站」,不再由我们决定接下来修什么、什么时候修。
眼下,人就是反馈闭环
每一种信号源都有自己的工具:工程师和 SRE(站点可靠性工程师,负责系统稳定运行)用 Datadog,产品经理用 Amplitude,设计师用 FullStory,客服用 Zendesk,等等。
用户在线上遇到问题时,错误会被记进可观测性工具。用户短时间内反复猛点同一区域的「愤怒点击」,会留在记录操作过程的会话回放里。与此同时,产品指标下滑,客服工单增加。
产品经理需要注意到这一切,调查并关联不同信号,再把信息整理成一张工单,排进下周的优先事项。随后,工单交给工程师,由工程师向 Agent 下达指令,让它把工单里的需求落实成代码。
到了 2026 年,这种做法实在说不通。Agent 已经聪明到能解决人类曾经面对过的一些最困难的数学问题。相比之下,解析错误并排定优先级,根本用不了多少智能。
我们都成了「人肉中转站」吗?
如果你把产品分析仪表盘截个图,粘贴进 Claude Code,再输入「调查这张图里的指标为什么在下降,并修复问题」,你就是一个「人肉中转站」。
所谓「人肉中转站」(meat proxy),就是一个人,唯一的工作是在两台本来完全可以直接通信的机器之间搬运信息。仪表盘掌握数据,Agent 拥有智能。你夹在中间,决定看什么、什么时候看、怎样描述。这就是「人肉中转站」。
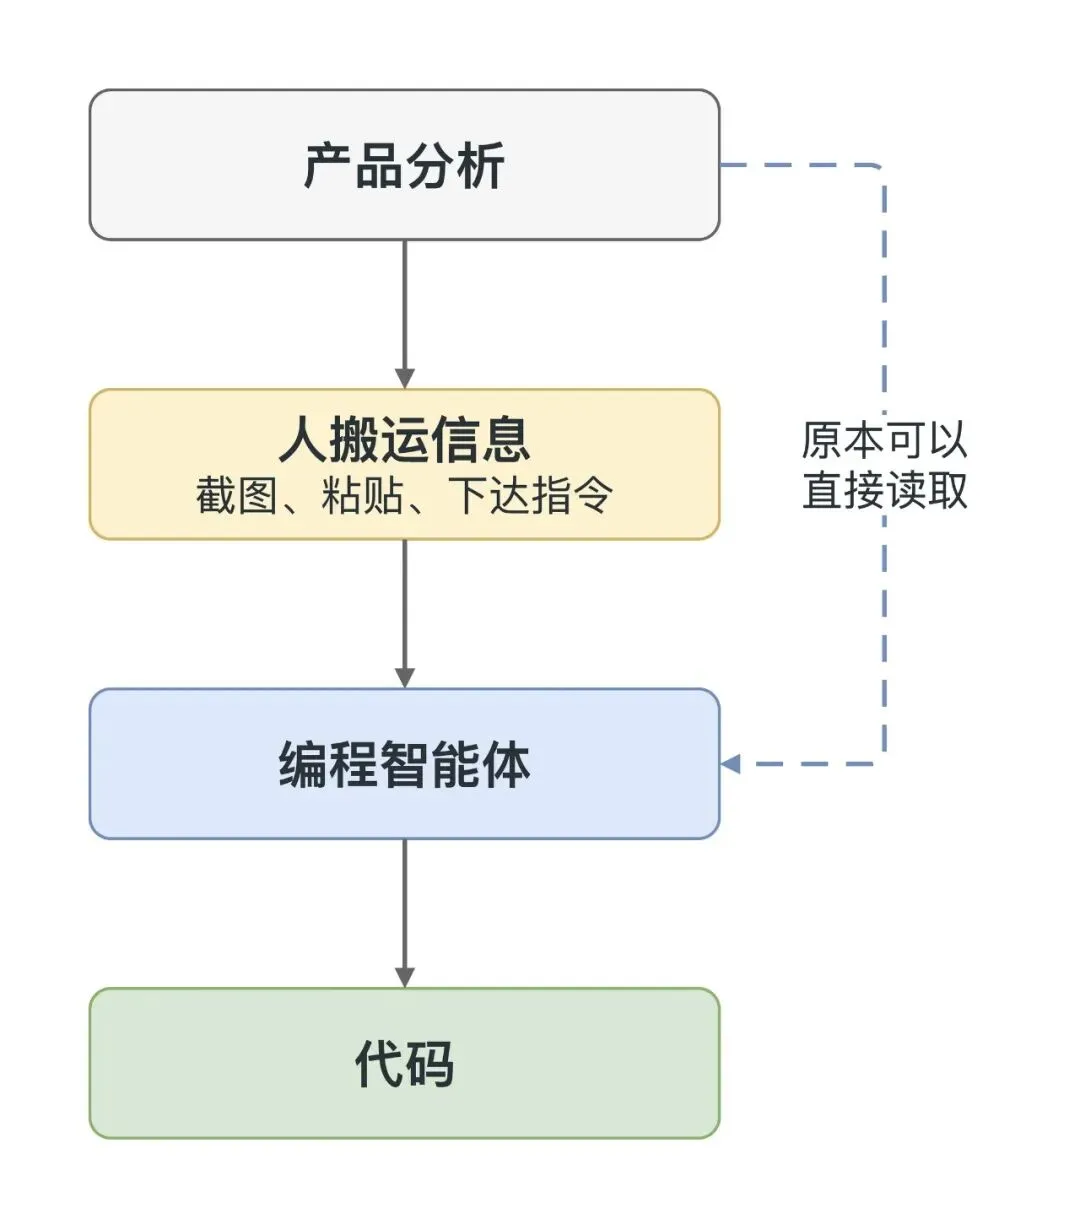
图 2:产品分析数据原本可以直接交给编程 Agent,中间却需要人截图、粘贴并下达指令。(据原图中文重绘)
MCP(模型上下文协议,用来连接 AI 与外部数据和工具)和各种连接器能让中转更快,但中间搬运信息的仍然是你。
自动化面临「未知的未知」问题
不少 Agent 工具都带有自动化功能,我自己也做过一个。它们本质上就是 cron 定时任务和 webhook(外部事件触发的回调),用一段预设提示词唤起 Agent:
监听 Honeycomb 告警,每次触发都展开调查。
每当 Sentry 创建一个新问题,就调查它,并提交包含修复代码的 PR(代码合并请求)。
每天早上检查产品指标。如果激活率低于 10%,就展开调查并写出修复代码。
这让人感觉效率高得惊人。还没等谁打开笔记本电脑,每条告警就已经有了调查报告,每个新异常也都有了一份代码合并请求。
但这些自动化流程只能看到已经有人认定值得关注的东西。触发它们的系统有什么盲点,它们就继承什么盲点。
总得有人先决定对什么发出告警、定义哪些 SLO(服务等级目标,用来约定系统的运行质量),而这些设定天然就不完整。对于复杂应用运行中涌现的行为,根本无法预先设好告警。
这就是「未知的未知」问题。已知问题会被检测出来,因为已经有人写了告警规则或异常处理逻辑。未知问题始终没有被发现,因为用于发现它们的机制根本不存在。
Agent 修复你已经知道如何发现的问题,速度快得惊人。而那些让你流失最多客户的问题,几乎可以说,恰恰是你还不知道该如何发现的那些问题。
应用也需要反向传播
把一个软件想象成一个神经网络。
代码就是权重和偏置,每一次代码改动,就是一次权重更新。用户与软件交互,产生各种信号,比如记录请求处理过程的调用链、点击、工单、客户流失和营收。这些就是网络的输出。
按这个类比,自我改进的软件可以分成两个阶段:
前向传播:输入意图,生成代码。编程 Agent 已经「解决」了训练迭代中的这一步。只用一段提示词,我们就能一次生成相当复杂的应用,甚至把它部署上线,并连接所需的可观测性工具和产品分析等工具。
反向传播:把输出与你想要的结果比较,计算差距,再把差距反向传回系统,调整权重。对应用来说,就是收集它在生产环境中产生的所有信号,弄清楚这些信号揭示了代码的哪些问题,再据此修改代码。
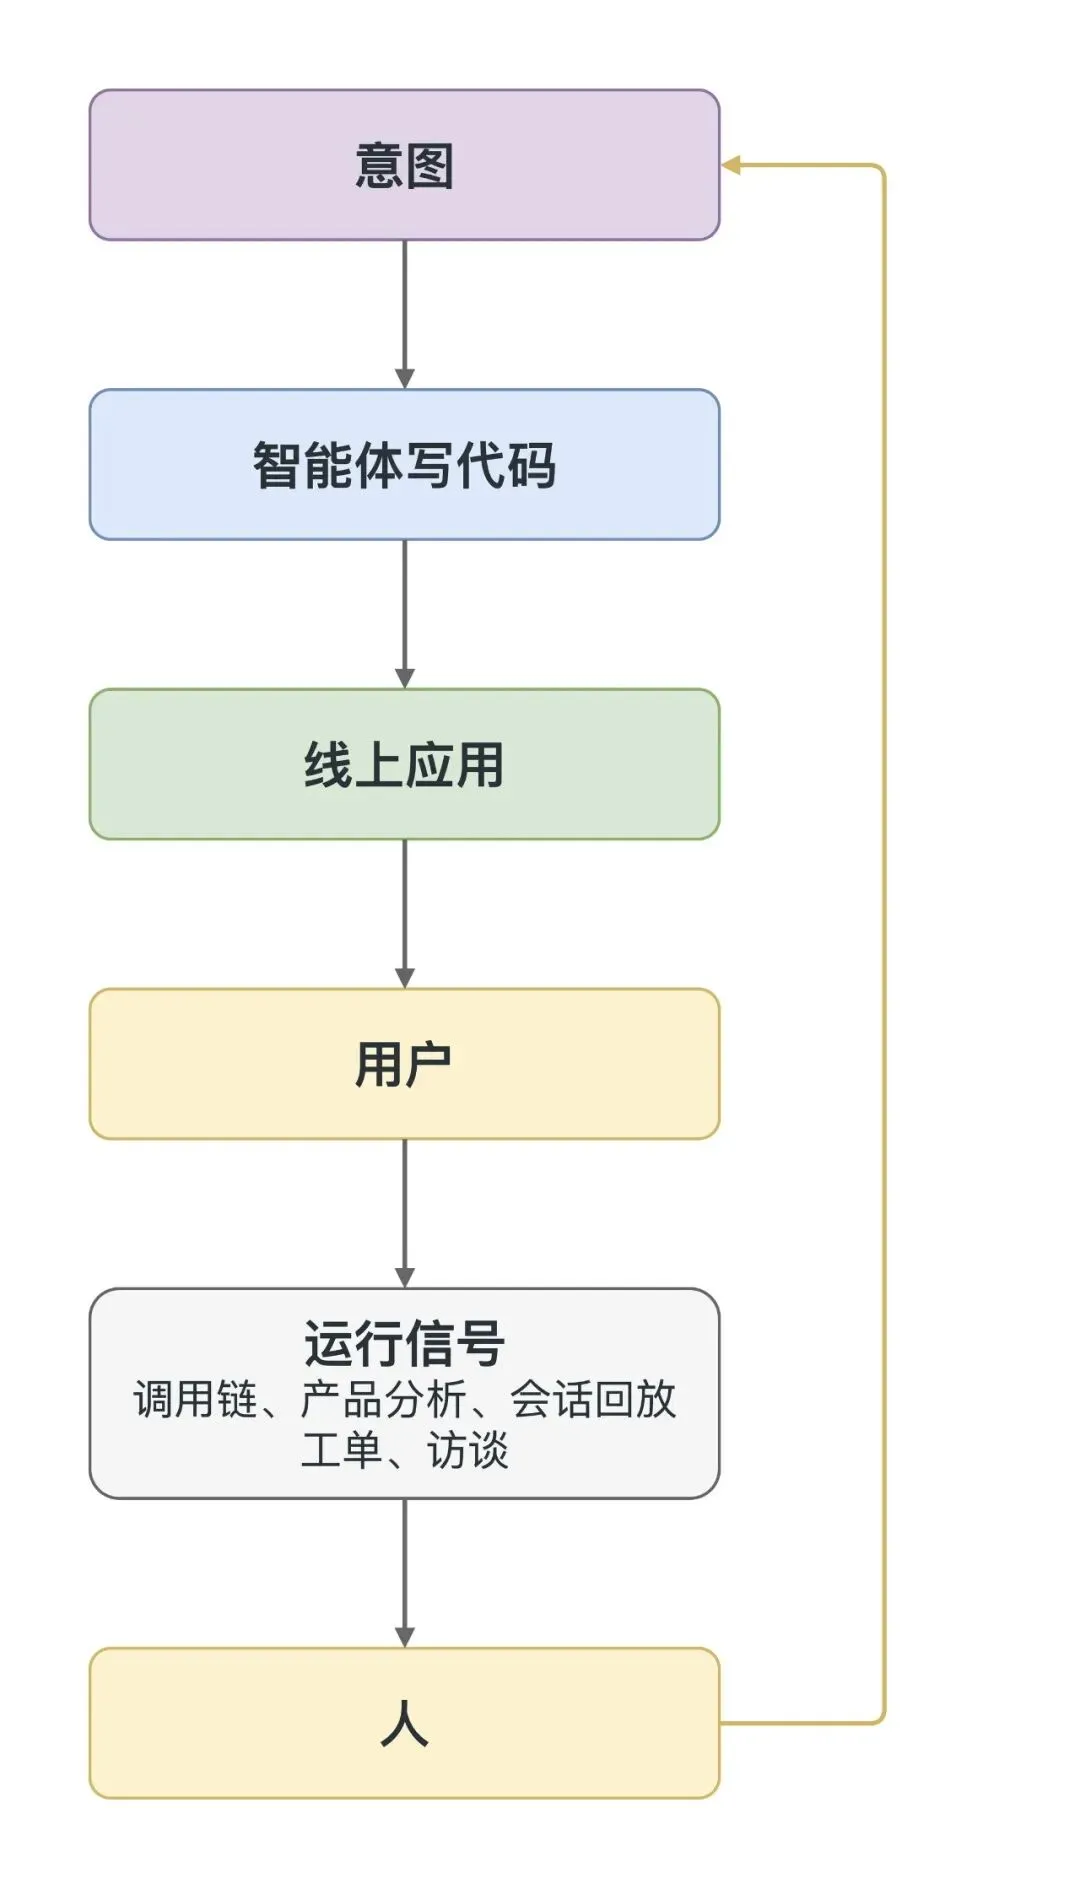
图 3:从意图到代码的正向过程已交给 Agent,用户反馈返回开发过程仍依赖人。(据原图中文重绘)
我们把前向传播自动化了,却把反向传播留给了人工。每周,我们把几十次「权重更新」推到生产环境,再在规划会上手工计算「梯度」,决定下一轮该往哪里调整。
频率充其量是每周一次,有些公司甚至每季度才做一次。这些规划依赖产品经理的记忆、抽样观看的 20 段会话录像,以及声音最大的那 3 条客户投诉。
如果我们用这种方式训练模型,根本做不出任何值得别人花时间使用的东西。
智能已经便宜到不必细算成本
在这个类比里,反向传播之所以由人工完成,只有一个原因:没有别的东西能够读取错误日志,找到对应的调用链,与会话回放交叉核对,理解客户为什么生气,再决定该改什么。这需要判断力,而好的判断力曾经稀缺又昂贵。
如今,情况已经不同了。智能已经便宜到不必细算成本。它能读遍每条调用链,看完每次会话,读完每张工单和每份访谈记录,再在几分钟内把它们关联起来。
编译注: 「不必细算成本」「几分钟内关联全部数据」是作者的概括。原文没有提供数据规模、费用或准确率评测,不应将其理解为零成本或适用于任意规模的保证。
我们可以让智能同时参与前向传播和反向传播,加快迭代速度,实现能够自我改进的软件。
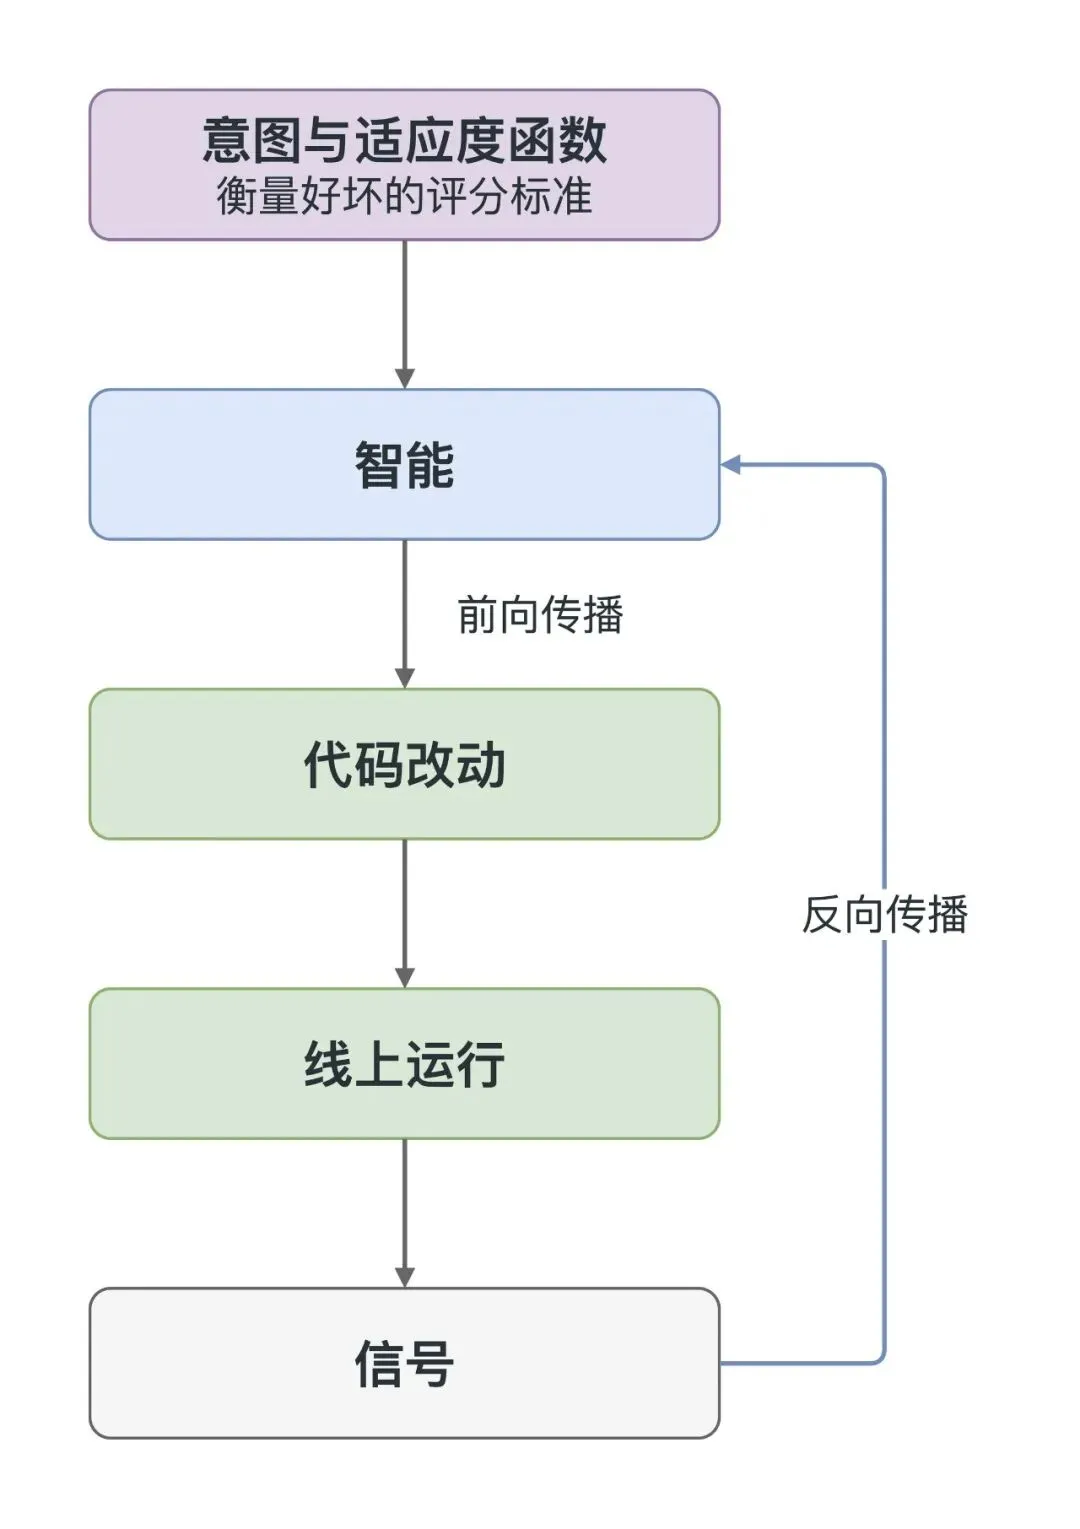
图 4:智能同时参与正向生成和反馈分析,让生产信号持续驱动代码改进。(据原图中文重绘)
那我们该做什么?
一个神经网络如果没有损失函数,也就是衡量结果偏离目标程度的标准,就只是一个非常昂贵的随机数生成器。反向传播需要知道,「更好」究竟意味着什么。
编译注: 这里的「反向传播」「梯度」与「损失函数」服务于软件反馈闭环的类比,原文没有给出对任意代码直接求梯度的方法。「没有损失函数就只是随机数生成器」也是强调优化目标重要性的修辞;训练好的网络推理时,并不需要每次都计算损失。
按这个类比,我们的工作变成了定义「更好」的含义。工程师、产品经理、设计师、销售、客服,每个人的角色,都变成了定义系统据以优化的适应度函数(fitness functions),也就是衡量好坏的评分标准。
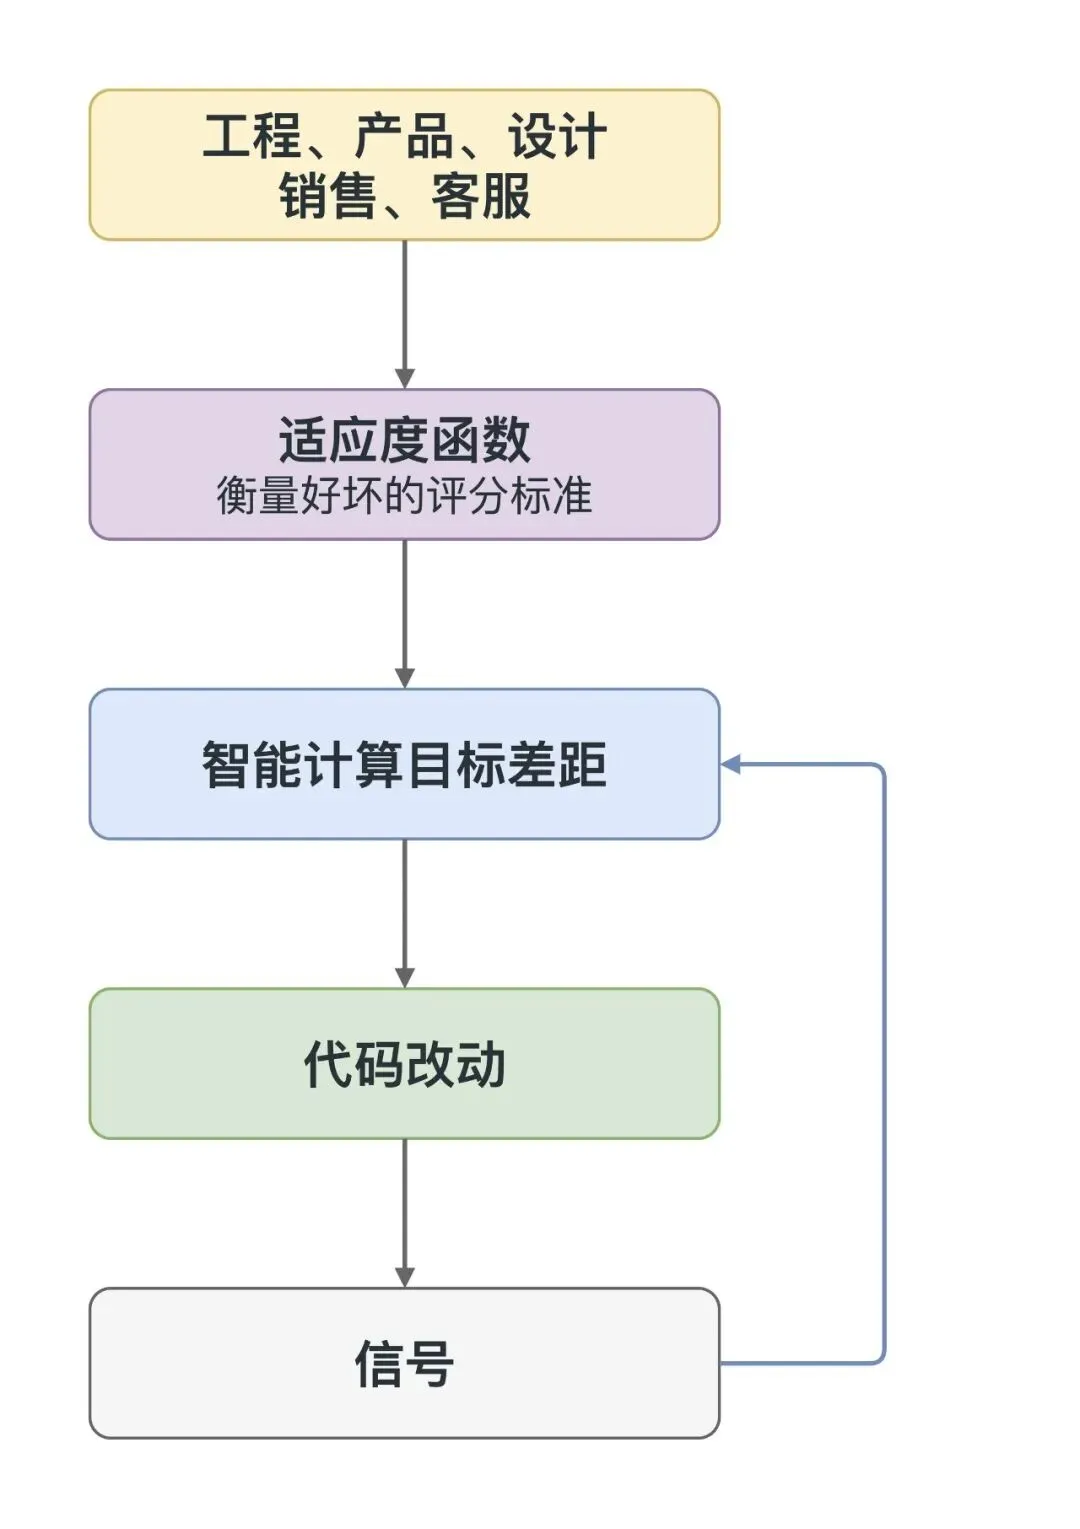
图 5:人定义优化目标,智能对照目标计算差距,再根据运行信号持续调整代码。(据原图中文重绘)
难点在于,这些函数经常相互牵制。更快的结账流程可能影响欺诈检测,更简单的新用户引导可能降低重度用户的激活率,折扣可能增加营收,却毁掉利润率,等等。
决定怎样给这些目标分配权重、哪些是硬性约束、为哪些客户优化,才是难事。 归根结底,就是决定公司想要达成什么,并把它写得足够精确,让机器能够据此优化。坦白说,最难的部分一直都是这个。
丰裕时代就在前方
让一个云端编程 Agent 同时拥有所有信号源的读取权限,包括可观测性数据、产品分析、会话回放和客服工单,再给它代码仓库的写入权限。然后,按计划定时运行下面这些任务。
每小时,读取过去一小时里新增的所有错误、调用链、会话回放和客服工单。把看起来属于同一个问题的内容归到一组,即使它们出现在不同工具里。针对每组问题,找出引入它的发布版本,提交包含修复代码的 PR,并附上全部证据。
每天早上,把昨天的情况与这些目标比较:结账流程的 p99 延迟低于 300 ms,错误率低于 0.1%,激活率高于 25%,每天客服工单少于 20 张。对任何朝错误方向变化的指标,到代码里找出原因并提交 PR。如果所有指标都按预期推进,就找出最有可能让这些数字继续改善的改动,并为它提交 PR。
编译注: 上文的 10%、300 ms、0.1%、25% 和每天少于 20 张工单,都是提示词中的示例阈值,既不是实测成绩,也不是适用于所有产品的推荐标准。
我们已经非常接近了。能够自我改进的软件,终将到来。而且,我们第一次离这个目标这么近,已经可以真正着手构建它了。
我也正在打造 Polylane[1],因为所有软件都应该能够自我改进。
参考资料
Boris Tane:Self-improving software is inevitable[2],Boris Tane Blog,2026 年 10 月 10 日。 Thang Luong、Edward Lockhart:Advanced version of Gemini with Deep Think officially achieves gold-medal standard at the International Mathematical Olympiad[3],Google DeepMind,2025 年 7 月 21 日。 Model Context Protocol:What is the Model Context Protocol (MCP)?[4],官方文档,查阅于 2026 年 10 月 11 日。 Stanford CS231n:Backpropagation, Intuitions[5],课程资料,查阅于 2026 年 10 月 11 日。 PyTorch:Quickstart — Loading Models[6],官方教程,查阅于 2026 年 10 月 11 日。
原文:Boris Tane,Self-improving software is inevitable[7],2026 年 10 月 10 日。
引用链接
[1]Polylane: https://polylane.com/
[2]Self-improving software is inevitable: https://boristane.com/blog/self-improving-software-is-inevitable/
[3]Advanced version of Gemini with Deep Think officially achieves gold-medal standard at the International Mathematical Olympiad: https://deepmind.google/blog/advanced-version-of-gemini-with-deep-think-officially-achieves-gold-medal-standard-at-the-international-mathematical-olympiad/
[4]What is the Model Context Protocol (MCP)?: https://modelcontextprotocol.io/docs/getting-started/intro
[5]Backpropagation, Intuitions: https://cs231n.github.io/optimization-2/
[6]Quickstart — Loading Models: https://docs.pytorch.org/tutorials/beginner/basics/quickstart_tutorial.html#loading-models
[7]Self-improving software is inevitable: https://boristane.com/blog/self-improving-software-is-inevitable/