ARTICLE · 1159472
AI 把生信门槛打下来之后,专业会重新变贵
AI 把生信门槛打下来之后,专业会重新变贵?
最近身边越来越多老师跟我说:"现在 AI 都能写代码了,单细胞分析我让学生自己用 AI 跑跑就行。"
这话没错。但我想说的是:AI 正在做一件很有意思的事——先把生信分析的门槛全部打下来,然后再重新让专业能力变贵。
这件事,生信圈其实已经经历过一次了。
一、AI 正在打掉生信的门槛
以前,跑一套转录组差异分析,你得会 Linux、会装软件、会写 R,环境报错能折腾一整天。以前做单细胞,从质控、降维、聚类到注释,没有专门的生信人员根本推不动。以前画一张像样的热图、火山图、UMAP 图,要反复调参数、改配色。
现在呢?
把报错信息丢给 AI,它告诉你怎么改; 描述一下需求,它给你写出完整的 Seurat / Scanpy 流程; 扔给它一列 marker 基因,它帮你猜细胞类型; 富集分析结果贴进去,它能给你写一段"像模像样"的讨论。
一个研究生突然发现:原来自己一个人也能做完一整套单细胞分析了。
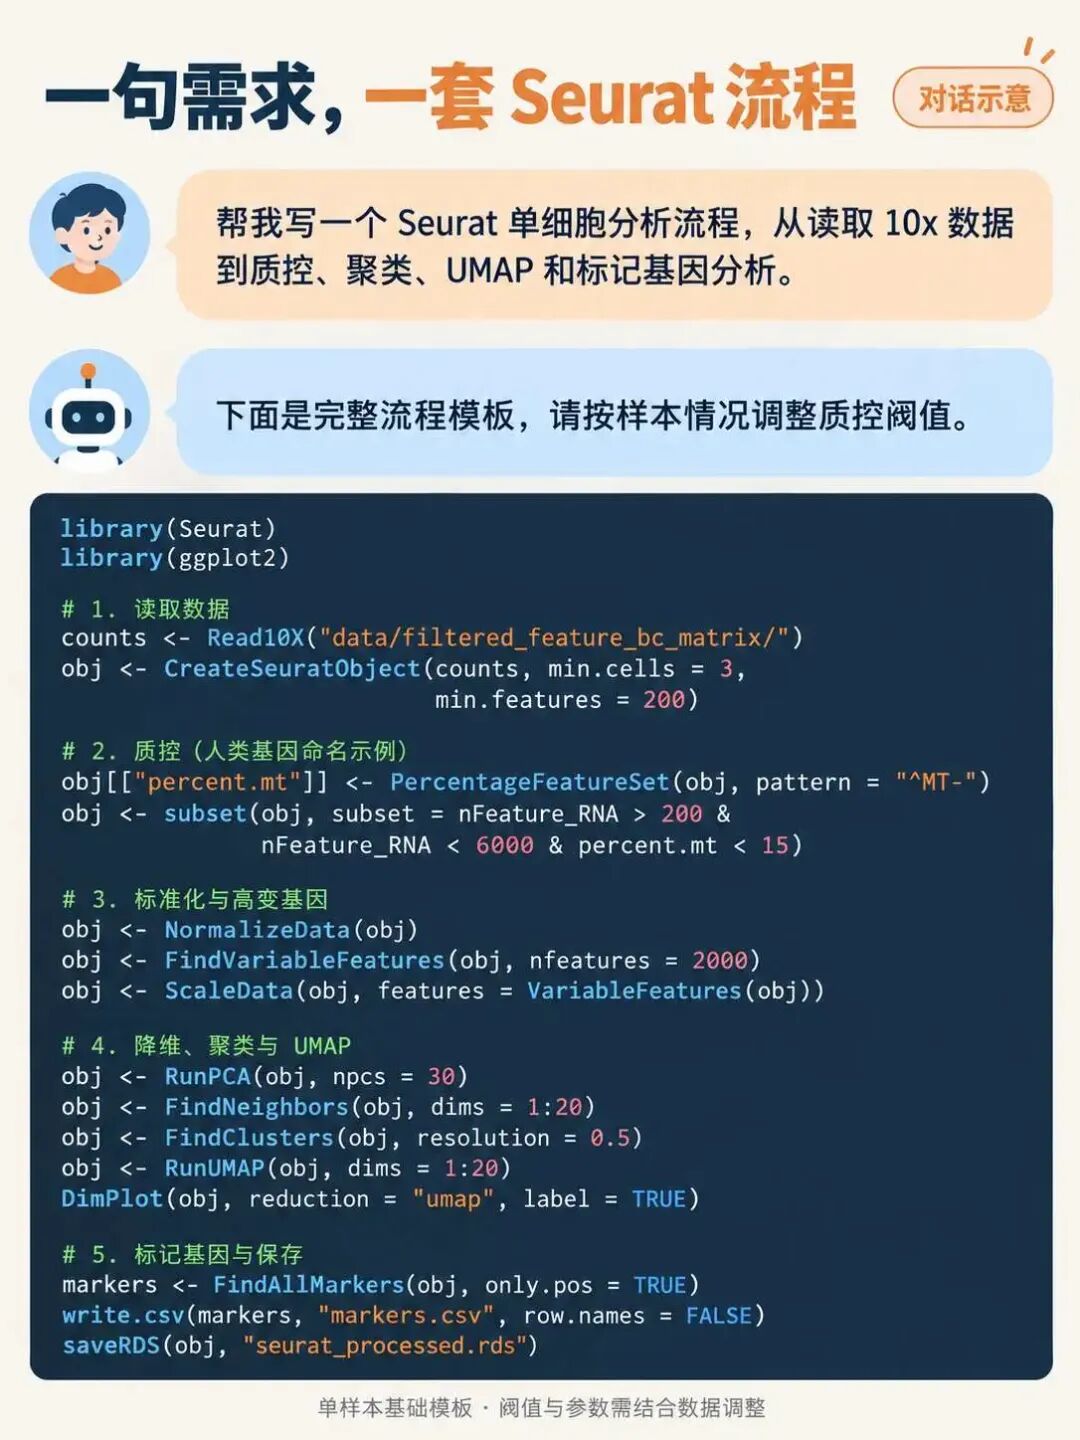
二、但你很快会撞上一堵墙:听不懂 AI 在说什么
举个真实会发生的例子。
一位老师做了一个很常见的实验:野生型和敲除小鼠,各分对照组和给药组,一共四组,做了转录组。他问 ChatGPT 该怎么分析,ChatGPT 很认真地建议:
"建议做交互分析。"
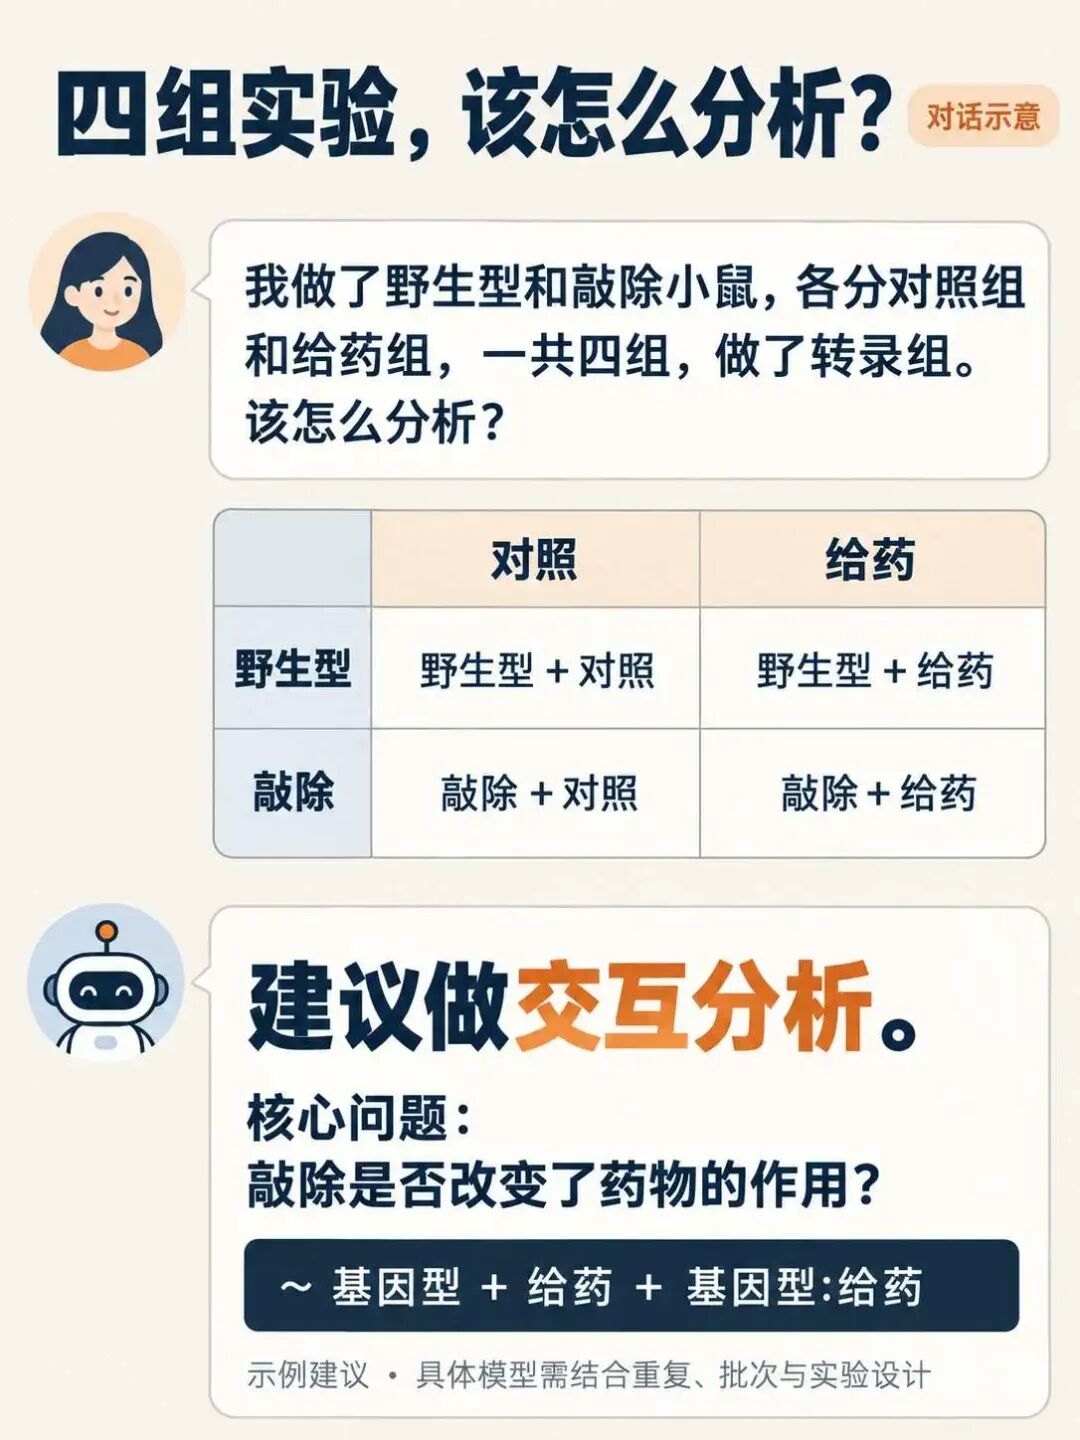
问题来了:什么是交互分析?
很多人第一反应是蛋白互作网络,或者细胞之间的通讯分析——毕竟都叫"交互"。其实都不是。
于是他接着问 AI。AI 解释说:在线性模型中加入交互项,比较主效应和交互效应……
又冒出来一堆新词:线性模型、交互项、主效应、设计矩阵、contrast。
每个词再问一轮,十几轮对话下来,分析还没开始,人已经晕了。更麻烦的是,他可能在某一轮理解偏了,后面所有分析都跟着偏,自己却完全不知道。
而一个懂一点生信的人,听到"交互分析"四个字,脑子里只需要一句话:
"看这个药,在敲除鼠和野生鼠里的作用是不是不一样。"
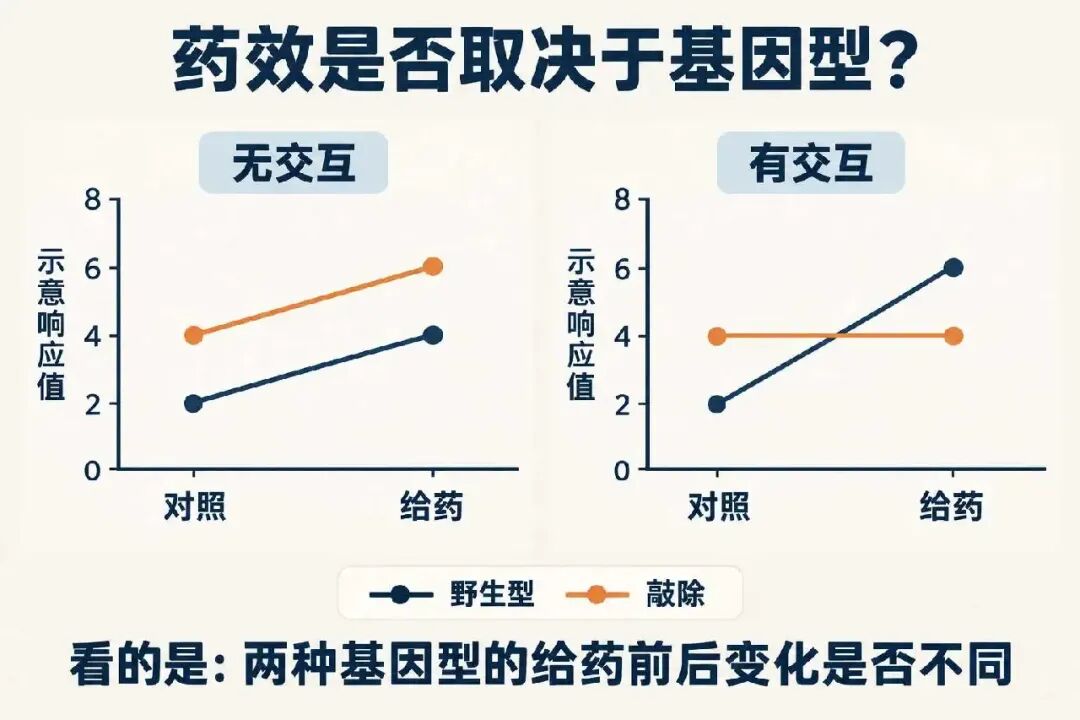
懂了。直接让 AI 写代码,然后马上追问下一个更关键的问题:"每组三个重复,够不够检测出交互作用?"——因为交互效应通常比主效应更难检测,样本量不够,很可能什么也找不到。
同一个 AI,一个人在跟它补课,另一个人在跟它干活。
三、专业名词,就是你和 AI 之间的接口
这就是用 AI 做生信时,大家最容易忽略的一点:
AI 能替你写代码,但不能替你听懂。
每一个专业名词,背后其实都是一整套逻辑的"压缩包"。批次效应、双细胞、聚类分辨率、拟时序、padj……懂的人,看到一个词就自动解压了,知道它在说什么、为什么重要、哪里会出坑。不懂的人,就得让 AI 一句一句解释,再把解释翻译成自己能听懂的话。
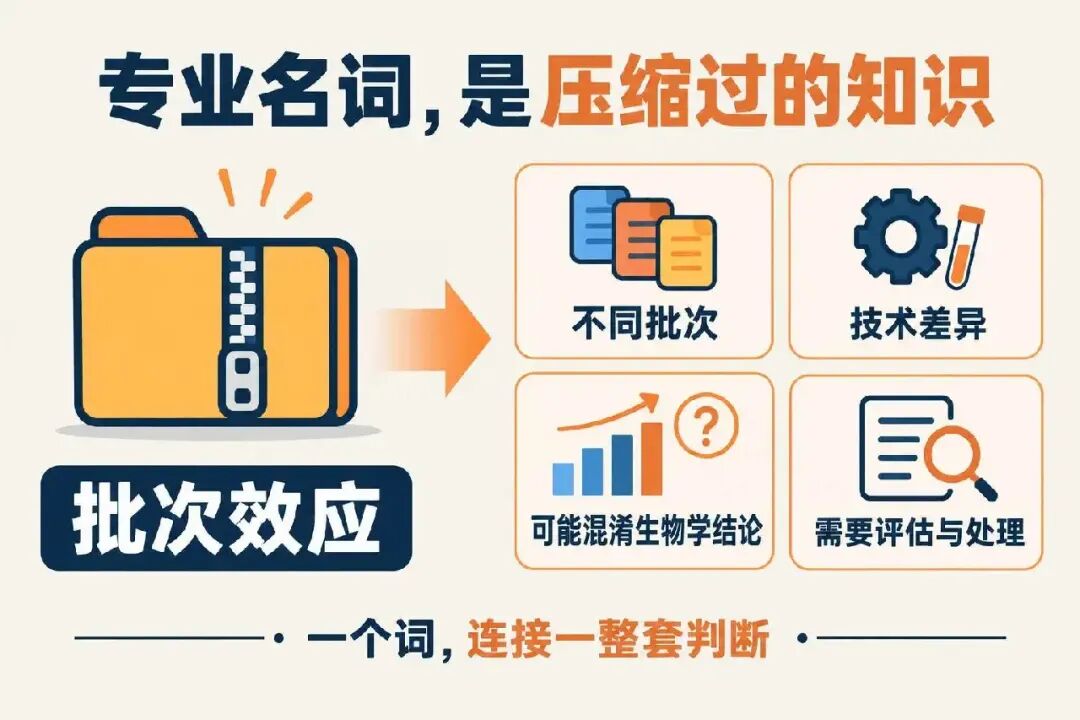
所以用 AI 做生信,有一个绕不过去的过程:你必须不停地跟 AI 讨论专业名词,直到把它们翻译成你自己的话。
这个过程越短,你分析得越快;这个过程走得越扎实,你越不容易被 AI 带偏。
AI 时代学生信,重点不再是背代码,而是**建立你自己的"词汇表"**。
四、"会用 AI 跑分析"很快会被磨平
说回大趋势。
今天你会用 AI 写分析代码,明天你师弟也会; 半年后,几乎所有做组学的课题组都会; 当所有人都用 AI 跑同一套默认参数,"能跑出结果"本身就不值钱了; 当所有人都能生成一张"还不错的 UMAP 图","还不错"就变成了最平庸的标准; 当所有文章都是"聚类—注释—差异—富集—细胞通讯"五件套,审稿人很快就会看腻。
所以,"会不会用 AI 做生信"这件事,很快一定会普及。差距不会出在这里。
五、这一幕,生信圈经历过
十年前,会跑转录组流程、能把差异基因列表拿出来,就是课题组里的"技术大牛"。一张火山图加一张 KEGG 气泡图,就能撑起文章里的一个 Figure。
后来呢?测序公司开始提供标准分析报告,云平台做到了一键出图。所有人都能拿到差异基因、富集结果、漂亮的热图。于是,单纯"能出图"马上就显得平庸了。
再然后,真正懂实验设计的人、懂统计的人、能把数据讲成生物学故事的人开始拉开差距。审稿人的问题也变了——不再问"你做了什么分析",而是问"你凭什么这么分析、你的结论站得住吗"。
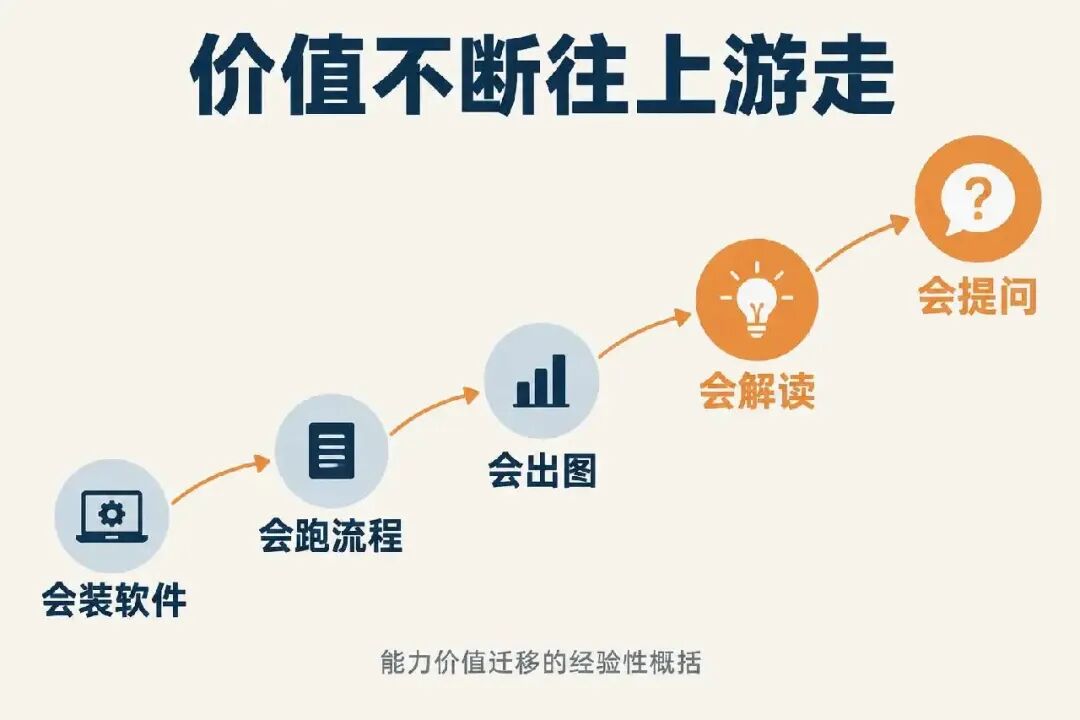
专业,又重新变贵了。 AI 时代,只是把这个过程又快进了一遍。
六、真正稀缺的,是"T 型"生信人才
真正需要的不是一个"会点 AI 的人",而是一个本来就懂生信、又特别会用 AI 的人。
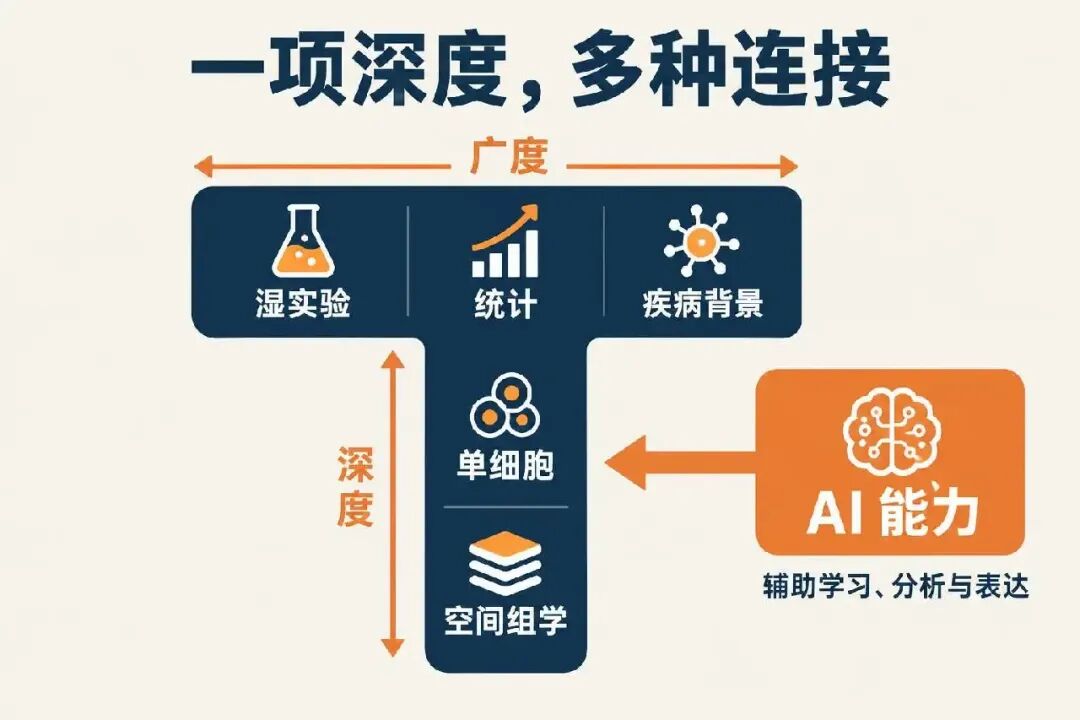
这种人的能力形状是 T 型的:
一个方向极深:单细胞、空间转录组、蛋白代谢、宏基因组,真正懂原理、知道坑在哪; AI 能力很强:能用 AI 把效率放大十倍,而不是被 AI 带着走; 周边领域有基本认知:懂一点湿实验、统计、疾病背景,能对上话就行。
七、AI 时代的单细胞分析师长什么样
他首先得是个单细胞分析师。
他得知道:要不要去双细胞、环境 RNA 要不要校正;两个亚群分开,是生物学差异还是批次效应;聚类分辨率为什么选 0.8 而不是 1.2;一群高表达 Fos、Jun 的"新亚群",可能只是组织解离时被"吓"出来的应激反应;细胞通讯预测出一百对配受体,哪几对才值得花钱验证。
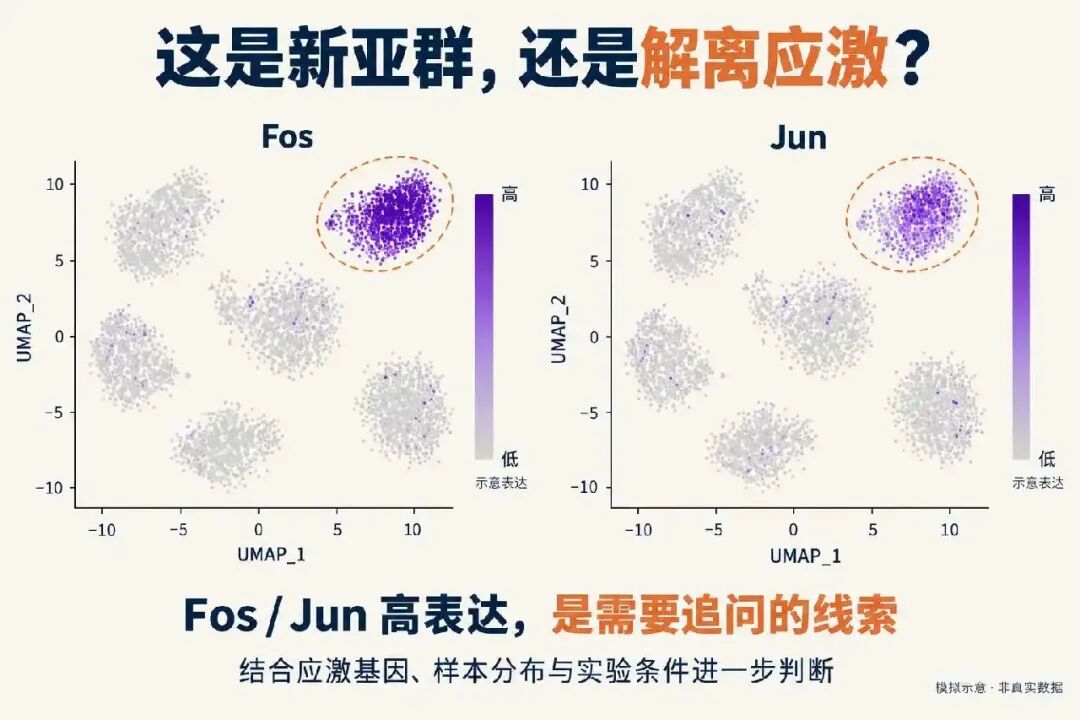
然后,他再让 AI 去写代码、批量跑参数、整理结果。
判断是他的,执行交给 AI。
八、AI 时代的组学分析师长什么样
做转录组、多组学,他首先得懂实验设计。
三个重复够不够?配对样本怎么建模?混杂因素有没有设计进去?像前面那个四组实验,从一开始就该想清楚:我要回答的是"药有没有用",还是"药的作用是不是依赖这个基因"?问题不同,分析方法和样本量都不同。
数据一旦测出来,实验设计里的错误,任何算法都救不回来。 这恰恰是 AI 最难替你判断的地方。
写在最后
"会不会用 AI 做生信",很快就不会是一种优势了。不会用 AI,才会掉队。
真正拉开差距的,只有两个问题:
你听得懂 AI 在说什么吗?你把 AI 接到了哪一项专业能力上?
附:AI 最爱说的生信黑话,翻译成人话
你被 AI 哪个生信名词绕晕过?欢迎在评论区告诉我,下一篇就挑大家最头疼的词来讲。