ARTICLE · 1166849
文档解析前沿进展:全模态结构化解析模型Youtu-Parsing-Omni-5B的用法及设计思路
今天是2026年10月13日,星期二,北京,天气晴。
继续看技术,看基础设施,全模态结构化解析模型Youtu-Parsing-Omni-5B,一个5B模型把文档、自然图像、音频、视频统一解析成 带空间/时间锚点的结构化JSON记录 ,定位是给LLM agent提供“感知层”,让LLM读取、定位、引用多模态证据,是个基础设施。
其实,这是一个趋势,给Agent做基础设施。其真正主张是“解析即感知接口”,多模态输入一次性转成带锚点的文本记录,agent不需要反复重编码视觉/音频token,且结论可通过bbox/时间戳回溯。这与RAG和computer-use agent的趋势直接对齐,但是,局限在于解析质量决定上限(本模型的ASR弱项会直接传导给下游),以及结构化记录会丢失原始信号中的长尾信息。
技术愈发陷入沉寂期,继续跟进。
一、全模态结构化解析模型Youtu-Parsing-Omni-5B
这个工作的目的是把媒体(文档/图片/图表/音频/视频)变成结构化 JSON ,给下游程序用,工作在《Youtu-Parsing-Omni: One Encoder, One Schema, Every Modality》,modelscope权重在:https://www.modelscope.cn/models/tencent-community/Youtu-Parsing-Omni
GitHub在https://github.com/TencentCloudADP/youtu-parsing
HuggingFace地址在: https://huggingface.co/tencent/Youtu-Parsing-Omni
技术报告在:https://github.com/TencentCloudADP/youtu-parsing/blob/main/youtu_parsing_omni/paper/Youtu_Parsing_Omni.pdf
1、先看任务和怎么用
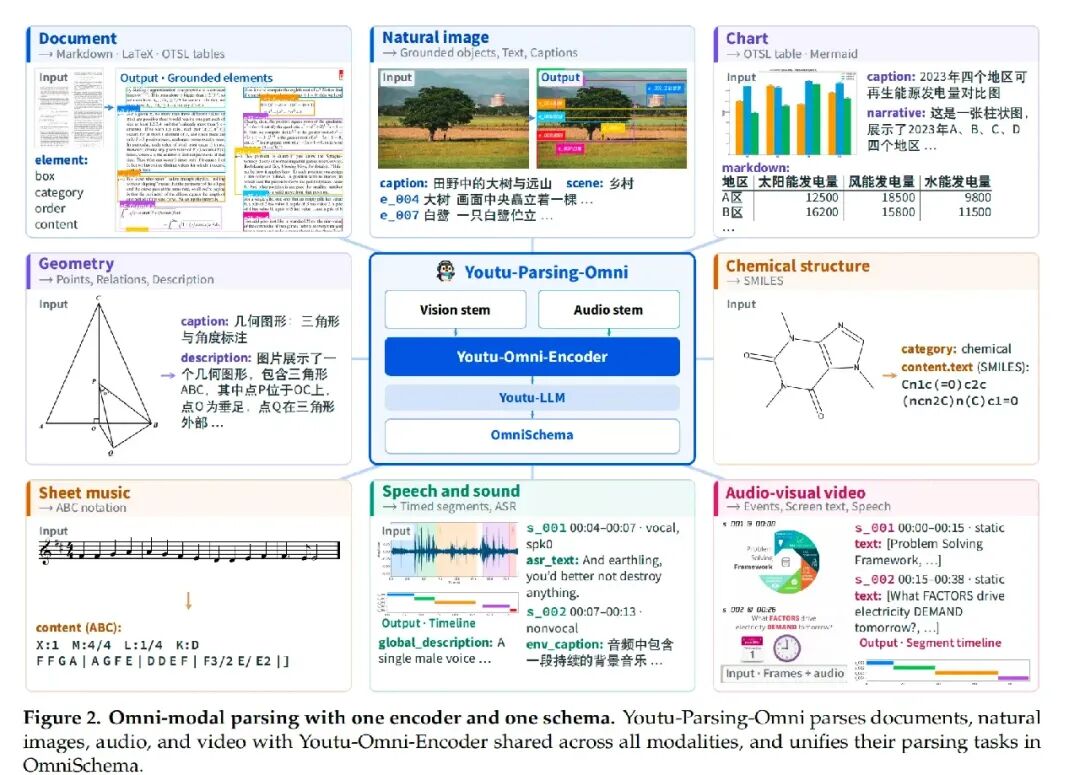
给定单个输入:文档页面、自然图像、图表 / 流程图、几何图形、音频片段或音视频视频,生成一个结构化的 JSON,支持 8 种任务:
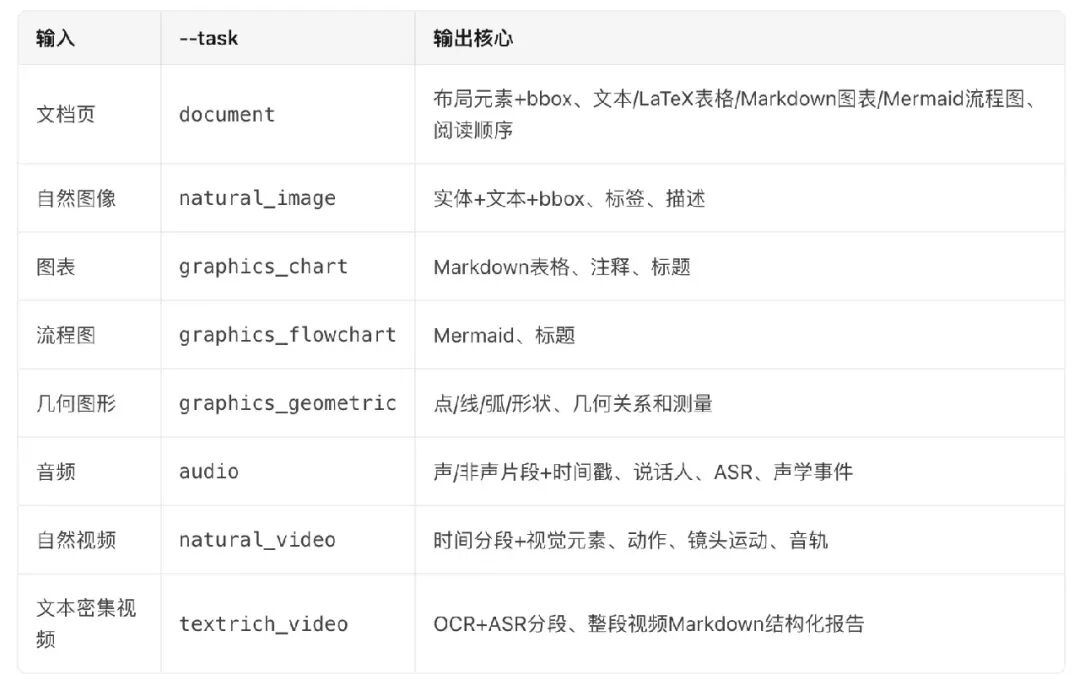
基于此,可以完成一些场景,比如:
其一,RAG 知识库预处理(最主流用法)。企业里的 PDF、扫描件、PPT 截图要进知识库,得先转成干净的 Markdown/JSON。它一个模型搞定版面分析 + 文字/表格/公式提取 + 阅读顺序还原,对标 MinerU、PaddleOCR-VL 这类专用模型,且 OmniDocBench 96.96 分排第一。这是文档型 agent 管线的地基。
其二,图表和流程图结构化,包括:图表截图 → Markdown 数据表(做数据提取、报告数字化)、流程图/架构图截图 → Mermaid 代码(可二次编辑、可被 agent 理解)、几何图形 → 点线关系和测量值(教育、做题类应用)
其三,音视频结构化,包括会议录音 → 说话人分离 + ASR + 时间戳 + 声学事件、讲座/教程视频 → OCR(幻灯片)+ ASR(讲解)+ 整段 Markdown 报告,这是做视频问答、会议纪要 agent、内容审核检索的基础设施。
其四,垂直场景,化学结构式识别(ChemOCR)、乐谱识别(PDMX-Synth)等。
所以,对于工具而言,其作为omni的价值其实是省架构,以前 OCR、ASR、视频理解、图表解析要拼 4 个模型,现在 5B 单模型一个 OpenAI 兼容接口全包,部署和维护成本可以下降。
此外,在统一输出上也有一些设计思路,就是输出即 schema:统一 OmniSchema JSON,bbox 用专用 token 编码,方便 agent 直接消费(比如点选交互、区域追问)。
2、看实现
从技术报告中可以看到一些做法:
1、设计思路
既然定位到omni,那么思路就一定是全包,那么如何全包?
就看之前怎么干?两个思路。
一个是跨模态联合感知。现有全模态方案(Qwen-Omni、Logics-Parsing-Omni)都是双塔:视觉ViT + 音频AuT分别预训练,在LLM里才汇合。三个后果:感知阶段无跨模态融合(LLM要从分离表征里自己推断跨模态关系);两塔各自索引时间,同一时刻的帧和声音在感知内部没有共享时间坐标;每个新模态要再建一座塔。对caption/QA影响不大,但对解析是硬伤,结构化输出必须显式说清“什么内容和什么内容同时发生”。
所以,解决方案是:
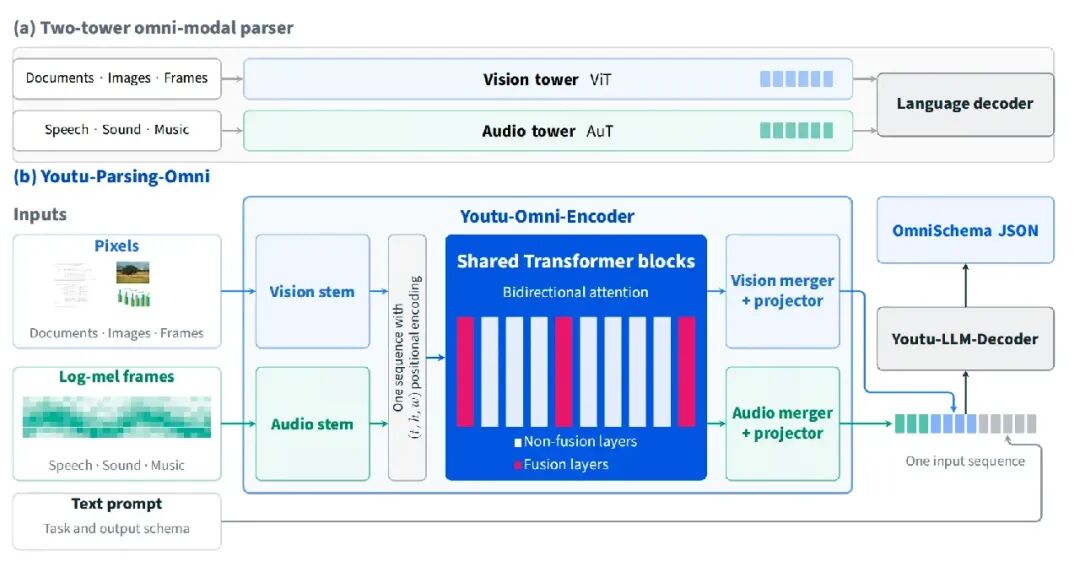
Youtu-Omni-Encoder(0.4B,单塔)
其一,共享Transformer(28层,hidden 1024)从 Qwen3-0.6B-Base 初始化 (去掉embedding和LM head),而非ViT,其动机在于解析本质是“读”,预训练语言模型的权重已经会“把上下文映射到符号”,直接复用这个能力。
其二,只有stem和projector是模态专属的(<3%参数)。视觉stem就是一个16×16 patch的线性映射;音频stem是3层stride-2卷积,13 token/秒。
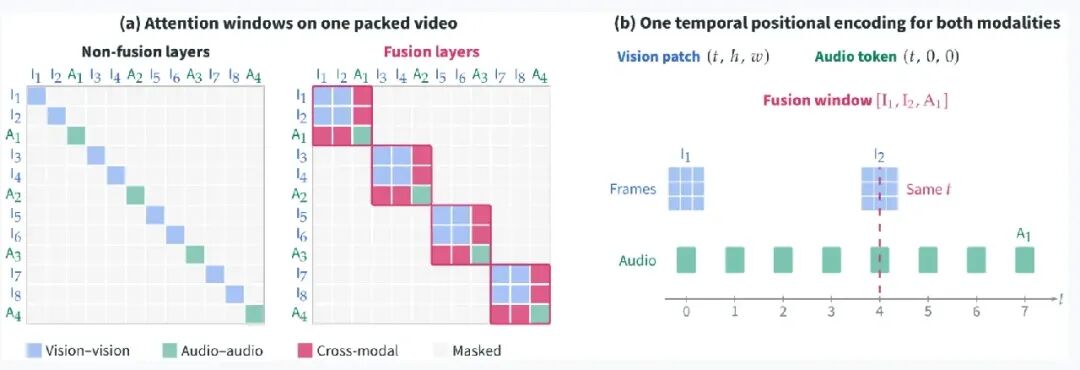
其三,轴分解RoPE:64个rotary slot切成三段(T/H/W = 21/21/22),各段独立频率表归一化。视觉token写 (t=帧号, h,w=patch位置),音频token写 (t=时间偏移, h=w=0),两种模态写入,同一个时间轴段,帧和声音从此可比位置。
其四,稀疏融合:第13/14/27/28共4层做跨模态注意力。视频按“I帧+其后音频chunk”切窗,窗内帧和声音互相attend,且按音频token速率共享时间尺度(Δt_audio=1/token)。也就是说,音画对齐在感知层内部完成,只有跨窗依赖留给decoder。训练时fused路由概率0.8,保证两条路由推理都可用。
一个是跨任务联合优化。十个任务输出字段不同,SFT只看参考前缀(推理时是自己生成的前缀,有exposure bias);RLVR/GRPO只用序列级标量奖励,异构指标(格式正确性、grounding精度、内容准确率)很难捏成一个reward。所以,为了解决这个问题,走了两个解法:
其一,OmniSchema(一个输出格式管十个任务),使用 JSON三件套:modality + 单元列表(图像用0-1000归一化bbox的elements,音视频用HH:MM:SS时间戳的segments)+ global_description。十个任务=文档、化学(SMILES)、乐谱(ABC)、图表(Markdown表)、流程图(Mermaid)、几何、自然图像、音频、自然视频、富文本视频,全部套这一个schema。每个token因此可以归类为 结构token (JSON语法)或 内容token (字段值)。
其二,OSAD(自进化on-policy蒸馏),使用三段后训练:SFT(16B token,建立schema格式)→ schema路由的GRPO(0.6B,序列级)→ OSAD(0.6B,token级)。OSAD的关键构造:
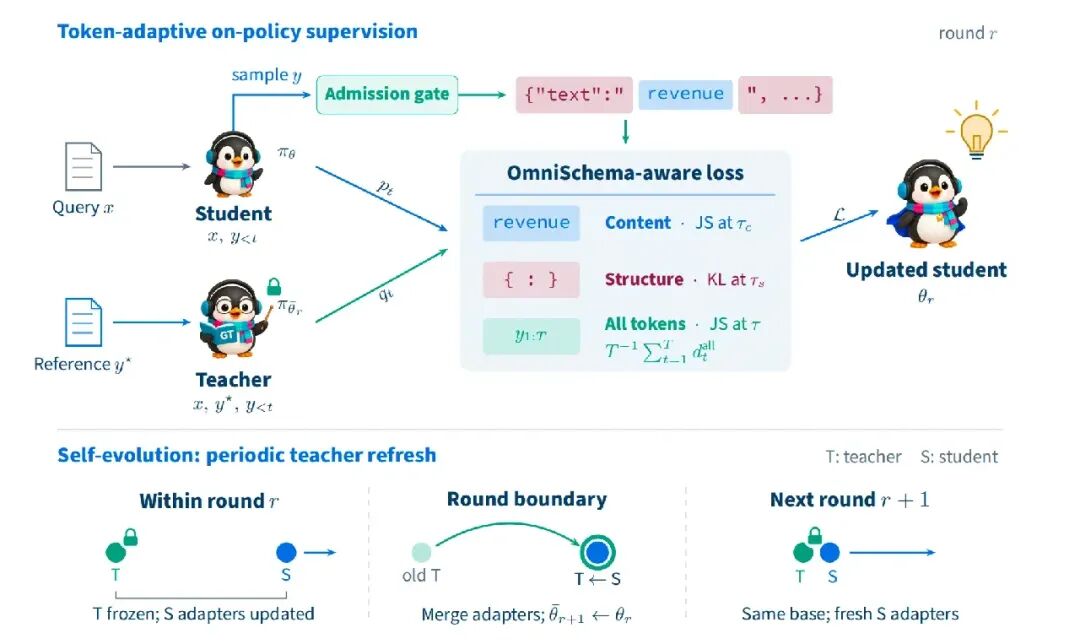
学生用LoRA在自身rollout上训练;冻结的教师是 同一模型的副本,但额外能看到参考解析 (privileged information,来自OPSD的思路);
对齐惩罚按token角色分配,内容token用JS散度 (有界,允许多个合法续写), 结构token用forward KL (要求覆盖教师对语法的预测),再加一个全token的JS项;
最后,每轮结束把adapter合并进base权重,教师随之刷新,教师和监督信号随学生共同进化,不需要人工设计reward也不需要单独训练的教师,共6轮。
这个的本质是“带特权信息的自蒸馏+周期性教师刷新”,前提是有一个统一schema能定义token角色,以及参考解析可以当特权信息用。
事实上,从趋势上看,这与RAG和computer-use agent的趋势直接对齐,但是,局限在于解析质量决定上限(本模型的ASR弱项会直接传导给下游),以及结构化记录会丢失原始信号中的长尾信息。
二、关于我们
老刘说NLP技术社区,自2022年建立以来,以公正、客观的角度,围绕知识图谱本体论+RAG知识库+Agent智能体三个方向做深入跟进,加入方式在:https://mp.weixin.qq.com/s/_sEWHeV20sN1JcwGJU9tJw