ARTICLE · 1175290
AI 写了三成新代码,交付的软件却没涨
AI 写了三成新代码,交付的软件却没涨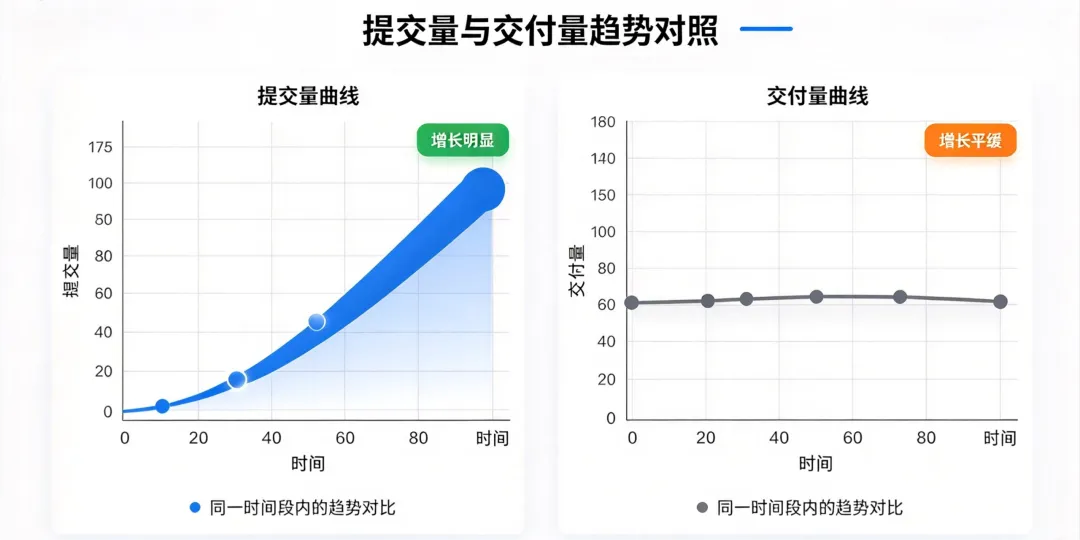
先说一个数字。 一家软件公司买了 AI 编程工具之后,工程师产生的代码量涨了三成。 但这家公司真正交付出去的软件,几乎没变。 这不是某个人的体感,是 700 多家公司、3 亿条工作记录算出来的。 哈佛的两位研究者 Fiona Chen 和 James Stratton,用了一个叫 Jellyfish 的工程效能平台的数据。 量级是这样的:约 3 亿条工作事件(提交、拉取请求这些),700 多家软件公司,70 万多名员工,时间从 2021 年一直拉到 2026 年 3 月。 然后他们要解决一个问题:怎么知道每家公司是什么时候开始用 AI 的?答案是把平台里直接测到的 AI 使用情况,和 GitHub 上的活动信号拼起来判断。再用"双重差分"这个统计方法,比较早用和晚用的公司,各自在引入前后发生了什么变化。 结果是这样一组数字: 采用 AI 编程代理(就是能自己写代码、自己提交的那一类,像 Claude Code、Cursor、Devin)之后—— 公司层面的代码总行数增加了约 30% 提交量增加约 20% 拉取请求增加约 23% 听起来很漂亮。 但研究者同时看了另一套指标:Jira 里的 Issue 和 Epic 解决率——也就是"真正做完的功能"这件事。没有统计上显著的变化。 他们还专门检查了一个可能:会不会是团队改去做更小、更简单的活了,所以看起来"做得多"?没发现这种变化。 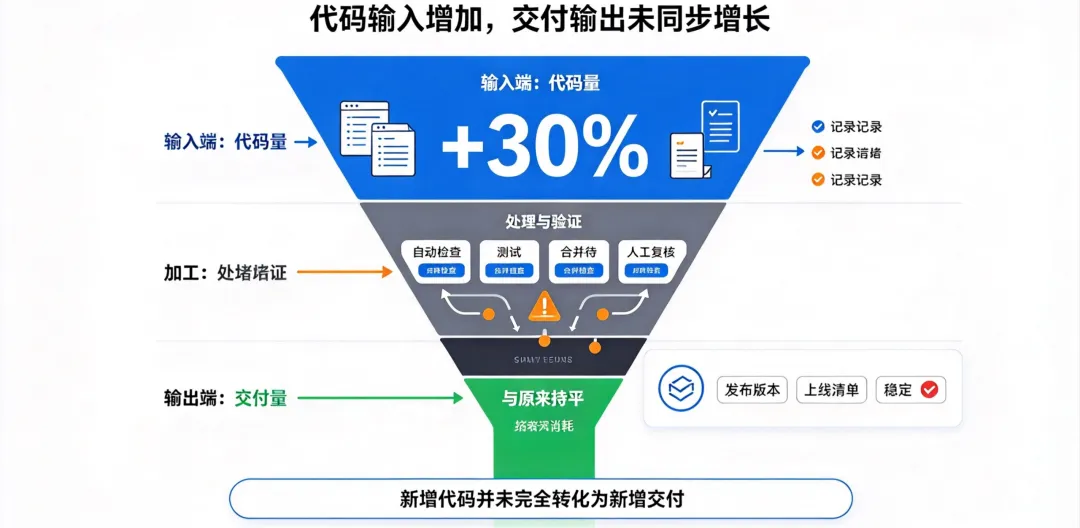
这是整份研究里最值得琢磨的一段。 答案在下游:被人接住了。 拉取请求从提交到被合并,平均时长涨了 49% 被要求返工修改的 PR 占比,几乎翻了一倍 每个 PR 上的评论数,涨了 35% 被拉去做代码评审的员工比例,涨了 14% 研究者的原话是:编码阶段提上来的效率,"被生产流程下游的瓶颈吸收了"。 还有一组对比特别清楚:到 2026 年 3 月,80% 的公司已经用上了某种形式的 AI 代码评审。听起来 AI 已经在帮忙看了吧? 但 AI 只贡献了全部评审评论的23.3%,以及全部拉取请求的10.8%。 也就是说,评审这件事,八成以上还是人在做。 研究里一位初级工程师的说法,比任何总结都直白: 如果只有一份研究,你可以怀疑它的样本、它的方法、它的数据来源。 所以这里要加一份:美国国家经济研究局的工作论文 35275《Writing Code vs. Shipping Code》,作者是 Demirer、Musolff 和 Yang。 这份研究用的数据完全不同——50 万多名 GitHub 开发者的公开活动,加上 AI 使用的遥测数据,方法也不同(匹配事件研究设计)。 它的结论是: 各代 AI 工具带来的累计提交量效应,大约从自动补全的 +30%,涨到交互式代理的 +180%,再到自主代理的 +240% 但这 240%,沿着生产链一路衰减——到"项目"层面剩大约80%,到"发布"层面只剩大约30% 四个主要软件市场里,新应用的数量大幅增加,但总使用量没有增加 两份研究,两个团队,两套数据,一个用企业内部遥测、一个用公开代码活动,得出的是同一个方向:代码涨了,交付没涨。 证据的可信度,有时候就来自这种"两个不同的方法算出同一个结果"。 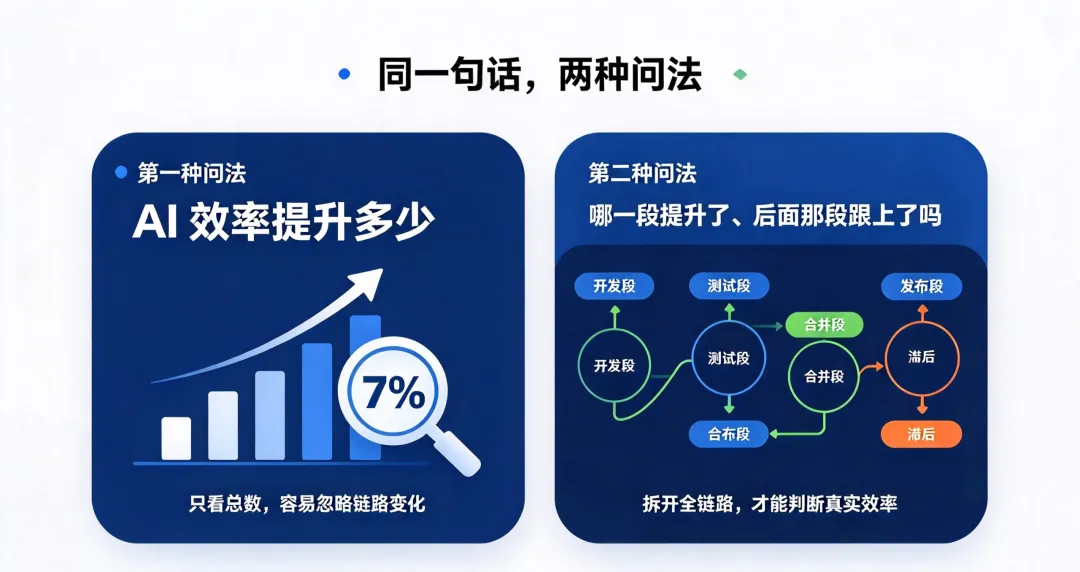
第一,别再拿代码量当 AI 效果的指标了。 它是所有指标里最容易涨的,也是最没用的——因为你完全可以什么都不交付,只让仓库里的行数翻倍。研究已经把这条路指出来了:看代码量会得出"AI 很有用",看交付会得出"没变化",差别只在于你量的是哪一段。 第二,如果在公司里被问"AI 工具买了到底值不值",现在有一个能用的答案。 值,但值在编码这一段。"用起来"和"用出结果"之间,隔着一整个下游。研究者的处方写得很直接: 换句话说,下一笔该花的钱可能不是"再买几个 AI 席位",而是谁来审。 第三,这条对个人最实用——你的东西更容易卡在别人那里。 如果你自己也在用 AI,你的产量确实上去了。但你周围的审核产能没有跟着涨。你的交付变多了、等待变长了、被打回来改的次数变多了,原因可能不在你。 你变快了,不等于整件事变快了。
"AI 提效"这四个字,我们听得太久了。 但效率从来不是一段的事。 它是一条链——你在哪一段变快,就会在哪一段被卡住。 下次再看到有人报出一个提效数字,你可以问一句: 快的是哪一段?后面那一段,跟上了吗? 你工作里有没有这种"我明明快了很多,项目还是慢"的时刻?评论区聊聊。
一、这个结论是怎么算出来的
二、多出来的那些代码,去哪了
"大家能飞快地提交一大堆东西,但代码评审始终是瓶颈。"
三、另一份独立研究,得出了差不多的答案
四、这对你意味着什么
"要真正拿到 AI 的红利,需要在下游评审能力上做配套投入,而不是单纯增加代码产出。"