ARTICLE · 1175292
批量下载文件程序的框架重构记录
批量下载文件程序的框架重构记录
起因:今天接到客户现场报案,说下载文件失败。我拿到日志后发现客户一次性下载了超过1000个文件,每个文件约25MB。 这立刻引起了我的警觉。合计24GB的文件,按照现场的带宽水平,正常也得半天时间。 进一步查看了同事写的代码,天塌了,什么鬼畜代码 接到用户的下载请求后,核心就一个for循环,把文件从阿里云OSS存下载到本地磁盘上。 进一步分析日志发现,刚开始下载挺顺利的,下载到第200多个文件的时候程序竟停止不动了。 程序是部署在IIS上面的。查了事件查看器,下载停止时记录了一个ID为5186的错误事件。通过上网查询到:它表示某个应用程序池的工作进程因为在一段时间内没有收到任何请求(即“闲置超时”),被 Windows 进程激活服务(WAS)主动关闭了。 那么问题就彻底明白了:IIS由于长时间没有外部请求被挂起了。 临时解决办法:把对应应用程序池的【闲置超时(分钟)】参数设置为0,就是永不超时先让客户用着。 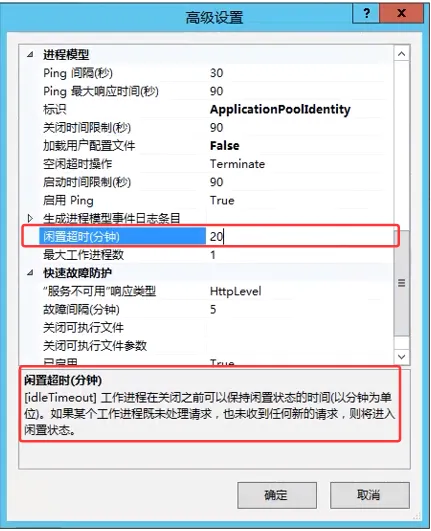
-------------------------------------- 继续思来想去,这样也不是长久之计。 整个下载过程数据全部运行在内存中,万一以后再遇上IIS意外、断电、关机等其他情况,都有可能中断下载过程。一旦内存数据丢失,再也无法重拾下载过程。而这1000多条数据是客户辛辛苦苦选择过滤出来的,让他再去操作一遍你猜他想不想顺着网线来打人。 整个下载程序就是一个空中楼阁,摇摇欲坠。 -------------------------------------- 经过2~3天的构想,我准备重构这个下载程序了。先画了一张流程拓扑图: 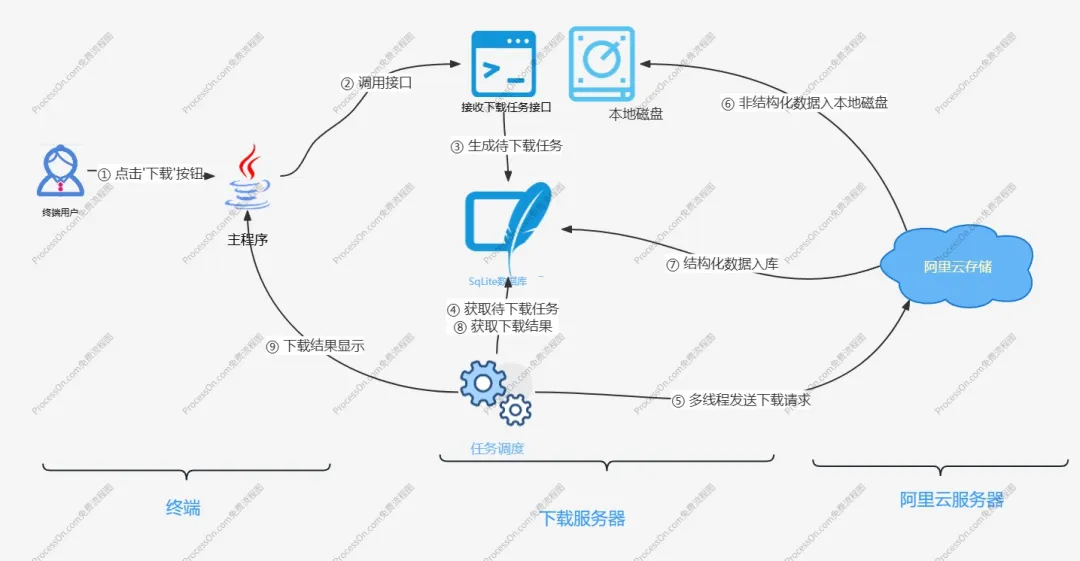
思路解析:核心思想是使程序落地,任何一步步骤都要落地持久化。 步骤1:用户下载“下载”按钮后,发送1000条数据的请求到主程序。 步骤2:主程序不直接执行下载动作。先把这个1000条数据变成1000个任务。 步骤3:把这1000个任务保存到sqlite数据库。默认状态“待下载” 步骤4:主程序获取所有待下载状态的任务 步骤5:分化为10个线程,每个线程100条下载任务 步骤6:各个线程下载完成后,把文件存储在本地磁盘 步骤7:把任务状态设置为“下载完成” 步骤8:当所有文件都下载完成后,获取下载结果 步骤9:把下载成功显示到用户终端。 思路有了,实现起来就是砍瓜切菜,手到擒来。 改进后的程序在这里就不附了,关键看思路。 -------------------------------------- 相比较老程序,重构后的程序有几个优点: 1、多线程的使用极大压缩了下载时长,用户体验改进。 2、各个文件的下载开始时间、下载结束时间、文件路径等过程量可以被监控。原先不可见的心虚的下载过程能真实反映。 3、再也不用对客户的下载过程心惊胆战了。就算程序崩溃,恢复后,可以先查看数据库状态为待下载的数据,再启动下载过程。相当于断点续传。 欢迎斧正,攻击新方案的最薄弱点
//打印日志Logs.WriteLocalLog("LOOP", "即将开始循环,文件总数:" + imgdata.imagelist.Count.ToString());for (int i = 0; i < imgdata.imagelist.Count; i++){//打印日志Logs.WriteLocalLog("LOOP", "即将开始第" + i.ToString() + "/" + imgdata.imagelist.Count + "个文件下载");bool res = DownloadFromCloud(imgdata.imagelist[i].imagePath, task_dt + imgdata.imagelist[i].moduleID, imgdata.imagelist[i].type);if (!res){totalFailed += 1;successFlags.Add(0);continue;}successFlags.Add(1);totalSuccess += 1;}//打印日志Logs.WriteLocalLog("LOOP", "循环下载结束,合计失败:" + Convert.ToString(totalFailed) + ",合计成功:" + Convert.ToString(totalSuccess));