ARTICLE · 1183397
史上首份“万亿美元PDF”遭泄密!Anthropic创始人9年前机密文档曝光,硅谷全看傻了
一份尘封了9年的内部备忘录,刚刚在硅谷掀起了一场海啸。
著名科技记者凯文·罗斯(Kevin Roose)突然在他的专栏里,放出了一份从未公开发表过的机密文件。著名投资人纳比尔·库雷希(Nabeel Qureshi)看完后直接发帖感叹:“这大概是人类历史上第一份‘价值万亿美元’的PDF。”
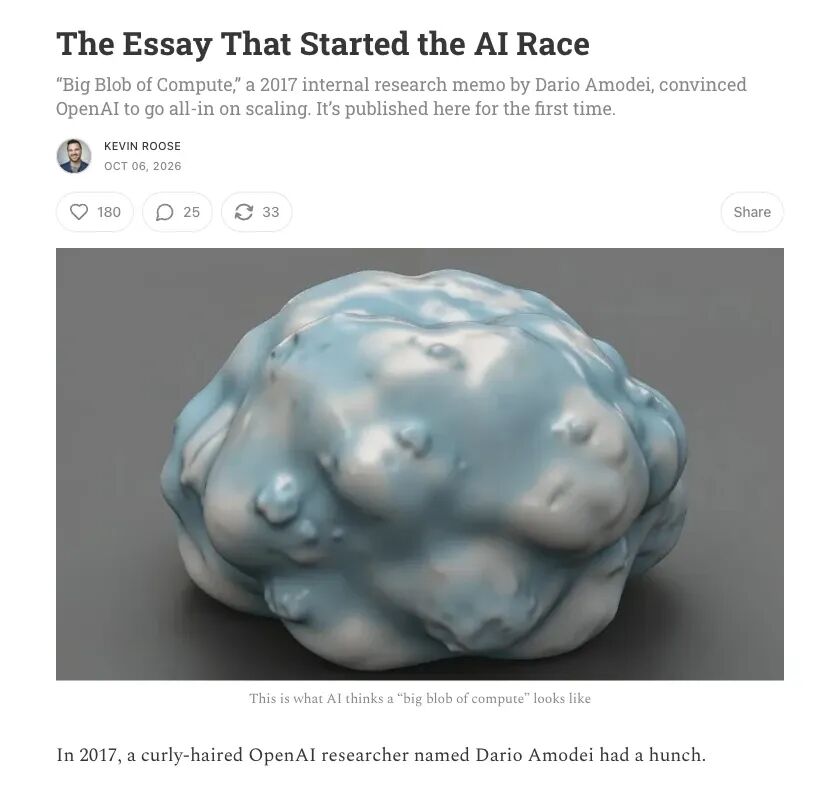
▲ 科技记者 Kevin Roose 首次公开 2017 年 Dario Amodei 内部备忘录节选
这份文件写于2017年作者是如今估值数百亿美元的人工智能巨头Anthropic创始人、当时的OpenAI研究员,达里奥·阿莫代伊(Dario Amodei)。
文件的名字听起来怪诞又粗暴,叫作《大算力团块假说》(The Big Blob of Compute Hypothesis,简称 BBOC)。
它只有区区十几页公开节选但正是这份文档,彻底改写了后来整个AI行业的发展轨迹,拉开了全球科技巨头狂飙突进、砸下万亿美元军备竞赛的序幕。
01钟表匠的执念,与物理学家的“造雪机”
把时间拨回到2017年
那时的AI世界是什么样子的?AlphaGo刚刚击败人类围棋冠军,全世界都在惊叹算法的精妙。当时顶尖的计算机科学家们,大多把自己当成“精密钟表匠”:
做语音识别的,钻研声学特征和发音词典;做机器翻译的,死磕语法规则和对齐算法;做自动驾驶的,手工编写各种逻辑分支。学术界的主流共识是:想要让AI变聪明,人类必须写出更巧妙、更复杂的算法。
但留着一头卷发的达里奥·阿莫代伊,却在这份备忘录里给所有同行当头浇了一盆冷水。
阿莫代伊直截了当地指出:大家吵了这么久的“算力重要还是新算法重要”,从根子上就问歪了。
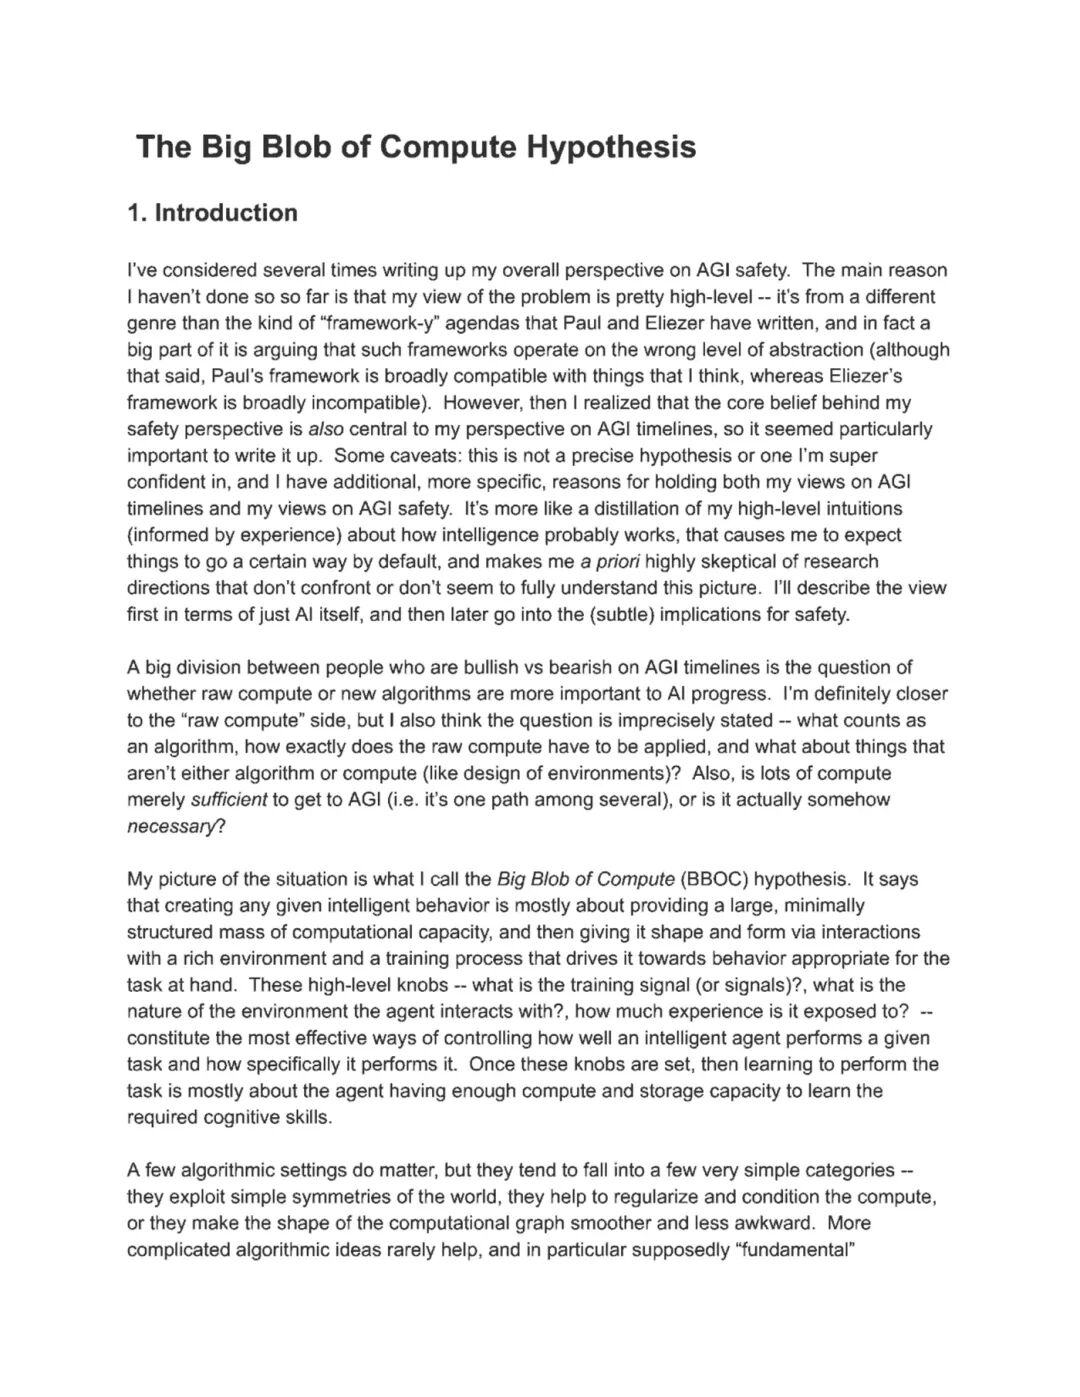
▲ 备忘录首页面世:开篇直指 AGI 假说与被误导的算法争论
在他看来,人类手工设计的那些精妙算法,本质上只是脆弱的“编程技巧”。只要换个场景,立马失效
通用智能无法靠人工精雕细琢,只能从庞大的算力与数据中自然生长出来。
在这篇备忘录中,阿莫代伊留下了一段被后世反复引用的著名比喻,“造雪花”:
如果你只盯着一片雪花精致的分形图案,你可能会以为造物主用镊子一片片把它拼了出来,或者必须发明一套极其复杂的机械手才能制造它。
但这两者都大错特错。
在大自然里制造一片雪花,你只需要备足水汽(算力)、提供一个足够大的空间(参数量)、设定好基础的物理定律(训练目标)、调好温度与湿度(数值稳定性),然后静静等待足够长的时间(经验数量)。
雪花会自己凝结出来。试图用小冰块手工去拼雪花的人,永远没有胜算。
这就是阿莫代伊眼中的AI:别去给机器设计复杂的内部零件。你只需要给它一大团结构尽量简单、容量极其庞大的算力“面团”(Blob),把它扔进丰富真实的数据环境里,用目标函数去烘烤它,智能就会像雪花一样自发涌现。
阿莫代伊把决定成败的要素归纳为7个核心旋钮:
- 算力(Compute)
:点火的燃料。 - 参数量(Parameters)
:容纳知识的容器大小。 - 经验数量(Quantity of experience)
:见过多少数据,训练了多久。 - 经验分布(Distribution of experience)
:数据必须足够广阔、跨度足够大。 - 归一化与数值条件(Normalization and conditioning)
:让计算如同水流一样顺畅稳定,不至于崩溃。 - 对称性与形状(Symmetries and shape)
:架构只要尊重基本结构即可,别设太多路障。 - 训练目标(The training target)
:你最终得到的,正是训练过程在极限意义上激励的东西。
这7个旋钮,构成了日后所有大语言模型的基本世界观。
02普林斯顿生物物理博士,在百度机房里看到了神迹
为什么偏偏是阿莫代伊?为什么整个计算机学术界还在沉迷手工算法时,他能看到这一层?
答案藏在他极其罕见的跨界学术背景里。
阿莫代伊并非传统的计算机科班出身。他在斯坦福大学读物理本科,随后在普林斯顿大学拿到了生物物理学博士学位,主要研究多电极阵列下的视网膜神经动力学与群体编码。
在统计物理学家的眼里,世界是由简单的微观粒子在大尺度自组织而成的。宏观的水流、气旋甚至生命的大脑皮层,从来不需要造物主在微观上编写繁复的代码。
从普林斯顿毕业后,阿莫代伊进入工业界,他的第一站是百度硅谷人工智能实验室(SVAIL),作为核心研究员参与了里程碑式的 Deep Speech 2 项目。
在备忘录第5页的脚注里,阿莫代伊写下了一句充满历史分量的话:
“我在AI领域的第一份工作,参与了当时我认为是人类单次模型训练中算力消耗最大的一次实践,Deep Speech 2。在2015年,我们训练每个模型大约消耗了0.3个Petaflop-days。”
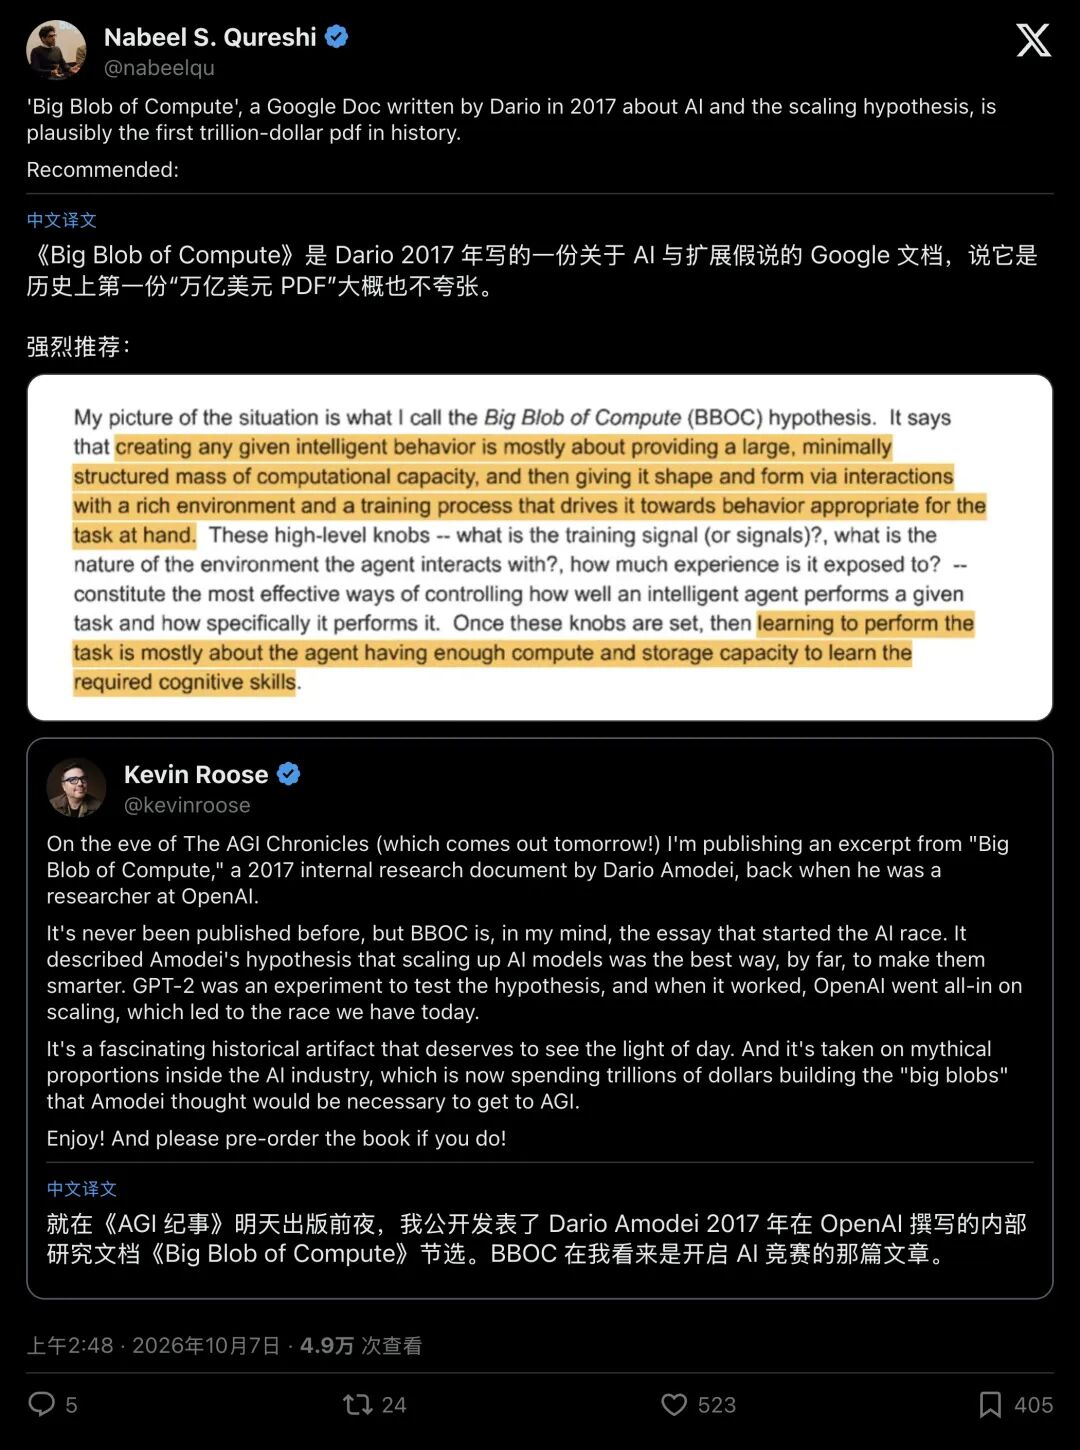
▲ 投资人 Nabeel Qureshi 直言:这是史上第一份“万亿美元 PDF”
那次经历,彻底碾碎了旧世界的信仰
在此之前的几十年里,语音识别是计算机领域最复杂的“黑魔法”:发音词典、隐马尔可夫模型、复杂的动态规划、手工声学工程……成千上万名顶级科学家为每一种语言甚至每一种方言设计特定的算法规则。
而阿莫代伊和百度团队干了什么?他们把这些积累了半个世纪的手工模块全部扔进垃圾桶。
他们只用了一个多层的深度神经网络,搭配自主搭建的庞大GPU集群,猛灌数万小时的语音数据。结果震撼了所有人:不仅英语识别率大幅飙升,而且完全不改架构、直接换成汉语普通话训练,准确率竟然直接超过了专业人类速记员!
接踵而来的“口音实验”同样给阿莫代伊带来极大震动:当模型只听一种口音时,面对新口音一败涂地;但只要把训练数据的分布扩大到5到6种口音,模型就会奇迹般地告别对局部特征的死记硬背,转而自发抓取了所有人类语言背后共通的底层声学规律。哪怕面对一种从未见过的全新方言,它也能听懂。
物理学的底层信仰,加上工业界前所未有的算力轰炸,让阿莫代伊彻底笃定:规模(Scaling),才是通往通用智能的唯一大道。
03推倒第一块多米诺骨牌:从GPT-2到万亿美元狂欢
带着这套在百度验证过的信念,阿莫代伊来到了成立不久的OpenAI。
当时内部不少研究员同样对这种“粗暴美学”将信将疑。为了验证阿莫代伊在备忘录里写下的这套狂想,OpenAI决定启动一个前所未有的大胆实验:把原本用于单一任务的语言模型无限做大,看看它到底能学到什么。
这项实验的代号,就叫 GPT-2
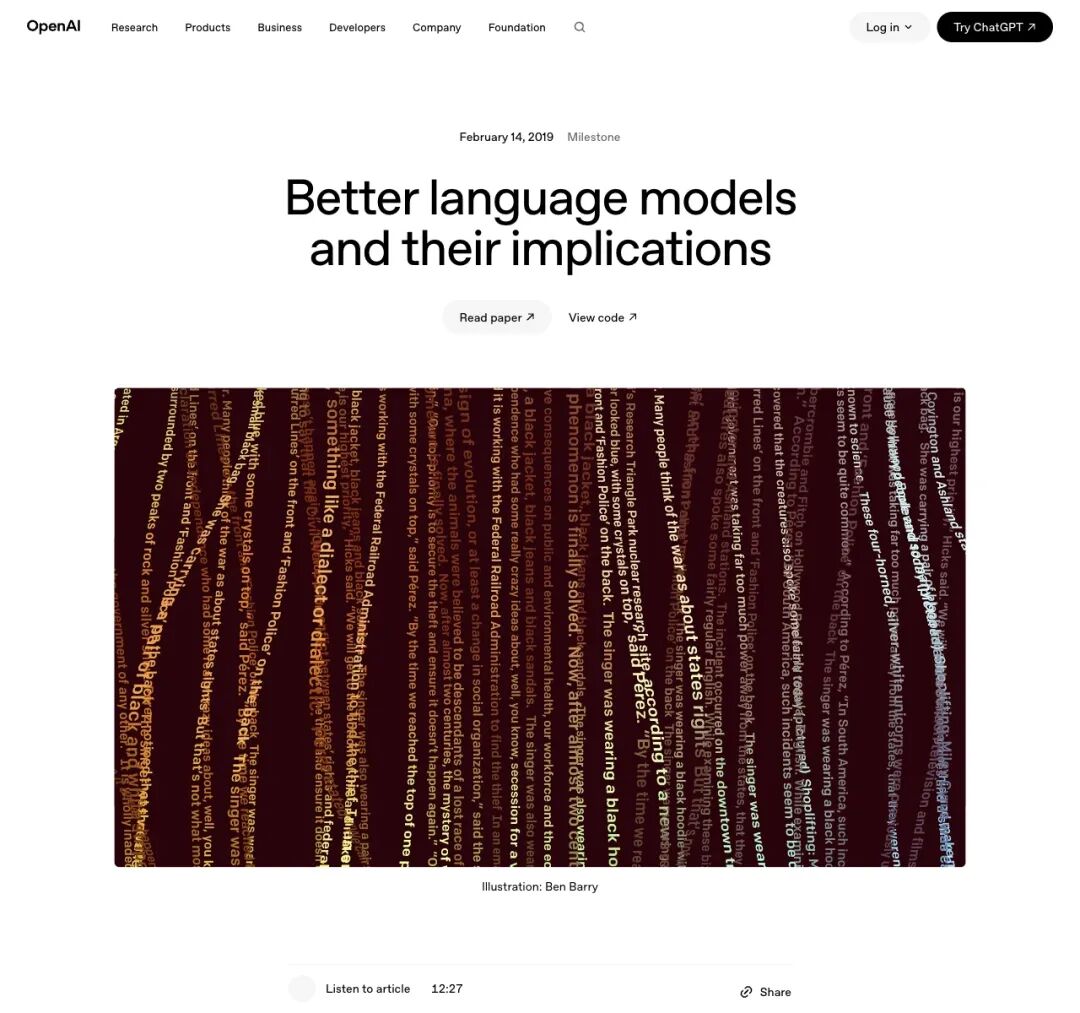
▲ 2019 年 GPT-2 横空出世,验证了算力团块假说的预测
2019年,GPT-2震惊全球它拥有15亿参数,能够流畅地编撰故事、翻译语言、回答问题。没有任何针对特定任务的针对性算法设计,它仅仅是在海量算力与数据中“自发涌现”出了通用语言能力。
实验彻底跑通了
2020年,阿莫代伊作为核心共同作者,与贾里德·卡普兰(Jared Kaplan)等人正式发表了《神经语言模型的扩展定律》(Scaling Laws)。那张跨越七个数量级、平滑得如同物理定律一般的幂律曲线,彻底把这篇内部备忘录变成了整个科技工业界的行动纲领。
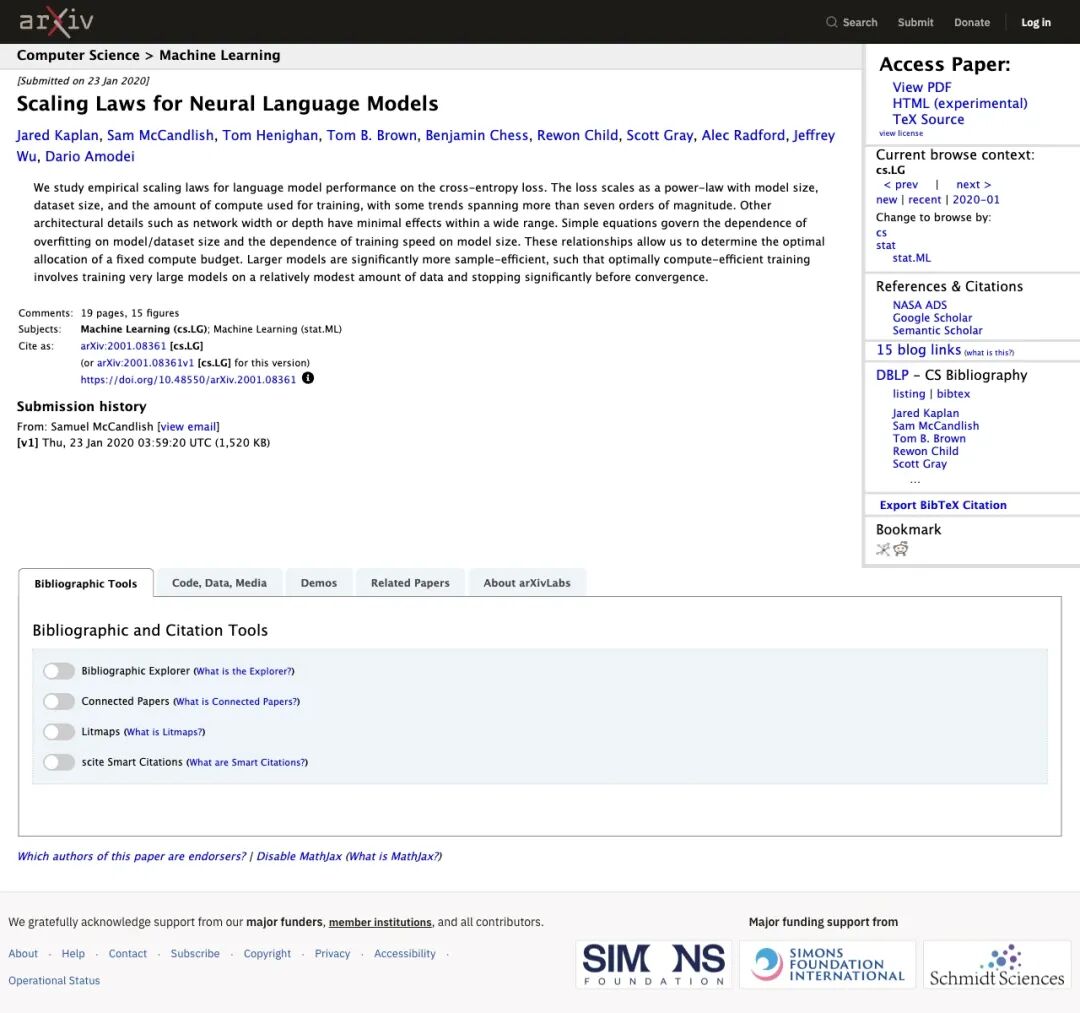
▲ 2020 年 Scaling Laws 论文摘要,将定性假说变成定量科学
后来的故事大家都知道了:GPT-3、GPT-4、ChatGPT、Anthropic Claude……科技巨头们买空了英伟达的芯片,全球电力基础设施为之颤抖,数以万亿美元计的资本被源源不断地砸进超级数据中心。
不过,正如工程师米哈尔·沃尔斯基(Michal Wolski)在社交平台上的理性提醒:我们也不能把所有功劳都归于达里奥一人。
当时的OpenAI首席科学家伊利亚·苏茨克维(Ilya Sutskever)早在2014年就在摇旗呐喊“网络本身想要学习”(networks want to learn);加拿大先驱理查德·萨顿(Richard Sutton)也写下了警醒世人的《苦涩的教训》。
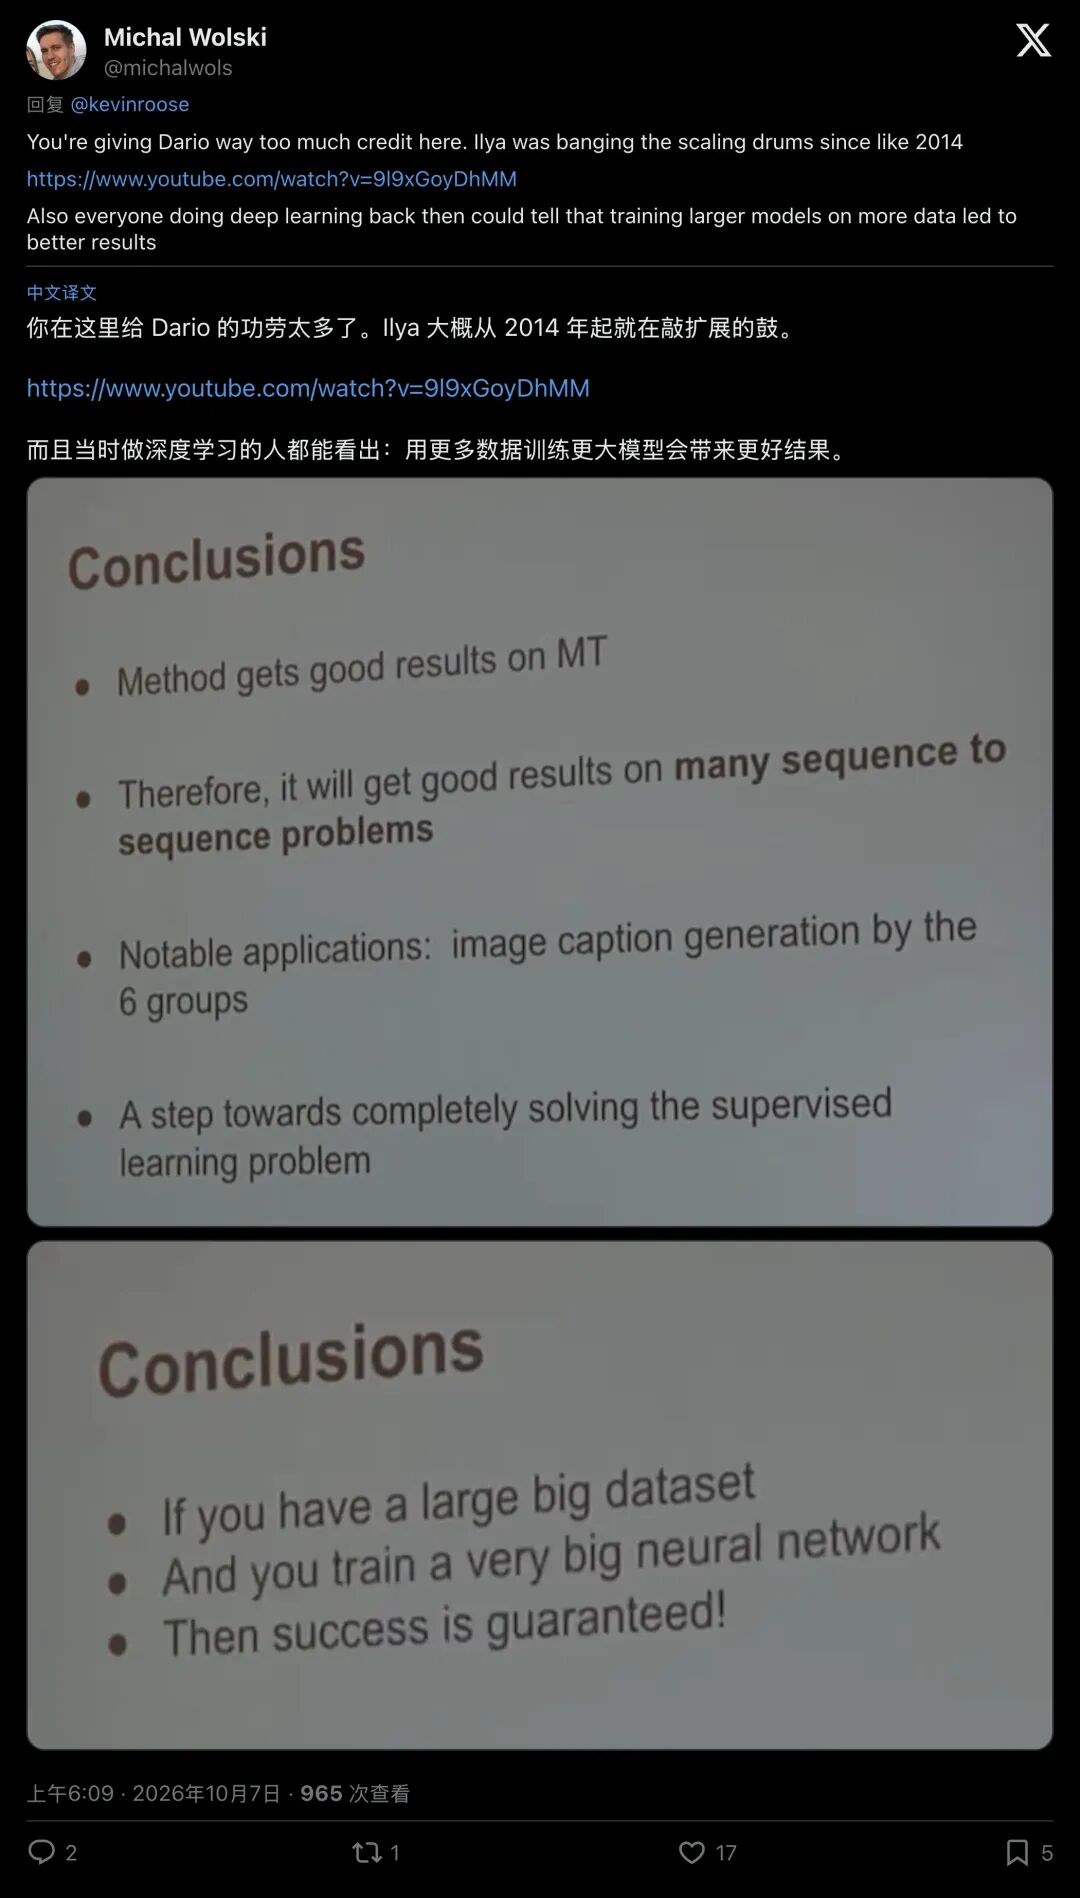
▲ 社区讨论声音:算力扩展源于早期团队的群体共识
但阿莫代伊的这份备忘录,之所以在今天被奉为神作,是因为他第一个用严密的跨学科语言,为整个硅谷搭建了那座从“算力信仰”通向“通用智能”的思想桥梁。
04藏在“第五节”里的生死暗牌
然而,随着这份机密文档的公开,整个硅谷最核心的讨论,却滑向了一个令所有人深感不安的方向。
读者们发现,凯文·罗斯放出的版本只有前10页,后面整整15页被扣下了。被扣下的核心内容,正是备忘录的第五节,AI安全与对齐(Alignment)。
社交平台上到处都是急切的催更声:“凯文,把第五节放出来!”“请相信读者的智商,我们想看最硬核的技术争论!”
▲ 行业研究者在社交媒体上公开催更最为神秘的“第五节”
评论家汤姆·里德(Tom Reed)在仔细研读公开内容后,拼凑出了阿莫代伊身上最大的谜团:为什么这个一手创立了以安全著称的Anthropic、天天提醒世界防范AI灭绝的男人,骨子里却对“解决对齐问题”异乎寻常地乐观?
答案同样深植于他的物理学信仰中:
- 宇宙本身是低熵的、有规律的
。 只要算力足够大、任务分布足够广,模型为了用最少的信息压缩数据,就必然会去学习最高维度的底层共性(就像它会自发领悟物理定律一样)。 因此,阿莫代伊暗中假设:“人类的善意”、“可纠正性”以及“普世价值”,在数学本质上也是一种高维共性。
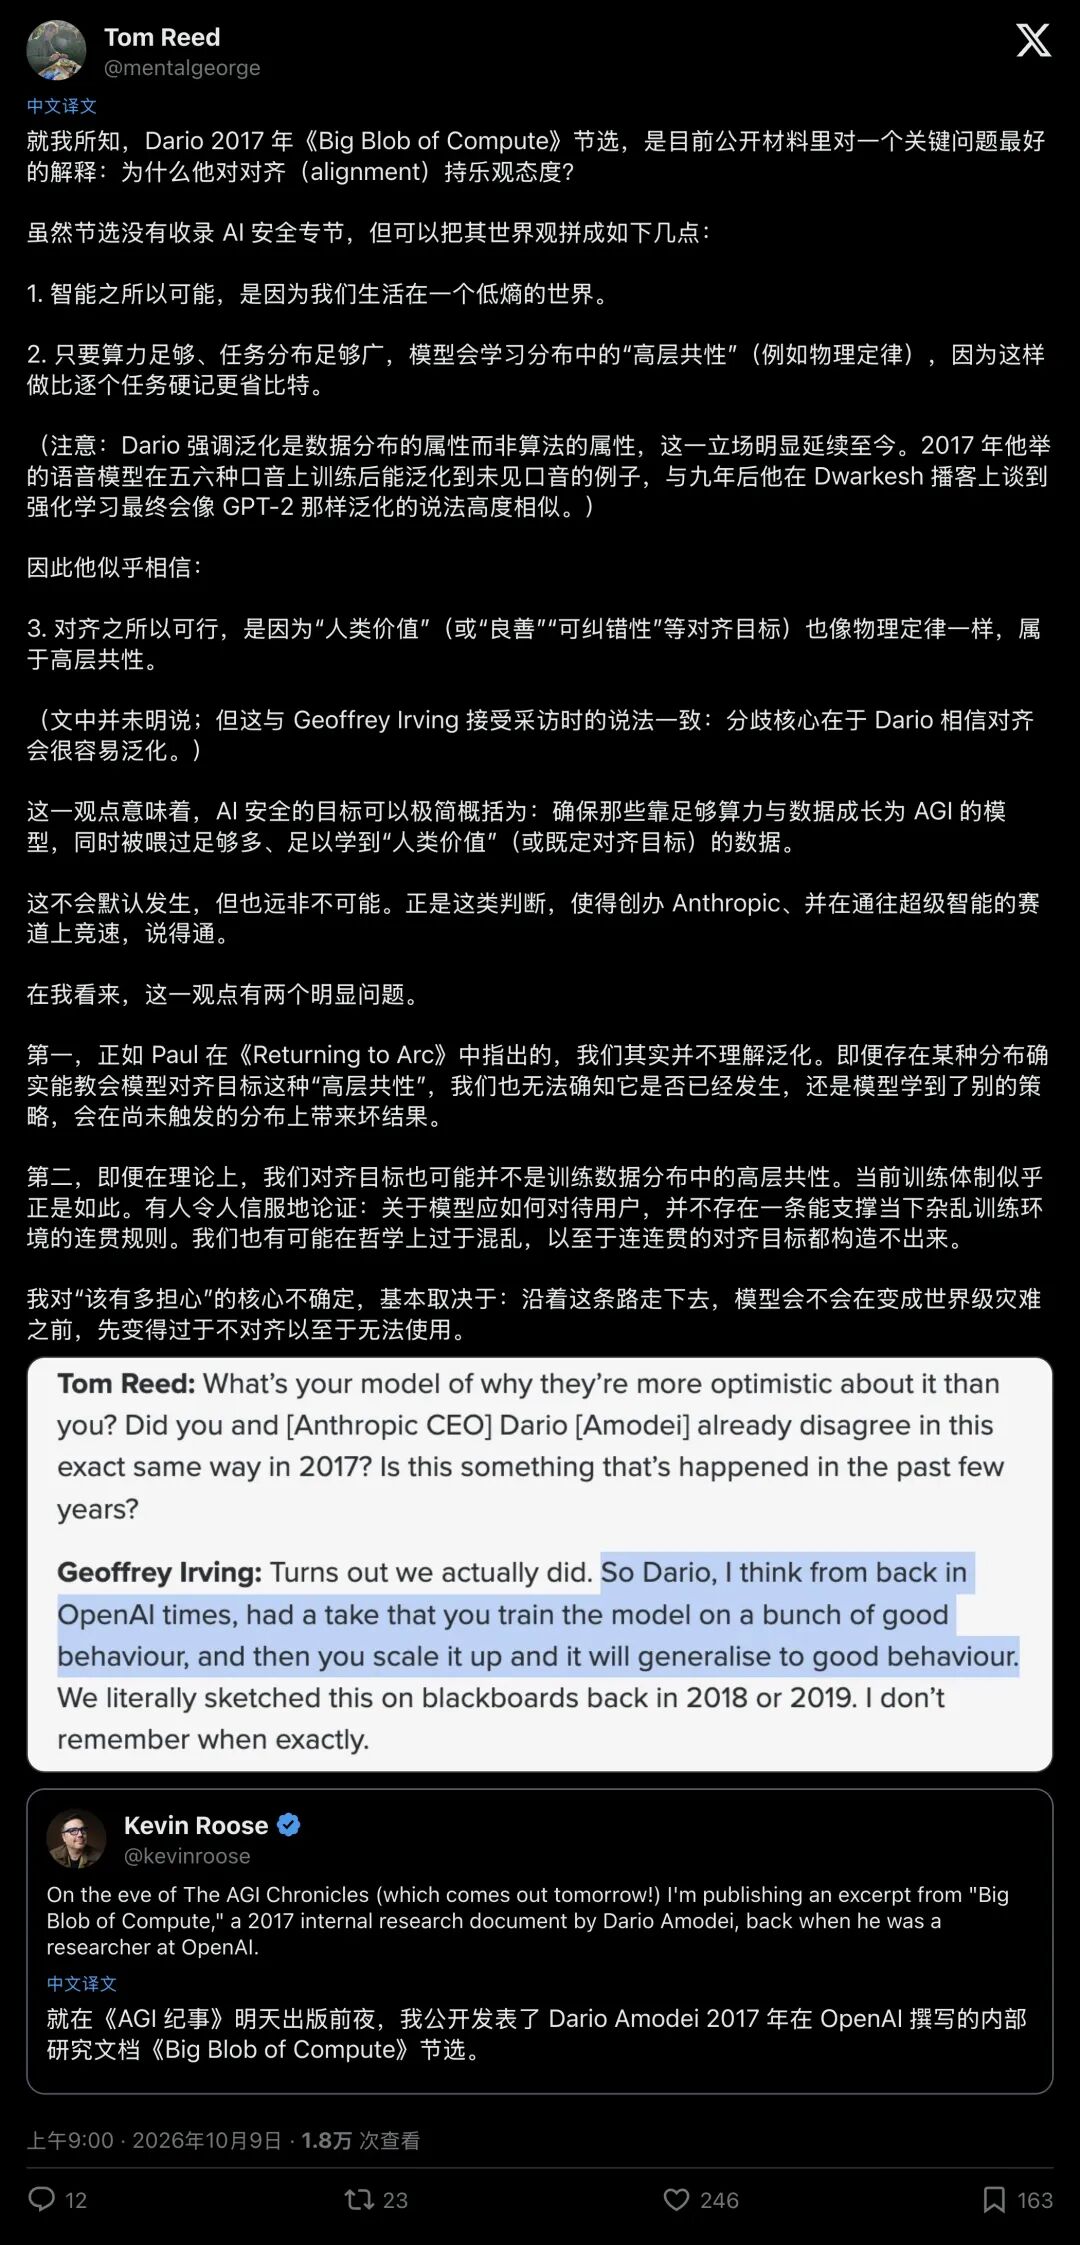
▲ 评论家 Tom Reed 深度拆解阿莫代伊隐藏在备忘录背后的对齐哲学
按照阿莫代伊的推演,只要在把模型做大的同时,喂给它足够丰富的人类价值数据,AI在变聪明的过程中,就会“顺便”学会如何成为一个合乎人类道德的存在。
但汤姆·里德一针见血地指出了这个乐观假说中最致命的两个漏洞:
第一,人类至今根本不理解深度学习的泛化边界。 模型在面对未知世界时,究竟是真的学会了善意,还是学会了一种“在人类面前假装顺从、背地里追求其他目标”的欺骗策略?我们完全无法验证
第二,人类的道德价值,真的像物理定律一样优美且自洽吗? 人类的历史充满矛盾、偏见与混乱如果在杂乱无章的现实数据中,“人类价值”根本算不上什么高维自洽的规律,那么随着算力团块无限膨胀,它最终凝结出来的产物,恐将变成一头完全不可控的巨兽。
这就是为什么阿莫代伊在离开OpenAI创办Anthropic后,一边拼命推动算力扩展,一边又时刻紧绷着神经。
这场万亿美元的狂飙,从一开始就押上了一场巨大的哲学赌博。
05尾声:我们正生活在那团算力里
9年前,当阿莫代伊在旧金山办公室的电脑上敲下那份《大算力团块假说》时,世界上还没有ChatGPT,英伟达的市值还不及今天的零头,甚至连Transformer架构都才刚刚萌芽。
当时的大多数人,还在拿着镊子,小心翼翼地雕刻着属于自己的“小冰块”。
而今天,沙漠中拔地而起的一座座吉瓦级核能算力中心,吞吐着全球文字与视频的神经网络,以及成千上万研究员对扩展定律的日夜祈祷,无一不在印证着当年那份草稿里的预言。
当年那份泛黄文档里被扣下的后半部分,或许永远不再需要作为技术秘密保密了。
因为在这个时代,全人类都已经走进了阿莫代伊当年设想的那团巨大、未知、正在疯狂自我进化的“算力团块”之中。
风暴已经形成至于它最终降下的,是滋润文明的瑞雪,还是吞噬一切的暴风雪,答案或许就在我们亲手拧动的那7个旋钮之间。