ARTICLE · 1191655
Hermes 本地模型下载太慢?把货搬到它家门口就好了
进度条半小时走了 31MB · 把下载救回来了
官方 CDN 镜像按哈希寻址,把文件提前摆进 Hermes 的仓库目录,安装时它自然跳过下载。
不换源、不代理,四步把 590MB 运行时装好
01
PART
一个几乎不动的进度条
THE STUCK PROGRESS BAR
Hermes 桌面端最近的本地模型功能,是真的值得玩。一句话介绍,它让你在自己电脑上跑开源模型,不用注册账号,不用API key,一分钱不花,数据一个字节都不出你的机器。设置里点开本地模型,选一个模型,下载,点 Use,新对话就跑在本地了。你那张吃灰的显卡突然就有了正经工作。
而且它把最烦人的部分都替你干了。选模型之前会先对着你的硬件报价,绿色是塞得进显存,黄色是要吃内存但能跑,红色是想都别想。上下文窗口多大、GPU 分几层、量化选哪种,你全不用管。
但有个问题。国内用户第一次点「安装运行时」,大概率会看到一个几乎不动的进度条。
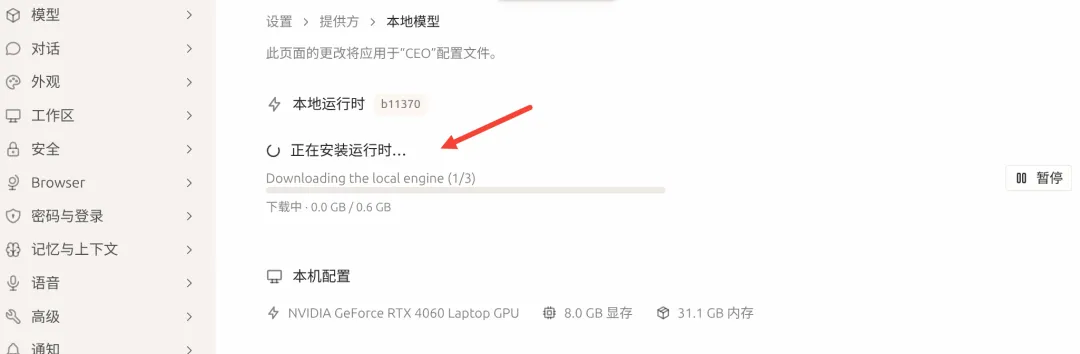
安装运行时卡住不动的进度条截图
我自己的惨案是这样的。昨天晚上我想试试本地跑MiniCPM5-2B,点了安装,然后去泡了杯茶,回来看了一眼,三十分钟,走了 31MB。我算了一下,按这个速度把 590MB 的运行时下完,天都亮了。我当时就愣住了。
后来我才知道,Hermes 的推理引擎是从 GitHub Releases 下载的。懂的都懂,国内直连 GitHub 的下载速度,属于薛定谔的网速,有时候还能爬,有时候直接超时。这不是 Hermes 的锅,但它确实挡在了「想用」和「用上」中间。
02
PART
先搬现成的,此路不通
DEAD END
我的第一反应特别朴素,我电脑上装着 LM Studio 啊,它里面就有llama.cpp引擎,复制过来不就完了?
去翻了一下,LM Studio 的后端目录里确实躺着一套完整的llama.cpp,连 CUDA 加速的都有。
可惜,不行。
原因说起来就两三行。Hermes 装引擎的时候会校验每个文件的SHA-256哈希,锁死的是官方发布的那个构建包。LM Studio 的二进制是人家自己编译的另一套东西,还捆着一堆自家的私有库。哈希对不上,文件结构对不上,Hermes 不认。
至于模型文件,倒是真能搬,同一个GGUF文件字节一样就能用。但我打开 LM Studio 的模型库看了一眼,空的。它里面就一个自带的向量模型,没得搬。
这条路堵死了。那还是得下载,问题是,怎么下得快一点。
03
PART
转折,镜像就写在源码里
THE TURNING POINT
转折来得有点突然。
翻 Hermes 包管理器源码的时候(对,它是开源的,这点真的很加分),我看到了一行注释,大意是「下载失败时回退到官方镜像」。
???
它有镜像。
一个按文件哈希寻址的官方 CDN 镜像,你给它一个哈希,它给你对应的文件。实测下来单线程能跑到每秒 1MB 左右,开 16 个线程并发拉,速度还能再往上翻。
那问题就变成了,怎么让 Hermes 走镜像,而不是死磕 GitHub。
再往下翻,我看到了更关键的一句,「如果目标位置已经有校验通过的文件,直接跳过下载」。
我当时就懂了。它有个仓库目录,里面要是已经躺着对的文件,安装的时候根本不会再联网。
我不需要说服它换路。我只需要把货提前搬到它家门口。
后面就是纯体力活了。整个过程我自己跑了一遍,从动手到装完,十几分钟,其中大半是下载时间。下面把每一步都摊开,你照着做就行。
04
PART
四步,把货摆到它家门口
FOUR STEPS
先说一下接下来的计划。一共四步,找到 Hermes 要的文件清单,用镜像把文件拉下来,放进它的仓库目录,触发安装。最后再顺手把模型也放好。全程用 Linux 命令,我是在 Linux Mint 上验证的,macOS 大同小异,Windows 用户路径要自己换一下。
Hermes 的包管理器有一个锁定文件,里面记着每个组件的下载地址和校验哈希。本地模型的推理引擎在里面叫llamacpp-cuda(N 卡用户就是它,A 卡是llamacpp-hip,纯 CPU 是llamacpp-cpu)。
python3 -c "
import json
d = json.load(open('/home/kookboy/hermes-agent/pm/lock.json'))
for a in d['packages']['llamacpp-cuda']['artifacts']['linux-x64']:
print(a['sha256'], a['url'])
"
跑完你会看到三行,每行是一个文件的哈希和地址,一般是一个 150MB 左右的主程序包,一个 400MB 左右的 CUDA 运行时包,再加一个小工具包。这一步的作用,就是拿到「买菜清单」,后面全靠它对账。
提示路径里的hermes-agent就是你的 Hermes 安装目录。找不到的话搜一下lock.json这个文件名,它藏在安装目录的pm文件夹里。
装一个多线程下载工具aria2c,Ubuntu 和 Mint 直接apt装。
sudo apt install aria2c
然后对着上面拿到的每个哈希,用这个格式下载,镜像地址的规律很简单,就是CDN 域名加上哈希值本身。
aria2c -x 16 -s 16 -k 4M --file-allocation=none -d ~/下载目录 \
-o 文件名 \
"https://hermes-assets.nousresearch.com/upstream/sha256/这填文件的哈希"
三个文件挨个来。速度大概在每秒 1 到 2MB,590MB 总共几分钟的事。跟我那 30 分钟 31MB 的进度条比,这种感觉太爽了。
下载完先对一遍哈希,防止文件在路上坏了。这步别省,几秒钟的事。
cd ~/下载目录
sha256sum *
屏幕上打出来的哈希,跟第一步清单里的逐个比对,一个字都不能差。
对上了,就搬进 Hermes 的仓库目录。规矩是这样的,每个文件单独放一个文件夹,文件夹名字是fetch-加上这个文件的哈希,文件本身保持下载时的文件名。
mkdir -p ~/.hermes/tools/fetch-文件哈希
mv ~/下载目录/文件名 ~/.hermes/tools/fetch-文件哈希/文件名
三个文件,三个文件夹。这个结构是 Hermes 源码里定的,只要摆成这样,它就会认为「这文件我已经下好了」。
最后一步,喊它来收货。
cd ~/hermes-agent
PYTHONPATH=. python3 -m pm.cli install llamacpp-cuda
如果你看到一个绿色的对勾和llamacpp-cuda字样,就成了。整个过程应该在几秒钟内结束,因为所有文件都已经在它仓库里躺着,它只需要解压和登记。
验证一下,跑一句引擎自带的版本查询。
~/.hermes/tools/llamacpp-cuda-11370-linux-x64/llama-server --version
能打出版本号,运行时就正式打通了。
05
PART
模型,其实不用下
MODELS
运行时只是发动机,模型才是货。这部分有个好消息,如果你手上已经有GGUF格式的模型文件,直接复制就行。
cp 你的模型.gguf ~/.hermes/models/
就这样。这个目录的规矩简单到离谱,放进去就能被识别。文件名最好保留模型本来的名字,比如MiniCPM5-2B-F16.gguf,Hermes 靠名字认人。
我这次就是把之前下载好的MiniCPM5-2B-F16.gguf(4.7GB)复制进去,回到桌面端设置的本地模型页面,模型已经在已下载列表里了,点 Use,直接开跑。
06
PART
三个坑,替你踩过了
THREE PITFALLS
后台命令跑在 zsh 下面
写脚本的时候别用bash的老习惯。比如rm -f *.aria2这种写法,在zsh里没有匹配文件会直接报错,整条命令全部中止。老老实实写完整的文件名,稳。
别中途打断下载会话
长时间下载的时候别中途打断会话。我第一次挂后台下载,中途被别的事一打断,下载进程跟着被连带杀掉了,还好断点还在。经验是,重要的下载就放前台一条条跑,稳得很。
残渣文件别手痒去删
下载过程中的残渣文件别手痒去删。在~/.hermes/cache/partials里会躺着一些断点文件,看着碍眼,但那是Hermes 自己的记账本,让它自己的清理机制去处理,手动删反而容易出怪问题。
///
END
一点后话
AFTERWORD
坦率的讲,这套方法有点「绕路手术」的意思。理想情况下,Hermes 应该开箱就把镜像设成默认源,或者至少给个换源的开关。我相信以这个项目的更新速度,这个问题迟早会被官方修掉,到时候这篇文章就可以退役了。但在今天,它就是能解决问题。而且这套思路不只对 Hermes 有用。你想想看,任何锁定 GitHub 下载、又提供哈希校验的开源工具,理论上都能用同样的办法加速,找到清单,镜像拉货,校验,摆到它认的位置。工具在变,「货要摆对地方」这个理不变。
说实话我自己也还在摸索,比如以后引擎出新版本了,这套流程要不要原样再来一遍,我还没实测。但方法是通用的,新版本就是新的哈希、新的文件,照方抓药。
机器是自己的,模型在自己显卡上跑,第一个字蹦出来的时候,你会觉得,这玩意现在真的就在我手心里。大时代啊,朋友们。
我是孤风,热衷于分享 AI 观察与干货。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见
THANKS FOR READING