ARTICLE · 1193284
四天25万星:REA给AI装上逆向神力,软件真的没有黑盒了吗?
大家好,我是三go。
一个开源项目,四天涨了 20 万颗 GitHub Star。
它叫 REA(Reverse Engineer Anything)。
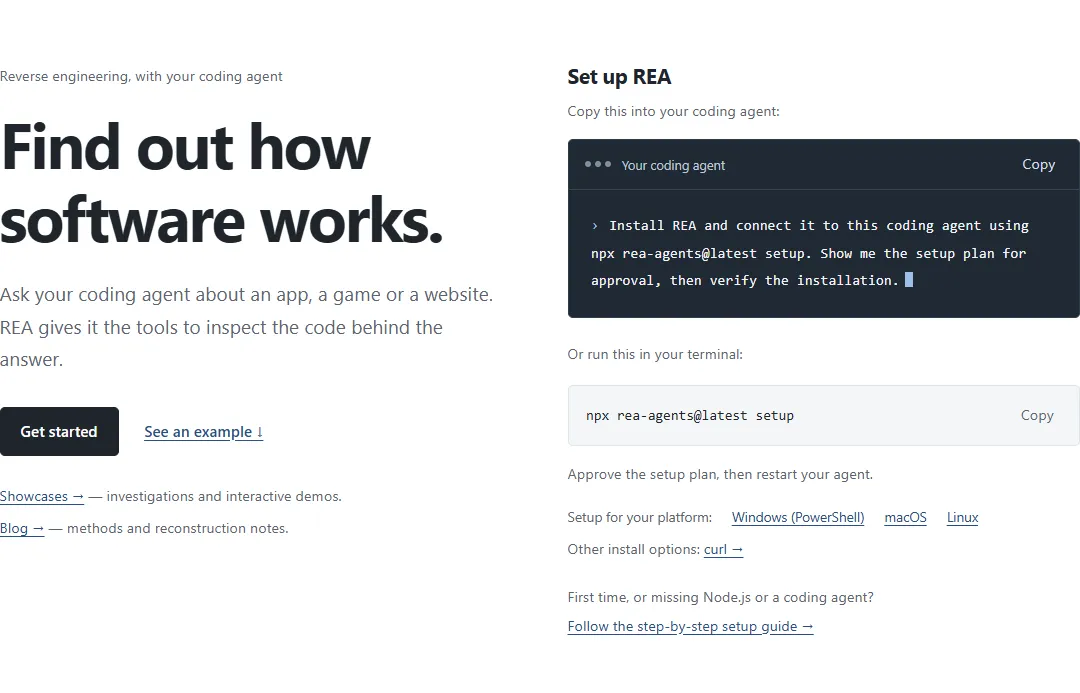
图 01 · 官网首页:装 REA 的两条命令
10 月 10 日,国内社区报道它时还只有约 5 万星;到 10 月 15 日,GitHub API 实测已经冲到 252,326 Star、63,377 Fork。
仓库今年 4 月就创建了,安静了大半年,10 月初突然点火。
为什么?
因为它干了一件以前听起来很像“专业人士专属技能”的事:
把逆向工程工具链,接进了 AI Agent。
以前你想搞懂一个闭源软件,得找 Ghidra、IDA、JADX 这些专业工具,再靠逆向工程师自己一点点分析。
现在,你可以直接告诉 Agent:
“帮我搞懂这个功能是怎么实现的,给我证据,然后复现出来。”
这件事真正让人兴奋的,不是 AI 突然学会了逆向。
而是:AI开始学会调用逆向工程师手里的工具了。
01
REA到底是什么?
逆向工程,就是你手里没有源代码,却想搞懂一个已经编译好的软件到底是怎么工作的。
比如:
一个游戏的弹道怎么算?
一个 App 的搜索功能怎么实现?
一个固件里面藏着什么?
一个二进制程序某个函数到底在干什么?
以前这些工作基本属于专业逆向工程师。
他们需要使用 Ghidra、IDA、Hopper、JADX 等工具,从二进制、汇编、调用关系、数据结构里一点点往回推。
难点从来不只是“看懂一段汇编”。
而是:你得知道下一步应该查什么。
REA做的事情,就是把这套工作流交给 Agent。
它本身并没有重新发明一套逆向引擎。
它更像一个“中间层”:
把现有逆向工具封装起来,通过 MCP 接给 Claude Code、Codex、Cursor、Gemini CLI 等 Coding Agent。
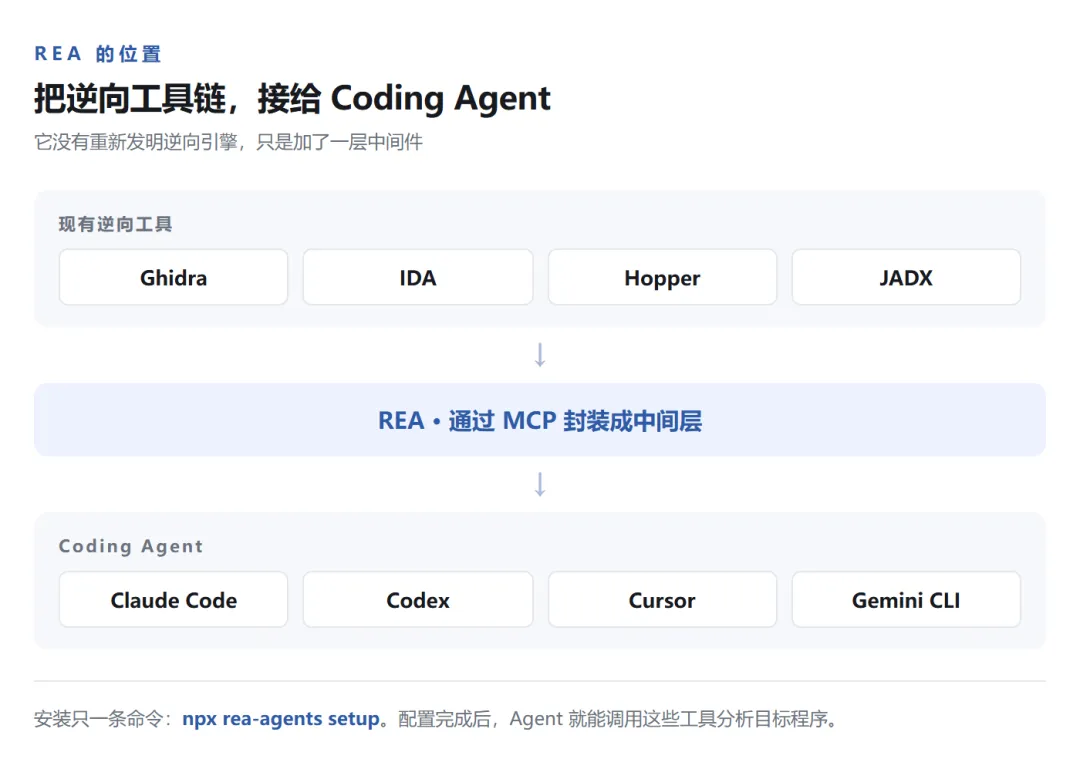
图 03 · 工具经 MCP 中间层接给 Agent
安装也很简单:
npx rea-agents setup
配置完成后,Agent 就可以调用这些工具,对目标程序进行分析。
于是以前的流程:
人提问 → 人操作工具 → 人看结果 → 人提出下一步假设 → 人继续分析
开始变成:
人提问题 → Agent 调工具 → 读取证据 → 建立假设 → 再调用工具验证 → 实现 → 测试
这才是 REA 最值得关注的地方。
它不是把 Ghidra 变强了,而是让 AI 开始拥有了一套可以反复调用、验证的逆向工作流。
02
AI现在能把软件拆到什么程度?
官方 Showcase 里有两个很典型的案例。
一个是 DX-Ball。
这是 2000 年代经典的弹球游戏。
REA 的 Agent 从游戏中的一条音效调用一路往下追,最终分析出:
砖块在屏幕上的横向位置,会影响声音的左右声道。
最开始的反编译结果并不完整。
Agent 又回到底层指令、调用方和数值常量继续调查,最后重建出对应的 C 函数。
官方记录的验证结果是:
3205 组输入与原始 x86 函数一致,并且指定编译器生成的函数实现实现了全部 63 个字节的复现。
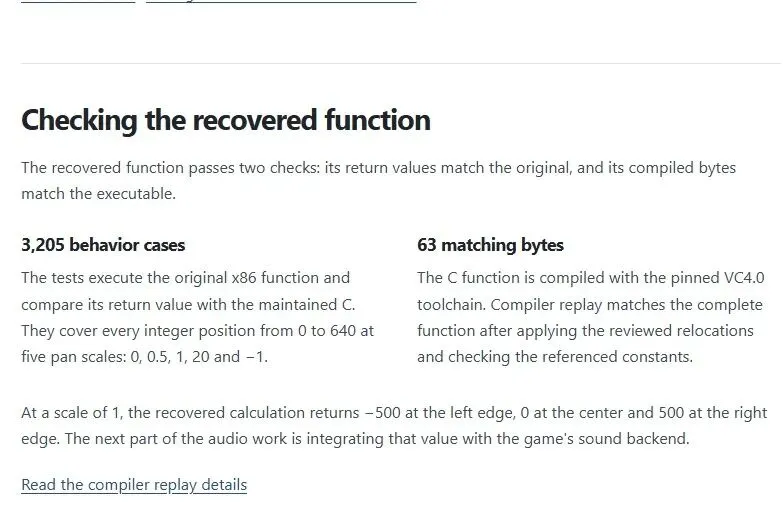
图 04 · 官方验证:3,205 组输入、63 字节
这就不是“AI看着汇编给你猜一段伪代码”了。
而是:
分析 → 提出假设 → 找证据 → 重构 → 测试验证。
另一个案例是 Notion Desktop。
Agent 对应用包进行分析,沿着页面 API、预加载脚本和进程通信一路追踪,最后定位到桌面端剪贴板相关的实现逻辑。
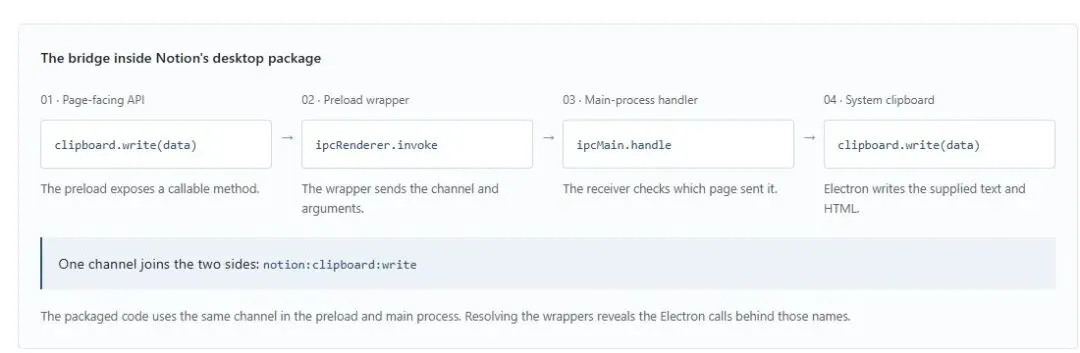
图 05 · 官方案例:Notion 剪贴板的四段链路
这两个案例刚好代表了两个方向:
一个偏底层二进制和算法。
一个偏应用架构和高层逻辑。
而这恰恰说明:
REA真正想解决的,并不是“反编译”三个字,而是“调查一个已经存在的软件”。
03
但有一件事必须说清楚:REA没有“逆向一切”
它的名字叫 Reverse Engineer Anything。
但别真的按字面理解。
社区里已经有人指出一个非常关键的问题:
真正强大的,未必只是 REA,而是后面的 AI 模型。
这话其实有道理。
你不用 REA,直接把 Ghidra、x64dbg、其他工具接起来,再配合一个能力足够强的模型,同样可以做很多逆向工作。
所以 REA的价值,不是:
“以前做不到的逆向,现在 REA 做到了。”
更准确的说法是:
以前已经存在的专业逆向能力,现在被重新组织成了 AI Agent 可以调用的工作流。
这两句话,看起来只差一点,实际上差别很大。
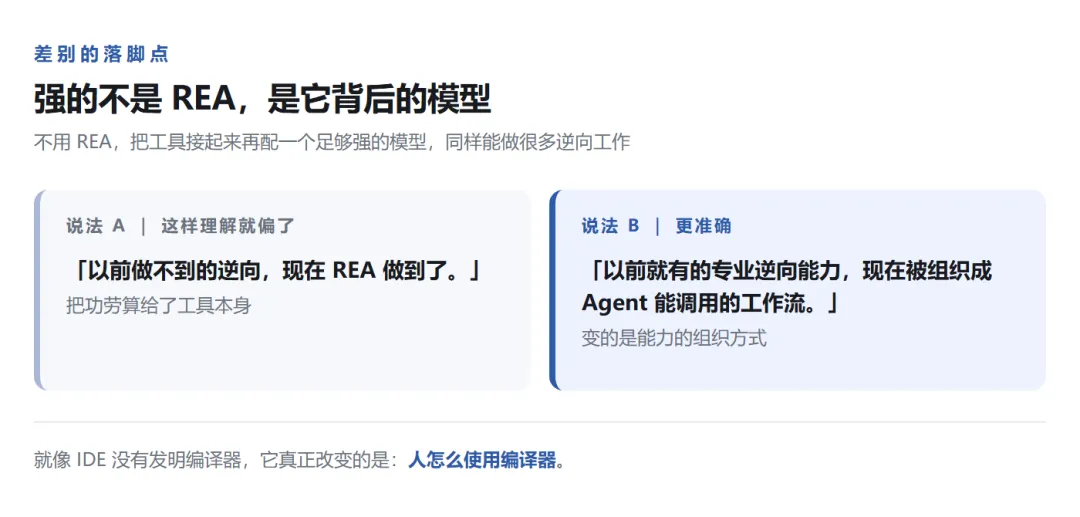
图 06 · 强的不是 REA,是背后的模型
就像 IDE 没有发明编译器。
它真正改变的是:
人怎么使用编译器。
REA也是如此。
它让 Agent 不再只是“看一段代码然后回答问题”,而是开始进入一个真正的调查循环。
04
而且,AI能拆的东西,取决于你能拿到什么
这一点也非常容易被标题带偏。
如果是桌面 App、前端 Bundle、Android APK、本地二进制、固件,那么你至少拥有一个可以被分析的目标。
但如果核心逻辑全部运行在服务器上呢?
你拿到的可能只有:
客户端 + API + 返回结果。
服务器上的核心业务逻辑、数据库、内部算法,并不会因为装了 REA 就凭空出现。
同样,混淆、加固、反调试、虚拟化保护,也依然会增加逆向难度。
所以,REA降低的是逆向工作的操作门槛,不是把所有技术壁垒直接抹掉。
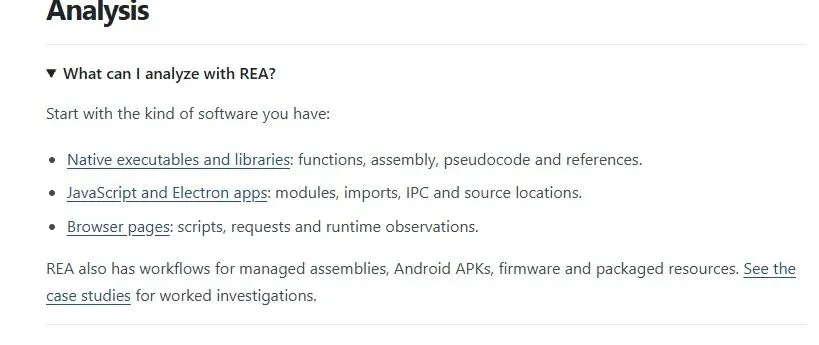
图 07 · 官方 FAQ:REA 能分析什么
这也是为什么有人实际使用后觉得“很神”,有人却觉得“效果一般”。
模型能力、目标类型、工具链、保护强度,都会影响最后的结果。
05
真正需要我们关注的,是软件正在变得“没那么黑盒”
但即便如此,我还是觉得 REA 值得关注。
因为它改变的是一个过去默认存在的前提:
只要不给你源码,你就很难真正理解我的软件。
这个前提正在变得越来越脆弱。
以前你做一个功能,别人想复制,至少得:
看界面、猜逻辑、抓行为、慢慢试。
现在则可能变成:
拿到客户端 → Agent 分析 → 找到关键函数 → 建立调用关系 → 验证算法 → 复现。
复制的成本正在下降。
所以我更愿意把它说成:
软件不是突然没有黑盒了,而是黑盒正在变薄。
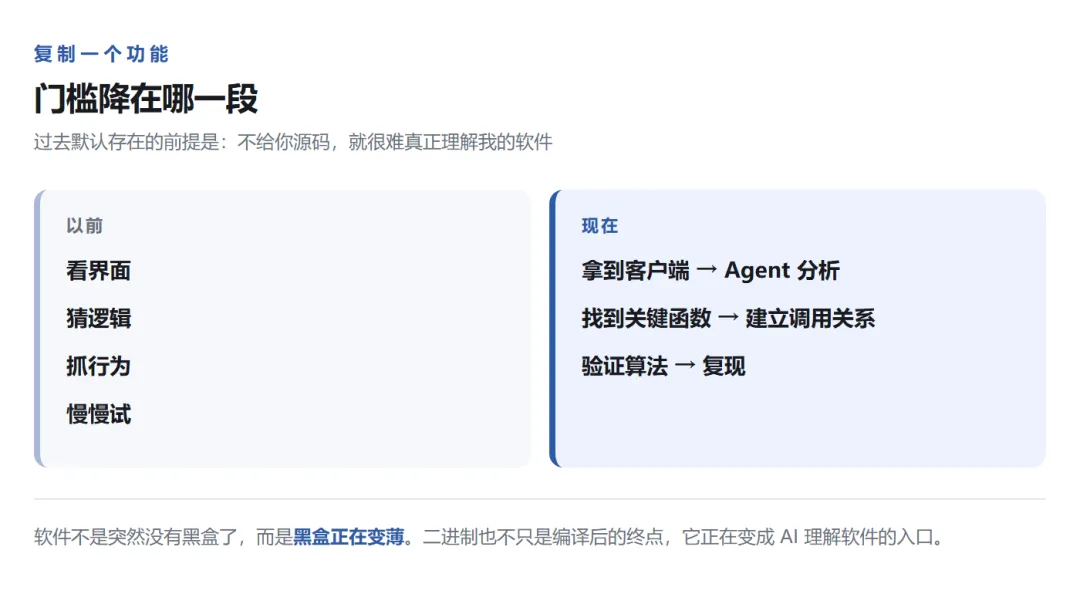
图 08 · 复制一个功能,门槛降在哪
甚至有一个评论说得特别有意思:
“突然间,全世界的二进制文件变得值钱了。”
以前二进制更像源码编译后的终点。
现在,它正在变成 AI 理解软件的入口。
这可能才是 REA 真正值得关注的地方。
06
但还有一道很现实的边界:AI平台本身
这里我要特别提醒一句。
REA只是工具层。
真正执行这些操作的,往往还是后面的 AI Agent 和模型。
而不同平台,对软件逆向、破解保护、分析商业软件等行为的安全策略可能并不一样。
从社区近期的反馈来看,已经出现了一些用户反映:
使用 REA 进行相关任务后,遭遇账号限制甚至封禁。
但这里必须把话说严谨:
这些目前主要是社区个案反馈,不能简单得出“用了 REA 就会封号”的结论。
真正值得关注的是另一件事:
工具允许你做,不代表模型平台允许你让它做。
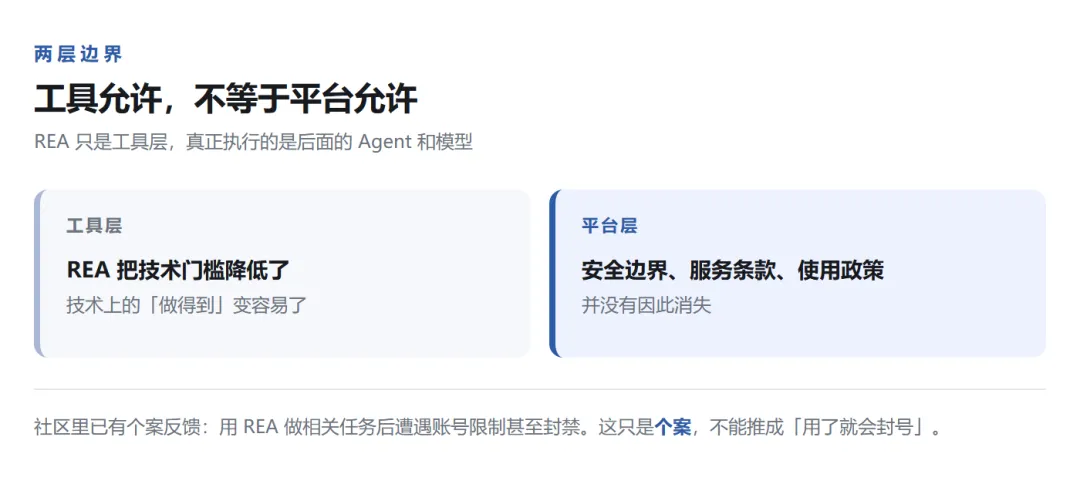
图 09 · 工具允许,不等于平台允许
REA把技术门槛降低了。
但平台的安全边界、服务条款和使用政策,并没有因此消失。
所以未来真正需要适应的,可能不只是逆向工程师。
还包括:
AI Agent应该拥有什么能力,以及这些能力应该被允许执行到什么程度。
07
三go的判断
第一,AI正在获得“理解既有软件”的能力。
过去我们聊 AI 编程,重点都是:
“AI能不能把代码写出来?”
REA代表的方向,则是另一个问题:
AI能不能看懂别人已经写好的东西?
当“写出来”和“理解已有软件”开始同时进入 Agent 能力范围,软件开发的边界就真的变了。
第二,代码本身可能越来越难成为长期护城河。
如果别人可以越来越低成本地理解你的实现,那么单纯靠:
“我的代码很复杂,所以别人复制不了。”
这套逻辑会越来越脆弱。
以后更重要的护城河,可能是:
数据、生态、服务、品牌,以及持续领先的速度。
你更新得比别人拆得快。
别人拆完的,永远是你的上一代。
第三,全民逆向真正的门槛,可能正在从技术转向授权和规则。
技术门槛降低之后,真正需要被重新画清楚的,是边界:
什么可以研究?
什么可以互操作?
什么可以审计?
什么需要授权?
什么可能触碰版权、合同或者平台规则?
AI可以让“能不能做到”越来越容易回答,但“该不该做”不会因此变得简单。
所以我并不认为 REA 意味着:
“以后所有软件都能被一键扒光。”
真正发生的变化是:
过去只有专业逆向工程师才能高效完成的工作,正在变成 AI Agent 可以参与甚至主导的工作流。
软件世界的大门从来没有真正锁死。
只是以前,拿着钥匙的人太少。
现在,AI正在学会怎么用这把钥匙。
而当 AI 不仅会写软件,还越来越会拆软件之后,我们真正应该问的,也许已经不是:
“软件还有没有黑盒?”
而是:
“当理解一个软件的成本越来越低,软件究竟还靠什么建立护城河?”
这,可能才是 REA 四天冲上 25 万 Star 背后,真正值得关注的事情。
如果这篇文章给你带来了一点新想法,欢迎随手点个赞、在看,转发三连。我把相关的文章整理成了合集就在下面,要是你也喜欢我的文章,别忘了点个关注,我们下篇再见。谢谢你看我的文章,愿这些分享能帮你少费一点工夫,也多留一点时间,去做自己喜欢的事。
标签:AI快讯|REA|逆向工程|Claude Code|Codex|MCP|AI Agent