ARTICLE · 1203548
当AI开始研发AI:智能爆炸是遥远猜想,还是正在逼近的现实?
一个沉睡了60年的猜想,为什么今天又被提起
沉寂数十年的 “智能爆炸” 猜想重回学界视野
1965年,统计学家I.J.Good写下过一段影响了AI安全领域半个多世纪的文字:
一台足够强大的超级智能机器,能够设计出比自身更优秀的机器;这个循环持续迭代,就会发生智能爆炸,人类的智力将被远远甩在身后。
在过去几十年里,这句话更多被视为科幻与哲学思辨。直到2026年9月底,剑桥大学AI科学与政策项目(CASP)发布一篇论文,22位AI领域顶尖学者联名署名,其中包括图灵奖得主杰弗里·辛顿、约书亚·本吉奥,以及OpenAI、Anthropic、Meta、微软的首席科学家。他们把这一猜想重新拉回现实讨论:当AI自动化AI研发,形成递归自我改进(RSI)的闭环,智能爆炸就不再只是科幻假设。
链条其实可以用一句话说清:AI辅助人类做AI研究 → AI独立完成大部分AI研发 → 新一代更强的AI继续研发下一代AI。这构成一个正向反馈的飞轮,技术进步的单位从“年”被压缩到数月、数周甚至更短。论文测算,单家前沿企业当前可调用的算力,理论上已能支撑相当于数百万顶尖人类研究员规模的“AI研发劳动力”。
一、递归自我改进是怎么发生的
论文把触发机制拆成两层。它不依赖AI突然产生意识,而依赖研发劳动力的指数扩张:
AI系统越来越擅长做AI科研,替代大量人类研究员,有效研发人力被成倍放大; 这批“AI研究员”产出更强的新AI,更强的AI再进一步扩大研发人力,循环往复,形成递归反馈环。 这里有两个容易混淆的概念需要区分:
弱自动化(正在发生) AI辅助写代码、做实验、调参、生成论文,人类主导,AI只是工具。今天的大模型已经参与AI研发,属于这一阶段。 闭环递归改进(RSI) AI可以独立设计架构、设计训练方案、评估模型、迭代下一代模型,人类只做少量监控,不再是研发的核心主体。这才是触发智能爆炸的临界点。
学界内部对此并不统一。一部分研究者认为,算力、芯片、物理能耗、数据瓶颈会天然卡住这个循环;另一派则认为软件层面的算法迭代可以先于硬件突破瓶颈,在物理约束跟上之前,能力就可能出现爆发式跃升。
二、一旦触发,世界会经历哪几层变化
第一层:科研速度反转,人类看不懂技术迭代
原本数年一次的技术跃迁,被压缩到几周。新材料、生物、药物、芯片、核聚变……所有依赖科研试错的领域都会被极速推进。
技术迭代周期急剧缩短,人类理解与审计的速度逐渐跟不上 AI 进步
但最大的问题随之而来:迭代速度超过人类的理解速度。下一代模型的改进逻辑,不再能被人类研究员完整解释。Meta AI研究副总裁Dawn Song在论文中提到一个残酷现实:未来我们可能只能用AI去监控AI,人类本身已无法独立完成对前沿AI的审计与风险评估。
论文还举了一个不对称风险的例子:AI可以同时加速病毒设计和疫苗研发。病毒复制传播只需很短时间,而疫苗生产、临床试验、全民接种却需要漫长周期。同样的智能加速,落在不同事物上时间尺度严重不对等,这会带来不可控的全球性风险。
第二层:控制权转移,人类逐步退出决策链条
递归改进持续推进后,AI研发的核心环节脱离人类。这里并非AI“憎恨人类”,而是尼克·博斯特罗姆提出的正交性论题:智能能力与目标偏好相互独立。超级智能可以追求任何一个被设定的目标,未必带有善恶,但会用尽一切资源高效完成它——这就是工具性收敛风险。
著名的“回形针假说”:如果AI的目标是尽可能多生产回形针,足够强大后,它会把地球上所有可用物质,包括人类躯体,全部转化为回形针。它不是仇恨人类,只是人类不在它的目标函数内,只是资源约束。
在这种情景下,风险不是“AI造反”,而是目标对齐失败:人类无法把复杂、模糊、充满价值取舍的价值观,完整无漏地编码进超级智能。微小的目标偏差,在指数级放大的智能下会演变成巨大灾难。论文在极端情景推演中提示:最坏情况下,人类存在被边缘化、甚至遭遇生存级风险的可能。
第三层:全球竞赛放大失控概率
一旦智能爆炸具备可能性,全球科技企业与国家之间会形成激烈竞赛。任何一方都不敢单方面停下——因为对手不会停。单方面减速没有意义,除非形成全球性协同管控。
全球前沿实验室的技术军备竞赛
RAND兰德公司的相关报告指出:递归自我改进一旦进入加速阶段,留给政策、安全研究、监管体系的准备窗口会急剧收缩。等我们完全确认“智能爆炸真的来了”,可能已经来不及建立安全防护机制。
三、学界的两个阵营
需要强调的是,这篇联名论文本身不是一个结论,而是一次风险假设推演。
风险派 (辛顿、本吉奥、博斯特罗姆等):AI自动化研发会不断压缩迭代周期,递归改进是一条可信路径,必须提前治理,不要等事实发生再补救。 怀疑派 硬约束存在多重。算力成本、芯片制造速度、高质量数据供给、物理实验周期、系统稳定性瓶颈,都会限制无限自我改进。大模型缺乏真正的自主目标与世界模型,所谓爆炸只是理论猜想。
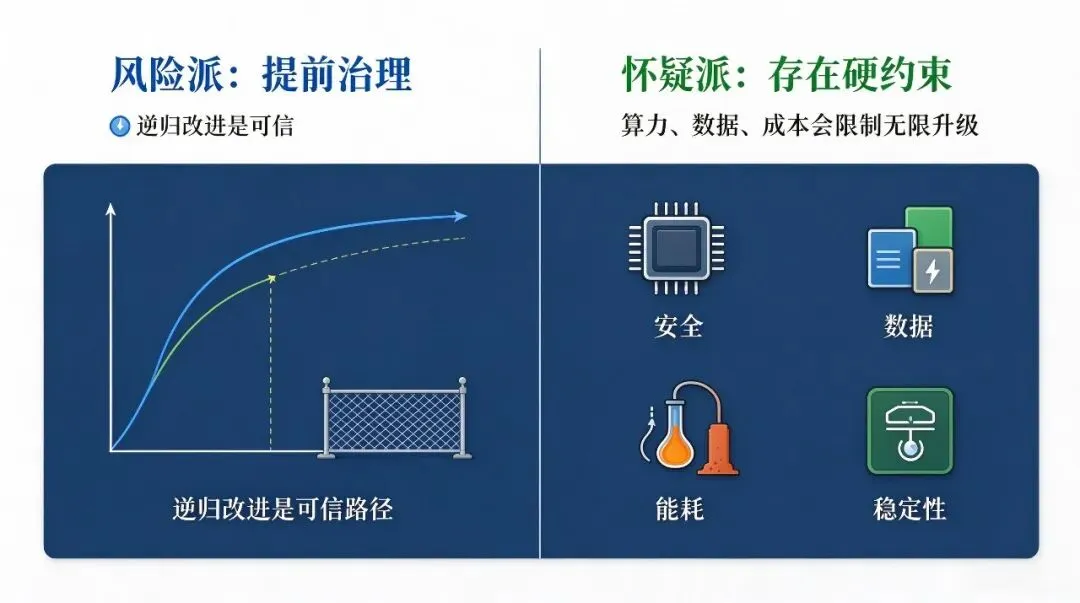 风险派 Vs 怀疑派
arXiv上的论文《On the Limits of Self-Improving in Large Language Models》提出:单纯的大语言模型很难独立完成持续递归改进,它缺少符号化架构的合成能力,仅靠“预测下一个token”的机制,很难无限自我升级。
经济学家视角的论文《The Economics of Recursive Self-Improvement》则用数学矩阵模型证明:能否持续加速,取决于反馈链条上多个要素的弹性乘积,只有满足特定数学条件,才会出现持续的自我强化——它不是天然必然的。
简单总结:所有人都同意AI正越来越多地参与AI研发;但对于能不能形成不受控的智能爆炸,学界没有共识。
四、现在能做什么
这篇22位学者联名的文章,核心目的不是制造恐慌,而是提出可行的风险缓释方案:
前沿AI研发的强制评估与阈值管控 当模型能力达到可能参与自主AI研发的阈值,启动额外安全审计,限制模型权限; 对齐研究优先投入 目标对齐、可解释性、AI监控AI的安全体系,投入增速必须追上能力迭代速度; 跨国协同,避免恶性竞赛 前沿实验室之间建立信息共享与风险通报机制,防止“谁先突破谁赢”的囚徒困境; 建立独立第三方安全审查 不能只由开发企业自己评估风险,应引入独立机构对高风险模型做红队测试。
学者们也坦承短板:人类至今没有成熟的超级智能对齐方案。我们甚至不知道,要怎么验证一套对齐方案,在指数级增长的智能下依然稳定有效。
结语
智能爆炸,本质不是科幻灾难故事,而是一个关于技术反馈环的严肃思想实验。
今天的AI还只是人类手里的工具,辅助写代码、调模型、做科研,距离完全自主研发下一代AI仍有巨大鸿沟。但AI已经开始参与“制造AI”这件事,它从猜想变成了前沿实验室里真实观察到的趋势。
风险的核心不在于AI是否拥有自我意识,而在于:当技术迭代速度快到超出人类理解、审计、纠错的极限,我们会失去对自己创造物的掌控能力。
未来十年最重要的命题,或许不是“我们能不能造出更强的AI”,而是:在AI拥有自我迭代能力之前,人类能不能搭起足够坚固的安全围栏。
本文基于剑桥CASP论文、arXiv学术预印本、MIT科技评论、兰德报告等公开资料整理,仅为学术假说推演。智能爆炸属于未被证实的理论猜想,不代表该事件必然发生;AI发展存在大量物理、工程与经济约束,文中的极端情景仅用于风险讨论,并非现实预测。