ARTICLE · 1209658
AI助手能替你办事了:认识Agent,划清授权边界
把AI用进工作 · 25 / 36
一次使用中的提问 · 模拟场景最近看到AI助手可以查邮件、建日程、整理文件,叫Agent。它和普通聊天AI有什么区别?如果我想让它办事,怎样给权限才不至于一句“帮我处理”就把文件乱改了?
对,Agent并不一定意味着“全自动执行”。很多人把 Agent 理解成“自动替我完成事情”,其实更准确的定义是:它能够围绕一个目标进行规划,调用工具获取信息或执行动作,并根据执行结果继续调整下一步。
所以即使每一步都让你确认,它仍然可以是 Agent。
比如一个文件整理 Agent:
你给它目标:
“帮我整理这个项目文件夹,生成一份周报草稿。”
它可能会:
读取指定文件夹 → 找到相关文档 → 提取信息 → 判断哪些内容需要整理 → 生成周报草稿 → 等你确认。
如果最后一步:
“是否保存草稿?”
你点击确认后才保存。
这仍然是 Agent,只是属于人在回路(human in the loop)的模式。很多实际工作场景反而应该这样设计,因为真正的问题不是 AI 有没有能力执行,而是哪些决定应该由人承担。
你说的这个权限范围:
只能读指定文件夹; 可以生成新草稿; 不能覆盖原文件; 不能删除; 不能发送;
其实已经接近一个比较合理的办公 Agent 配置。
但这里有一个关键点:
不能只靠聊天里的文字约定。
比如你告诉 AI:
“不要删除文件。”
这属于“行为要求”,不是“权限控制”。
如果工具本身仍然给它:
删除权限、修改权限、发送权限,
那么理论上它仍然可能因为理解错误、流程错误或者工具调用错误造成问题。
真正可靠的权限,需要落实在工具层。
比如文件系统权限。
不要给 Agent:
“整个电脑文件访问权限。”
而应该建立一个工作目录:
例如:
/项目资料/输入
这个目录:
允许读取。
然后设置:
/项目资料/输出
允许创建新文件。
但是:
原始资料目录:
只读。
输出目录:
可以写入。
这样即使 Agent 判断错,也没有能力修改原文件。
这和数据库里的权限设计类似:
不是提醒员工“不要改生产数据”,而是根本不给修改生产库的权限。
再比如文档编辑。
比较安全的流程不是:
“打开原文件 → 修改 → 保存。”
而是:
“读取原文件 → 生成 draft_v1.docx。”
然后:
你审核。
如果满意:
再人工替换正式文件。
这样保留了版本链。
尤其是合同、制度、汇报材料这类文件,不应该让 Agent 直接覆盖。
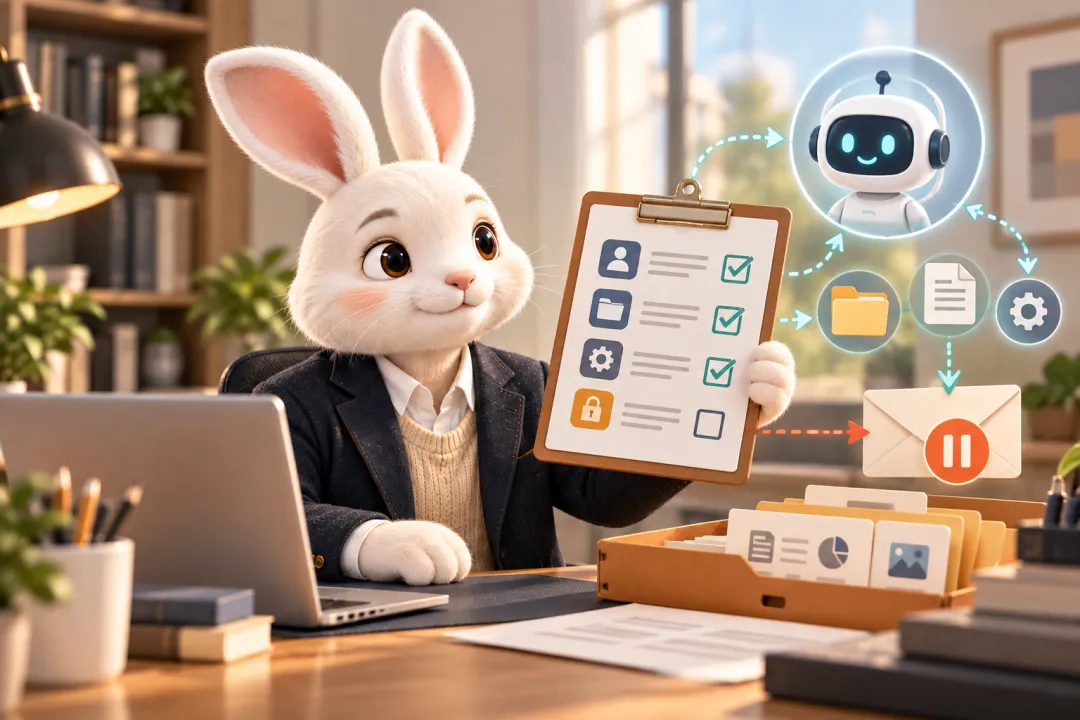
工具层还应该限制动作类型。
例如文件工具可以设计几个能力:
读取文件:
√ 可以
创建文件:
√ 可以
修改已有文件:
× 禁止
删除文件:
× 禁止
发送邮件:
× 禁止
这叫能力边界。
Agent再聪明,也只能在允许的动作范围内工作。
另外一个很重要的问题是:
什么时候停下来?
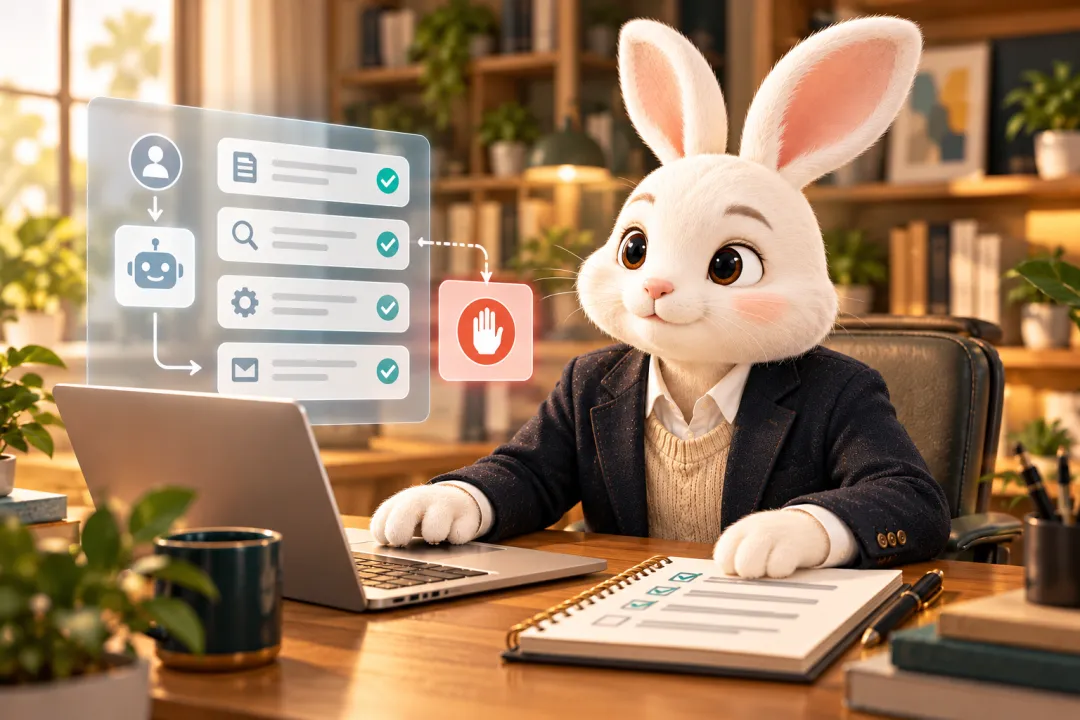
好的 Agent 不应该一路执行到底,而应该设置检查点。
例如:
第一阶段:
读取资料。
完成后停:
“我找到12个文件,其中3个可能相关,请确认是否继续。”
第二阶段:
整理内容。
完成后停:
“我生成了草稿,但发现两个数据来源冲突,需要确认。”
第三阶段:
输出文件。
停:
“是否保存为正式版本?”
这些暂停点不是降低效率,而是在关键决策处留下人工判断。
还可以设置异常停止规则。
例如:
如果出现以下情况,自动暂停:
找不到指定文件; 文件版本不明确; 发现多个冲突版本; 需要修改原文件; 需要发送外部信息; 需要访问未授权目录。
不要让 Agent 自己“猜”。
因为很多 AI 错误不是能力不足,而是在信息不足时继续推进。
所以,一个比较稳妥的 Agent 工作方式是:
目标由人给;
资料范围由权限限定;
步骤由 Agent规划;
低风险动作自动执行;
高风险动作人工确认;
异常情况自动停止。
你现在设想的模式,其实不是“把 AI 当助手然后完全放手”,而更像给它一个明确岗位:它负责整理、分析、准备结果,但最终决定权仍然在你手里。
未来很多企业里的 Agent,大概率也不是一个拥有全部权限的超级助手,而是一组权限受控的小 Agent。比如一个只负责整理资料,一个只负责生成报告,一个只负责检查流程。这样比给一个 AI 全部权限更容易管理,也更符合实际工作。
选题依据《从AI小白到应用大师》第14章14.1、14.2、14.6、第15章15.2。