ARTICLE · 1210422
今日AI报告 | 10月19日:国常会重定调、DeepSeek两大动作、可灵4.0全量上线 ,10条大事
今日AI报告
◆国数智能科学技术研究总院·众创网集团◆
国常会再部署"人工智能+":别再比参数了,开始比生产力
10月16日,国务院常务会议听取"人工智能+"行动进展情况汇报,指出人工智能是影响未来发展的关键变量,要从我国产业体系完备、应用场景丰富、工程化能力强这些实际出发,注重以落地应用牵引技术创新。换句话说,考核重心从模型能力转向真实场景的产出。这是继2025年8月国务院印发行动意见后,年内又一次系统部署,落点从能力建设转向价值兑现。
部署有三个抓手。第一是夯实底座:加强技术攻关和算法创新,促进算电协同,增加高质量数据供给,其中"算电协同"首次写进这类部署,直面算力背后的能源配套现实。第二是突出赋能:以实体经济为重点强化供需衔接,鼓励联合研发、推进中试验证、加大场景培育,打通实验室到大规模商用之间的中间环节。第三是安全托底:因业分级分类施策,守牢AI安全底线。
数据也已经跟上:我国AI核心产业规模突破1.2万亿元,企业超6600家,智能算力规模达2592EFLOPS。落地样本更直观,上海宝鸟服饰把AI嵌入设计与排产后,定制西装交付周期从20天压缩到5天,合格率升到99%;东风奕派的"设备大师"智能体,把紧急故障平均响应时间从10分钟缩到4分钟;一汽奔腾座舱系统的重点模块测试效率提升超60%。
评价标准正从模型指标换成生产率指标:先回答有没有用,再回答技术新不新。
谷歌1000万美元买下破产航司30年数据:下一座金矿在档案柜里
据外媒报道,谷歌在破产法院竞拍中出价1000万美元,收购美国破产航司Spirit的30年企业数据,对手Mercor出价750万美元。数据清单看一眼就知道为什么值钱:约1亿封邮件、5亿条Teams聊天记录、1700万份OneDrive文件、2060万份SharePoint文档,还有约3000万行代码,覆盖8万个邮箱账户。谷歌说得很明白,用途是训练能执行多步骤企业任务的智能体。
网上免费数据那么多,为什么非要花钱买一家破产航司的内部文件?因为AI训练正在换赛道。公开网络数据早被各大巨头扫荡干净,而智能体要真正替人干活,缺的恰恰是真实企业里的事务长什么样:一封报销审批邮件怎么流转,一次航班改签牵扯哪些系统。这些内容全网找不到,如今成了稀缺资产。
这笔交易还提示了一个新市场:企业数据资产化。手里攥着几十年经营数据、却不知道怎么变现的传统企业,数据训练授权可能变成一项新收入;对AI公司来说,谁能拿到干净、真实、带完整业务流程的数据,谁就能在智能体竞赛里快一个身位。交易还要法院批准,但方向已经划出来了:下一座数据金矿不在互联网上,在各家公司的档案柜里。
DeepSeek两天两动作:模型开源,搜索开始按次收费
先看搜索这一头。10月17日,DeepSeek上线Search与Fetch两个API,基于自研搜索引擎,专门服务Agent与RAG应用;10月18日就公告了定价:按请求次数计费,每1000次成功请求5元,11月1日凌晨起正式收费。这个动作在国内厂商里很少见。AI要替你干活,绕不开实时联网检索,过去这一层要么免费凑合,要么各家自己搭,现在有人把它做成明码标价的稳定服务,说明Agent经济开始分层了:有人卖大脑,有人卖眼睛。对开发者是好事,检索有了统一入口,成本也可预期。
模型这头也没闲着。同日上线的开源模型V4.1-Flash-1017用MIT许可开放权重,总参数7630亿。官方基准显示,它在DeepSWE v1.1、Automation-Bench v1.0.6这些编码与自动化任务上超过GPT-5.6 Sol和Claude Opus 5,同等智能水平下输出Token还少约20%。开发者的反馈更实在:榜单未必全面赢,但速度和Token效率让日常手感更好,便宜模型当默认、昂贵大脑留难题,正在成为新搭配。开源社区很快放出了量化版本,自部署门槛进一步降低。
两个动作合起来看,路径很清楚:开源聚人气,检索做收入,模型和搜索互相导流。Agent生态过去缺的是便宜好用的眼睛和手,现在这块拼图又多了一个有分量的玩家。
VAST开源EdenLive:一块RTX 5090,跑出720P实时世界模型
VAST开源了实时世界模型EdenLive:5B参数,在一块RTX 5090上以720P分辨率跑出24FPS以上的连续画面,端到端延迟压到百毫秒级,权重与代码全部开放。官方说它首次在实时生成条件下同时做到三件事:任意参考输入、任意画风、长时连续运行。以前多数世界模型要么生成一段固定长度的视频就停,要么只能在指定画风里循环,边看边生成、连续不断片,才是实时交互真正的门槛。
为什么这件事重要?因为世界模型的终点不是短视频,而是可交互的实时环境。游戏里无限延展的开放世界、具身智能的低成本仿真训练场、XR设备的实时场景重建,都要求模型像显卡渲染画面那样即时生成世界。延迟从秒级压到百毫秒级,意味着这条路从演示阶段走到了可用阶段。对做仿真的团队尤其关键:训练机器人不用再等渲染,环境可以即时生成。
打法上也能看出变化。VAST此前靠3D生成产品Tripo和世界模型StereoWorld出名,这次EdenLive把重心从生成质量转向生成速度和开放部署。当实时世界模型跑进消费级硬件,虚拟内容的生成成本会再降一个量级,做内容、做仿真、做硬件的团队都值得盯一眼。
英伟达开源机器人框架ASPIRE:机器人学会自己写程序了
英伟达发布并开源机器人智能体框架ASPIRE V1.0。它不让机器人死记动作,而是让模型自主编写控制程序去完成任务,失败了就复盘原因、修改代码,把跑通的经验沉淀成可复用的技能。目前技能库里已有90多项Skill、覆盖150多个任务,在没见过的任务上零样本成功率达到31%。这些技能不是写死的规则,是模型自己迭代出来的资产,用得越久越厚。
接入GPT-6 Astra之后,效果进一步提升:LIBERO-Pro等机器人基准的任务成功率接近满分。英伟达机器人研究负责人Jim Fan给它起了个名字,叫物理世界的苦涩教训:与其费力采集海量演示数据,不如把代码当成通用接口,让模型像软件工程师那样持续迭代。
对做具身智能的团队,两个判断值得记下。第一,机器人技能可以从一次一任务的手工编排,转向自动生成加持续积累,新任务的上线周期会大幅缩短。第二,通用大模型和专用机器人模型的边界在模糊,先把框架层做好,底层模型可以持续换新。机器人行业的竞争焦点,正在从本体和灵巧手,转向谁的技能库涨得更快。
对产线来说,这意味着换型成本的下降速度,可能比本体硬件的迭代更快。
4个AI组队27小时打穿《我的世界》:死605次,写2783个程序
谷歌DeepMind让4个Gemini 4 Argon智能体在《我的世界》里自主组队,从零开始采集资源、制作装备、探索世界,全程无人类干预,27小时后击败末影龙。过程数据很有意思:它们累计编写了2783个程序,死亡605次,每次失败后自主诊断原因、调整分工、恢复进度,相当于一支会自我复盘的虚拟工程小队。更难得的是分工,谁探路、谁战斗、谁修装备,全程自己商量,没有人类提示。
为什么值得认真看?因为长时程自主协作一直是Agent的短板。单步任务多数团队都能做,但连续几十小时的复杂项目,一步出错就可能满盘皆输。DeepMind验证的思路是把代码当通用接口:不会操作就写个程序来操作,记不住就写成函数保存,出了Bug就修。代码可保存、可复用、可回滚,这正是工程化的底子。这个范式不只属于游戏,仓库调度、产线巡检、多机器人协同,本质都是同一类问题:一组AI在长周期里分工、容错、持续执行。
对落地团队来说,判断点在这里:多智能体系统的价值,不在单个模型多聪明,而在协作与恢复机制是否可靠。什么时候这类系统敢在真实业务里连续跑一周不出事,Agent才算过了工业级这道坎。
在这之前,任何多智能体方案都只能算演示。
智谱开源法律模型GLM-Legal:双榜登顶,成本只有同类的1/70
智谱发布并开源法律模型GLM-Legal,在Harvey LAB与LegalBench两个法律评测榜单上同时拿下第一,整体通过率19.2%,准确率86.23%。它能审合同、分析证据、做跨境合规,调用成本只有Gemini 4 Argon的1/70。通用旗舰模型在法律任务上经常看着都会、一做就错,因为法律判断依赖海量法条、判例和行业惯例的精确约束,通用模型容易给出似是而非的答案,垂类模型靠定向训练把差距补上了。这也是垂类路线反复被验证的逻辑:在专业领域,定向投喂比通用堆参数更有效。
成本才是真正的杀招。法律服务最大的痛点是贵:一份合同审查动辄上千元,跨境合规咨询按小时计价。成本降到1/70意味着,原来只有大企业请得起的法律AI,中小律所、创业公司甚至个人都用得起了。结合医疗、金融领域垂类模型接连冒头,趋势越来越清晰:通用模型卷智力上限,垂类模型卷行业下限,后者离收钱更近。
这套路径可以直接复用:选一个容错成本高、数据壁垒深的行业,用垂直数据做定向训练,用成本优势换市场规模。先用基准成绩证明专业度,再用价格打穿市场,GLM-Legal两步都走通了。开源策略再叠加生态卡位,垂类之战才刚开局。
可灵4.0全量上线:30秒长镜头直出,AI视频开始拼关键镜头
10月15日,快手可灵AI新一代视频生成模型Kling 4.0正式全量上线。升级集中在三条:单次原生生成最长30秒,支持长镜头和连续叙事,高速运动、跟拍环绕等大幅运镜更稳定;关键帧输入扩展到最多10帧,全能参考支持最多15项图文音视频素材,提示词上限提高到8000Token,完整分镜脚本可以一次喂进去;10-bit HDR、4K和21:9超宽画幅也已宣布支持。换句话说,一条完整的广告短片,从分镜到成片可以一口气生成。
这份升级单背后的竞争很直白。字节的Seedance 2.5今年7月就支持30秒生成、单任务最多50个参考素材,可灵这次是贴身对垒。商业数据也说明赛道有多热:可灵一季度收入超6.5亿元、同比增长超300%,二季度超8.5亿元,上半年合计超15亿元、超过去年全年;估值约180亿美元,已经反超快手当前约162亿美元的市值。
从玩具到工具,分界线就在交付稳定性上。可灵已服务超1亿用户、5万多家企业客户,还和海外动画电影展开制作合作。竞争焦点正从单帧惊艳转向关键镜头的稳定交付,对影视和广告行业来说,AI视频承接正式商单的能力又上了一个台阶。
对影视和广告公司来说,接下来的判断标准会更具体:一条商单能不能交给AI,看的是返工率,而不是第一眼的惊艳。
医院导诊台换人形机器人:66个工作日回答了46686次提问
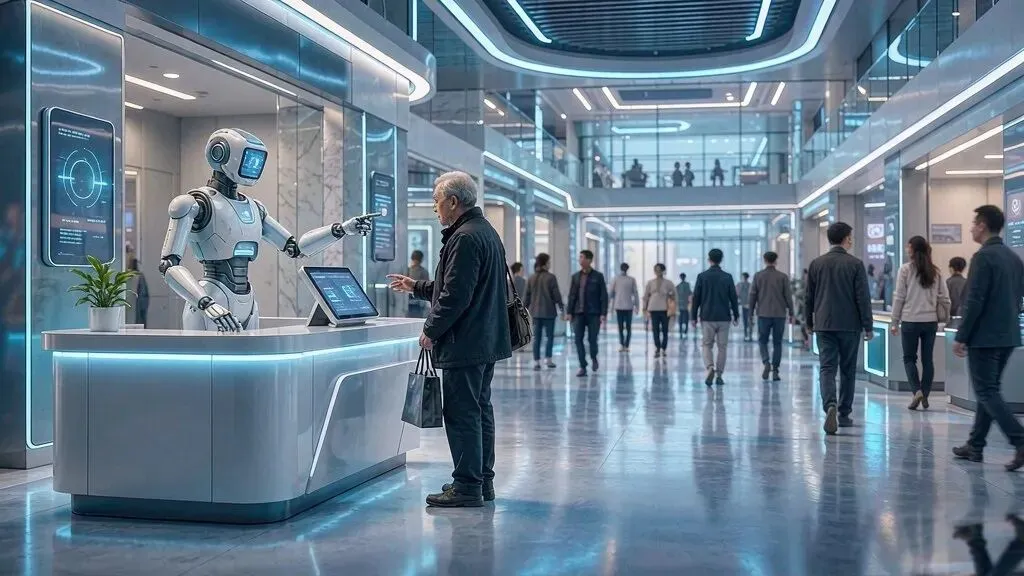
在北京大学人民医院门诊大厅,人形机器人灵犀X2已常态化值守导诊台。它对接院内私有知识库,靠拟人语音和肢体交互承接高频咨询:科室怎么走、医保怎么报、检查在哪层。运营数据是这次报道最硬的部分:66个工作日累计交互46686次,日均服务707次,单日最高1420次。门诊大厅是医院咨询压力最大的地方,这组数字说明它不是展台摆设,而是真的在分流,导诊人力被释放出来,可以去做更需要人的事。
做对的地方有两点。一是范围克制:机器人只做科室指引、医保答疑、院内导航这类非诊疗辅助,诊断权牢牢留在医生手里,符合医疗场景的监管底线。二是交互降门槛:相比固定自助终端,拟人化对话对老年患者更友好,而这恰恰是医院里最需要帮助的一批人。
同期,广州多款导诊机器人进驻医院和社区卫生服务中心,广汽孵化的慧仑科技也在测试轮足机器人做病房陪护和物资递送。具身智能落地正在换打法:先从高频、低风险、高重复的场景切入,用真实运营数据迭代,再往深水区走。这可能是机器人进医院最靠谱的一条路径。
对医院来说,采购逻辑也会跟着变:先看有没有跑出真实运营数据的案例。
538小时脏数据教会机器人干活:真机训练只用1小时
香港大学MMLab团队提出EgoWild2Dex方法,直接用538.9小时未经处理的真实人类第一视角视频训练机器人,素材里全是日常杂乱场景、意外状况和不规范动作,不做精心清洗。结果是:每个下游任务只需不到1小时真机数据微调,机器人就能完成拆快递、用热熔胶枪固定手办、制作冷饮这类复杂双臂操作,平均成功率达96.7%。
方法看似反直觉,逻辑却很清晰。机器人数据采集是行业最贵的环节:遥操作采一条高质量演示,成本可能要几百元,几分钟的任务往往要采上千条。而人类日常视频遍地都是、几乎零成本,如果能做到脏数据直用,数据瓶颈就被撬开了。第一视角画面又恰好和机器人双臂操作的视角天然对齐,等于找到一个规模近乎无限的数据入口。
这提示了一个新的行业分工:本体和灵巧手解决能不能动,数据管线解决学得快不快。谁能把海量人类视频低成本转成机器人技能,谁就能在训练成本上拉开数量级差距。数据不再从机器来,而是从人来,这个判断如果成立,具身智能的进化速度会被重新定义。
本内容由AI基于公开资讯整理,仅供学习参考涉及具体公司与数据以实际为准 · 转载请联系授权