ARTICLE · 1210628
全国产十万卡 AI 超集群发布,十万卡不是重点:被忽略的是那句“40% 的应用需要融合”
10 月 17 日至 20 日,第二十二届全国高性能计算学术大会在深圳举行。中科曙光带着曙光8000 真机参展,发布它支撑的十大应用成果——这是国内首个“全国产十万卡 AI 超集群”,今年 7 月才首次亮相(中国科学报 10 月 18 日报道[1])。
媒体报道集中在两个词上:十万卡、能装一个宇宙。但发布里有一句话更值得记下来:目前这台机器上超过 40% 的应用,需要“超智融合”协同发力。
这句话把整件事的重心挪了位置。
先说清这台机器是什么
架构是 CPU + GPU 异构。中科曙光副总裁曹振南的说法是从芯片、计算、存储、网络、散热、应用到服务全链路一体化设计,卖点是三个词:全精度计算、大规模并行、原生超智融合。
“超智融合”是这轮报道里最容易被跳过的词。“超”指超算,做的是把物理方程写进计算机、一小步一小步推演未来,要求高精度;“智”指智算,做的是从海量数据里归纳规律,追求吞吐。前者算得准但慢,后者算得快但可能不准——大模型的“幻觉”就是只抓相关性、没有因果的直接后果。
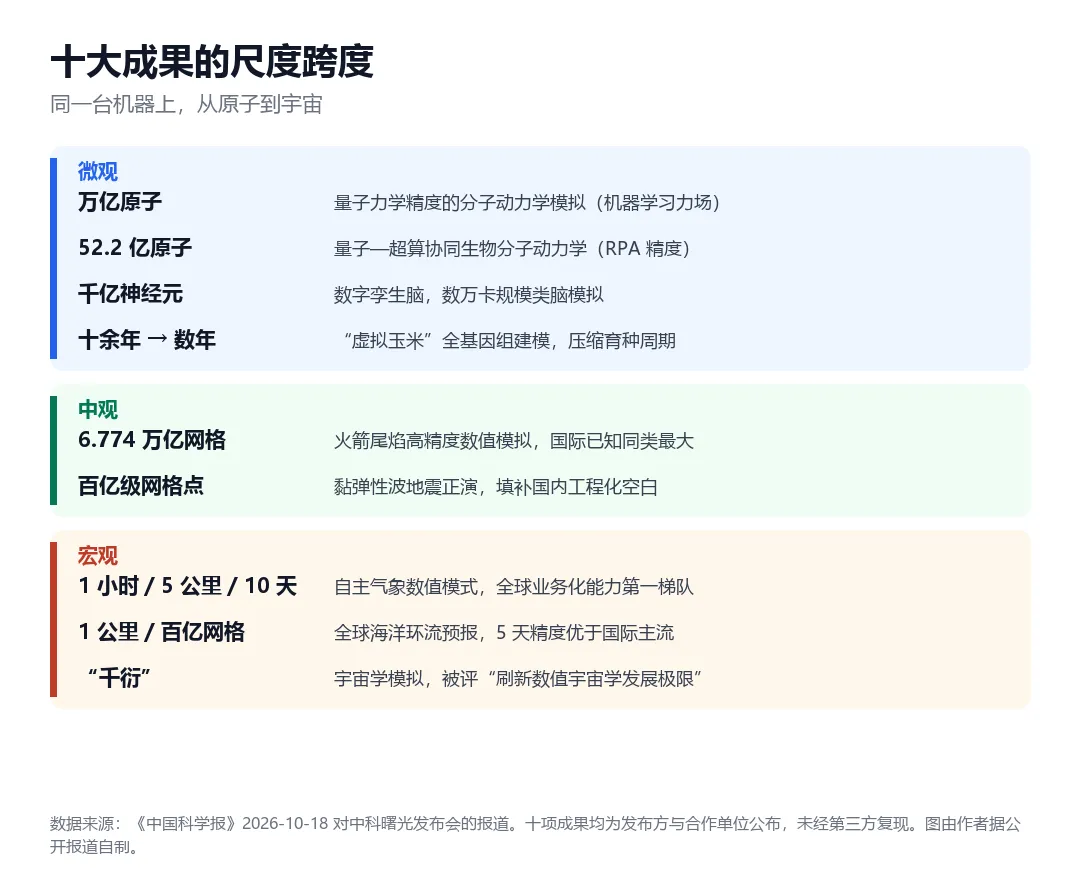
十大成果可以按尺度排一串:龙讯旷腾等用机器学习力场首次实现量子力学精度的万亿原子分子动力学模拟;中国科大等参与的量子—超算协同模拟把规模推到 52.2 亿原子;复旦类脑研究院与曙光合作,做出千亿神经元规模的数字孪生脑;西安交大的火箭尾焰仿真用了 6.774 万亿网格,是国际已知同类最大;中国气象局用自主数值模式在 1 小时内完成全球 5 公里分辨率、未来 10 天预报;崂山实验室的海洋环流预报做到 1 公里分辨率、百亿网格。
这些数字有一个共同点:它们不是“生成”,而是“求解”。求解要的是精度和稳定性,不是猜得像不像。
40% 那句话为什么重要
如果这台机器只是“把十万张 AI 卡连起来”,那它确实只是规模新闻。但 40% 这个比例说明,真正跑起来的负载里,接近一半不能只靠 AI 卡的半精度算力。
机制是这样的:AI 的部分负责在海量候选里快速筛选,但筛选结果必须回到高精度求解里复核,否则错误会被放大。曙光高端计算总工程师卜景德举的例子很具体——万亿原子分子动力学走的是“分子动力学模拟 + AI”的路线,为了提速,他们设计了支持 FP64、FP32 的张量核心做加速,规模从 400 亿原子做到 3.6 万亿原子。
FP64 就是双精度浮点,科学计算的底线精度;AI 训练常用的 BF16 只有它一半的位宽。一块只会跑 BF16 的卡,压缩不出 FP64 需要的动态范围。
所以“全国产”这三个字真正的含金量不在卡的数量,在于国产芯片能不能同时提供:高精度算力、卡间高带宽低延迟互连、以及能把这些拼起来的软件栈。数字孪生脑的例子也印证了这一点——它模拟神经元靠突触相连,对延迟和带宽要求极高,最后是靠节点内和节点间的自主互连,才撑起“数万卡规模”的类脑模拟。
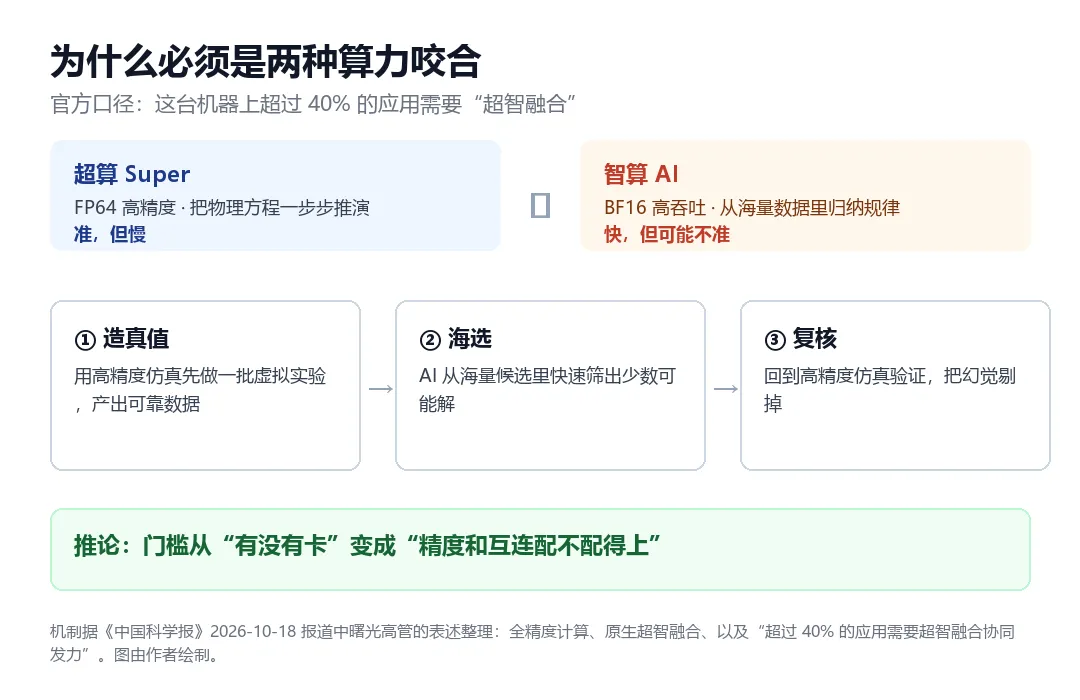
一句话:门槛已经从“有没有卡”变成“精度和互连配不配得上”。
“全国产”验证到了哪一步
这部分必须划清界限,否则整篇文章就变成替厂商做宣传。
可以确认的:系统存在,名字叫曙光8000,发布方是中科曙光,场合是深圳的全国高性能计算学术大会,时间是 10 月 17 日至 20 日;十大成果的题目、机构与关键数字,来自《中国科学报》对曙光两位高管的专访,可以逐条核对。
不能确认的:没有任何独立第三方的复现或评测。“全国产”是官方表述,国产化率如何计算、核心计算芯片具体型号、整机能效、单位算力的实际成本,报道里都没有。央视也做了报道,但我只读到标题(其中包括“十万卡塞进 2000 平米”“时延从 10 毫秒到 3 毫秒”的说法),没有核到正文,因此本文不采用这些细节。
还有一个容易被忽略的口径问题:“十大应用成果”是发布会上的自选清单,选的是最亮的十个,不是全部负载。曹振南自己也说,这十项“只是应用能力的一部分代表”。
对你的实际影响
分三种人,结论不同。
做 AI for Science、工业仿真、量化计算的技术负责人:这条新闻和你直接相关,但要改的不是采购清单,是评估项。国产卡的评估不能再只看 BF16 吞吐和跑分,必须加两项:FP64 吞吐,以及卡间通信的带宽与延迟。这两项决定你能不能在本地把“AI 筛选 + 数值复核”串起来。
只做文本、图像推理的团队:短期没有直接影响。这台机器是科研与工程负载的底座,不是通用 API。不必因为它调整你的排期。
想租这类算力的团队:这里是最大的缺口。整场发布没有提到对外开放的服务方式、价格、可用队列和 SLA。它现在更像一台国家队设施而不是一个可采购的商品——如果你在算预算,暂时不要把国产十万卡算进你的成本模型。
你现在该做什么
适用对象:手上有 AI + 数值混合负载、正在评估国产算力的技术负责人。
第一步,把评估项改掉。 在你的选型表里加三行:FP64 实测算力、卡间互连实测带宽与时延、主流框架与通信库的兼容情况。别用发布会上的聚合数字做决策,那测的是别人挑过的负载。
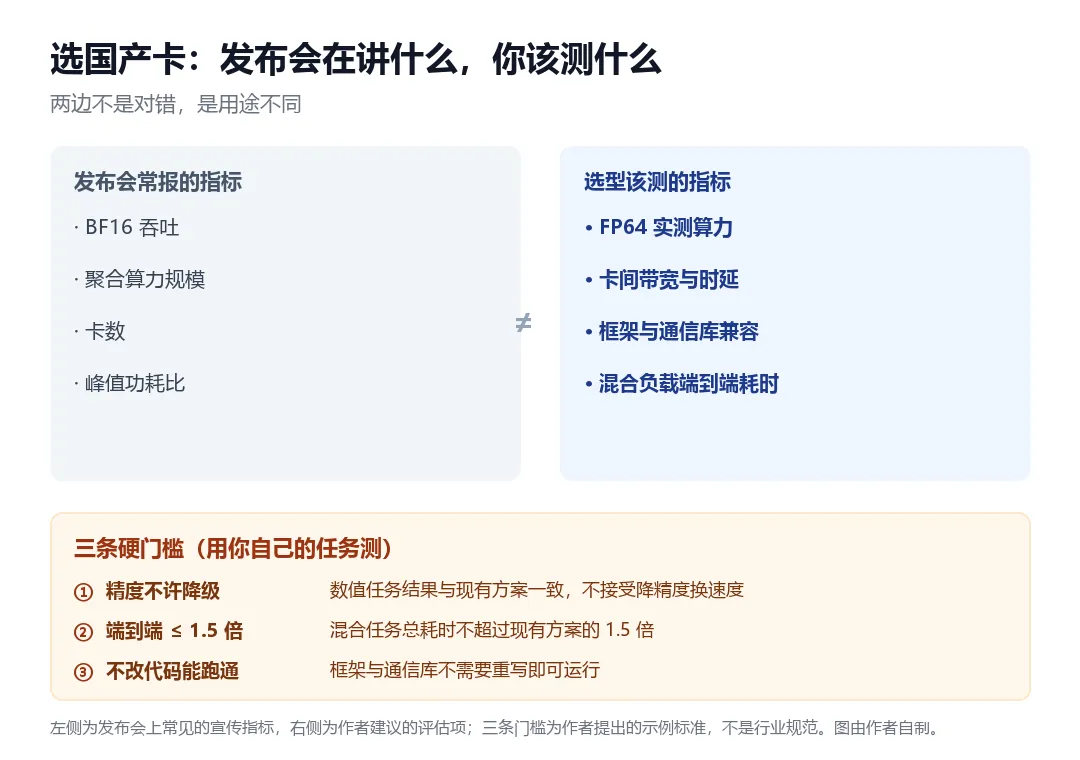
第二步,用你自己的 kernel 做一周实测。挑三个代表性任务:一个纯 AI(比如模型推理)、一个纯数值(比如你最小可信的仿真单元)、一个混合(AI 出候选、数值复核)。后两个才是国产卡真正的考场。
验证标准可以写死:数值任务的精度与现有方案一致(不允许降精度换速度)、混合任务的端到端时间不超过现有方案的 1.5 倍、框架无需改代码即可跑通。三条都过,才进入下一轮;有一条不过,就先留在现有平台上。
暂时不动的条件:如果你的负载强依赖 CUDA 特有算子、或者团队里没人做过国产软件栈的移植,那么这件事对你是两年后的议题,不是今年的。
必须写的限制
第一,十大成果全部是发布方与其合作单位公布的结果,没有第三方复现;“全国产”“十万卡”均为官方表述。
第二,我没有读到任何一项成果的论文或技术报告,只有新闻口径的数字。本文引用这些数字是为了说明负载的形状,不是为它们背书。
第三,把“超智融合”类比到商业场景是有距离的。科研负载有明确的物理方程可以复核,多数业务场景没有;这也是这条路线最不容易迁移的地方——你有可验证的“真值”环节吗?没有的话,40% 这个数字跟你无关。
最后留个问题:你们团队最贵的那个计算任务,如果只能用你信得过的方式复核结果,你会拿什么当那个“复核器”?
关于创作方式:本文的资讯检索、资料整理与初稿由 AI 辅助完成;事实来自《中国科学报》2026 年 10 月 18 日报道与经济日报同日报道[2](后者提供了“超算造数据—智算海选—超算复核”这一表述),央视报道仅读到标题、未采用其细节;发布方数据为厂商与其合作单位自述,未经独立验证;未经人工逐条复核前,请勿将其视为已核实结论。
引用链接
[1] 中国科学报 10 月 18 日报道: https://news.sciencenet.cn/htmlnews/2026/10/573154.shtm[2] 经济日报同日报道: http://www.jingjiribao.cn/static/detail.jsp?id=690665