ARTICLE · 1213772
文档处理 Agent 实战:扫描件、表格、合同一次搞定,别再无脑塞给大模型
本文是《AI Agent 实战》系列第 9 篇。第 7、8 篇做了两个"对外"的 Agent(选品、客服),这一篇回到最朴素也最高频的需求:把一堆乱七八糟的文档变成结构化的数据。发票报销、合同归档、报告摘录、台账整理——每个公司都有这种活。很多人第一反应是把 PDF 直接塞进大模型上下文"看着办",这篇就是要告诉你为什么这是反模式,以及怎么用五段流水线把它做对。
一、为什么"整份 PDF 塞给 LLM"是新手第一大坑
先看一个真实感很强的翻车现场。你把一份 80 页的供应商年报 PDF 转成文本,一股脑丢给 qwen-plus,让它"提取所有财务数据"。结果:
- 贵
:80 页约 12 万 token 输入,一次调用几毛钱,跑 100 份文档就是几十块,而且每次重跑都重新收费; - 漏
:长上下文的"中间遗忘"效应,第 30-50 页的表格数据最容易被忽略; - 错
:PDF 转文本时表格已经塌成一行行流水账,"营业收入 1.2 亿"和"净利润 1.2 亿"混在一起,模型分不清列对应关系,直接编一个给你; - 慢
:单次调用几十秒起步,批量场景根本没法看。
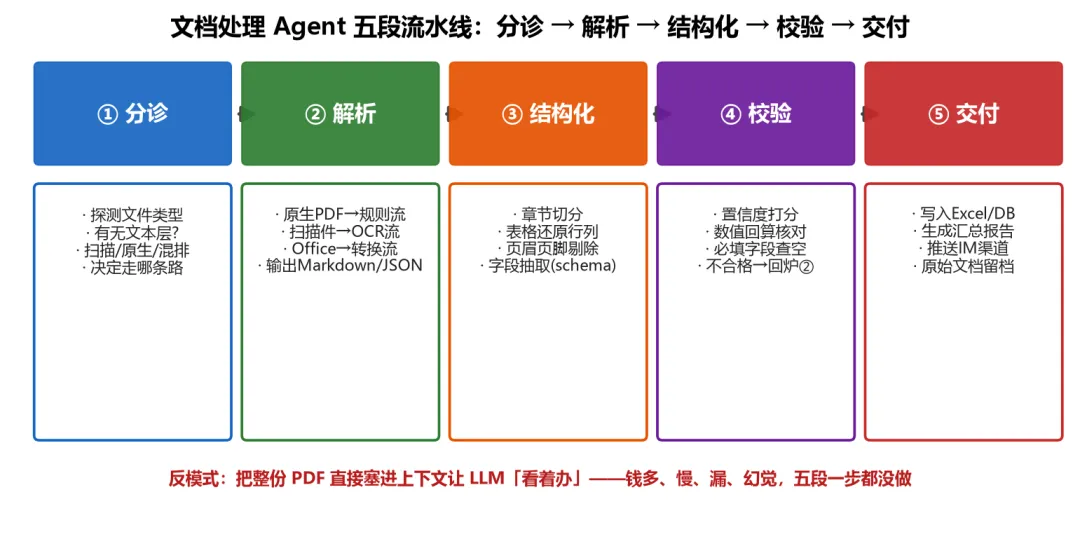
问题的根源不在模型,在于你跳过了文档处理该做的所有前置工序。正确的做法是把任务拆成五段流水线,每一段用最适合的工具:
一句话概括:分诊决定路线,解析还原内容,结构化重建秩序,校验兜住质量,交付对接下游。LLM 只在"字段抽取"和"写摘要"这两处出场,而且每次只喂给它处理干净的局部文本——这才是成本和准确率都可控的姿势。
这套流水线还有个隐藏收益:可调试。第 4 篇的老原则"先定位层再定位行"在这里具象化了——数字错了查校验层,表格错位查解析层,扫描件没字查分诊层。黑盒式的"塞给模型"出了问题你连断点都打不了。
有读者会问:就处理三份文件,也值得搭五段流水线?不值得。判断标准和第 3 篇选 Dify 还是写代码一样看量:月均处理量 < 50 份、字段 < 10 个、错了没人追责,MarkItDown 转一下再手动塞给对话模型,十分钟交差完全合理。流水线的收益在三个地方开始兑现——批量(第 51 份文件边际成本趋近于零)、复用(同一套代码服务报销/合同/台账多个场景)、审计(每笔数据可回溯到原文页码)。当你的同事开始把文件夹甩给你说"帮我整理一下",就是该把脚本升级成 Agent 的信号。
二、分诊层:先判断"这文件到底需不需要 OCR"
社区里有个被反复验证的结论:相当大比例的 PDF 根本不需要 OCR——2026 年有个开源预检工具(pdf-inspector)的统计口径说"54% 的 PDF 不用 OCR"。扫描件和原生件的占比因行业而异,但先探测再路由这条原则是通用的:拿一份带文本层的 PDF 去跑 OCR,纯属浪费钱还引入识别误差。
探测方法很朴素:试着抽一页文本,看字符数和"看起来像不像人话"。
# triage.py —— 分诊:判断文件类型与是否需要 OCRfrom pypdf import PdfReaderdef triage_pdf(path: str) -> dict:r = PdfReader(path)sample = "".join((p.extract_text() or "") for p in r.pages[:3])chars = len(sample.strip())pages = len(r.pages)# 文本层判定:平均每页可提取字符数density = chars / max(min(pages, 3), 1)if density < 40:kind = "scanned" # 扫描件/图片型 → 走 OCR 流elif density < 300:kind = "mixed" # 混排(部分页有文本层)→ 逐页路由else:kind = "native" # 原生 PDF → 走规则流return {"path": path, "pages": pages, "kind": kind,"density": round(density, 1)}if __name__ == "__main__":import sys, jsonprint(json.dumps(triage_pdf(sys.argv[1]), ensure_ascii=False))
三个阈值(40/300)是经验起点,务必用你自己的文档样本重标定:有些财务系统导出的 PDF 文本层里全是空白字符,密度虚高;有些设计稿导出的 PDF 一页就几百字,密度虚低。分诊错了后面全白干,这一层的样本测试是整条流水线里性价比最高的十分钟。
非 PDF 文件(docx/xlsx/pptx/图片)的分诊更简单——按扩展名和魔数路由即可,MarkItDown 这类工具本身就支持百余种格式输入,不需要额外判断。
mixed 类型(混排)最容易被忽略也最值得单独处理:一份合同 PDF,前 5 页是系统导出的原生文本,最后 2 页是拍照插入的附件章页。正确姿势是逐页跑密度检测、按页打标签,原生页走规则流、扫描页只把那几页送 OCR,最后按页码合并。整份文件按"最差页"路由(全部走 OCR)是最省事的错误做法——原生页经 OCR 一转,本来 100% 准确的文本反而引入了识别错误,得不偿失。
Office 文档还有个隐藏坑:.doc/.xls/.ppt 这三个老格式(无 x 后缀)是二进制格式,纯 Python 库基本不支持,Linux 服务器上通常靠 LibreOffice headless 先转成 OOXML 再处理。分诊层遇到老格式直接标记 legacy,路由到转换分支,别等解析报错才发现。
三、解析层:工具选型,一张决策树讲清楚
2026 年的开源文档解析格局已经比较稳定,选型逻辑看这张图:
几个关键事实,都是写作前刚核实过的(版本号与许可证以各项目官方页为准):
- pypdf
(MIT):PyPDF2 的正式继任者,纯 Python,合并拆分加密都行,文本提取是弱项但够用,当前 6.x 版本; - pdfplumber
(MIT):基于 pdfminer.six,单元格级坐标定位是它的独门绝技,有线框表格提取很准;缺点是慢(单页 80-200ms,比 PyMuPDF 慢 3-5 倍),100 页以上大文件要当心内存; - Docling
(MIT,IBM 出品,已捐给 Linux Foundation AI & Data):布局分析 + TableFormer 表格模型,公开评测里复杂表格单元格识别准确率约 97.9%,输出结构化 JSON/Markdown,和 LangChain/LlamaIndex 有原生集成,是"企业级 RAG 前置解析"的热门选择; - MinerU
(OpenDataLab,约 76K star):中文双栏论文、公式、密集版面的天花板,但它是 AGPL-3.0 许可证——闭源商用产品集成它需要仔细评估传染性条款,或者用其官方托管服务/商业授权,这一点很多人踩坑,后文报错清单里专门列; - MarkItDown
(微软,MIT):一行代码把 PDF/Word/PPT/Excel/图片转 Markdown,快、格式全,但表格和复杂版面还原能力弱,适合"先跑通再说"的原型期; - PyMuPDF / PyMuPDF4LLM
:性能最强的一档,2021 年起归 Artifex 所有,同样是 AGPL-3.0 双许可(商用需买授权或开源你的代码);自 1.24.3 起官方导入名从 fitz改为pymupdf,老教程里的import fitz在新版仍兼容但新代码建议用新名。
规则流的代表用法,pdfplumber 提表格:
# parse_tables.py —— 规则流:从原生 PDF 里精准抠表格import pdfplumberdef extract_tables(path: str) -> list[dict]:out = []with pdfplumber.open(path) as pdf:for i, page in enumerate(pdf.pages, 1):for t in page.extract_tables({"vertical_strategy": "lines", # 有线框表格用 lines"horizontal_strategy": "lines"}):rows = [[(c or "").replace("\n", "") for c in r] for r in t]if len(rows) < 2:continueout.append({"page": i, "header": rows[0], "rows": rows[1:]})return out
vertical_strategy 默认按线框找列;遇到"看起来有表格其实没画线"的排版,改成 "text" 按字符间距聚类,配合 snap_tolerance 微调。这是 pdfplumber 最常被问到的参数,没有之一。
扫描件流(OCR)的选型看决策树右栏:本地免费选 PaddleOCR(Apache-2.0,PP-OCRv5/v6 支持 50 种语言,CPU 可跑,v6 于 2026 年 6 月发布);不想维护模型选云端 API——百炼的 qwen-vl-ocr 当前定价输入 0.3 元/输出 0.5 元每百万 token(以官方计费页为准),对手写体和版面的理解明显好于传统 OCR;发票合同这类模板化场景,TextIn、阿里云 OCR 等专用 API(约 0.05-0.09 元/页量级)开箱即用,往往比通用方案省一半事。
Docling 的接入代码只有几行,值得放进来感受一下"企业级解析"的接口形态:
# parse_docling.py —— Docling:布局+表格一体化解析,直接喂给 RAGfrom docling.document_converter import DocumentConverterconv = DocumentConverter()result = conv.convert("供应商年报.pdf")md = result.document.export_to_markdown() # 给 LLM 的干净 Markdownfor table in result.document.tables: # 结构化表格对象df = table.export_to_dataframe()print(df.shape, list(df.columns)[:3])
输出既是 Markdown(保留标题层级)又是可遍历的表格对象,还能导出 JSON 给校验层——第 3 篇 Dify 知识库、第 18 篇 LlamaIndex 深度问答的前置解析,用它都能无缝衔接。
最后给一个选型三问,帮你在决策树之外做最终裁决:一问许可证(闭源商用?先排除 AGPL 的 MinerU/PyMuPDF 或买授权);二问是否需要 GPU(MinerU VLM 后端、Docling 大模型模式都吃显存,纯 CPU 环境优先 pdfplumber/PaddleOCR 轻量档);三问错误的代价(合同金额抽取错一位小数就是事故,宁可上商业 API 也别省这几分钱;内部资料检索错一段无伤大雅,免费方案随便试)。
四、结构化层:字段抽取要带 schema,不要带祈祷
解析出来的 Markdown 或表格还是"文本",业务要的是"字段"。这一步是 LLM 的主场,但要用结构化输出约束它——让模型按 Pydantic 模型填表,而不是自由发挥。
# extract_fields.py —— 用 schema 约束 LLM 抽取发票字段from pydantic import BaseModel, Fieldfrom langchain.chat_models import init_chat_modelclass Invoice(BaseModel):"""增值税发票关键字段"""invoice_code: str = Field(default="", description="发票代码,识别不到留空")invoice_number: str = Field(default="", description="发票号码")date: str = Field(default="", description="开票日期,YYYY-MM-DD")buyer_name: str = Field(default="")seller_name: str = Field(default="")amount_excl_tax: float = Field(default=0.0, description="不含税金额(元)")tax_amount: float = Field(default=0.0, description="税额(元)")total_amount: float = Field(default=0.0, description="价税合计(元)")confidence: float = Field(default=0.0, ge=0, le=1,description="整体把握度,模糊就压低")def extract_invoice(md_text: str) -> Invoice:llm = init_chat_model("qwen-plus", model_provider="openai",api_key="YOUR_KEY", temperature=0)chain = llm.with_structured_output(Invoice)# 只喂清洗后的局部文本,不喂整份原始文档return chain.invoke("从以下发票文本中抽取字段。金额单位统一为元,""识别不到的字段留空/0 并压低 confidence:\n" + md_text[:6000])inv = extract_invoice(invoice_md)assert abs(inv.amount_excl_tax + inv.tax_amount - inv.total_amount) < 0.01, \"价税合计不平,进人工复核"
三个设计点值得展开:
confidence字段是校验层的抓手。与其事后猜模型有没有把握,不如让它自报——配合下一节的规则校验双保险。注意自报置信度不能单独作为放行依据(模型普遍过度自信),必须和"数值回算"这类硬校验叠加使用。 temperature=0+ schema 双约束,把随机性压到最低。第 7 篇说过的原则在这里同样成立:凡是"每次跑结果应该一样"的环节,不许模型自由发挥。 - 断言"价税合计=不含税+税额"这类业务恒等式
。发票、报表、对账单几乎都有这种内部勾稽关系,代码一行就能验,能拦下绝大部分"模型看错小数点"的事故。
多文档批量场景,把每份文档的抽取结果落成 JSONL,方便校验层统一处理、也方便出问题时回溯单条记录——这一步偷懒,第八节的报错清单就会找上门。
长文档不要一次全抽。80 页年报抽"所有财务指标",正确姿势是结构化层先按章节切块(利用解析器输出的标题层级,或按"第X章/1.1"编号正则切),每个目标指标先定位所在章节、再只对命中块发起抽取。两个好处:token 消耗从"整本书×指标数"降到"相关章节×指标数";更重要的是每个字段有了出处(页码+章节号),校验失败时复核人员三秒定位原文。
表格抽取优先走"表格→DataFrame→代码计算",而不是"表格→文本→LLM 复述"。第 7 篇的老原则在这里升级:凡是能从还原后的表格里用 pandas 直接算的(求和、同比、排序),绝不过 LLM。LLM 在结构化层的合理职责只有三种——列名归一化("营业收入/经营收入/营收"是一回事)、跨表实体对齐(两个附件里的"上海××贸易有限公司"是同一家)、以及真正模糊字段的判断(合同里"甲方"指向哪家公司)。让 LLM 干计算的活,是文档 Agent 第二常见的反模式(第一是整文档塞上下文)。
五、校验层:置信度、回算与人工复核队列
校验是文档 Agent 和"玩具"的分水岭。三层递进:
# validate.py —— 规则回算 + 置信度 + 人工复核队列def validate(record: dict, rules: list) -> tuple[bool, list[str]]:"""rules: [(检查名, 断言函数)],全部硬校验,不信任模型自报"""fails = [name for name, fn in rules if not fn(record)]ok = not fails and record.get("confidence", 0) >= 0.85return ok, failsINVOICE_RULES = [("价税合计勾稽", lambda r: abs(r["amount_excl_tax"] + r["tax_amount"]- r["total_amount"]) < 0.01),("发票号码格式", lambda r: len(r["invoice_number"]) in (8, 12, 20)),("日期可解析", lambda r: bool(r["date"]) and__import__("datetime").datetime.strptime(r["date"], "%Y-%m-%d") is not None),("金额非零", lambda r: r["total_amount"] > 0),]review_queue, passed = [], []for rec in load_jsonl("extracted.jsonl"):ok, fails = validate(rec, INVOICE_RULES)(passed if ok else review_queue).append({**rec, "_fails": fails})print(f"自动通过 {len(passed)} 条,待人工复核 {len(review_queue)} 条")
- 第一层:硬规则回算
。勾稽关系、格式校验、枚举值域、日期合法性——纯代码,零成本,能解决 80% 的质量问题; - 第二层:模型自报置信度
。只作为"加严检查"的信号:confidence 低于阈值直接进复核队列,不试图让代码理解"模型为什么没把握"; - 第三层:人工复核队列
。复核界面不用开发,复核人员直接在 JSONL 上改字段、加 reviewed_by标记回灌即可。关键设计:复核结果要回流成评测集——攒 50 条真实修正样本后,每次换模型、改提示词都先跑一遍这个集合,这是第 15 篇评测主题的种子。
还有一个容易忽略的点:原始文档必须留档,每条结构化记录带上源文件路径和页码。校验失败时你要能一键回到"第 3 页右下角那个表格",而不是对着一堆 Markdown 猜当初模型看到了什么。
复核队列的运营有两个数字要盯:入队率和复核修正率。入队率长期高于 30%,说明校验阈值太紧或解析质量差,该回头修上游而不是堆人力;入队率低但抽查发现"自动通过的记录也有错",说明规则覆盖不足,把漏网案例补成新校验规则——每补一条,同类错误从此自动拦截。两个月下来,规则库会比任何模型微调都值钱,因为它沉淀的是你业务的真实坑位。
六、编排层:用 LangGraph 把五段串成状态机
单份文档的脚本谁都会写,Agent 的价值在于批量、异构、可中断。用第 2 篇的 LangGraph 把流水线挂成状态图,每个文件走一遍,失败单独进异常分支而不是炸掉整批:
# pipeline_graph.py —— LangGraph 1.x 编排五段流水线from langgraph.graph import StateGraph, START, ENDfrom typing import TypedDict, Literalclass DocState(TypedDict):path: strkind: str # native / scanned / mixedblocks: list # 解析后的文本块+表格records: list # 抽取的结构化记录need_review: boolerror: strdef route(state: DocState) -> Literal["parse_native", "parse_ocr"]:return "parse_ocr" if state["kind"] == "scanned" else "parse_native"def parse_native(state): ... # 调第三节 pdfplumber/Doclingdef parse_ocr(state): ... # 调 PaddleOCR / qwen-vl-ocrdef structure(state): ... # 调第四节 with_structured_outputdef validate_node(state): ... # 调本节 validate()g = StateGraph(DocState)g.add_node("triage", lambda s: {"kind": triage_pdf(s["path"])["kind"]})g.add_node("parse_native", parse_native)g.add_node("parse_ocr", parse_ocr)g.add_node("structure", structure)g.add_node("validate", validate_node)g.add_edge(START, "triage")g.add_conditional_edges("triage", route)g.add_edge("parse_native", "structure")g.add_edge("parse_ocr", "structure")g.add_edge("structure", "validate")g.add_edge("validate", END)app = g.compile() # 生产建议配 checkpointer,批量中断可续跑
配合第 6 篇的确认机制,可以在 validate → 交付 之间加一个 interrupt():复核队列非空时暂停,等人处理完再放行交付——低置信文档绝不静默入库,这是文档 Agent 的安全底线。批量跑几百个文件时给 compile() 配上 SqliteSaver checkpointer,进程挂了从断点续跑,不用重头再来(第 8 篇讲过的会话持久化,在批处理场景同样值钱)。
交付层的实现反而最简单:pandas 汇总所有通过的记录写 Excel(注意报错清单第 12 条的日期类型坑),同时把 JSONL 明细一起归档——Excel 给人看,JSONL 给机器用,两边以 source_file + page 字段互相引用。如果下游是第 3 篇的知识库或第 8 篇的客服 Agent,这一步还要多输出一份"清洗后的 Markdown 语料",让同一套流水线喂饱多个下游,这就是把文档处理做成基础设施而不是脚本的价值。
七、常见报错与调试清单
import fitz | import pymupdf;升级前读官方迁移说明 | ||
^\d+(\.\d{1,2})?$ 预清洗;校验层勾稽回算兜底 | |||
八、成本估算(月度,处理 1000 份平均 10 页的文档)
对比一下反模式:整文档塞上下文的方案,仅 1000 份 × 12 万 token 的输入一项就要数百元,还没算重跑与纠错。先把文本洗干净再喂模型,token 消耗普遍能降一个数量级——这是第 14 篇成本优化主题在本篇的第一次预演。
再给三个立刻能用的降本招数:缓存解析结果(同一文件二次处理直接读缓存的 Markdown/表格,OCR 和解析都是幂等的,按文件哈希缓存零风险);分层用模型(简单字段用 flash 级小模型抽,只有版面复杂或前次失败的文档才升级到 plus,实测多数发票小模型足够);批量接口(百炼 Batch 模式下 qwen-vl-ocr 输入价约减半,文档整理本来就是异步批处理,天然适合 Batch 队列)。三招叠加,云端方案的成本通常能压到本表估算的下限以下。
九、总结与下一篇
总结:文档 Agent 的五段流水线——分诊(先问要不要 OCR)、解析(按决策树选工具,盯紧 AGPL 许可证)、结构化(schema 约束 + 业务恒等式)、校验(规则回算为主、置信度为辅、人工兜底)、交付(留档可回溯)。LLM 是流水线里的一颗螺丝,不是整条流水线。
落地顺序建议倒着来:先用 20 份真实文档手工跑通"解析→抽取"两段(第三节+第四节的代码就够),确认字段质量能看;再补校验规则和复核队列(第五节),确认错误拦得住;最后才接分诊路由和 LangGraph 编排(第二、六节)上批量。一上来就搭全套状态机,多半在第二周就放弃——流水线的每一段都该在上一段验证过质量之后再加,这和第 4 篇"小步快跑定位问题"是同一个哲学。
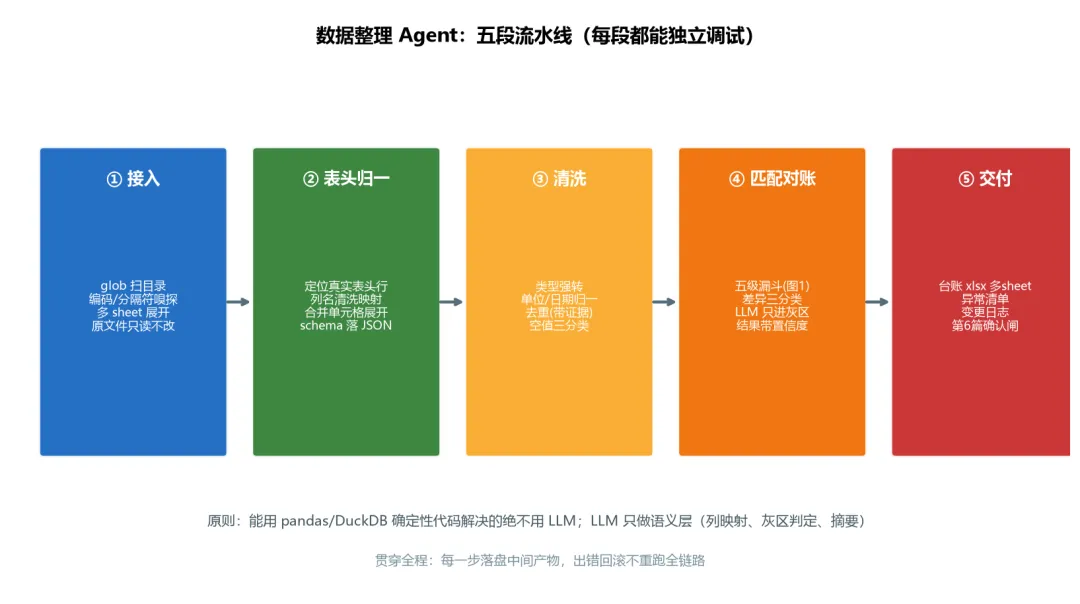
下一篇(第 10 篇)我们做数据整理 Agent 实战:把散落的 Excel/CSV 对账合并、清洗归一、生成台账——正好接上本篇交付端"结构化数据之后怎么管"的话题。文档处理解决"从文件到数据",数据整理解决"从数据到台账",两篇连起来就是一条完整的资料流水线。
📌 系列说明:《AI Agent 实战》共 20 篇,每周更新。前 6 篇解决"能不能跑",7-10 篇解决"能不能用",11-15 篇解决"跑得贵不贵、稳不稳",16-20 篇解决"规模化与合规"。欢迎收藏追更,评论区聊聊你被文档处理坑过的经历——是表格错位还是扫描件乱码?点赞高的痛点我会写进后续实战案例。