ARTICLE · 1214998
05. 几张Excel合并之前,先把数据口径说清
WorkBuddy实操系列 · 05
05. 几张Excel合并之前,先把数据口径说清
✦ ─ ✦
玩AI的杰克
三张表合成一张,文件能打开,行数也看起来正常。可金额一汇总,就有人问:“这一列到底含不含税?”这时才发现,合并动作完成了,业务口径还没确认。
这个任务需要先让WorkBuddy列字段差异。哪些能对齐,哪些要业务确认,分清以后再合并。工具可以处理数据,口径需要我们交代。
STEP
准备三张小表,把问题留在材料里
01
在input中保存下面三个CSV文件,可以用Excel打开。先用六行看懂规则,再扩大到自己的数据;不要一开始就让工具处理几百个文件。
csv
# region-a.csv
region,order_id,amount_gross
A,0001,100.00
A,0002,200.00
# region-b.csv
区域,订单编码,结算金额
B,0001,150.00
B,0002,50.00
# region-c.csv
region,order_id,amount,tax_status
C,0001,70.00,net
C,0002,120.00,gross
实际保存时,文件名说明行不写入CSV。A与B的金额本次都约定为元、含税;C明确含有不含税记录。订单编号必须保留前导零,且同一个编号可以出现在不同区域,主键采用“区域+订单编号”。
这些约束要写进rules/data-dictionary.md。它决定怎样理解输入,不由列名或模型习惯替你推断。(注意关键词:约束)
STEP
先扫描,暂时不汇总
02
第一轮只读材料,输出字段、类型、缺失值和异常。不要让它顺手把编号变成数字,也不要把不含税金额自动换算。
text
读取input中三份CSV与rules/data-dictionary.md。
先列字段对照、金额单位、含税口径和建议主键。
检查订单编号是否按文本保留,区域加编号是否唯一。
不修改、不汇总、不自行补税率。
列出需要业务确认的记录,等我确认后再继续。
这一轮应识别B表的字段异名,以及C区0001的“net"状态。若它认为所有“金额”都能相加,就回到材料里说明净额与含税金额的区别。所以这个配置的关键是告诉模型概念,模型通过概念去获取应该获取的数据,可以看之后的例子中,为什么 net 的 70 不累加进去。
字段映射可以记录为下面的配置。它需要在指令中明确引用,不是平台自动加载文件,可以理解为让模型统一关键字。
json
{
"区域": "region",
"订单编码": "order_id",
"结算金额": "amount_gross",
"key": ["region", "order_id"],
"currency_unit": "CNY_yuan"
}
STEP
确认异常怎么处理,再生成规范表
03
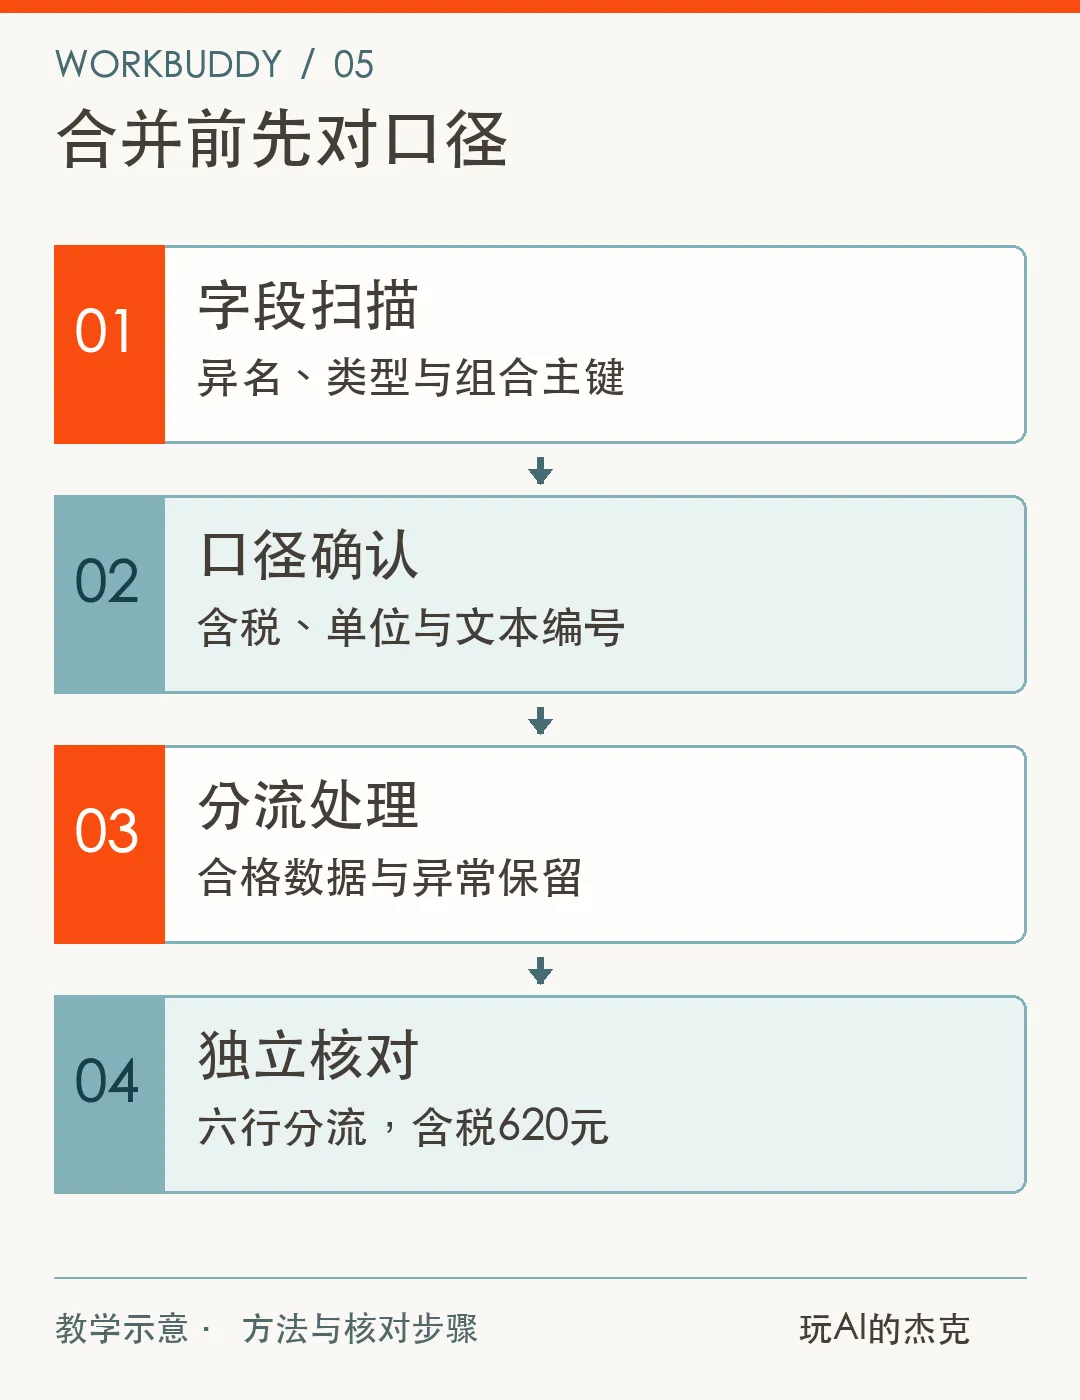
这次选择保留所有原始数据,但只把已明确含税的五条记录放进规范结果。C区0001进入异常表,等待确认税率或拿到正确口径,不删除也不猜测。
text
按确认规则生成output/clean.xlsx。
规范字段为region、order_id、amount_gross、source_file、source_row。
订单编号保持文本;主键按区域与编号组合。
C区0001是不含税记录,放入output/exceptions.xlsx,不换算。
在checks/merge-review.md记录字段映射、各文件行数与异常原因。
不覆盖input,不自动删除任何记录。
若无法生成XLSX,说明限制,先交CSV与核对说明。
XLSX 即 Office 软件能力,负责文件生成。它有没有按约定处理文本、字段和金额,仍需要通过结果核对。只有CSV时明确记录格式未达原目标,不能称为Excel完整交付。
数据量大以后,“来源文件+原行号”很有用。看到一条异常,可以回到原记录确认,而不是只剩下一张已经清洗过、找不到出处的表。
STEP
行数和金额都要对得上
04
这组材料共六条数据。按当前教学规则,规范表五条,异常表一条;五条含税金额应为100+200+150+50+120=620元。70元净额暂不纳入这个总数。
这些是人工设计的验收值,不是WorkBuddy的实际运行回执。自己执行后,检查输入六行能否通过来源记录对应到五行规范数据和一行异常。
再用Excel公式或独立脚本计算规范金额。下面只展示金额求和的关键规则:
python
from decimal import Decimal
values = ["100.00", "200.00", "150.00", "50.00", "120.00"]
total = sum((Decimal(x) for x in values), Decimal("0.00"))
assert total == Decimal("620.00")
Decimal适合这里的确定小数计算。完整数据处理还需处理空值、异常文本与重复主键,不能只把这几行示意代码复制后当成全套生产程序。
STEP
碰到重复,先保留两边原值
05
真实文件可能有同一订单的两个版本。重复不一定就是多余,也可能是更正记录、不同状态或重复导入。先列出两条来源,确认业务规则以后再决定保留哪一条。
text
发现重复组合主键时,保留所有冲突记录与来源。
不要默认保留最后一条或金额更大的一条。
输出重复清单,说明哪些字段不同,等待我确认。
其他已确认记录可以继续处理,但在报告中标清未解决部分。
如果工具已把0001改为1,修复要回到原输入,不能凭结果猜补几位零。让它按文本重读编号,重新生成规范表,并在核对说明里记下修正。
STEP
把口径和处理记录一起留下来
06
一次合并结束,值得保留的是字段字典、异常处理规则、来源映射和核对方法。下个月换文件,先扫描它们是否仍然成立,再执行同一流程。
数据变得整齐只是第一步。每一行如何进入结果、每个金额按什么口径计算、未解决项在哪里,说明清楚,才有基础把这个过程做成后面的可复用Skill。
我是玩AI的杰克,原樊登读书企业版技术负责人、IBM 架构师,有 20 年技术开发与企业数字化实践。持续分享 AI、软件工程和技术运营的经验与思考,欢迎关注。