ARTICLE · 1224848
你的 AI 有 210 个工具,为什么干不好一件事?
【免责声明】本文内容仅供学习交流,所述方法需结合实际场景灵活运用。AI工具输出结果仅供参考,关键业务决策请结合人工判断。
如果你是技术负责人,重点看第二、三、四部分;如果你是HR/知识管理岗,重点看第四部分"业务知识资产化"那一段,和第五部分的权限分层。
实验室那位维护 TAPD(腾讯的项目管理产品)的 AI,手上有 210 个工具:查需求、流转状态、写评论、报工时,26 个模块。按理说,它该什么都会干。
但它每次开工的第一件事不是干活,是"复习":210 个工具的名称、描述、参数定义先灌满它的上下文,然后才开始猜,手头这件事该轮到哪几个工具。一份需求还没读、一条评论还没写,一大块工作记忆先没了。
这不是个例。Gartner CIO 调研(2026)显示,受访企业中 17% 已经实际部署了 agent,60% 以上计划在未来两年内部署;Gartner 同时在《Hype Cycle for Agentic AI 2026》里预测,到 2027 年底,超过 40% 的 agentic AI(任务型智能体)项目将被取消。如果这组数字说明什么,我们的判断是:落地卡点在组织,不在模型——工具越接越多,活没见得更快。
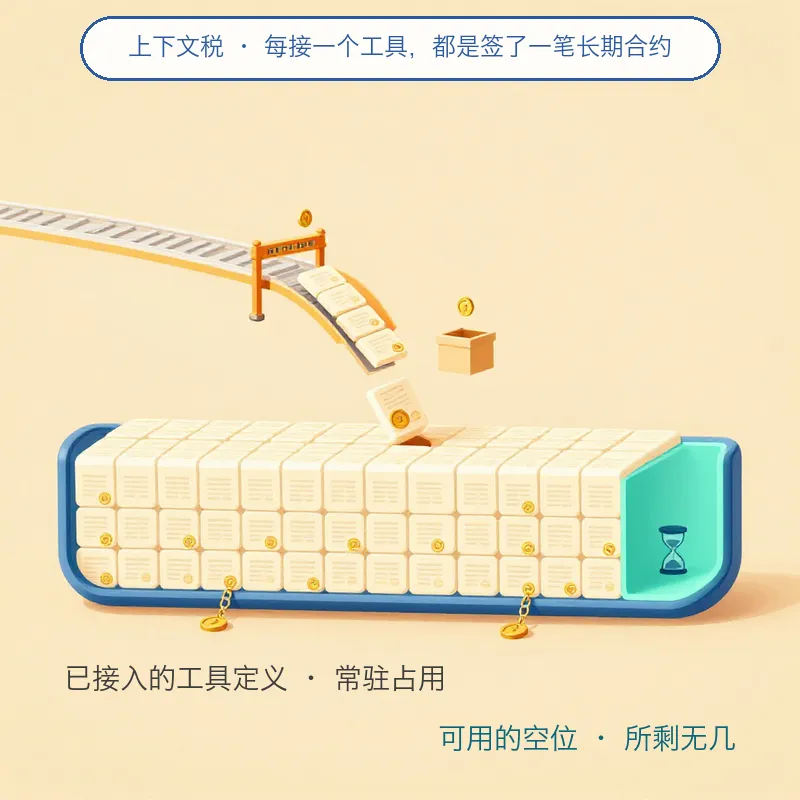
每接一个工具,都是一笔长期上下文支出
MCP 是一个开放协议,把企业系统的功能包装成 AI 能直接调用的工具;每个工具都带一段定义——名称、说明、参数结构、取值枚举,一旦接入,每次会话开始都会自动占一块上下文,不管这次任务用不用得上。这笔固定支出,下文叫它上下文税——每接一个 MCP 工具,都是签了一笔长期合约的上下文支出。
税有多重,两拨人认真量过。MCP 官方仓库的 Discussion #2812(2026-05-28)里,作者用 Anthropic 的 token 计数 API 实测了 11 个生产环境的工具:带完整描述和参数说明的工具定义,比极简写法多耗 5 到 15 倍 token,重型工具一个定义就在 1,000 token 上下。工程博客 Apideck(2026-03)给出的区间是每个工具 550 到 1,400 token(厂商口径,未独立复现)。学术界也在看——arXiv 论文《MCP Tool Descriptions Are Smelly!》扫了 103 个 server 上的 856 个工具,样本内 97.1% 的描述至少有一种质量缺陷:太长、含糊,或干脆互相矛盾(该比例仅代表样本,不外推)。
一个人的实测让它有了体感。开发者 Khushbu Shah 在 Medium 上的记录(2026-06-15):接入多台 MCP server 之后,还没读任何文件、没调任何工具,上下文先被吃掉约 9 万 token。她同文还估过"分层错了、成本可差 35 倍"的账——未经独立复现,不作论据。
最贵的 token,是开工前就花掉的那九万个。
业界不是没打补丁。Anthropic 的工程博客《Code execution with MCP》(2025-11)给出过方案:让 agent 写代码调 MCP,参数结构需要时才从文件系统读;Claude Code 也上线了 tool search,工具按需呈现;Solo.io 的网关 agentgateway 用渐进式披露(按需逐步呈现,不一次全摊)把 token 用量砍了 91%(Solo.io 官方博客,2026-04-22)。补丁都在治"多",没治"乱":210 个工具摊开的工具面(agent 能看见的全部工具集合)摆在眼前,它依然不知道该走哪条流程。
MCP 解决"摸得到",Skill 解决"干得对"。
Skill 是一份叫 SKILL.md 的文件:把某类活怎么干——步骤、规范、判断节点——写成 agent 按需加载的说明。2025 年 10 月 16 日,Anthropic 发布 Agent Skills,官方原话是:Skills 与 MCP 互补,"教 agent 更复杂的流程"("Skills can complement (MCP) servers by teaching agents more complex workflows")。七周多后的 12 月 9 日,MCP 被捐给 Linux Foundation 旗下新成立的 Agentic AI Foundation;再过九天,12 月 18 日,Agent Skills 开放为行业标准,规范当天对外公开发布。两个多月,"两层"从厂商特性变成跨厂商的公共基础设施——到 2026 年,一份 SKILL.md 已经能在 Claude Code、OpenAI Codex、Cursor 等三十余家主流智能体里直接用(社区追踪快照:Denser,2026-02;各家统计不一)。
"Without MCP, the agent cannot access your systems. Without the skill, the agent has access, but doesn't know your processes."
没有 MCP,agent 摸不到你的系统;没有 Skill,agent 摸得到系统,但不懂你的流程。
—— 意译,译自 Red Hat Developers,Cedric Clyburn,2026-05-25
分层图景大致是四层:
业务层 · Skill:流程、规范、领域判断——"这类活该怎么干"
编排层 · agent:判断现在是什么任务,该加载哪份流程
连接层 · MCP:工具、数据、执行——"手能伸进哪些系统"
系统层:TAPD / CRM / 工单 / 数据库
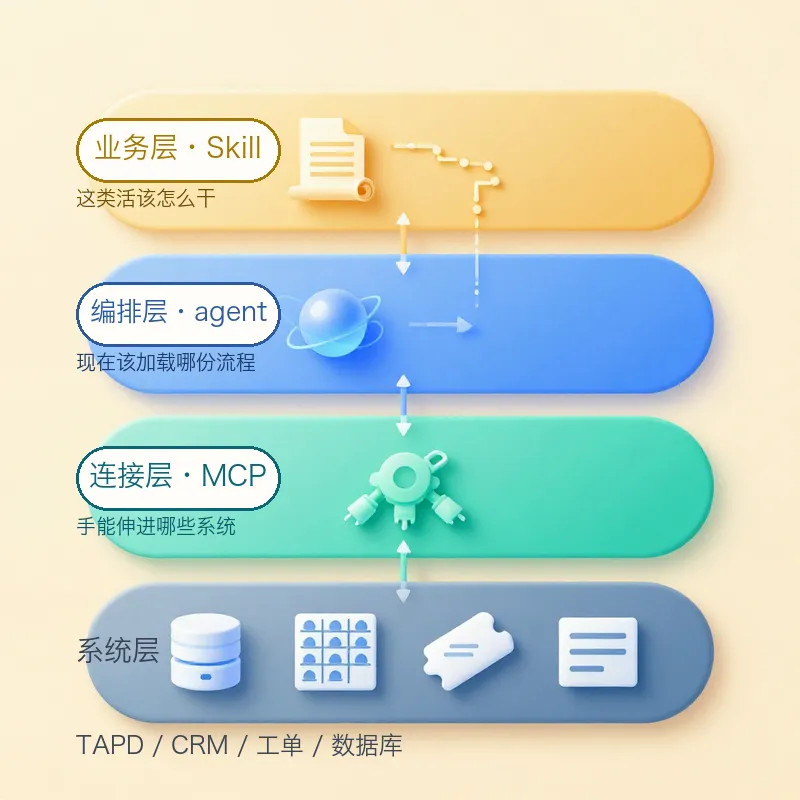
工具管连接,技能管章法——两层咬合
Skill 是把老师傅脑子里的流程,变成每个 agent 都能加载的文件。四层里少任何一层,都会掉进三种常见反模式。
只接 MCP 不写 Skill:Red Hat 原文里的场景,同样的 CRM 数据,每次取出来格式都不一样,agent 每次都在重新猜。
只写 Skill 不接 MCP:流程懂了,每一步还得人肉递工具,自动化无从谈起。
全塞进 system prompt(系统提示词,agent 每次开工必读的总说明):上下文税最重的交法,流程每改一次就得发一次版——写成 Skill 文件,有版本、能评审、可以先放小范围试用再全量铺开。
Red Hat 自己的例子是 DevOps:MCP 连着 Kubernetes、监控和事件系统,Skill 教告警怎么分级、阈值怎么定、报告按什么格式写。技术栈离多数行业有点远,翻成传统企业的话是三条:
🔁 知识迁移:换成传统企业,这 3 条直接对照
1. 先盘调用分布,再裁工具面——按"实际用了什么"裁,别按组织架构裁2. 流程知识写成"可加载的文件",不是"可宣讲的 PPT"——文件有版本、能评审、可先小范围试用(灰度)3. 给 agent 的操作规程,和给新员工的标准作业流程(SOP),是同一份知识——写一次,两头用
那 210 个工具,没经过选型——是我们自己写的:tapd-mcp-server,210 个工具、26 个模块,把 TAPD 的 API 包装给 Claude Code 用。它怎么长出来的,特别企划之一写过:用 Claude Code 开发它,再用它管理自己的开发;最近一个迭代(编号打码为"…0048")排了 10 条需求、19.5 人天、跨 5 周,全程在 TAPD 里流转。
工具多了,问题跟着来:agent 每次都要在 210 个工具里找路。收敛的依据是什么?我们没拍脑袋,拉了调用记录。
单项目口径:xihe-cli 一个项目的会话里,TAPD 工具被调用 391 次,其中 261 次是 update_task——更新任务状态、回填工时,一个工具占三分之二。全量口径:所有项目加起来 1.4 万+ 次调用,前三名是 get_stories 3481 次、create_comment 2619 次、update_task 2555 次。两个口径对不上很正常,哪个工具高频取决于项目在干什么;对得上的结论只有一条:工具面不是设计出来的,是调用分布算出来的。
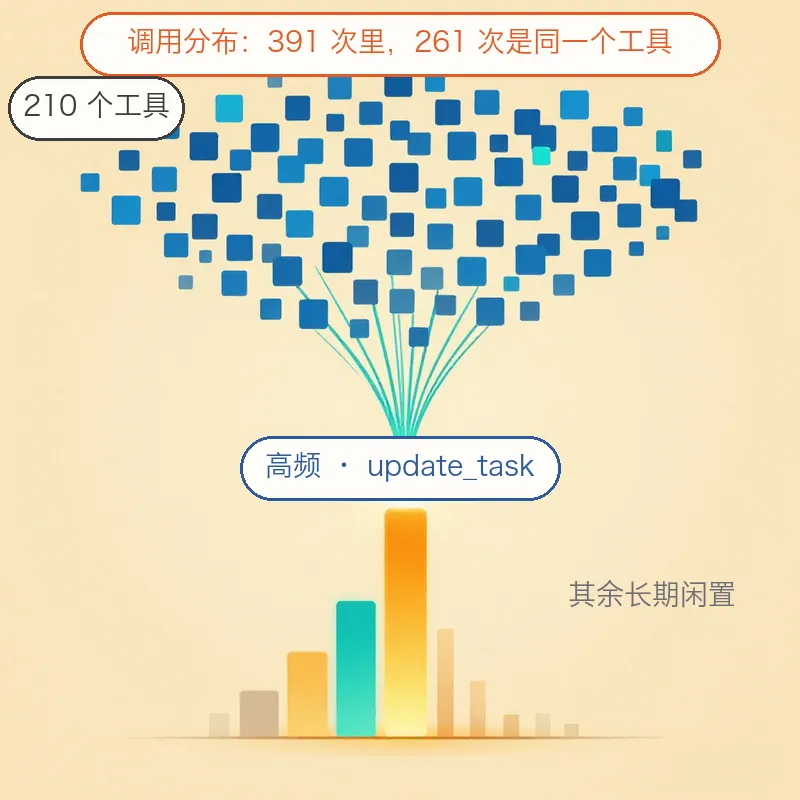
高频的就几个,其余的躺着交税
210 个工具摆在那里,每个场景真正高频的就几个,其余的躺着交税。
于是有了围绕这套工具的沉淀:10 个 TAPD skill、2 条规则,每一条背后都是一次真实翻车。
• 状态值禁止硬编码——AI 猜过一次状态名,九个任务顶着界面上没人认识的字符串过了一夜,就是之一篇里那次 status_3 事件。• 富文本字段必须传 HTML——纯文本进去格式全丢。• 写操作的降级禁止静默重试,POST 异常直接抛错——静默兜底会重复创建工作项,数据就脏了。• "SDK 已安装"是文档幻觉——4 月的分析文档白纸黑字说官方 SDK 已集成,9 月打开 package.json 根本没有。
连自己写的文档,都会骗 agent。
这 10 条里有 9 条是工程师撞出来的,但有一条,工程师写不出来。
tapd-timesheet 里写着我们的报工口径:末次活动在 18 点之后记 11 小时,否则记 7.5 小时;工时只能挂任务和处理过的缺陷,禁挂父需求。这不是技术参数,是工时制度——口径定成什么样,答案不在工程侧。实验室里还有一份同类条目:AI 自动回复系统什么时候转人工——连续 3 次不满意、紧急求助、用户点名要人。三个触发条件写的全是业务判断:什么情况下,机器该承认自己接不住。这类条目的定稿人,通常也不在工程侧——在 HR、在业务负责人。把这类判断从某个人的脑子里拿出来,变成可加载、可评审的文件——"业务知识资产化",最具体的形状就是它。
2026 年 9 月,我们把 tapd-mcp-server 拆成三包——tapd-core 装 210 个工具的共享内核,tapd-cli 给人用,tapd-mcp-server 给 agent 用——双入口共用同一个调用注册表,零能力重写。这个长法有先例——阿里云百炼的 bl 命令行(据我方 2026-09 立项调研):人敲命令,agent 走结构化参数,界面不同,内核没有必要长两遍。
skill 沉淀的效果,tapd-flow 这条最典型:流转状态之前,先查工作流 API 拿到当前可用的状态,再执行流转。两步,把 210 种可能性压成一条可复现的路径——agent 手上还是 210 个工具,但在这个场景里,它会走的只有这一条。
工具和技能各有一条供应链,MCP 这条在 2026 年已经出过事。
公开报道的安全研究里,有一种叫 tool poisoning 的攻击:恶意指令藏在工具的描述文字里,模型读得见,用户看不见——工具描述本身成了攻击面。更进一步的玩法是混注册表:有研究把木马化的 server 塞进合法的 MCP 注册表,用假账号和人为制造的复刻项目(fork),把信任信号做得很好看。
⚠️ 警示:这不是 MCP 协议层的漏洞,而是注册表和分发层的信任伪造——协议是开放的,但注册表不是无条件的。结论很直接:star 数和 fork 数,不能当准入依据。
Skill 这条供应链安静些,结构是一样的:复制来的每份 SKILL.md,和接入的每个 server 是同构风险。Anthropic 官方文档的提醒很直白——只从可信来源安装,安装前审查捆绑的脚本和资源。
Skill 的加载机制,还天然是权限分层的接口。Anthropic 的 Agent Skills 官方文档里的三层加载是这样的:
• 每个已装 skill 的元数据(名称加描述,约 100 token),常驻上下文;• SKILL.md 正文,判断相关之后才读入;• 捆绑的脚本,执行时才碰,甚至可以不进上下文直接执行。
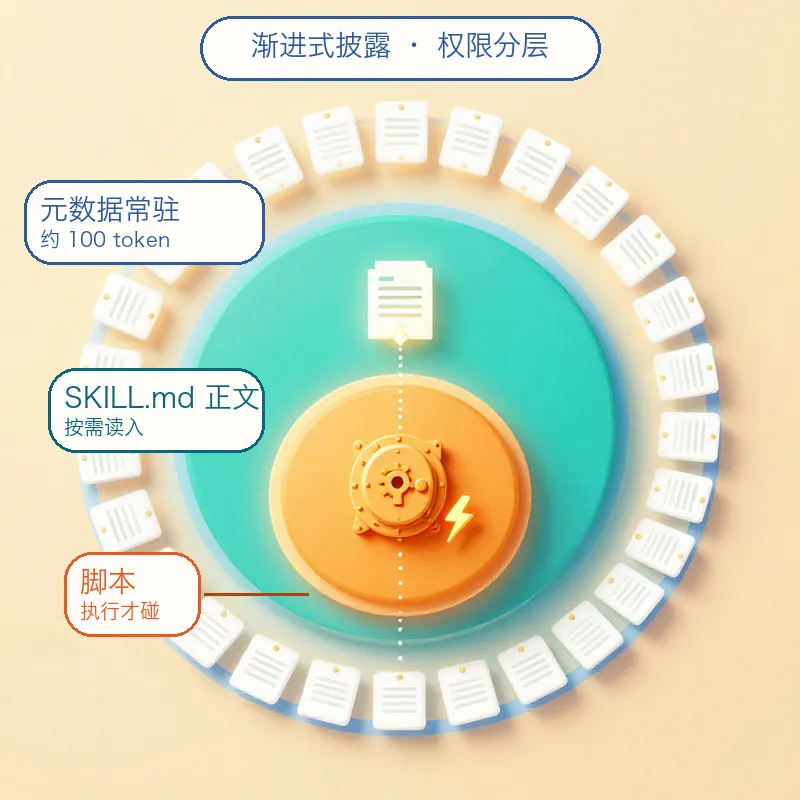
技术侧省 token,组织侧划权限
这个结构恰好是企业知识分层的形状:常驻的元数据,是全员可见的操作规程;按需加载的正文,是角色相关的流程细节;执行才碰的脚本,是涉密操作。渐进式披露在技术侧省的是 token,在组织侧划的是权限。
谁有权把一个 SKILL.md 放进元数据层——也就是放进每个 agent 的常驻视野、全员可见——谁就必须对它的准确性和安全性负责;元数据的评审标准,应该和内部全员可见的文档同级。
上下文治理和权限治理,是同一件事的两面:决定一段知识"谁能看到"的机制,同时决定了"它占多少上下文"。正篇 04《一个AI把战略规划泄露给前台,只需要一次搜索》写过数据权限,这里多走一步——知识也有权限。至于两条供应链的准入——白名单、装前评审、沙箱执行、按权限范围签发的令牌(scoped token)——业内做法大同小异,本文不展开。
落成行动步骤之前,有五个变量值得先想清楚。
1. 哪些知识值得沉淀为 Skill。三个条件可以参考:高频、步骤稳定、踩过坑。"踩过坑"容易读成空话,展开说:坑是例外处理、系统怪癖、文档没写的判断节点——比如"状态值必须查接口,不能硬编码"。反过来,一次性流程写成 skill 是负债:维护成本比省下的高。
2. 工具面收敛到什么程度。用调用分布说话,不拍脑袋。391 次调用里 261 次是同一个工具——这个比例,比评审会上任何一场争论都有说服力。
3. Skill 是组织资产,还是个人草稿。谁来评审、怎么版本化、怎么灰度——没有答案,skill 就还是个人笔记,人一走就散。正篇 02 和 03 讨论过的老问题,在这里换了个技术形态重新出现。
4. 上下文预算的审批权在谁手里。每接一个工具都是常驻支出,这笔预算谁来批——平台团队、财务,还是每个产品线自己认领?第二章算的是账,这一条问的是:谁来签字。
5. 两条供应链各自由谁审、审什么、沙箱放在哪层。SKILL.md 和 MCP server 的审查不必是同一批人,但都得有明确的主人。没有主人的供应链,等于敞着门。
四个问题,对照自己的团队:
📋 自检清单
• 你的 agent 开工前,上下文里躺着多少工具定义?数得出来吗?• 团队里最会干活的老师傅的那套流程,现在存在哪里——他脑子里,还是一份可加载的文件?• 上一次 agent 干错活,是工具没接对,还是流程没写清?• 复制来的 SKILL.md 和接入的 MCP server,最近一次被谁审查过?
答不上来的如果有两个以上,就值得把这五个变量排进下一次例会。
特别企划之一讲"AI 在维护我的 TAPD",这一篇讲的是它为什么长成了两层:MCP 把系统接进来,Skill 规定这些系统该怎么用——10 条 skill 里有 9 条来自真实翻车。这套架构往深处走还会撞出新问题,特别企划会继续写下去。
💡 觉得有用?复制这段话转发给你的CTO/HRD:我们给 AI 接了一堆工具,活还是干不利索。这篇用我们自己 210 个工具的实验讲透了为什么——工具管连接,技能管章法。第四部分建议细看。
💬 互动话题你的团队上下文里,躺着多少工具定义?A. 不到 20 个,数得过来B. 20 到 100 个,没细数过C. 数不清,也没人数过评论区聊聊你的答案。顺带一句:如果这篇让你重新估了手里那套工具面的分量,点赞、在看、转发,随意就好——不换任何东西。
声明案例真实性:文中实验室自证数据(210 个工具、26 个模块、调用分布、skill 与规则条目)均来自羲和实验室真实运营记录;外部数据(token 开销、Gartner 数字、安全研究)在正文标注了可查来源,部分行业观察为社区口径或未经独立复现,均已随文注明,引用口径以原文为准。免责声明:本文内容仅供学习交流,所述方法需结合实际场景灵活运用,不构成具体管理或采购决策依据;AI 工具输出结果仅供参考,关键业务决策请结合人工判断。AI 辅助创作:本文由 AI 辅助创作,经人工审核编辑后发布。
📖 系列文章(企业级AI协同实践 01-07 + 番外 · 特别企划)
羲和实验室
企业级AI协同 · 从部署AI工具,到设计AI协同
羲和实验室由AI训练师与智能体共同组成,致力于探索人机协作的最佳实践。
🚀 关注「羲和实验室」
点击下方卡片关注公众号
🚀 羲和实验室 · 企业级AI协同实践
从部署AI工具,到设计AI协同
企业级AI协同实践 · 特别企划之五 · 羲和实验室