ARTICLE · 1227391
长上下文与稀疏注意力——当文档长到读不起(Day 23 · 前沿瞭望③)
三种攻法,今天收官前两种
前三篇前沿是同一堵带宽墙(Day 2)的三种攻法:投机解码是一次读、多次产出(Day 21),量化是每次少读(Day 22),今天是第三种,也是最激进的一种——干脆少读:稀疏注意力。
先回链一笔旧账:Day 11我们算过长上下文的双重税——存储税(KV Cache线性增长,100k上下文=33GB/路)和每步回看带宽税(生成每个字都要把这33GB读一遍)。当时留下的悬念"软件侧长上下文优化"(Day 11原话:每一项把单路显存压下来的技术,等于不花钱翻倍通道数),今天兑现。
稀疏注意力的核心思想:不是每句话都该回头看全部历史
满血注意力的规则是:生成每个字,回头和所有历史token做一次注意力打分。但人类的阅读也不是这样的——读到合同第80页时,你主要依赖的是最近几页和开头那几个关键条款(当事人、定义),中间的过程性条款极少回看。稀疏注意力就是把直觉工程化(图1):
滑窗+锚点方案:每个token只看两类历史——最近W个token(滑窗,比如4k),加上开头极少数"锚点"token(几个到几十个,负责承接全局信息)。其他历史不再参与注意力,KV甚至可以丢弃或卸载。
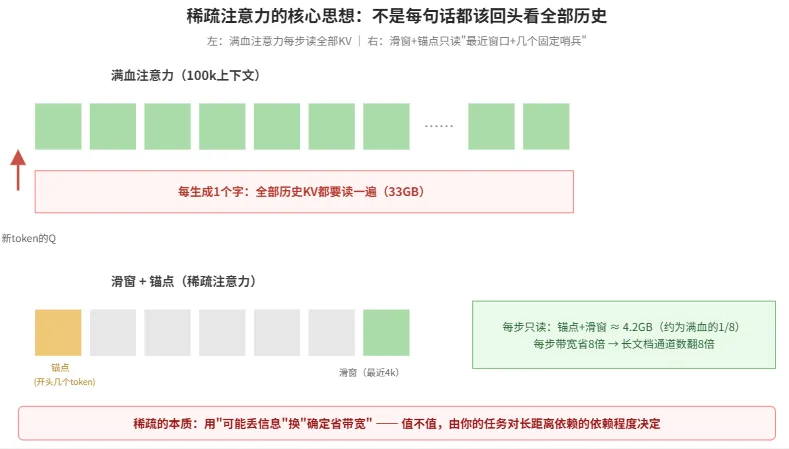
图1:满血 vs 滑窗+锚点。右图每步读取量从33GB降到约4.2GB(1/8),对应Day 11的通道账:同样集群,文档通道数×8
这笔账的直接推论:长文档业务的通道数(产能单位)第一次可以靠软件优化而非加卡来翻倍——这正是Day 11说"金融文档业务愿意为长上下文优化付溢价"的机理。
稀疏的家族谱系
滑窗只是最朴素的一档,按"砍法"从保守到激进排一排:
KV选择/压缩类:不固定窗口,而是动态挑重要块(H2O、StreamingLLM思路)——注意力分数高的历史保留,低的丢弃或压缩成块级摘要。比滑窗聪明,代价是引入选择机制本身的开销。
块稀疏类:以块为单位决定看不看(如NSA一类硬件友好方案),把稀疏模式设计成对GPU/加速器访存规整的形状——稀疏不只要省,还要省得规整,否则随机跳读的kernel效率会吃掉理论收益(Day 5的gather冷水在稀疏时代升级版)。
线性化类:最激进——把注意力换成O(1)每步的状态更新(Mamba/RWKV一族),彻底告别KV Cache。代价是表达能力的长距离依赖上限存在争议,适合流式场景,慎用于"全文精确比对"类任务。
代价与边界:大海捞针测试
稀疏不是免费的,代价有一个著名的检验器:大海捞针测试(Needle in a Haystack)——把一句关键话埋进十万字无关文档里,问模型那句话说了什么。满血注意力轻松通过;滑窗方案如果那句话在窗口外且不在锚点里,就会丢掉。选型时的动作因此很明确:要求厂商在您业务的真实文档+真实问题上做回归测试,不只看官方捞针曲线——捞针是合成任务,您业务里"第3章的免责条款"是不是总在"针"该在的位置,只有您知道。
另一层边界是任务的"长依赖性质":文档问答(局部性强)受益大;跨章推理、全文一致性校验(如合同前后条款冲突检测)受益小甚至有害。先给业务做"长依赖依赖度"分级,再谈上不上稀疏。
与RAG的分工:一个在进门前,一个在进门后
常被混淆的一对:RAG(检索增强)是进门前裁——只把检索到的相关片段放进prompt,输入本身变短;稀疏注意力是进门后裁——全文都读了(Prefill照算),只是生成时注意力不再全覆盖。两者可叠加:RAG压缩输入,稀疏管理长程依赖。给客户讲方案时把这层分工说清,专业度立刻超过大多数供应商。
专栏:长上下文军备竞赛的经济学
行业正在经历"上下文通胀":从8k到100k到1M,数字竞赛如火如荼。但三本账冷静下来看:一,上下文翻倍,KV存储翻一倍、注意力计算翻四倍(平方税)、每步回看带宽翻一倍——成本的三条曲线里两条是超线性的;二,很多业务要的其实不是"更长的窗口",而是"更准的检索"(RAG)或"更聪明的裁剪"(稀疏);三,满血长上下文的价格终会高到只为真需求服务——那时稀疏松软方案就会分走大部分市场。这个判断不站队任何技术,只站队账本。
三段式练习
· 客户原话:"我们要做100k合同审查,满血上下文太贵了,有没有省钱的办法?"
· 技术翻译:① 任务分级:合同审查里"条款抽取"局部性强(稀疏友好),"全文一致性校验"长依赖强(需满血)→ 混合策略 ② 通道数账:滑窗+锚点把每路读取从33GB压到~4.2GB(图1口径),通道数×8或卡数÷8 ③ 验收设计:客户真实合同集做两类任务回归,稀疏方案在一致性校验上的损失要量化给业务方签字 ④ 与RAG叠加:条款库检索先行,输入端再裁一刀
· 方案要点:先分级再选型——"审查"不是一个负载,是一组负载,每一级长依赖依赖度对应一档技术方案,分开验收分开报价。
明日预告
Day 24(前沿收官):《端侧推理的临界点——手机跑大模型,靠什么》。三种攻法讲完,最后一篇瞭望把视线从数据中心移向口袋:当模型小到能进手机,推理的账本会如何重写。