ARTICLE · 1234905
AI 智能体用得最多,不等于测得最准:软件测试还要补一张关联表
导语
现状一句:不少团队建了多个 AI 测试 Agent,看板上却只有一个总调用量。
反常识一句:GitHub 在 10 月 22 日把自定义能力明细从最多 5 条扩到 25 条,但用量变大仍然不等于质量变好。
收益一句:看完你能拿到一张AI 测试能力归因表,把调用量、通过率、风险和成本落到具体 Agent、Skill 或工具入口上。
结论先给:AI 测试的下一步不是多建几个 Agent,而是让每次使用都能归因到具体能力,再和测试结果关联起来。
一、名字出现,先解决的是“谁在干活”
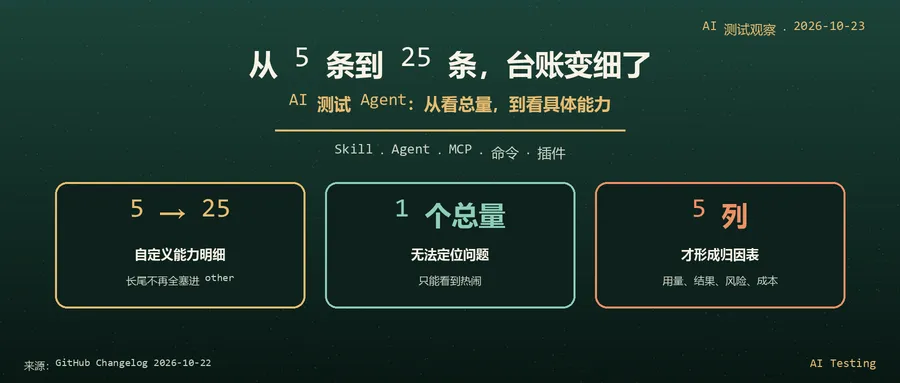
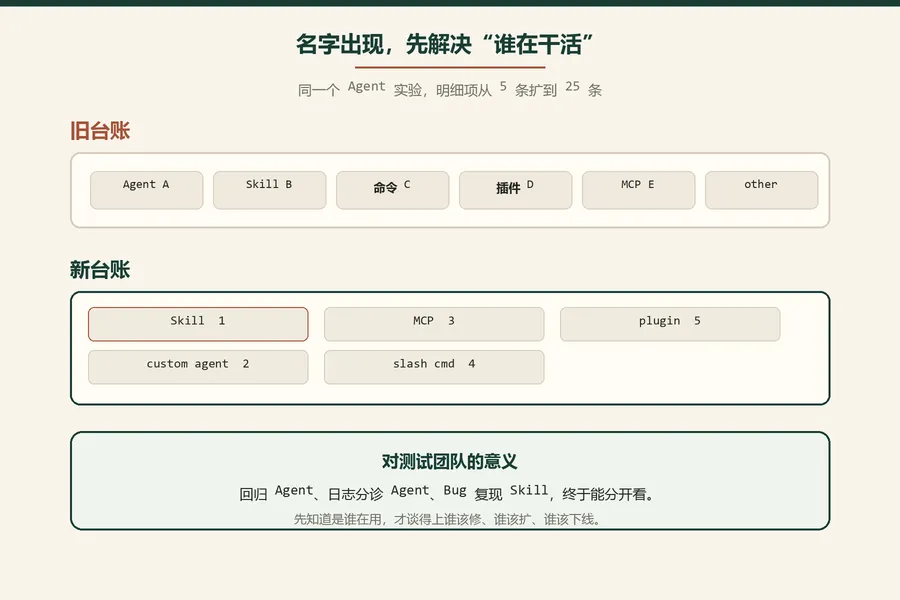
GitHub 的 Copilot 用量指标现在会显示组织自定义的 Skill、custom agent、MCP server、slash command 和 plugin 名称,不再统一塞进 other 或 custom。每个明细列表最多展示 25 项,超出部分才合并到 other;此前上限是 5 项。
对测试团队的意义很直接:当 API 回归、日志分诊、Bug 复现和用例生成分别由不同 Agent 承担时,你终于可以先分清是谁被使用,而不是只有一个总量。
如果能力名称不稳定,同一种能力还会分裂成多条记录,趋势和复盘都会被污染。
二、用量涨了,不代表测试变好了
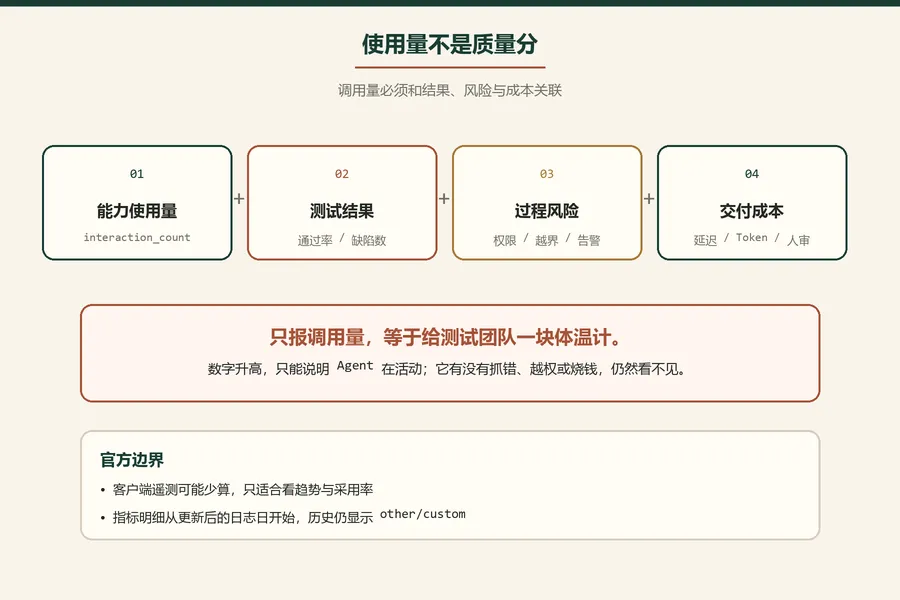
这次更新没有改变 interaction_count 和 distinct_use_count 的计算方法,只让自定义项更容易被识别。官方也说明,这些数据来自客户端遥测,客户端过旧或遥测被阻断时会少算,只适合看趋势和采用率,不适合当精确账本。
所以“某个 Agent 调用最多”只能证明它被使用,不能证明它抓到了更多 Bug,也不能证明它的调用过程安全。用量必须和测试结果、轨迹及成本做关联,否则只是热闹。
例如,某回归 Agent 的调用从 100 涨到 300,缺陷发现数没有增加、单次成本却翻倍;这更像把任务交给了更贵的路径,不能直接写成提效。
三、可抄:AI 测试能力归因表先补五列
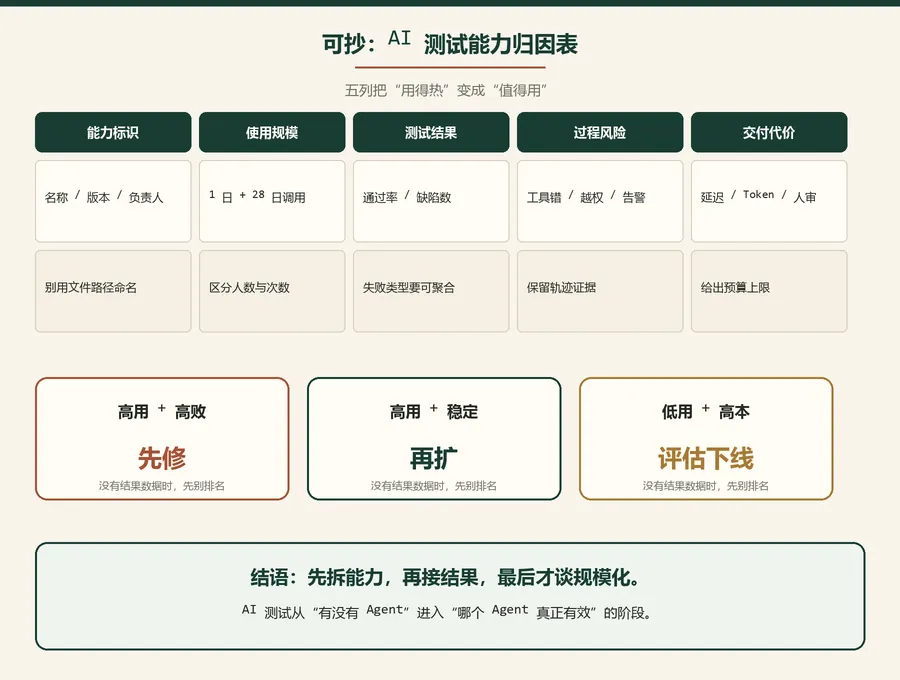
能力标识:Agent、Skill 或工具的稳定名称、版本与负责人; 使用规模:1 日与 28 日调用量,区分独立使用者和重复调用; 测试结果:关联用例通过率、缺陷发现数和失败类型; 过程风险:工具调用错误、权限越界、敏感数据接触与告警; 交付代价:延迟、Token、人工复核时间和维护成本。
这张表的价值不在“排行榜”,而在定位:高调用、高失败的能力先修;高调用、稳定通过且成本合理的能力再扩;低调用又高成本的能力直接评估下线。没有结果数据时,先别排名。
四、每周只追三个问题,就能决定扩、修还是砍
第一,最常用的能力是否也在制造最多的失败?这是在修流程。第二,效果稳定的能力是否只服务了少数人?这是在评估推广空间。第三,低频高成本能力是否仍在消耗预算?这是在砍维护负担。
同时要把能力名称当配置治理:使用稳定且有业务含义的命名,避免暴露文件路径或客户信息;指标只从更新后的日志日开始出现,历史数据仍会显示 other 或 custom。上线前后要记录切换日期,别拿两套口径直接比。
结语:AI 测试从“有没有 Agent”进入“哪个 Agent 真正有效”的阶段。先把能力拆出来,再把结果接上去,最后才谈规模化。
互动提问:你们团队会按模型、Agent、Skill 还是具体业务任务统计 AI 测试效果?现在最想砍掉的是哪一种低效能力?