ARTICLE · 1235592
新一代油藏模拟软件,何必是软件?
设想一个工作场景:工程师打开一个已经完成历史拟合的油藏模型,只需提出一句话:“在保持总注水量不变的前提下,比较三种注水制度对采收率、含水率、压力分布和剩余油的影响。”系统检查现有数据,提示缺失条件,生成可审查的算例配置,调用模拟器运行,跟踪日志,再将结果整理成对比报告。工程师把精力放在假设、方案和结论上,重复的软件操作逐渐退到后台。
这听起来像未来产品的一种形态。先说明一句:下面描述的是一个设想中的工作流,用来说明系统需要做哪些事,不代表已有产品能完整做到。值得讨论的是:油藏模拟软件已经发展了几十年,当计算内核越来越成熟、任务又可以由智能系统编排时,我们还需要把它想象成一个必须打开并逐项操作的桌面程序吗?
从早期计算程序,到成熟的商业模拟器
油藏模拟的历史早于今天熟悉的软件界面。20世纪前半叶,研究人员借助砂包、电解模型和电阻网络等物理类比,研究压力传播与流体运动。到了20世纪50年代,早期计算设备开始承担渗流方程的数值求解。Donald W. Peaceman 对这段历史的回顾提到,1951年前后,Humble Oil 的研究人员仍在使用物理模型;随后,研究团队利用 IBM 604 等设备开展气体渗流计算。1953年前后,已有一维单相气体渗流的数值解发表,1954年的相关研究进一步推动了数字油藏模拟的发展。
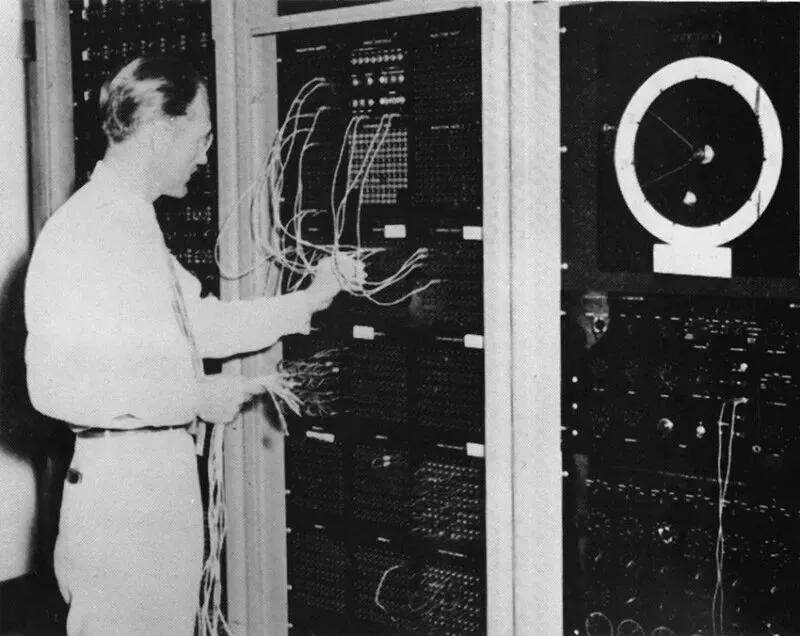
最初的模拟程序多由石油公司和研究机构内部开发,计算规模受机器内存、运算速度与数值方法制约。随着三维、多相模型逐步成熟,模拟开始从研究代码走向工程产品。行业历史回顾资料将 D. R. McCord & Associates 的产品列为1966年进入市场的早期商业模拟器案例之一。此后,黑油模型、组分模拟、混相驱、化学驱与热采等能力陆续扩展,油藏模拟也逐渐成为油田开发研究的重要工具。
1983年,ECLIPSE 向首批客户部署。此后几十年,网格描述、井模型、复杂流体、并行计算和图形可视化持续进步。工程师可以在三维地质模型中检查井位和属性,比较压力、饱和度与产量的变化;模拟器也逐渐融入地质建模、PVT、历史拟合、生产分析和开发方案优化等工作流程。
今天的模拟软件,已经很强
如今,ECLIPSE、INTERSECT、CMG、tNavigator 等商业平台覆盖了多类油藏模拟任务;OPM Flow 等开源项目则为研究者提供了可检查、可扩展的模拟器实现。以 OPM Flow 为例,它支持全隐式黑油模拟,并利用自动微分支持流体模型开发,也扩展到 CO₂ 储存、热模拟等应用。
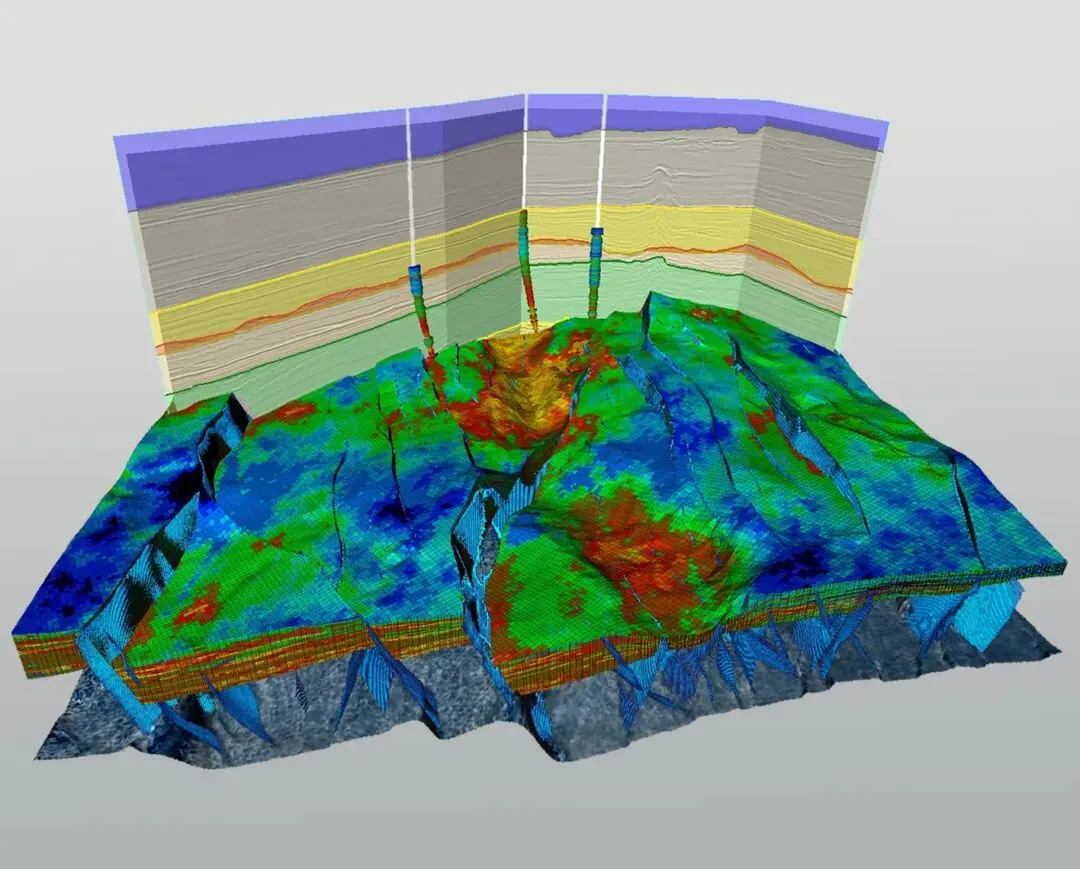
这些工具的核心价值在于长期积累的物理模型、离散方法、非线性求解、工程验证和生产实践。真实油藏中的多相流、复杂井控、强非均质性与大规模网格,仍然需要可靠的数值模拟能力来处理。
工程师的日常工作也因此形成了一条较长的链路:整理地质与流体数据,准备网格、PVT、相对渗透率和井控;编写或修改输入文件;运行计算并排查报错与不收敛;再从大量输出中提取曲线、切片和指标,完成方案比较与报告。许多时间消耗在模型配置、工具衔接和结果整理上。
下一代产品,可以从“操作软件”转向“描述任务”
自然语言提供了一种新的入口。工程师可以用专业语言描述目标、约束和关注指标,系统再把任务拆解成模型检查、参数修改、算例运行、日志诊断和结果分析。对用户而言,交互方式可以是一段对话;对后台而言,它仍然需要调用明确的工具、真实的模拟器和可复核的数据。
这类产品可以有几种形态。它可以是现有软件中的对话助手,帮助解释关键词、检查输入文件和分析日志;可以是通过 API 或命令行调用的云端模拟服务,让其他工程平台直接使用计算能力;也可以是垂直领域智能体,根据任务组织多个算例、监控作业状态、比较结果并形成报告。
垂直领域能力可以从专业知识库、模拟器手册、关键词规则、项目数据和工具调用逐步建立。许多场景可以先用通用大模型配合专业知识检索、结构化输入解析与确定性校验,再根据实际需要决定是否进行领域微调。真正关键的是系统能否正确理解工程语义、调用正确的工具,并把每一步操作留在可审查的记录中。
这条路已经出现了公开探索
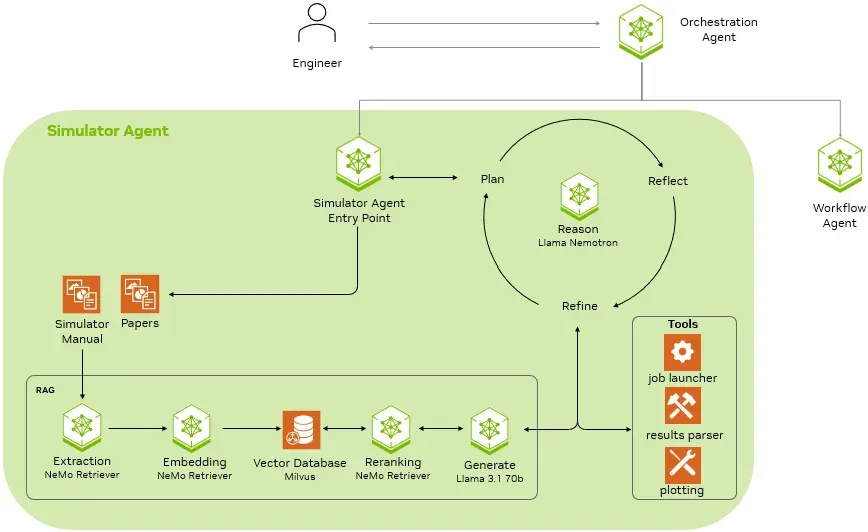
2024年,AWS 与 Stone Ridge Technology 介绍了面向油藏模拟的生成式 AI 助手,涉及专业知识检索、模型输入检查、运行日志分析和结果解读。2026年,NVIDIA 的技术文章进一步展示了将模拟器助手、工作流管理和结果分析连接起来的智能体方案,并以 OPM Flow 等工具作为模拟工作流的一部分。这些公开探索说明,领域知识、智能体和真实模拟器之间已经可以建立实际的连接。
除了云厂商和芯片公司,公开信息中也能看到 SLB、Halliburton 等油服企业在把智能助手接入现有的油藏模拟与开发平台,CMG、Emerson 等传统模拟器厂商则在原有产品上扩展自动化与 AI 能力。不同路线的共同点是:先解决“能不能可靠调用模拟器”,再谈“能不能自主决策”。
不同方案的自动化程度和适用边界仍有差异。面向真实工程项目的系统还需要持续验证模型配置、异常恢复、数据安全与计算结果的可靠性。尤其要区分三件事:大模型提出的解释、模拟器实际算出的数值,以及尚待工程师确认的假设。
从一句工程问题,到一组可复核的算例
下面是一个设想中的工作流,用来说明系统需要做哪些事。
例如,工程师提出:“以当前历史拟合模型为基准,比较三种注水制度;保持总注水量和生产井控制不变,重点分析含水率、累计产油量、压力分布和剩余油变化。”
系统首先确认模型版本、单位、流体与岩石参数、井控和比较指标是否齐全。信息不足时,先向工程师追问;条件确认后,再生成不同方案的输入配置,记录每个算例与基准模型之间的差异,调用模拟器执行,并检查运行日志、收敛状态和关键输出。最后,系统交付方案对比、关键图表、异常说明和完整的运行记录。
工程师仍然需要审查模型假设与计算结果。数值求解成功,说明当前离散模型完成了计算;模型是否足以代表真实油藏,还要结合历史拟合、现场数据和专业判断来评估。智能系统应当帮助工程师更快地发现问题、组织证据和探索方案,同时保留人工确认关键假设与决策的环节。
还有哪些硬骨头
把“能跑通一次演示”变成“能在项目里长期使用”,中间还有几道坎。
一是责任边界。 智能体给出一个开发方案,如果结果不好,责任算谁的?系统必须把“建议”和“决策”分开:关键假设、边界条件和最终方案,仍然要由工程师确认并签字。
二是版本与可追溯。 模型版本、输入 deck、模拟器版本、算例差异、运行日志,要能串成一条可回放的链。否则出了问题,既说不清是数据错、配置错,还是模型本身不适用。
三是非收敛与异常。 油藏模拟最常见的失败不是“算错”,而是“算不动”。智能体要能识别不收敛、给出可能的调整建议,并在多次尝试失败后停下来交给人,而不是盲目重试、消耗算力。
四是知识时效。 模拟器手册、关键词规则、最佳实践都在变。知识库需要有版本和适用范围,避免用旧规则去解释新版本,也避免把某一块油田的经验生搬到另一块。
五是成本与延迟。 一次多方案对比,可能意味着几十次模拟。哪些任务值得让智能体跑,哪些还是手动更快,需要算一笔账;大模型调用、算力排队和结果整理,都不是免费的。
六是开放接口。 OPM 这类开源模拟器容易接;很多商业模拟器并不开放 API。智能体要真正落地,绕不开这个现实,也需要和厂商、平台一起解决。
七是人机界面。 工程师在哪里审、审什么、怎么批,需要专门设计,而不是最后弹出一份报告就完事。好的系统应该把“哪一步是模型算的、哪一步是模型猜的、哪一步需要人判断”标清楚。
未来的“软件”,可以是什么?
油藏模拟产品的形态可能逐渐分化:桌面软件继续服务于复杂建模和可视化;命令行与 API 负责自动化调用;云端平台管理计算资源和批量任务;垂直领域智能体负责理解工程目标、组织工作流和解释结果。这些形态可以并存,也可以在同一套系统中协作。
回看这段历史,油藏模拟从物理类比走向数字计算,从内部研究程序走向商业模拟器,再走向集成化工作流。下一步的变化,很可能发生在人与计算能力的交互方式上。
所以,“新一代油藏模拟软件,何必是软件?”真正值得追问的是产品形态的边界。当系统能够理解工程意图、调用可靠的数值计算、组织任务并交付可复核的结果时,它可以是一款软件,也可以是一项服务,或者一套围绕工程任务运行的智能系统。
但更准确地说,软件不会消失,变的是人和计算能力之间的接口。 桌面软件、命令行、云服务、智能体会长期并存;工程师从“打开软件、逐项操作”,转向“描述任务、审查结果”。软件退到后台,工程师的位置反而更靠前——因为要判断的,仍然是地质认识、模型假设和工程决策。
延伸阅读
• Donald W. Peaceman, “A Personal Retrospection of Reservoir Simulation” — 早期油藏模拟与计算设备发展史。 https://archive.computerhistory.org/resources/access/text/2024/06/102739347-05-0002-acc.pdf
• J. W. Watts, “Reservoir Simulation: Past, Present, and Future,” SPE Computer Applications, 1997. https://doi.org/10.2118/38441-PA
• SPE/JPT, “Ten Technologies From the 1980s and 1990s That Made Today’s Oil and Gas Industry” — ECLIPSE 发展历史。 https://jpt.spe.org/ten-technologies-1980s-and-1990s-made-todays-oil-and-gas-industry
• OPM Flow 官方介绍。 https://opm-project.org/?page_id=19
• AWS 与 Stone Ridge Technology, “Building a generative AI reservoir simulation assistant with Stone Ridge Technology,” 2024. https://aws.amazon.com/blogs/industries/building-a-generative-ai-reservoir-simulation-assistant-with-stone-ridge-technology/
• NVIDIA Developer Blog, “24/7 Simulation Loops: How Agentic AI Keeps Subsurface Engineering Moving,” 2026. https://developer.nvidia.cn/blog/24-7-simulation-loops-how-agentic-ai-keeps-subsurface-engineering-moving/