ARTICLE · 1245273
Paimon AI 原生湖仓——从 Unified Lake Format for Data + AI 到多模态入湖.我试着整理成一套能讲给别人听的话.
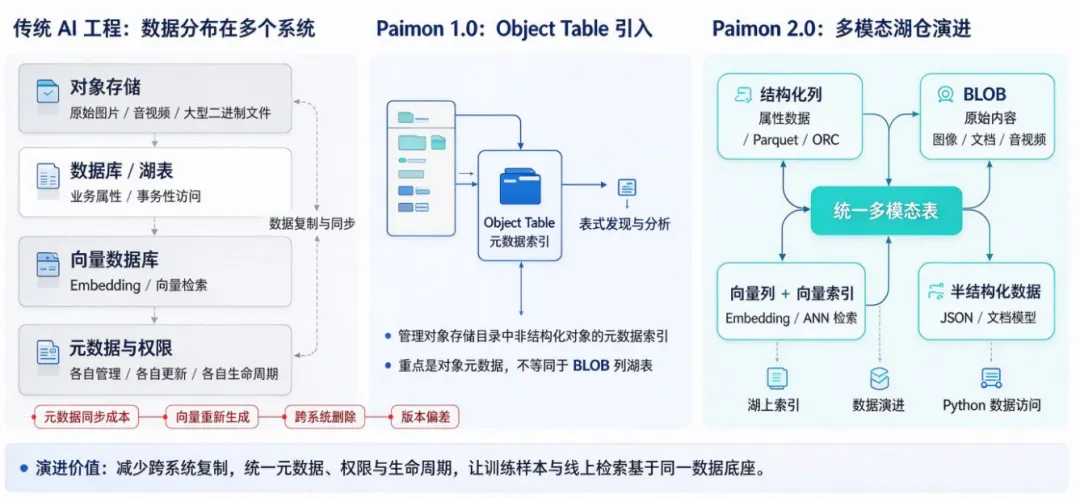
如果你的数据始终活在一张表里,比如订单表、用户表,那你大概率没经历过“一张最小可用的 AI 数据集居然要横跨四个系统”这种事。
图片在对象存储,业务属性在数据库,Embedding 在向量库,训练版本在训练脚本里——这些系统各自有各自的元数据、更新流程、权限和质量基线。听起来只是“麻烦一点”,实际是每次你想让 AI 看到同一份数据,都得先把四个系统的口径对齐一遍。
对象存储确实适合存二进制,数据库确实适合拿来做事务性访问,专用向量库确实对在线检索优化得更好。这个体系没有大错,但它在重复造“同一份真相”:同一张商品图,在对象存储里有一份元数据,在数据库里有一份业务属性,在向量库里有一份向量。模型升级时,三处全部要变,而它们几乎不可能同时变完。
Apache Paimon 想做的事,是给这些“各过各的”数据一张共同的桌子:一个逻辑表里,能放下结构化属性、原始图片、文本切块和 Embedding。不是把二进制塞进普通列,而是让它们围绕同一份逻辑结构,各自用各自最合适的物理形态存在。
我花了两天把文档、社区讨论和版本发布记录过了一遍。下面是我整理出来的“说人话版本”。
一、Object Table 和 BLOB,根本是两件事
新手最容易混淆的就是“Paimon 1.0 不是已经有 Object Table 了吗?为什么 2.0 还要强调 BLOB?”
这两个东西解决的问题完全不是一个层次。
Object Table 是给“躺在对象存储里的文件”建一个目录索引。桶里有什么文件、文件名、大小、上次修改时间,这些元数据可以被当表查。重点在“发现”:我知道 S3 里有一个目录装的是商品图,但我没法快速回答“哪些图片大于 2MB”。Object Table 让这种问题变得可回答。
但注意,它查的是元数据,不是文件内容。图片内容还是躺在原先的对象存储里。
BLOB 是另一件事:它把二进制内容本身纳入了表管理。说直白一点,商品图数据入表以后,这张表的逻辑行就变成:
product_id | category | title | image | embedding |
其中 image 是一个真实的 BLOB 字段,物理上落在独立的 .blob 文件里,和普通结构化列分开存放。这样你查询 product_id 和 category 时,完全不需要去读图片内容。
有一种模式是 Managed BLOB:表自己管理文件生命周期;另一种是 Blob View/描述符引用方式:表里只保存引用信息,读取的时候再去上游解析,避免再把完整二进制复制一份。
所以“统一到一张表”并不是把所有内容塞进同一个文件,更不是外部对象自动被复制进 Paimon——逻辑统一和物理复制是两回事。
二、VECTOR 是数据类型,不是搜索能力
Paimon 2.0 提供了 VECTOR<t, n> 类型,可以用来表达固定维度的稠密向量。它支持 BOOLEAN、TINYINT、SMALLINT、INT、BIGINT、FLOAT、DOUBLE 这些元素类型,维度不带默认值。
但它不能用作主键、分区键或排序字段。向量列可以走专用的 Vortex 文件做独立存储,优化读取,但独立存储不等于你可以直接按相似度搜。
这是多模态湖仓最容易让人误解的地方:
- 向量存储解决的是“向量怎么放”;
- 向量索引解决的是“查询向量怎么找近邻”。
你定义了一个 VECTOR<FLOAT, 768> 列,只是说明“这张表里有 768 维稠密向量,物理上按向量文件存放”。如果你没有构建索引,那查询向量时就是全表暴力比对。这对小表不是问题,但对千万级以上的表,就是一个灾难。
三、索引和可见性,是工程上最容易翻车的地方
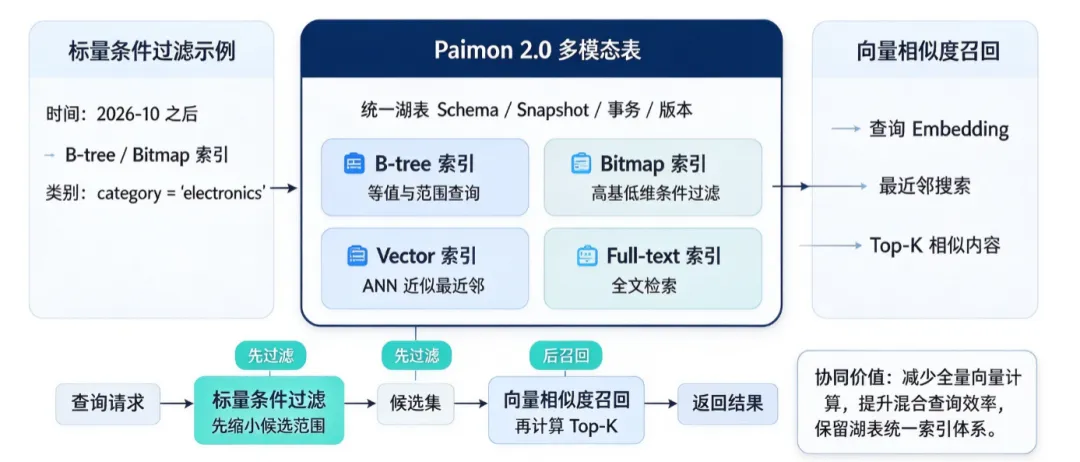
Paimon 2.0 的全局索引体系包含 B-tree、Bitmap、Vector、Full-text 等方向。它们解决的问题不同:
- B-tree / Bitmap:标量条件过滤,比如“只查 2026-10 之后、category = 'electronics' 的数据”
- Vector 索引:近似最近邻(ANN)检索
- 两者配合:先通过标量索引缩小候选范围,再对候选集执行向量相似度召回
听起来很顺,但工程上有三个坑:
坑 1:索引不是建表自动带的。
你建了表、导入了数据、定义了向量列,不等于索引已经构建完毕。索引构建需要单独触发,提交后才会被查询用到。
坑 2:索引有可见性窗口。
数据写入、数据提交、索引构建、索引提交是分开的步骤。新数据已经入表,但如果索引还没完成构建或提交,向量检索就召回不到它们。这在云托管实现里常常是最容易踩的 SLA 坑。
坑 3:过滤条件不一定下推。
不是所有 WHERE 条件都能配合向量索引执行预过滤。只有命中对应 B-tree 或 Bitmap 索引覆盖范围的表达式才会下推,其他条件可能在向量召回之后才过滤。如果业务要求“仅搜索 2024 年以后的文档”,但日期字段没有任何索引覆盖,那结果可能在召回后才被过滤,先扫全量,性能会大打折扣。
四、真正的数据链路:入湖、回填、索引、检索
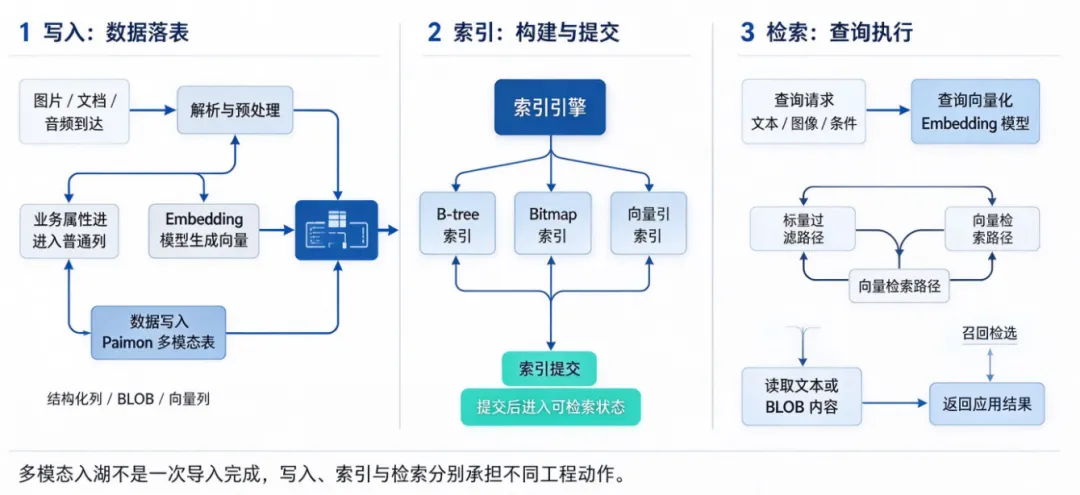
多模态入湖不是“导一次数据完事”。完整的链路至少包含三层动作:
- 写入:图片/文档/音频到达,业务属性进入普通列,Embedding 模型生成向量,数据落表
- 索引:支持引擎构建并提交 B-tree / Bitmap / 向量索引
- 检索:查询时生成向量,走符合条件的过滤路径,召回候选后读取对应文本或 BLOB 内容
这三个阶段是串行发生且互相依赖的。数据写入了,索引没提交,等于查不到。模型升级了,向量回填了,但索引没重建,等于新旧向量混着查——结果跑偏。
这就是为什么向量模型升级时,必须给每一行记录 model_version。查询向量和索引里的向量必须来自兼容的模型版本,否则召回的正确性无从谈起。升级时先回填、再重建索引、最后切换查询路径,不能图省事一把梭。
五、湖上检索 vs 专用向量库:谁该退场?
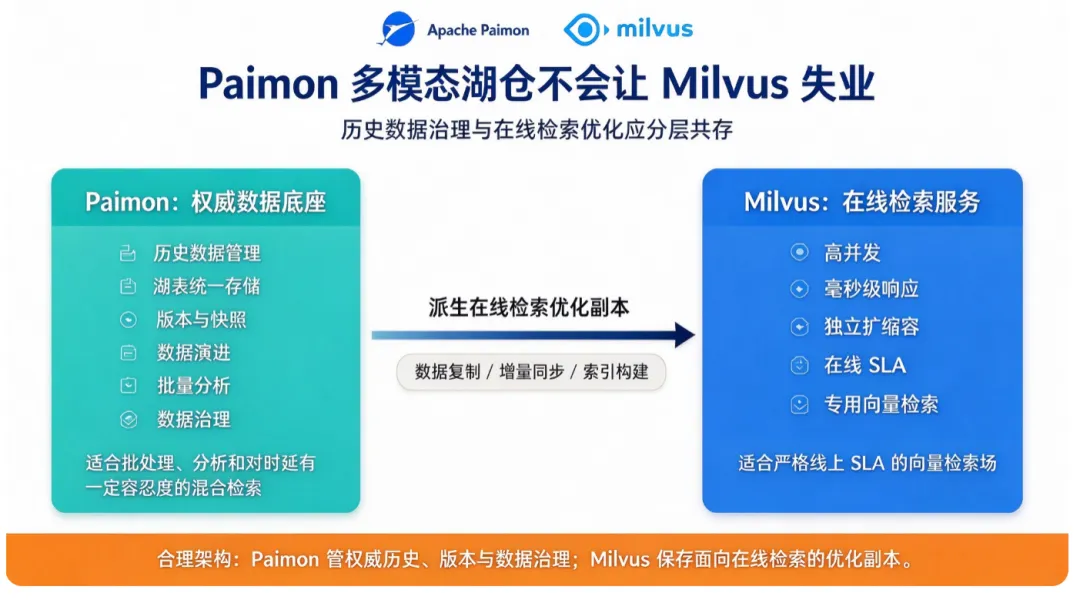
这里得泼一盆冷水:Paimon 多模态湖仓不会让 Milvus 失业!
Paimon 的核心优势是历史管理、湖表统一、数据演进和批量分析。如果你的检索场景以批处理、分析或对时延有一定容忍度的混合检索为主,那湖上方案确实可以省掉“数据复制到向量库”这一层。
但如果你的场景是线上严格 SLA:高并发、毫秒级响应、独立扩缩容,那么专用向量库仍然有它的位置。
两者可以共存,而且合理形态通常是:
- Paimon 管权威的历史数据、版本、数据治理
- 向量库保存从 Paimon 派生出来的在线检索优化副本
这时工程上真正要管的是同步延迟、删除传播、模型版本和故障后的重建流程,而不是谁替代谁。(可以跟StarRocks查询湖表和内表的场景进行类比)
“百万向量毫秒召回”这类话,不要当作默认承诺。实际性能取决于向量维度、数据规模、索引类型、标量过滤的选择性、召回率要求、硬件配置和并发模式。想搞清楚,用代表性数据跑压测,然后拿数字说话。
六、我留下的几个判断
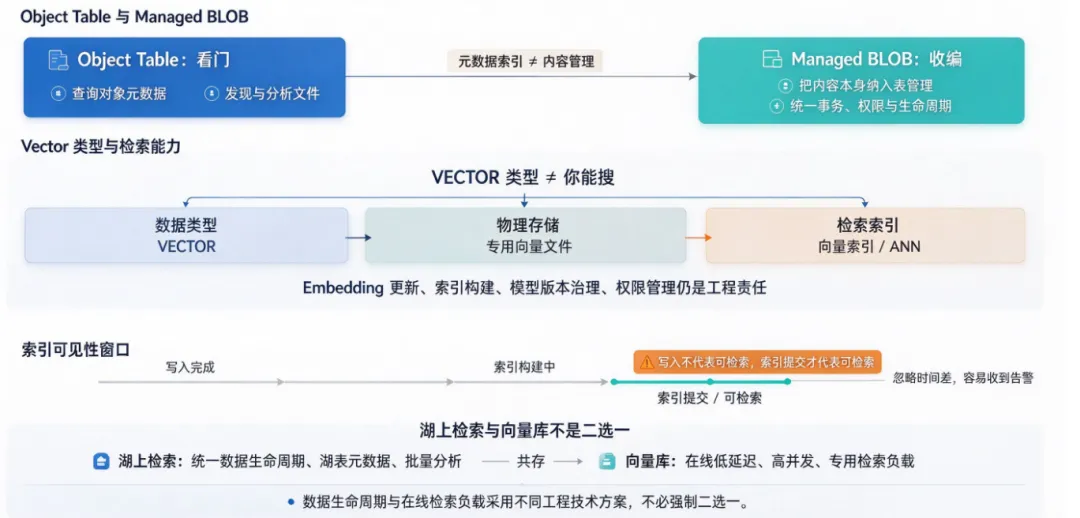
- Object Table 是看门,Managed BLOB 是收编。Object Table 能查对象元数据,但不管理内容;BLOB 是真正把内容本身纳入表管理的方向。
- VECTOR 类型≠你能搜。三件事永远分开看:数据类型、物理存储、检索索引。
- 统一表≠统一一切。Embedding 更新、索引构建、模型版本治理、权限管理都还是工程责任,不会因为“放一张表”就自动消失。
- 索引可见性窗口是生产事故高发区。写入不代表可检索,索引提交才代表可检索。谁忽略这之间的时间差,谁半夜收告警。
- 湖上检索和向量库不是二选一。
数据生命周期和在线检索负载本来就该有不同的工程技术方案,该共存的就共存,不用为了架构简洁而强制二选一。
下一篇(第 28 篇)进入检索层:《统一多模态检索——一条 SQL 完成全文、标量与向量混合召回》,进一步分析 Paimon、StarRocks、DLF 与 Milvus 在不同检索路径中的职责边界,以及如何根据数据新鲜度、召回质量与在线 SLA 设计可验证的混合检索架构。