ARTICLE · 1269129
用 Python 批量解析 PDF 公开文档:字抽不干净,后面全是白干
一、先花三秒判断这份 PDF 有没有字
公开源上的 PDF 大致三类。我碰到过一份三百多页的法规汇编,前四十页能抽,往后全是影印,一份文件里两种东西都有。Word、LaTeX 和排版软件导出的属于文本层,页面里有字符对象,抽得出来。扫描件整页就是一张图,一个字符都没有,抽出来是空字符串。混合型常见,也麻烦,正文有字,附件页是扫描,图表本身也是图。常见的公开源里,政府报告、国际组织文件、专利公开文本、企业年报多数是文本层,扫描件更多出现在历史档案、影印附件和部分法规汇编。
判别不看扩展名,看两件事:一页能抽出多少字符,页面上有多少图片对象。两个数一起看才有意义,字符数接近零、图片数是一,就当扫描件处理;字符数正常、图片也有几张,说明正文能抽,图里的字抽不到,得单独再过一道。这两个数还有别的用法:线条数多而字符数少,往往是表格线撑起来的空表模板;一页里图片超过三张,这页多半是图片版式,抽出来的正文会很稀。
混合型只能按页判,不能给整份文件贴一个标签,同一份文件前二十页能抽、后面几页得送 OCR,很正常。
import pdfplumber
with pdfplumber.open("report.pdf") as pdf:
page= pdf.pages[0]
chars= page.chars# 每个字符一条:size、x0、x1
print(len(chars),len(page.images), len(page.lines))
命令行上还有一道更快的闸。pdfinfo 看三个字段:Pages 大得离谱的先隔离,Encrypted 是 yes 的分流走另一条路,Producer 写着扫描仪或者复印机型号的,按扫描件处理。
判别这一步省掉,后面所有质量问题都会算到模型头上。
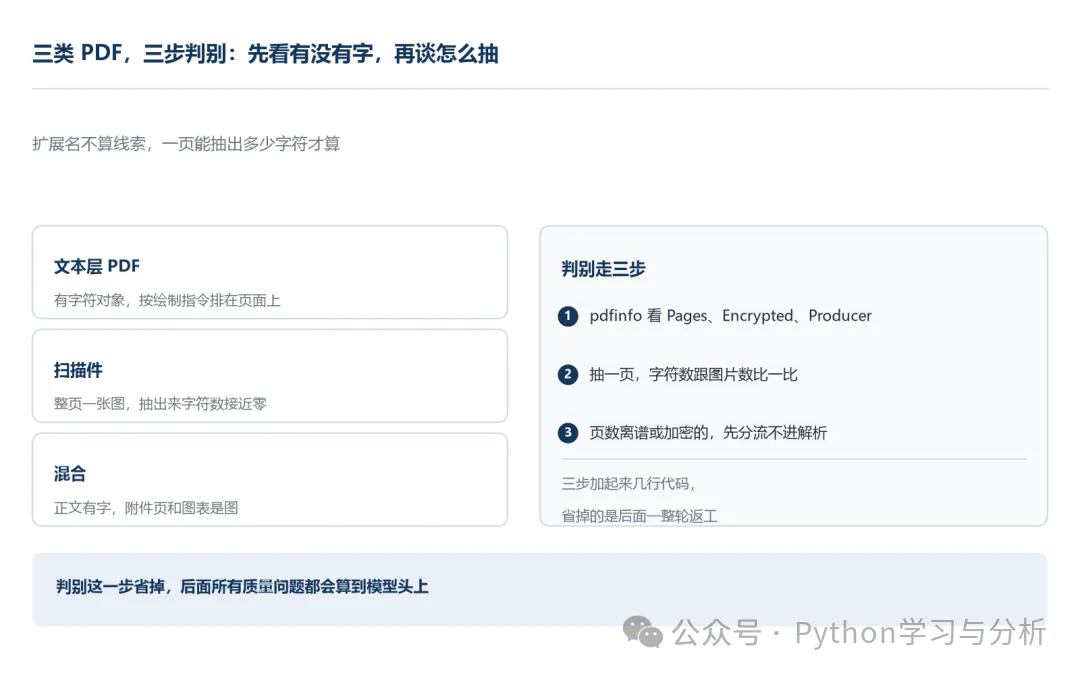
图1 三类 PDF 与三步判别:先看有没有字
二、抽出来读不通,先怀疑顺序
ISO 32000 定义的文本操作符就 Tj、TJ、Td、TD、Tm 这一类,全是把某段字画在某个位置的指令。规范里没有段落、句子、词这一层语义对象。抽取出来的原始顺序,是内容流里指令的先后,不是人眼阅读的顺序。
页脚、页码、水印、印章往往是末尾才画,于是它们插在正文中间。反过来也常见,有的排版软件先画侧栏再画正文,抽出来读着像句子被人剪碎又拼错。表格里的字和正文也可能在流里交错,同一张表被拆进段落的两个位置。我们最早那一版是整页抽文本、按句号切段,东西发出去才发现落款跑到了第二段中间。
补救只能靠坐标重排:先做行聚类,同一个 baseline 上的字符归成一行,行按 y 排序,行内按 x 排序。行聚类的容差别开太大,baseline 差两三个点以内算同一行,再松就会把上下两行并成一行,字号大的标题行先出事。
行排好了,段落还得自己拼。PDF 里没有段落标记,能用的线索只有三个:行尾有没有排到右边界,排到了说明这段还没完;下一行行首有没有缩进,缩进了多半是新段;行距有没有突然变大,变大了也多半是新段。三条一起判,顺手把每行的 x0 和 x1 记下来,缩进量就是现成的。这一层做不实,后面切句、抽事实全是虚的,换个再强的模型也补不回来。
import fitz# PyMuPDF
doc = fitz.open("report.pdf")
for pno, page in enumerate(doc):
forblock in page.get_text("dict")["blocks"]:
ifblock["type"] != 0:# 1 是图片块
continue
forline in block["lines"]:
forspan in line["spans"]:
span["text"],span["size"], span["font"], span["bbox"]
span 里除了 bbox,还有三件关键属性:size 是字号,font 是字体名,flags 标着粗体和斜体。这三样后面全要用,判标题层级、判页眉页脚、判表头落在哪,靠的都是它们。
多数库都提供 sort 参数,但 sort 只管到块级。双栏页面下照样是乱的,别指望一个开关解决问题。pypdf 从 3.x 起 extract_text 多了个 extraction_mode 参数,取 layout 时按版面走,顺序好一些,代价是慢。选库还有一条许可上的事要看清:PyMuPDF 是 AGPL-3.0 或者商业授权,对外交付的商业系统得留意,pypdfium2 是 pdfium 的绑定,许可在 Apache 2.0 和 BSD 三条款之间,宽松得多,可以做替代。
速度上的体感量级是这样:同一台机器抽同一页双栏正文,纯 Python 的 pdfminer 路线是几十毫秒到一百多毫秒,fitz 是个位数毫秒,差一个量级。这是体感,不是基准测试,别拿它当选型依据。
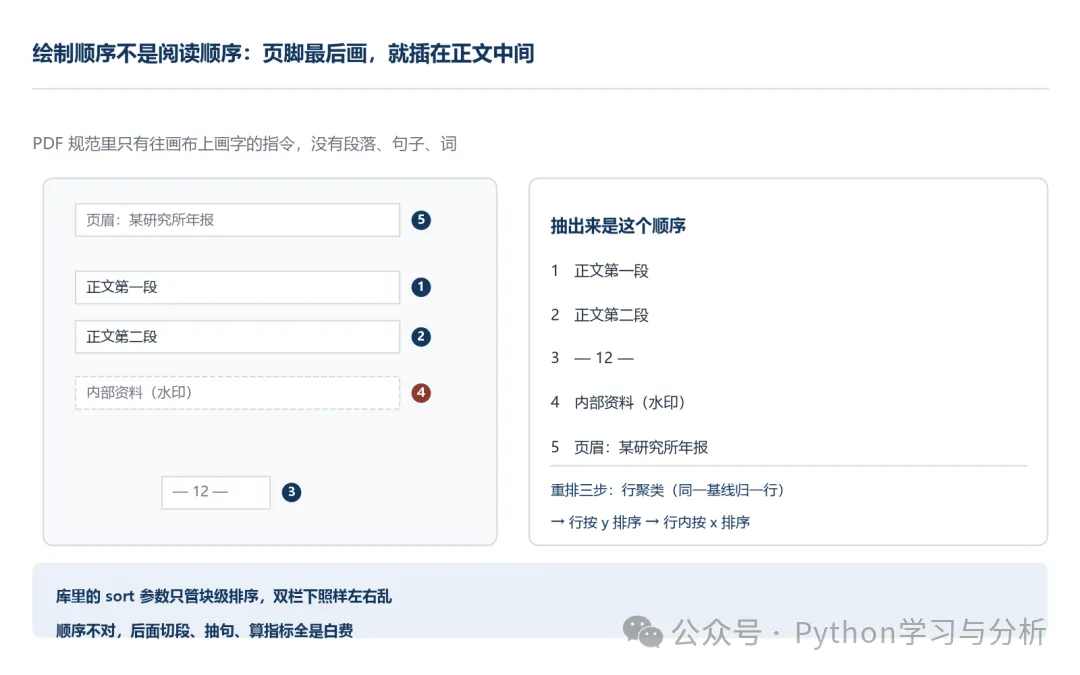
图2 绘制顺序不是阅读顺序:页脚最后画,就插在正文中间
三、双栏和页眉页脚:位置比内容可靠
单栏按 y 排没问题,双栏就出事。两栏的行在 y 上几乎平行,按 y 排就是左右交替,读起来像两句话被缝到了一起。
做法是先按 x 分栏:对字符的 x0 做一维聚类,或者看正文块的宽度分布,正文块宽大约是页宽一半,这一页就是双栏。两列字符之间那段空白宽度超过两倍字号,就从那里切。切完栏,再在每栏内按 y 排。
页眉页脚用统计法。每页首尾各取两行收集起来计数,出现在六成以上页面上的行判为页眉页脚。
from collections import Counter
def header_footer(pdf):
c= Counter()
forpage in pdf.pages:
text= page.extract_text() or ""
lines= [l.strip() for l in text.splitlines() if l.strip()]
forl in lines[:2] + lines[-2:]:
c[l]+= 1
n= len(pdf.pages)
hit= max(3, int(n * 0.6))
return{t for t, k in c.items() if k >= hit}
短文档这个比例没有意义,页数少于五页就换判据:走白名单,或者按位置判,顶部 8% 和底部 8% 里的行先当页眉页脚搁着。
页眉页脚不剔掉,会同时污染正文和去重指纹。同一份报告换个站点发布,页眉不一样,正文哈希就不一样,去重直接失效,同一份文件在库里躺着好几份。剔的时候整行拿掉,不要按字符挑着删,行框整个去掉,正文的断行才不会被改坏。
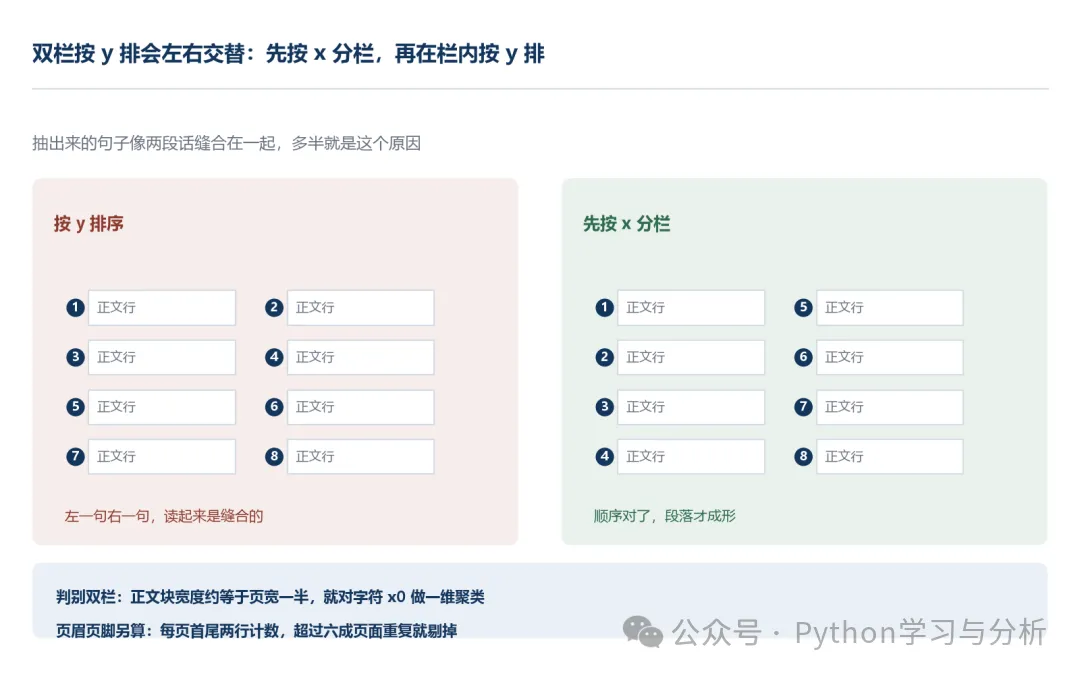
图3 双栏按 y 排会左右交替:先按 x 分栏
四、中文抽成「信 息 采 集」:那些空格本来不是空格
一堆字被空格隔开,来路有两条。一条是排版软件为了对齐,逐字定位每个字的位置,抽出来字符之间就被插了空格。另一条是字间本来没空格,解析器按间距超过阈值就当词间隔的规则自己补的。
判断依据是字符框的间隙:拿相邻字符的 x0 减上一个字符的 x1,只有超过大约 0.3 倍字号才当空格。pdfplumber 的 chars 里每个字符都带 x0、x1、size,够用。中文字号普遍比西文大,阈值按字号的比例算比按固定磅值算稳。
还有一种不是空格的东西:有的排版软件用全角空格做首行缩进,抽出来缩进落进了正文,每段开头多两个空白,按行清理的时候得先把缩进认出来再丢掉。
还有两个坑得提前防。西文断行带的连字符要粘回去,hyphen 加换行加 nation 得拼成 hyphenation,但 legit-imate 这种词内本身带连字符的不能一起粘,判法是看连字符前面那行是不是正好排到了右边界。字体没有 ToUnicode 映射的时候,抽出来是 (cid:123) 这样的一串,或者干脆一片乱码,这是字体嵌入的问题,换库救不了,只能拿 OCR 兜底。
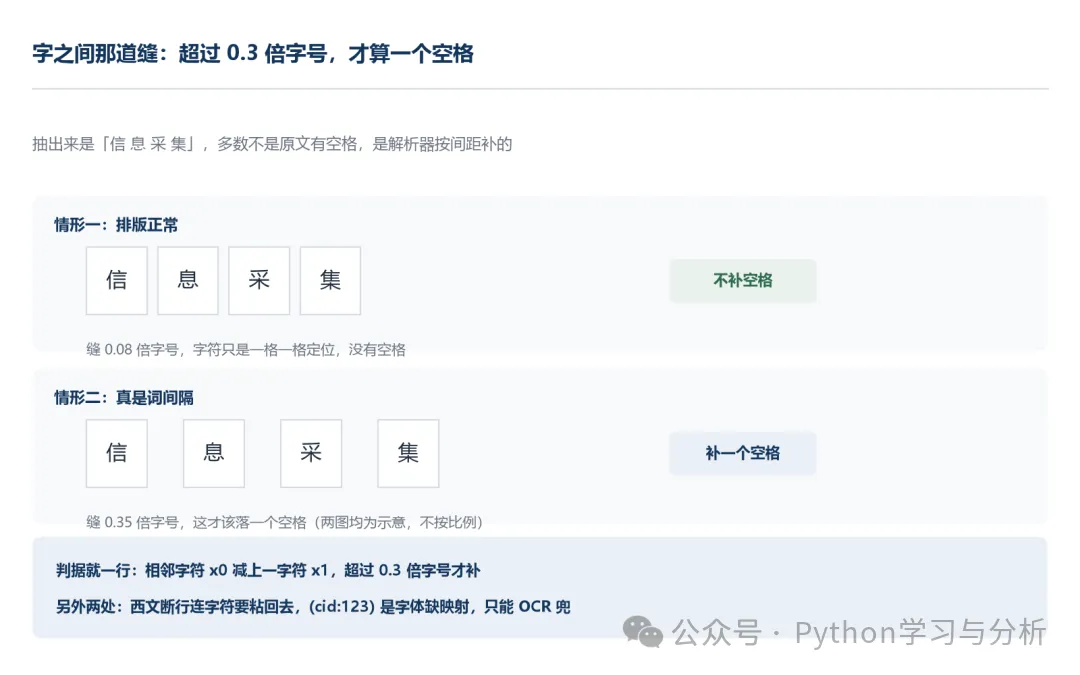
图4 字之间那道缝:超过 0.3 倍字号才算空格
五、表格:有线一套、无线一套,别用同一个参数
pdfplumber 的 extract_tables 默认按页面上的线条切单元格,矩形边也算线条。策略有四种:lines、lines_strict、text、explicit。默认 vertical_strategy 和 horizontal_strategy 都是 lines,snap_tolerance 和 join_tolerance 都是 3。
有框线的表用 lines。没框线只有对齐的表换 text,靠词的位置推虚拟线,参数不能一套用到底,有线和无线本来就是两种版面。text 会把相邻两列的短词粘到一起,得配 min_words_vertical 往上调,默认 3,意思是同一条对齐线上至少凑够三个词,才认作一列边界,列里全是短词就往下调,列里全是长句就往上调。Camelot 的思路一样,lattice 对有线,stream 对无线。
# 有框线的表
t1 = page.extract_tables({"vertical_strategy": "lines"})
# 没框线,只有对齐
t2 = page.extract_tables({"vertical_strategy": "text",
"min_words_vertical":3})
真正麻烦的是三处。合并单元格会重复出格或者丢格;跨页表要按表头字段拼,不能拿页尾去拼页首;数字被列宽切断,一个金额的头一半落在上一行、尾一半落在下一行,得按列宽反推才能接回来。表头也不一定在首行,可以先拿 page.crop 把页眉页脚裁掉再做表。
表格抽出来的东西必须带置信度,人工要核的那部分得能被挑出来。一批几百张表进库,没有置信度,谁也不知道该看哪几张。
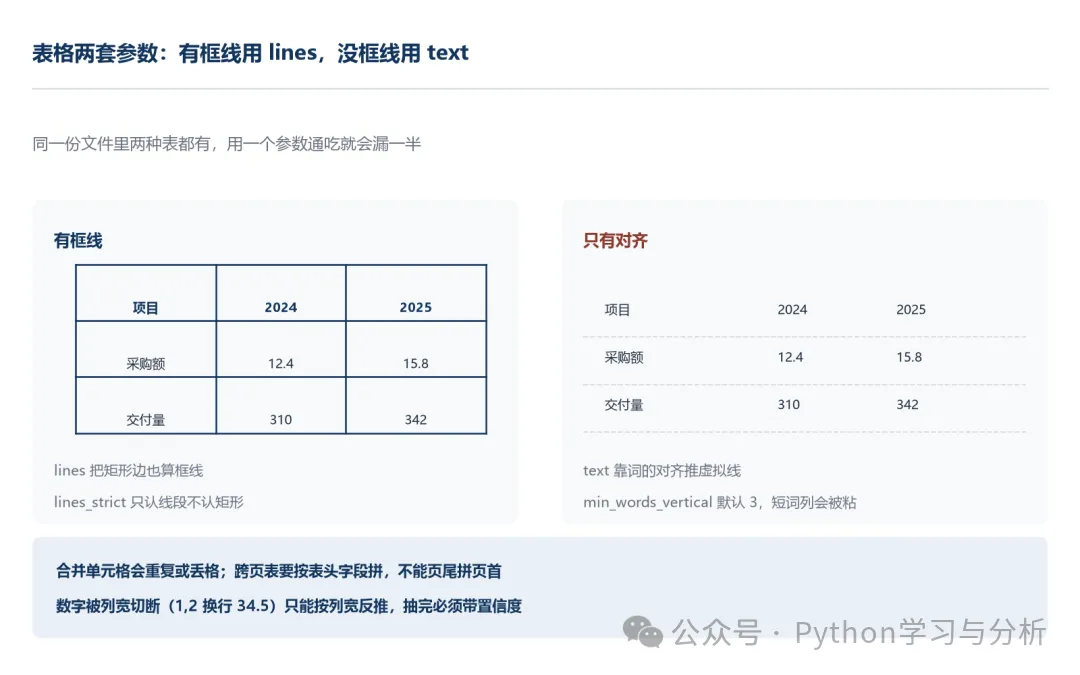
图5 表格两套参数:有框线用 lines,没框线用 text
六、扫描件:什么时候值得上 OCR
别整库都过一遍。先算字符密度,每页中文字数除以页面面积,低于阈值的才走 OCR。阈值别拍脑袋,拿一批已知是扫描件的文件先算一遍密度,取一个能把它们和文本层干净分开的位置。
渲染成图按 300dpi 走,tesseract 官方文档写明图片 dpi 至少 300 效果才稳。渲染完做灰度化、二值化,Otsu 就够,再去黑边,页面倾斜的先纠偏,这几步省掉,识别率掉得比换引擎还明显。
tesseract 的中文要装 chi_sim 语言包,--psm 是版面假设,6 是一整块统一文本,4 是单列可变字号文本,表格页别用 6,它会把整页当成一段读。中文表格和竖排用 PaddleOCR 更稳。
三条硬要求:OCR 结果必须标来源是 OCR,跟文本层的字分开存;每页存一张渲染图快照,往后核对时能回溯;OCR 出来的数字要单独走一次校验,金额、日期、编号三类正则各过一遍,错一个数字比错十个字严重得多。tesseract 也给得到词框,别只存整页文本,坐标不存,前台跳转的时候没地方落。
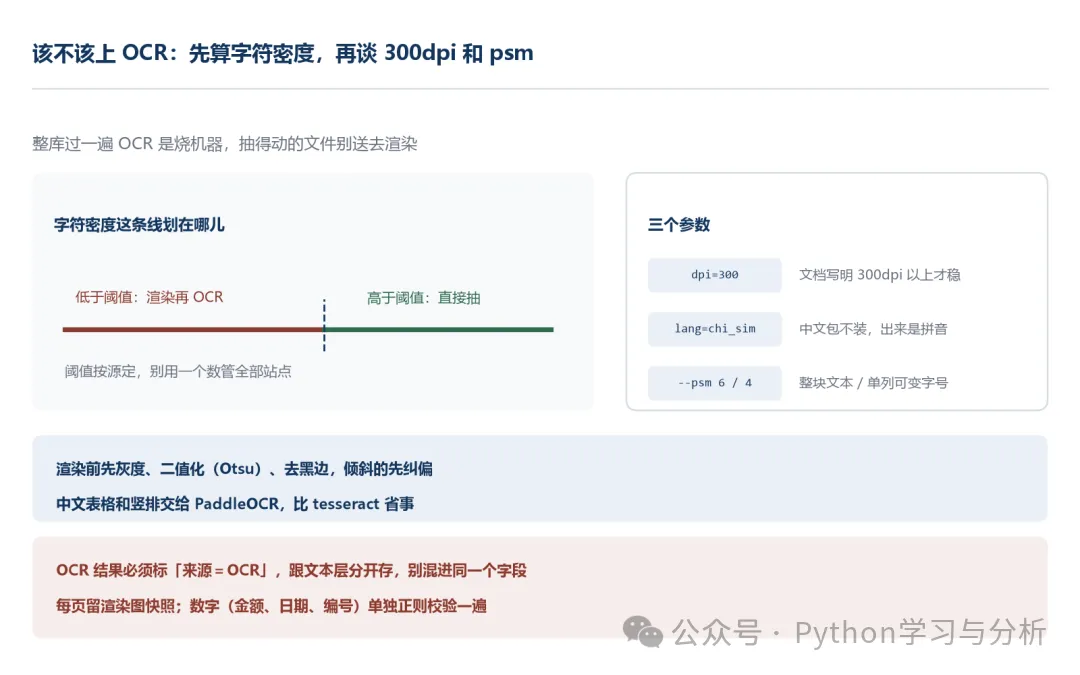
图6 该不该上 OCR:先算字符密度,再谈 dpi 与 psm
七、批量这一层:四件事比解析算法更容易出事
并发按 host 限,不是按总量限。总量限到五十,落在同一个站点上的可能就有二十个,那是自己找封。每个 host 一个信号量,跑得慢一点,但能跑整夜。我们跑过一整夜才发现,卡住的不是总量,是同一个站点上的二十个连接。
流式下载,单文件大小设上限,页数也设上限。先用 pdfinfo 或者 pikepdf 数页,几千页的先隔离出来单独跑。构造出来的畸形文件也得防,pikepdf 的 check 能查出文件结构问题。
失败进死信队列,按状态码和异常类型分类重试,别无限重试。重试次数给上限,退避时间随次数往上加,同一批文件连着失败三次就停手等人看。临时文件和渲染图要及时清,磁盘比 CPU 先满。
加密得分两种处理。真需要口令的,跳过并记录,别硬试。只设了权限口令的很多机构文档都这样,禁止复制禁止打印,能打开但抽出来是空的。这种情况别当解析失败反复重试,白烧机器,日志里全是假故障,真故障就看不见了。
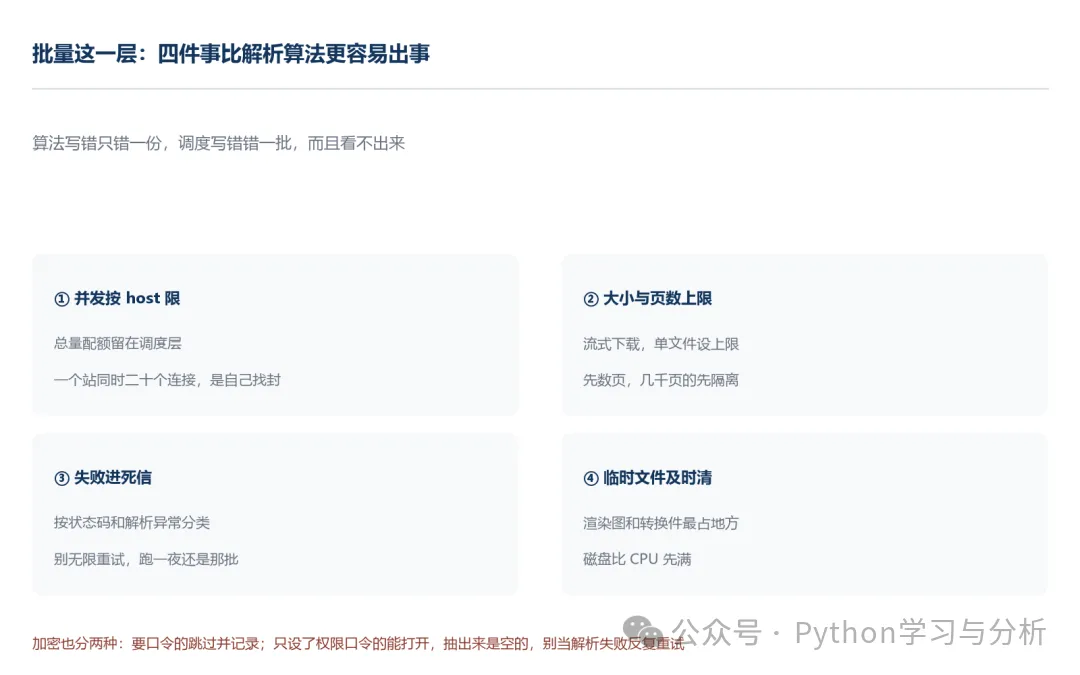
图7 批量这一层,四件事比算法更容易出事
八、抽完怎么知道抽坏了
三个指标,按源分档打。字符覆盖率,抽出的字符数除以按版心面积估出来的容量。领域词命中率,自己维护一份词表,机构名、装备类别、法规名都放进去,命中率骤降基本就是抽坏了。数字完整率,金额和日期的正则命中数比上页面里的数字串数。
分档的办法不复杂,按源算近七天的均值,跌到均值七成以下标黄,连着两天黄就回看那一批文件,比随机抽查有效得多。
指标只能指到“哪一批可疑”,还得人去看。我每周抽二十份,每份翻一页跟原文对读,十分钟的事;抽出来的东西以表格为主的,再多看一眼表头对齐没有。这活没人愿意干,但不干,指标掉档了也不知道掉在哪儿。
存的时候拆两张表。文档表放文件、来源、时间、正文哈希;块表放页号、bbox、块序号、文本。块级坐标一定要留着,前台才能点一句话跳回原文那一页,把那句话框出来。引用关系单独记一条,一条结论对应哪几个块,后面核对口径全靠它。
易海聚这边解析和采集是分两个池子跑的,附件单独排队,解析失败的进单独的表,不跟采集失败混着看。这两件事混在一起,谁也别想定位问题。要动手改,从给解析失败单独建一张表起,改动少,几天就能见效。
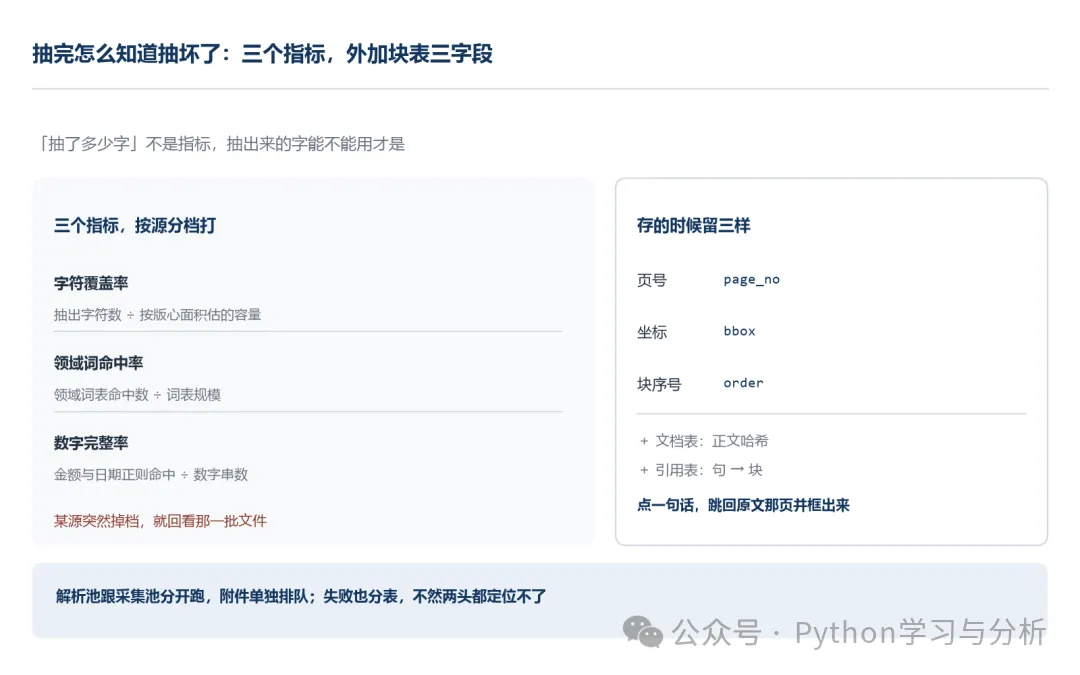
图8 三个质检指标,外加块表三字段