ARTICLE · 1277969
把 PDF 表格丢给 AI,三秒变 Excel
月底把一沓供应商发票的 PDF 摊在桌上,对着屏幕一行行往 Excel 里敲。敲到第三张,太阳穴就开始跳,心里算着这周又得搭进去两小时。
这事怎么突然变简单了
前两天 OpenRouter 发了一篇教程,讲怎么让 AI 直接读 PDF、把里面的表格抽出来。听起来像开发者的玩具,但它捅破了一层窗户纸:会"看文件"的 AI,国内早就能用了。豆包、通义、ChatGPT,还有 Excel 里那个 Copilot,都能干同一件事。
以前你以为"PDF 转 Excel"得找 IT 部、得买软件。其实它归你,今天就能试。
我第一次知道这招的时候,差点笑出声。想想自己手抄过的那些对账单,那种"早知道"的懊恼你大概也熟。
怎么把 PDF 喂给 AI
步骤就两件,不用记。第一,把 PDF 拖进对话框。第二,说一句:"把表格转成 Excel,保留原来的列名和数字。"
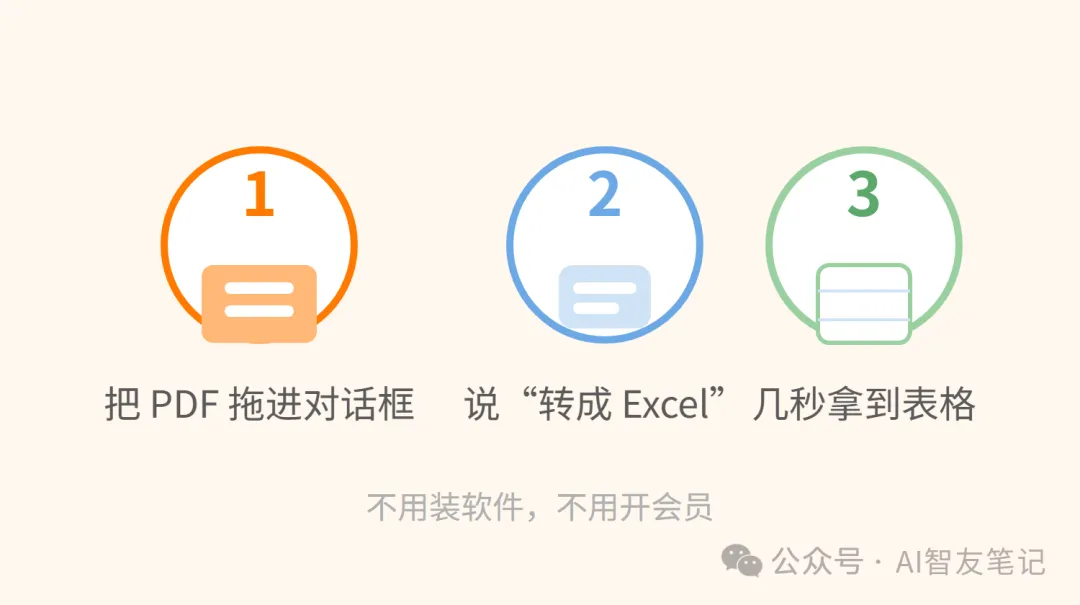
拿一张发票试,十行左右的数据,三秒就吐出一张干净的表。OpenRouter 自己测过,五个 PDF、六百多个格子,读得对的模型一个没漏。普通的表,免费的模型就能跑,不用开会员。不限发票,合同附件、供应商报表、银行流水,只要是带表格的 PDF,一个道理。
AI 也会看走眼
别把转出来的表直接交差。AI 不是神仙,有几个地方它容易栽:括号里写的负数,比如 (3,878),它可能当成正数;一张跨两页的表,它偶尔会接错行;合计行和脚注,也常被它当普通数据读。
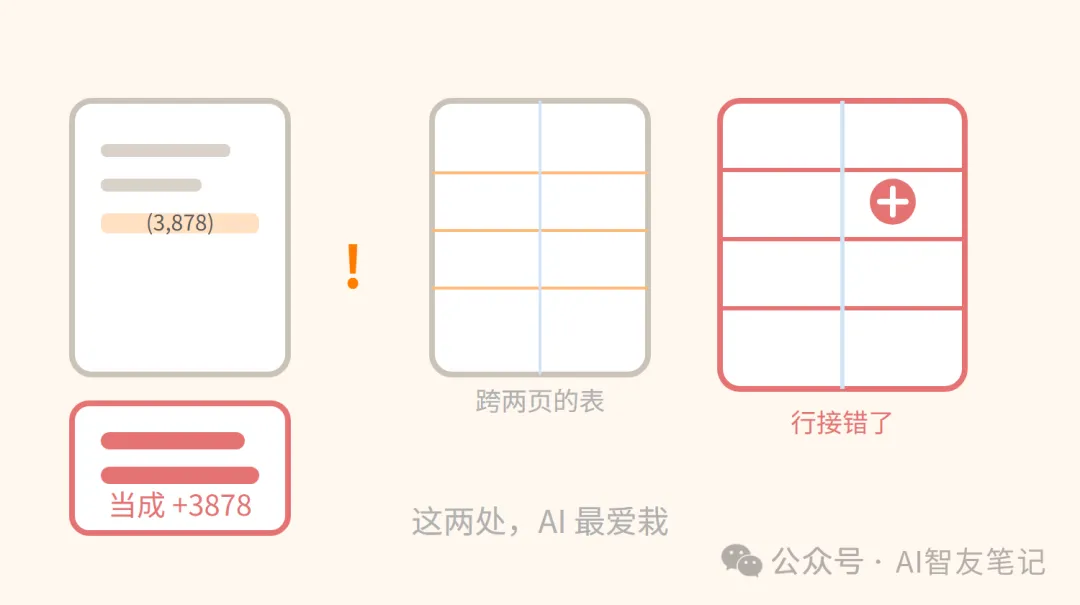
给它下指令时加一句"读不懂就标出来,别猜",比事后纠错省事。转完先扫一眼首尾两行和那个总数,对上了再放心用。
哪些 PDF 它搞不定
干净、文字能直接用鼠标选中的 PDF,它最稳。一份二十页的报表,只要文字层在,它基本不翻车。反过来,纯扫描拍下来的、糊到看不清的、合并单元格乱七八糟的、还有加密打不开的,它就容易翻车。
扫描件要先过"让电脑认字"那关,拍得歪、拍得暗,认出来就乱。我见过一张拍斜的采购单,五行的数它读错两行,所以手边有扫描件,先确认拍清楚了再用 AI。
我自己的做法
我现在每月的对账单,先丢给 AI 出初稿,再花一分钟核对总数。原来手抄要半小时,现在前后五分钟。上次一张十二行的对账单,它把供应商名字漏了半截,还好我核对时一眼看见了。省下来的那二十五分钟,我拿来干别的,比盯着屏幕数格子舒服多了。
你今天就能做一件事:翻出一张手边的发票或者对账单 PDF,丢进豆包或者通义,说"转成 Excel"。三秒看完结果,你就知道这几年白敲了多少。
要是你身边也有个总被表格折磨的同事,把这篇甩给他,比教他装软件管用。(顺手点个"在看",下次算法还能把这类干货推回给你。)
你被 PDF 表格坑过最惨的一次是什么?评论区报个数,我看看到底不是我一个人对着屏幕骂过。