ARTICLE · 1278601
Google Genie 4来了,AI已经能生成可以走进去的世界,但我觉得还不能高兴太早
Google Genie 4来了,AI已经能生成可以走进去的世界,但我觉得还不能高兴太早
以前我们看AI生成视频,最大的感受就是画面越来越真实。 从几秒钟的简单片段,到复杂的镜头运动,再到人物对话、环境音效,AI视频的进步确实很快。 但视频始终存在一个限制。 不管画面多么逼真,观众都只能看。 你不能突然走到人物身后,看看另一边是什么。也不能随手把桌上的东西拿起来,观察周围环境会发生什么变化。 Google DeepMind最新发布的Genie 4,想解决的就是这个问题。 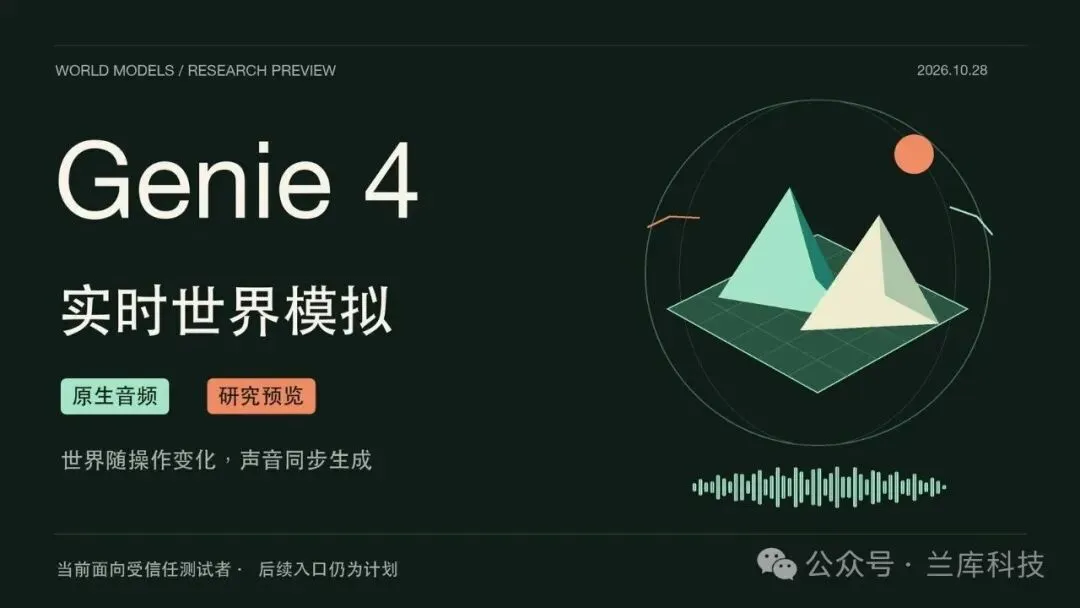
10月27日,Google公布了新一代世界模型Genie 4。按照官方展示,它可以实时生成允许用户控制和探索的虚拟环境,同时支持原生声音、人物对话和动态场景变化。 比如你可以用键盘控制视角,在生成的场景中移动。 也可以通过文字指令,让天气发生变化,或者向场景里添加新的人物和物体。 AI会根据你的输入,继续生成接下来发生的事情。 看到这里,很多人可能会有一种感觉:以后是不是连游戏引擎都不用了,直接告诉AI想玩什么游戏就行? 我觉得这个想法很有吸引力,但现在距离真正实现还有不小的距离。 先说Genie 4到底进步在哪里。 Google在2025年8月发布Genie 3的时候,就已经能够根据文字描述生成实时可探索的环境。 当时官方公布的能力包括720p分辨率、每秒24帧,以及持续几分钟的场景一致性。 所以,能够生成可互动世界,并不是Genie 4第一次实现的能力。 它真正的变化,是进一步提升场景真实感、动态控制能力,以及声音和人物行为之间的配合。 这次Google不只是让你看到一个正在生成的世界,还尝试让其中的人物能对你的行为作出回应。 环境有对应的声音,人物能实时交流,场景还可以随着指令发生变化。 这就和传统AI视频拉开了区别。 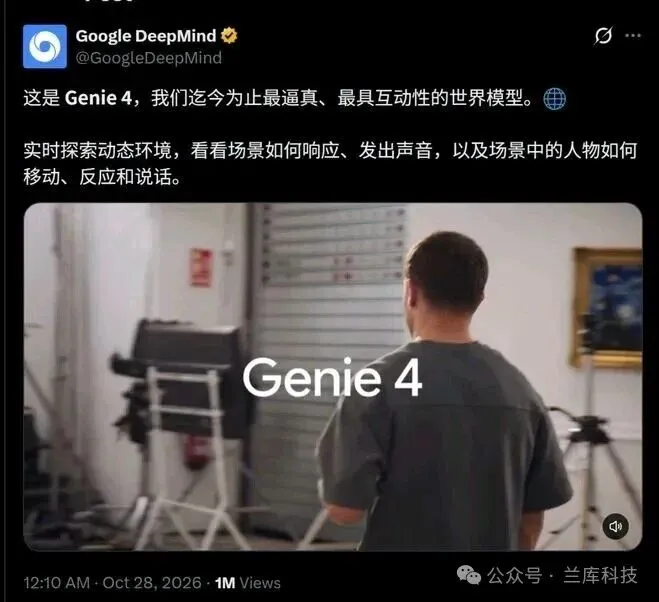
普通视频生成更在意镜头最后看起来像不像真的。 世界模型则需要考虑另一件事:当用户突然改变行为,下一秒究竟应该发生什么? 这件事明显更复杂。 比如一段AI视频里,一个人把杯子放在桌上,模型只需要让这个动作看起来合理。 但在一个可互动世界里,如果用户突然拿走杯子,桌面应该发生什么变化? 如果用户转身离开,再回来看,杯子还在不在原来的位置? 如果杯子被撞翻,液体应该怎样流动? 这些问题看起来都是小事,但它们决定了这个世界到底只是会动的画面,还是具备稳定规则的虚拟环境。 而Google自己也承认,目前Genie 4仍然存在局限。 比如长时间运行之后,场景细节可能发生漂移,物体的持续存在性也不完全可靠。 多次修改指令之后,空间关系和视觉细节可能出现变化。 复杂物理交互、实时音频准确性、文字显示和长期一致性,都还需要继续研究。 所以我认为,目前把Genie 4叫作能够生成互动场景的世界模型是准确的。 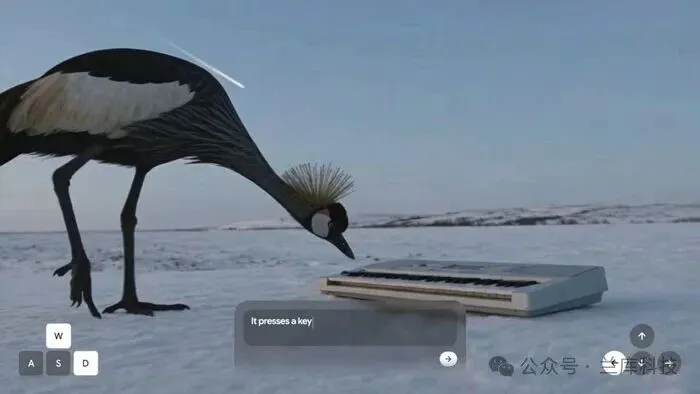
但如果直接说它已经可以替代成熟的游戏引擎,就有点过头了。 传统游戏引擎的价值,从来不只是把画面渲染出来。 它还要维持明确的物体状态、碰撞规则、任务逻辑、角色行为和存档系统。 玩家今天捡到的一件装备,明天重新进入游戏之后还得存在。 一个关卡的物理规则,不能因为玩家多走了几步就突然改变。 而且游戏开发需要可控、可重复的结果。 如果开发者设定某个动作必然触发某个机关,那么这条逻辑就必须稳定工作。 这也是生成式世界模型当前需要面对的问题。 它可以快速产生很丰富的场景,但不代表这些场景背后已经拥有完整、确定的游戏逻辑。 不过,这并不影响我认为Genie 4是一次重要进步。 因为它真正有价值的地方,可能不在于马上替代游戏引擎,而在于大幅降低某些创作工作的试错成本。 过去一个游戏团队想测试某种场景氛围,可能需要先建模、制作素材、安排灯光,再把角色放进去。 如果只是为了验证一个初步想法,这个过程可能会花掉不少时间。 Genie 4提供了另一种方式。 你可以直接描述想要的世界,进入其中观察场景,再根据实际效果修改天气、环境、人物和镜头。 对于概念设计和前期创意验证,这种效率提升很有想象空间。 影视制作也是一样。 导演和美术团队可以提前探索一段场景的空间感,尝试不同镜头和灯光方案,而不是等到后期制作才发现某个设计不好用。 但我认为,这还不是Google真正想做的全部事情。 更值得注意的是,Genie 4与Gemini模型之间的合作。 Google在官方介绍中提到,Gemini 3.8 Flash可以作为实时引导模块,持续观察Genie生成的画面,把目标拆成多个步骤,再根据执行结果调整后续行动。 简单理解,一个模型负责生成世界,另一个模型负责观察、理解和指导行动。 这就比单纯生成视频复杂得多。 而且Google此前已经做过类似研究。 2025年发布的SIMA 2智能体,就被用于测试AI能否理解并操作陌生的虚拟环境。 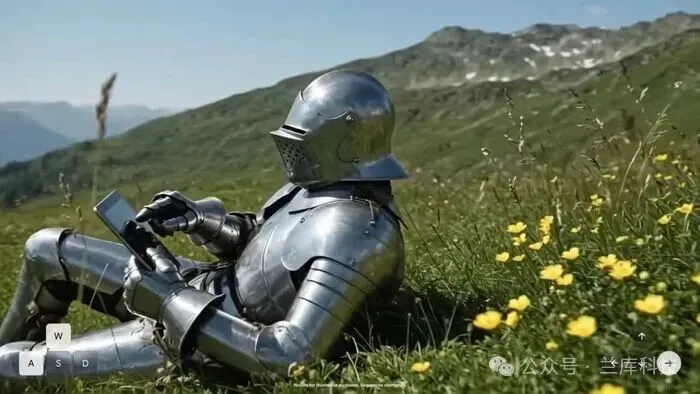
Google还尝试让SIMA 2进入Genie 3生成的世界,根据用户指令完成任务。 把这些研究放在一起看,Genie的发展方向就比较清楚了。 Google不只是想让人类走进一个AI生成的世界,还希望未来能让AI智能体在这样的环境中学习、探索和执行任务。 比如训练机器人。 现实中的机器人训练有很高的成本。 每一次动作都可能涉及设备、场地、人力和安全风险。 如果能先在虚拟环境里生成大量不同场景,让机器人智能体反复尝试,再把其中一部分有效经验带到现实世界,理论上可以降低某些训练和测试成本。 但这里必须强调一个前提。 一个虚拟场景看起来符合物理规律,不代表它真的能够准确模拟现实世界。 机器人训练对碰撞、摩擦、重力、物体形变等细节有严格要求。 如果世界模型模拟出来的结果与现实偏差过大,机器人学到的行为反而可能不可靠。 这也是为什么Google在谈论Genie 4时,仍然把物理准确性和长期一致性列为需要继续解决的问题。 还有一件事不能忽略。 Genie 4目前主要面向受信任的测试者,以研究预览形式开放,并不是所有普通用户现在都能直接使用的成熟产品。 
今年1月,Google曾向美国部分Google AI Ultra订阅用户开放基于Genie 3的Project Genie实验产品,当时的单次生成还存在60秒的限制。 但那个限制属于早期Genie 3产品,不能直接当作Genie 4的最新能力上限。 Google现在已经明确表示,Genie 4接下来会逐步面向相关订阅用户和开发者合作伙伴开放。 所以,现阶段更适合把它看成一项方向明确、进步明显,但仍需要大量实际验证的技术。 我觉得Genie 4最重要的变化,不是AI生成的画面又逼真了多少。 而是AI开始尝试从“按照要求给你一段结果”,走向“根据你的行为持续回应”。 这会改变我们与数字内容交互的方式。 但要让AI真正生成一个可靠、稳定、可以长期存在的世界,光靠漂亮的画面还远远不够。 
未来如果Genie这样的模型能够把生成能力和确定性的物理规则、程序逻辑结合起来,游戏设计、虚拟训练乃至机器人研究,都可能出现新的工作方法。 只是现在,我还不急着宣布游戏引擎要被淘汰。 能够生成一个看起来真实的世界,和让这个世界始终按照可靠的规则运行,是两个不同层次的问题。 Google已经开始解决前一个问题。 后一个问题,恐怕才是真正困难的部分。