ARTICLE · 1278896
DIA-NN 引擎源码考古 · 1.7.12 · 第三回 · 候选排队过堂,证据都在峰里
上一回 《DIA-NN 引擎源码考古 · 1.7.12 · 第二回 · 数据进门先报到,名单出炉再下锅 ~》,咱们刚说到候选名单备齐、分批下锅。那份名单,是候选前体(Precursor)离子清单:一条一条记的是 “某条肽段 + 某个电荷态”;谱库拿去检索的,就是这样一条 Precursor —— 不是蛋白名单,碎片也不会单列出来排队。碎片信息并没有缺席:每个 Precursor 在检索时都会拿到一张理论碎片表 —— 从谱库来的随库带,从 FASTA 炼的到检索时才按电荷态现生成;碎片 m/z、强度、离子类型都在里头,清单仍按 Precursor 排队。有谱库的照谱库递,没谱库的从 FASTA 里炼。
名单正式递进了数据里。可讲到这儿,事儿才办了一半:它只告诉引擎 “该找谁”,至于 “在哪儿找、拿什么认”,还没人管。这一回咱们就接着往下说,看看引擎怎么在成千上万张扫描里,把某一条候选的证据一点点抠出来,再逐个峰打分,看哪一个得分最高。
从这份 Precursor 清单到峰里的证据,源码上是一条笔直的调用链。先给候选找位置(build_index()),再把谱图里的强度取成曲线(chromatogram()),然后从曲线里认出峰(peaks()),接着给每个峰填一堆特征(score()、score_RT()),最后由 seek() 挑出分数最高的那个峰。这几道工序,就是本篇要拆的全部内容。
本篇范围
这一篇只讲上面那条链 —— 从找位置走到选峰。权重怎么学、q 值怎么算、校准怎么一轮轮迭代、定量怎么出,都不在这条链上,留给后续文章。
检索台:先弄清这条候选该去哪几张扫描里露面
一条 Precursor 进了数据,第一步不是打分,而是找位置。Precursor::search()(L7774–L7785)第一次跑起来时,先调 build_index()(L7101–L7118)。这个函数只干两件事:把 “该看的扫描” 挑出来,再定一个扫描半径。
挑出该看的扫描
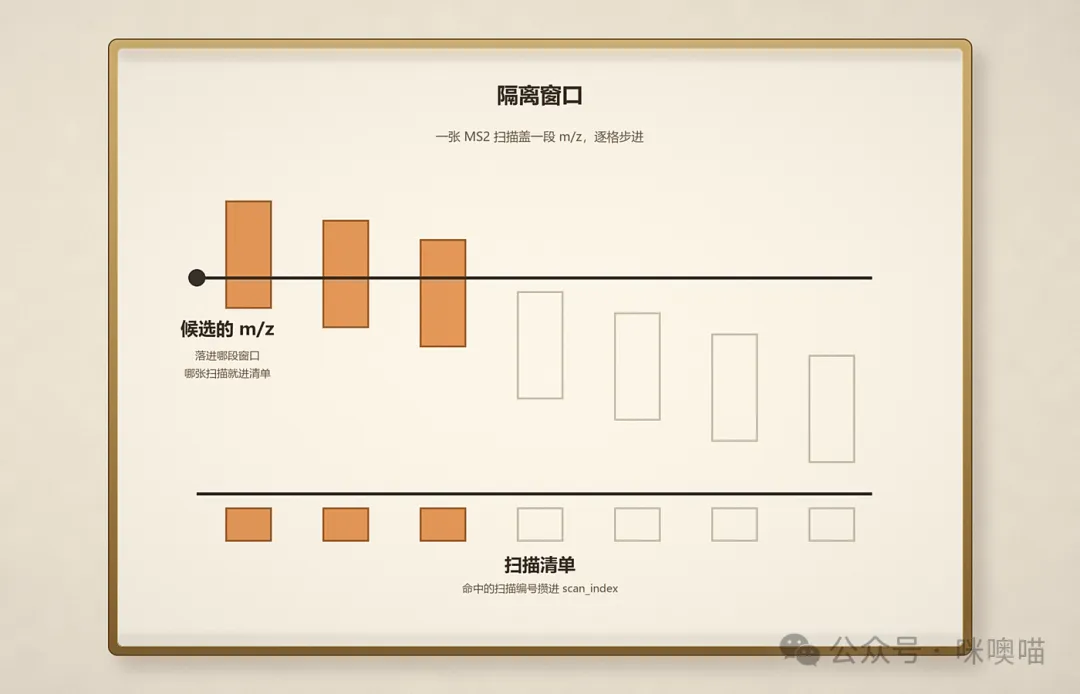
要挑扫描,先得知道一张 MS2 扫描覆盖的是什么。这一步的前提,是分析对象为 DIA(数据非依赖性采集)数据 —— 这也是 DIA-NN 主要面对的数据类型。DIA 的每个采集周期,通常先采一张 MS1 全谱,再把 m/z 范围切成若干隔离窗口,逐窗口采集 MS2;窗口依次步进,走完整个范围,再进入下一个周期。同一窗口里的多条 Precursor 会一起碎裂、一起进同一张 MS2 谱,所以一张扫描并不专属于某条 Precursor,而是覆盖一段 m/z。
所以检索一开始要回答的,就是这条候选的证据可能落在哪几张扫描里。每张 MS2 扫描覆盖的那一段 m/z,就是它在采集方法里对应的隔离窗口 —— 由前级四极杆在采集这张 MS2 之前选定,跟 MS1 全谱那对字段不是一回事。候选的 m/z 落在这段范围内,这张扫描里才有可能出现它的碎片;落在范围外,说明这张扫描根本没采过它那段质量区间,后面提曲线、找峰全是空转。
对得上才收,对不上的不进这份清单。窗口的上下界记在每张 MS2 扫描自己的 window_low 与 window_high 两个字段里(Scan 结构,L2598–2601),命中的扫描编号写进 scan_index(L7109–L7111)。判断的就是一件事:候选的 m/z 有没有落在这条上下界之间 —— has(mz) 里写成 window_low <= mz && window_high > mz,左闭右开,落在窗口内返回真(L2609)。
这两个字段在读数时就填好了。Bruker timsTOF 的窗口不随谱图直接给出,要按采集方法表里每个窗口的中心与宽度现算,上下界=IsolationMz ± IsolationWidth / 2(L8700–L8708);其余格式的谱图本身就带着窗口上下限,直接读进来(L8593)。
采集方法的窗口设计允许相邻窗口略有交叠。交叠不会让候选被两张扫描都收走:读数刚一收尾,引擎就把交叠区对半切开 —— 两窗的分界挪到交叠区中点,交叠区里的候选只归进其中一张(L8496–L8500)。若候选的 m/z 落在所有窗口之外,清单直接为空,这一轮就没有峰可找(L7109–L7111、L7441)。
这里比对的 m/z 是校正后的
上面比对的 m/z 不一定是谱库原值:隔离窗口的中心由仪器标定,与谱库、FASTA 里的理论 m/z 可能差着系统偏移;窗口越窄,这点偏移越容易把候选推到隔壁窗口。DIA-NN 因此留了条校正通道:从高置信度鉴定里量出每条 Precursor 沿 Q1 轴(窗口中心那条轴)的偏移,去掉首尾各 20% 取均值,当常数补进 m/z(
q1_delta()L6754、L9802 起)。它默认不走:只有运行被认作 Scanning SWATH(一种 DIA 采集方式)、且显式加--q1-cal才学(L2140、L10243),首轮也没样本。还有限制:偏移得小于候选到 MS2 采集范围边界距离的一半才补(L7105),免得边界候选出范围。
把校正量算进去,扫描照上面的规则挑,命中的编号攒成清单 —— build_index() 的第一件事到此办完。
定一个扫描半径
可这份清单只圈定了候选可能露面的扫描,没规定要以它为中心、往两侧各看几张。而要判断几条碎片是不是一起起落,光有一张扫描不够,得看它前后一段。
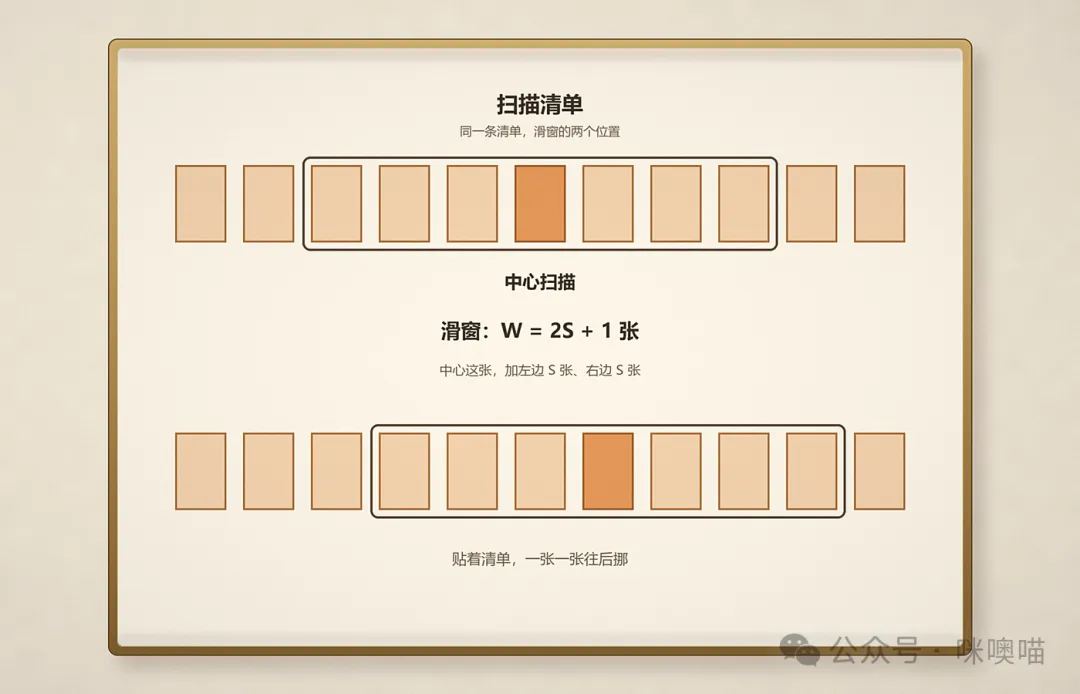
往两侧各看几张,就是半径 S。数的不是时间轴上挨着的扫描,而是这条候选清单里、真正命中它 m/z 的那些 MS2 谱图 —— 对做实验的人来说,差不多就是前后各看几个采集周期。
仪器一个周期把全部隔离窗口扫一遍,候选的 m/z 通常只落进其中一张,所以这份清单大致是每个周期一张、按时间排下来。滑窗以其中一张为中心,左边 S 张、右边 S 张,连中心这张算上,一次盖住 W = 2S + 1 张(L7144);后面找峰,就贴着清单一张一张往后挪。S 量的是往两边伸多长,W 量的是这一窗一次盖住多少张 —— 前者是半径,后者是总宽,两个不是一个数。
滑窗要从头挪到尾,清单首尾就凑不齐邻域 —— 各 S + 1 张直接不评峰(L7441)。
这个半径的数值从哪儿来?引擎有三条来路(L7114–L7116)。WindowRadius 不为 0,就直接用它;否则,若已经估出峰宽 PeakWidth(单位同样是清单里的谱图张数,且大于一个极小值 E),用 ScanScale × PeakWidth(ScanScale = 2.2,L148),结果至少取 1;两样都没有,就拿清单里的谱图张数 k 除以 ScanFactor(默认 150,L146),同样至少取 1。越往后,越依赖这份数据自己的统计。
半径估得准不准,直接决定滑窗的宽窄。洗脱峰一般要跨好几个采集周期,半径太小,峰的两翼被切在窗口外,几条碎片曲线的相关起不来;半径太大,每条候选都要在更宽的窗口里逐位算相关,算力和内存一起涨。所以引擎宁可在第一轮先粗估,等校准有了数据再收紧。
这个自动推断,在界面上也有个入口 —— 主界面下方 “Algorithm” 分组里的 “Scan window” 数字框。控件出厂值是 0,上限 1000(Form1.Designer.cs L197–208);悬停提示的原话是 “Radius (in scans) of the retention time window that is used to scan extracted chromatograms of precursor ions”,并说明这个参数是用来覆盖自动推断的(Form1.resx L123–125)。界面叫 “Scan window”,代码里叫 WindowRadius,差得远,量的却是同一件事:按时间数扫描,不按质荷比切。
它怎么传到引擎,也简单:填了大于 0 的数,才拼出 --window(Form1.cs L410);留 0 就什么都不传,交给引擎自己估。所以那个 0 不是 “没有半径”,而是 “第一轮先让引擎推断”。估出来的值,要等校准跑完、并决定重算扫描窗口时,才由 update() 定为全体共用值(这是默认情形),同时把 InferWindow 置成 false(L9763–L9769),下一轮直接照用。
勾上 “Unrelated runs” 就换一套算法:它下发 --individual-mass-acc --individual-windows(Form1.cs L417),那个统一值不再套给全体(L9769)—— WindowRadius 留 0,每条候选改按自己所属数据文件的峰宽现推(L7115),每个文件各有一套半径。
小编注:这个勾选框其实是两件事捆在一起。除了上面这半(窗口按文件单独算),它还同时管着质量精度 —— 也改成每个 run 各自确定(L2054)。那半要等校准跑起来才看得出效果,留到后续文章再讲。
提色谱:把碎片强度按扫描取成曲线
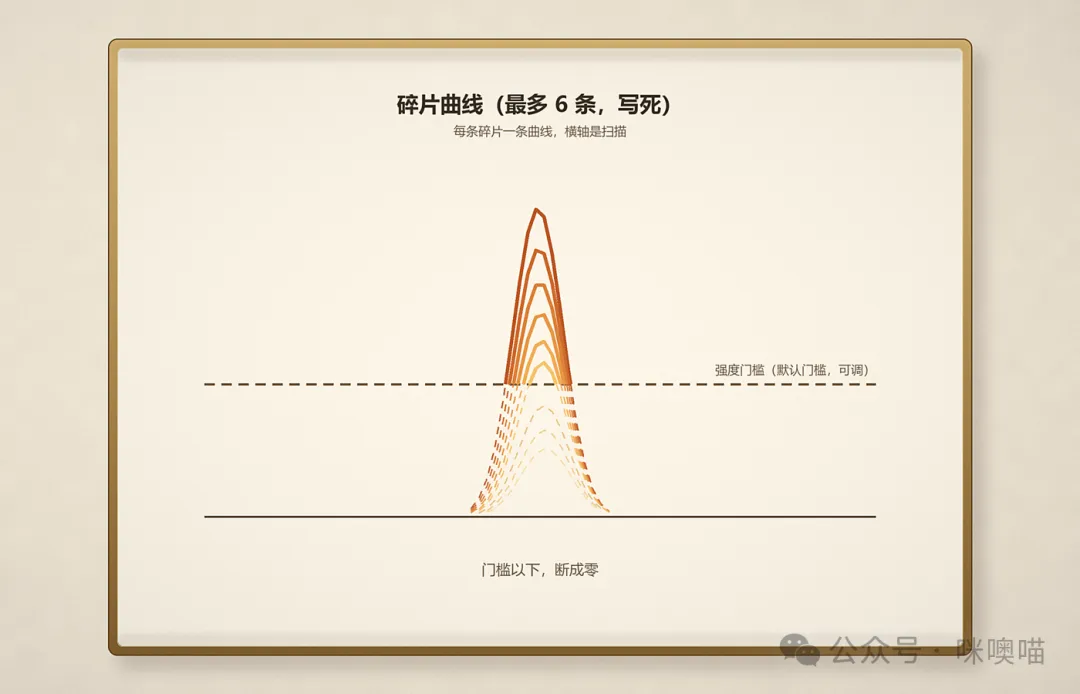
扫描范围定好,下一步是把谱图里的强度取出来。chromatogram()(L7163–L7213)干的就是这活:对 scan_index 里的每一张扫描,按理论碎片的预测 m/z 去谱图里取强度,一个碎片一条曲线。取到的值填进 run->MS2 的一格(L7206–L7211)—— 一个碎片一行、一张扫描一格。曲线的横轴是扫描(也就是时间),纵轴是强度 —— 一条曲线,就是这张碎片在整段时间里的强度起伏。
所谓理论碎片,说的是 “这条肽段该在哪些 m/z 上出碎片”:从谱库来的那份直接带一张库里的碎片表,从 FASTA 炼的则按序列和电荷态现生成。两种来源记的都是理论值,不是本次仪器测到的峰;引擎拿这些值去谱图里对号,对上了就把强度记进账。这道工序拆开,是三件事。
挑出该取的碎片
取强度之前,碎片表先被筛过一遍。这一步在 Searcher 构造时就做完了,还没轮到 chromatogram():只有 m/z 落在 MS2 采集范围(tandem_min 到 tandem_max)之内的碎片才留下(L7154–L7158);留下来的不足 MinSearchFrNum = 3 条(L323),整张表直接清空(L7159),m 归零,chromatogram() 一进门就返回(L7164)。换句话说,3 是 “少于几条就别玩”,6 是 “最多取几条”,一个管门槛,一个管上限。
只取前 TopF = 6 条碎片(L776)。这个 “前” 是有序的:碎片表在 Entry::init() 里就按强度从高到低排好(L3571–L3573),chromatogram() 直接从排头往下取(L7206),所以拿到的是筛完之后强度最高的 6 条,不按 m/z 顺序,也不按离子类型挑。谱库那半的强度取自库里的参考谱,FASTA 那半是按序列预测的,两者随后都按各自最大值归一到 1(L3577–L3583);归一除以的是同一个常数,不改排序。
TopF 本身是 const,没有命令行参数,GUI 也没有旋钮 —— 它是写死的,不是可改的默认值。另一个参数 --max-fr 只能把碎片表截得更短(截断就发生在排序之后,保留最强的那几条,L3574–L3575),它抬不高 6 这条上限(L2031、L775)。所以每条候选在这里最多只留 6 条碎片曲线。
定哪些采样算数
曲线取好了,还得定下门槛。先看强度这道门:MinPeakHeight = 0.01(L154),低于这个值的采样一律记 0(L7210)。这个 0.01 比的是强度原值 —— 读数时 height 直接取自谱图里的 intensity(L8595),整条链路没有按基峰缩放的步骤,所以它是绝对阈值,不是 “基峰的百分之几”。
对仪器厂商直出的原始数据、以及 mzML 这类转换格式,强度通常以离子计数计,动辄成千上万,0.01 实际上只是一条 “有没有信号” 的地板线:该 m/z 上没有峰时 level() 本就返回 0,微弱到接近零的采样也被压成同一个 0,后面算相关时拿到的就是一条干净的、带零的曲线。只有当输入强度本身已经归一化(比如按基峰百分比导出)时,0.01 才相当于基峰的 1%。这个值是默认值,可以用 --min-peak 改(L1837),GUI 没有单独项。
RT 窗口在这道工序里才第一次露面。前面挑扫描只问 “隔离窗口含不含这个 m/z”,不问时间;到了 chromatogram(),如果 RT_windowed_search 为真,引擎会按预测 RT 加减 RT_window 算出一个区间(L7179–L7181),再拿它裁剪采样:区间外的扫描不取值,格里留 0(L7201–L7204)。这里的 “预测 RT” 不是谁现猜的:校准把每条肽换算到这张 run 的时间刻度上,它就是 “这条肽该出峰” 的位置 —— 换算用的刻度是库里带的还是算出来的,后续文章再讲。判断时留了 W 的缓冲 —— 比的是 k ± W 那张扫描的 RT,免得刚好卡在边界上的采样被切掉。
这个 RT_window 没有 GUI 旋钮,它由校准算出来(L9751)。偏差项把实测与预测 RT 之差取绝对值、反号排序,取 20% 位置那个值再乘 −2 取正 —— 用偏差的话说,就是拿偏差里偏大的那批(约 80% 分位)放大 2 倍,宁可宽一点也不切掉真峰(L9744–L9751;RTWindowLoss = 0.20、RTWindowMargin = 2.0,L185–L186);跨度项取 1%/99% 分位之间的 RT 跨度,除以 40(RTWindowFactor,L184)。两者取较大值,就是窗口半宽。
算出来不等于用上:要攒够 100 条高置信度鉴定(RTWinSearchMinCal,L189)才真正启用 RT 窗口搜索(L9752),参考 run 的门槛低些,10 条就够。总开关是 --no-rt-window(L2048),最小宽度还能用 --min-rt-win 调整(L2050)。
所以,GUI 的 “Scan window” 管 “捞多宽”,引擎的 RT 窗口管 “算不算数”,两件事各管一头。前者是半径,后者是硬门槛;前者能在界面上填,后者由校准算,命令行只能调最小宽度或直接关掉。
给母离子也记一条曲线
碎片之外,chromatogram() 还要给前体自己取一条曲线。这一条记的是母离子在 MS1 全谱里的强度:每张 MS2 扫描按自己的 RT 找到前后两张 MS1,用前体的 m/z 各取一次强度,再按时间线性插值(L7188–L7197)。开关是硬编码的全局开关 MS1PeakSelection = true(L232),没有命令行参数、没有界面项,全工程无处改写,只要数据里有 MS1 谱就默认取;曲线单独存进 run->MS1(L7172–L7176),跟碎片矩阵分开记。取值发生在 RT 窗口判断之前:RT 窗口前侧裁掉的采样,MS1 格里也已经有值;窗口后侧整段截断的采样,两边才一起留 0(L7187–L7204)。
这条曲线后面有两处用处:找峰时,它跟最佳碎片曲线做一次相关,直接加进相关和(L7489–L7493);打分时,它进 pMs1TimeCorr 等几维(L7686–L7693),峰顶那张的强度还要拿去算 MS1 与 MS2 的信号比(L7612)。这里只取一个通道,峰找出来之后,extra_chromatogram() 才在峰附近补上紧质量窗口和同位素,凑成 9 个通道(L7286–L7287)。顺带一句:ForceMs1 是写死的 false(L231),全工程没有入口能打开它,所以 “MS1 里没峰就不记这次采样” 那条分支(L7196)在 1.7.12 里走不到。
找峰:几条碎片一起起落,才算一个峰
曲线取完,接下来认峰。认峰这件事拆开,是两件事:先认出候选峰、排出谁先试,再逐条过门、定去留。
认出候选峰,排出谁先试
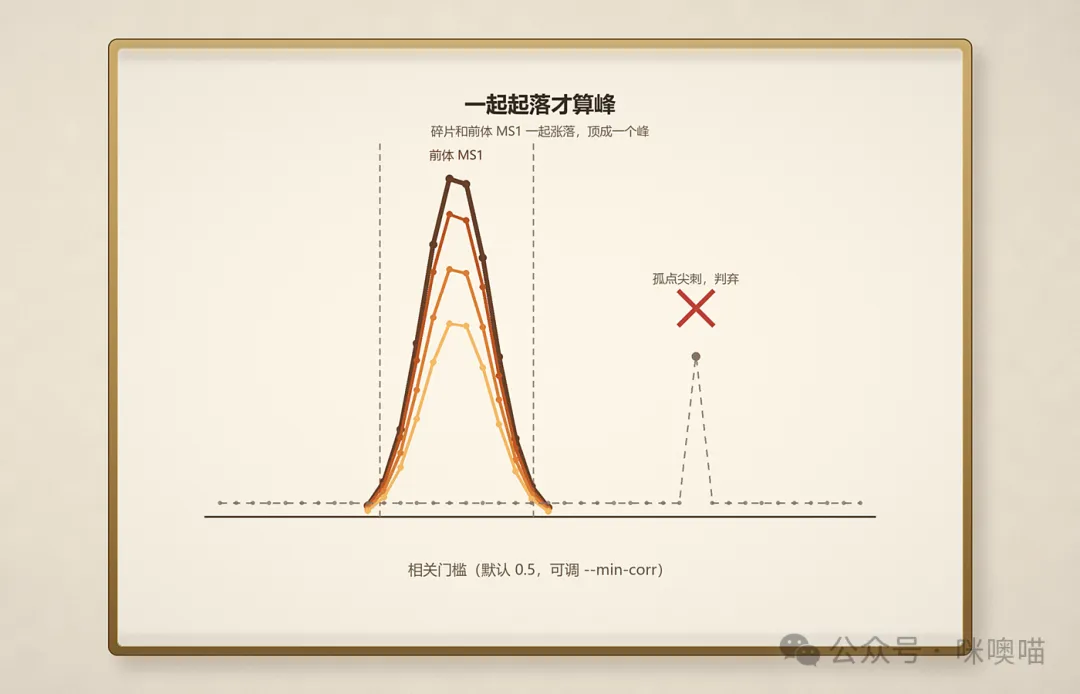
peaks()(L7423 起)的思路很朴素:真正的肽段洗脱,应该是几条碎片曲线一起涨、一起落;如果只有一条碎片在冒尖,那更像噪声。所以它判峰的核心不是 “哪条曲线最高”,而是 “几条曲线像不像”。
这里说的相关,不是 “像不像参考谱”,而是 “像不像彼此”。两条曲线同升同降,相关就接近 1;一条先升后降、另一条反着来,相关就低。拿这个量判共洗脱,比盯单点强度稳得多。
滑窗从 from + S + 1 扫到 to - S - 1(不含右端,L7441),首尾各留出 S + 1 张不评峰,保证任何一个窗口都完整。每个位置上先数碎片:当前这张扫描强度达到 MinPeakHeight 的算一条,当前没有、但左右邻扫描有信号的也算一条(L7444–L7454)。
当前这张加左右邻三张里,至少要有两条碎片冒过门槛,而且当前这张扫描上不能一条都没有(L7454)—— 这就是 “至少 2 条碎片才成峰” 的出处。换句话说,中心那张扫描不能是空的:峰顶总要落在某张扫描上。
只有两条碎片冒信号时最省事:直接算这两条曲线的相关,相关得大于 0,否则这个位置直接作废;冒信号的有三条以上,就攒一张相关矩阵 —— 碎片两两之间的相关都算上(最多 6 条全在内),每条把跟其他各条的相关加成一个和,和不大于 0 的不入列,剩下的按和从大到小排,按这个顺序往下试(L7457–L7482)。排好这个序,等于先拿 “跟大伙最合拍” 的那条碎片开刀;它成了,峰就定了,它不成,再换下一条(L7485–L7528)。这也是为什么 best_fragment 往往就是那条最合拍的碎片。
过完门,定去留
轮到某条碎片试的时候,要过几道门:相关和不到 MinCorrScore = 0.5(L228、L7494)不要。这里说的相关和,除了碎片之间的相关,还含那条前体自己的 MS1 曲线 —— 它跟当前正试的那条碎片曲线做一次相关,直接加到和里(L7489–L7493)。MinMs1Corr 只是这条相关的门槛,默认负无穷(L229、L7491),等于不拦;但不拦不等于不算:这一分直接算进 0.5 那道门的合计,也写进最后记账的相关和 —— 后面留峰划区间,用的就是这个和。不过试谁先谁后,还是按碎片之间那部分排的序,MS1 这一分不改序。过了门还要平滑曲线,峰顶强度得达到 MinPeakHeight(L7496–L7498)。原始曲线难免带毛刺,先平滑再判,免得一个单点噪声把峰顶的位置带偏。
然后是 Apex(峰顶)检查。引擎先要求当前位置差不多就是局部最高点:以它为中心、左右各 S / 3 张(整数除法,至少 1 张)的范围里不能有更高的(L7501–L7507);再要求它的强度至少是 ±(S−1) 范围内最高值的 PeakApexEvidence = 0.99(L227、L7509–L7515)。说白了,不要求峰顶绝对最高,但不能比附近最高点矮太多。
峰不只留一个。凡是相关和不低于 “最高分 − MaxCorrDiff(2.0)” 的峰都留下(L230、L7538–L7542),各自带着自己的 apex(真实扫描号)和 best_fragment(试峰时领头、最终过了全部门的那条碎片,L7486、L7525)进入打分。
为什么不全留,也不只留一个?全留,打分是白算;只留一个,万一分最高的那个是干扰,后面连备选都没有。留一个 “贴着最高分” 的区间,既控住数量,又给后续判定留余地。
注意一个峰记了两个坐标:peak 是它在清单里的位置,也就是滑窗中心那张的下标;apex 是同一位置对应的真实扫描号(L7543–L7544)。后面取 MS1、取同位素,都按真实扫描号去查 —— 两个坐标错一位,后面全错。
这几个门槛都有命令行参数(--min-corr L2122、--min-ms1-corr L2124、--corr-diff L2126、--peak-apex L2128),GUI 都没有单独的旋钮。但 GUI 里有一个勾选框会顺手改其中两个 —— 见下面这条注。
小编注:上面说的这个勾选框,在 GUI 里管的是内存,名字叫 “Reduce memory usage (for very large databases)”,可它顺手改的就是上面那两道找峰的门 —— 下发
--min-corr 1.0 --corr-diff 1.0(Form1.csL341),一道把 0.5 抬到 1.0,一道把留峰容差从 2.0 收到 1.0。门槛一紧,留下的峰自然少,内存也就下来了。悬停提示把代价也摆在明处:鉴定数可能略降(Form1.Designer.csL688–L689)。
打分:一百来维证据,折成一个总分
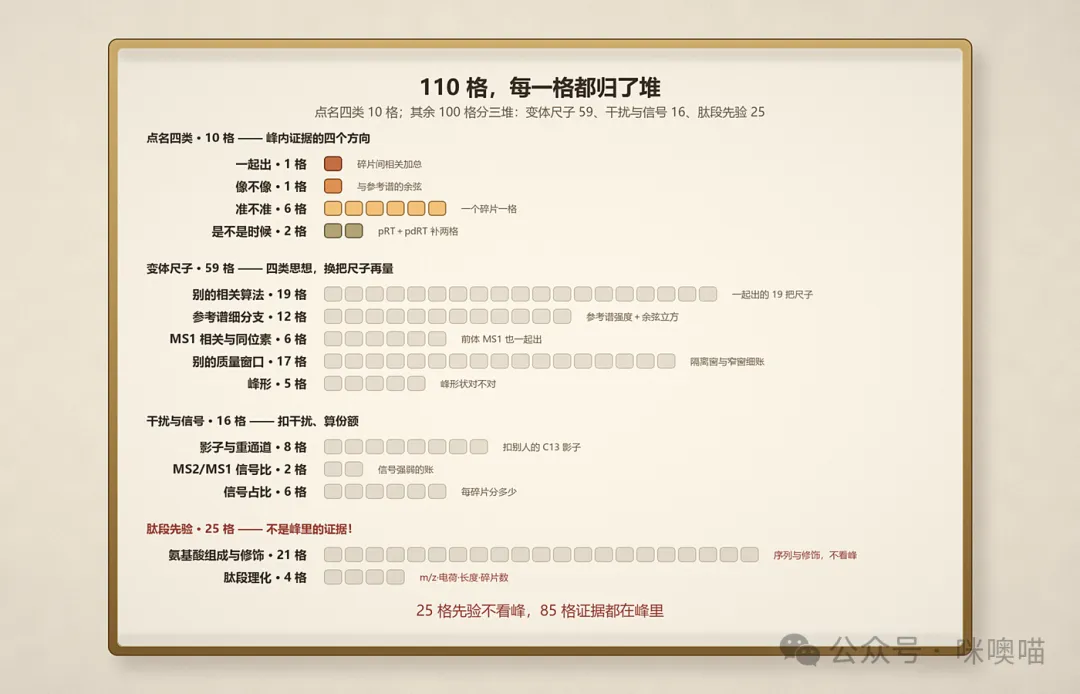
峰找出来,最后一道工序是打分。为什么要打分?找峰留下的是一摞候选峰,哪个是真、哪个是干扰,得有个可比的数字才好下判 —— 同一候选里选峰靠它,所有候选排到一条队上比可信度也靠它。所以这道工序干的其实是特征数值化:峰的证据逐项变成数字,一项占一格,一个峰填出一条 pN 维的特征 —— 这就是喂给分类器的特征矩阵的一行 —— 再由权重把这一行折成一个总分。score()(L7550)管的就是填特征这一步:一进门先把这条峰的特征数组整体清零(L7560、L7568),再按组往里填。填多少格由 pN 决定 —— 1.7.12 编译出来的版本里,pN = 110。
清零这一步不是形式主义。特征数组是按峰分配的,一个峰一段,互不覆盖(L7560);清零保证每一位都有定义 —— 没填到的维就是 0,不会残留上一轮的数值。
110 这个数不是拍脑袋来的。顶部四个常数先定死:TopF = 6、auxF = 12、nnW = 5、qL = 3(L776–L778)。然后枚举表一格格往下排:氨基酸组成占 20 格,pRT = pAAs + 20 = 48;质量偏差占 6 格,pRef = pAcc + TopF = 55;参考强度占 11 格;信号占比占 6 格,两组相关分别占 12、6 格;峰形占 5 格;Q1 那五组各 3 格,共 15 格 —— 最后 pN = pQCorr + qL = 110(L780–L809)。这个数是编译期定死的:Q1 那段在 #if Q1 条件编译下,宏在 1.7.12 源码里写死为 true(L355),改宏重编才走另一支 pN = pShape + nnW = 95(L809)。
这些常数全是写死的,没有一个是 GUI 旋钮。所以 “110 维” 不是可调项,而是这一版引擎的固定账本。
小编碎碎念:110 维铺开,第一眼确实唬人。可它更像一张体检表 —— 指标列了一长串,真下结论时,说话的往往就那么几项。
为什么要铺这么多格?因为分类器不是靠一条规则拍板,而是把很多条弱证据放在一起看。维数多,是为了让不同情况都有对应的证据位;至于每一位值多少钱,由权重决定,不由维数决定。这份账要讲清,是两件事:哪些证据最能说明问题,以及全部证据怎么折成一个总分。
点名四类证据
点名这四类,标准也简单:一句话能说清、彼此不重叠、刚好覆盖 “峰里有什么证据” 的四个方向 —— 一起出、像不像、准不准、是不是时候。
110 格真要在正文里逐格报菜名,各位观众老爷会当场睡着,小编也会。挑这四类最有话说的,逐个过:
第一类是共洗脱。pTimeCorr 以找峰时定下的 best_fragment(领头那条碎片曲线)作主曲线,跟每条碎片曲线做相关,再把相关加起来(L7629–L7638)。几条碎片一起起落的峰,这一项就高 —— 它回答的是 “这些碎片是不是同一件事”。
第二类是与参考谱的相似度。pCos 在窗口内逐点算强度向量与参考谱的余弦,再按洗脱强度的平方加权平均(L7615–L7627)。余弦只看方向、不看绝对高低,所以峰整体强一点弱一点,不影响这一项;加权平均则让峰顶附近的点说话更响。它回答的是 “峰里的强度配比,像不像名单里那条 Precursor 该有的样子”。
第三类是质量准不准。pAcc 一个碎片一格:实测 m/z 与预测 m/z 的偏差,先按质量精度归一,再乘上这条碎片的共洗脱相关(L7649–7651)。偏差越小、曲线越像,这一格越高。这里取的是 Apex 那张扫描的实测 m/z(L7650),不是整个峰的平均 —— 峰顶的质量精度,最能代表这次检测。
第四类是出峰时间。score_RT()(L7742–L7758)补两格:pRT 是预测 RT 在整段 RT 跨度里的相对位置,pdRT 是实测与预测之差按这段跨度归一后的平方根(L7756–L7757)。pRT 以 0 到 1 为刻度,这条肽该出峰的位置偏早还是偏晚,一眼能看出来;pdRT 取平方根,是把偏差压到一个温和的尺度上。它回答的是 “这个峰出得是不是时候”。
折成一个总分
剩下的一百来格,是同类证据的细分支:别的相关算法、别的质量窗口、同位素、峰形、氨基酸组成……正文不逐格展开,知道 “证据不止这四类” 就够了。
这里还要补一句 extra_chromatogram()(L7267 起)。它在峰找到之后才动手,只在峰附近补料:MS1 的九个通道(含同位素)、宽松质量窗口下的 Shadow/NF 强度、紧质量窗口的强度(L7280–L7296),RT 窗口的判断跟 chromatogram() 一个口径(L7307–L7311)。这些料最后都会变成特征,但不进正文的账。
特征填完,怎么变成一个分数?cscore(L6709–L6712)把特征向量跟当前权重做点积,取哪些维由 par_seek 决定。注意这一步不在 score() 里,而在选峰的 seek() 里(L8136)—— 特征是一份 “证据清单”,权重是 “每类证据值多少钱”,点积就是把清单换算成一个总分。
所谓点积,就是逐格相乘再相加:某个峰在某一维上证据强,乘上正权重就加分;权重若为负,证据强反而扣分。
为什么要压成一个数?110 维并排放着比不了高下 —— 这一维加分、那一维减分,得有个统一的算法说了算。分开记账、统一折算,正是这套打分设计的关节:分开记,每类证据各占各的格,谁在加分、谁在拖后腿一目了然,权重也能一维一维地学;统一折,才得到一个能排队、能选优的数 —— 哪个峰更像真峰,全凭它说话。
seek()(L8123–L8165)逐峰算分,分高者当 best_peak。选出来之后回填几样东西:best_fragment、apex、RT,还有 evidence(L8145–L8159)。evidence 直接取 pTimeCorr(L8159),也就是拿 “共洗脱相关” 当这个候选的证据强度,先记在结果上。
有一个边界值得单说:RT 窗口的硬检查写在 “分数更高” 这个分支里面(L8145–L8146)。也就是说,只有某个峰有可能刷新最优时,才去查它有没有超出 RT 窗口;分本来就不高的峰,连查窗口这一步都省了。这是省算力的写法,不是漏判。
顺带留一个引子。search() 的前半段受一个 fInit 标记保护(L7775–L7783):第一次进入时,挖峰、填 110 维特征,只做一遍;之后再调 search(),峰不再重挖,特征不再重填,只有 score_RT() 每次重算(L7784)。权重更新以后,也不必把 110 维重算一遍 —— seek() 里用新权重对缓存的特征重新做一次点积就行(L8136)。换句话说,峰是 “一次性挖好” 的,权重的多轮迭代改的只是 “怎么给这些证据定价”。这套缓存怎么支撑一轮轮的训练与校准,等后续文章讲到权重时再展开。
写在后面
到这里,一个候选在一轮检索里的路径就走完了:找位置、取曲线、认峰、打分、选峰。这几道工序里,量最大的是第二道和第三道 —— 每条候选、每张扫描、每条碎片都要对一遍;打分则是一串向量运算,量小得多。这也解释了前面设那么多门槛的用意:先把不可能的候选、不成形的峰挡在外面,后面的账才算得动。
考古挖到这一段,最有意思的不是某个公式,而是几处 “看着不起眼、实际卡着全局” 的小设计:
• 一个半径,定的是往两边看多远 —— 看窄了,峰的两翼被切在窗口外,几条曲线的相关就起不来;看宽了,又费算力。 • 一条资格线,定的是证据够不够格进场 —— 碎片太少,凑不出互相印证的证据,这样的候选连比都不用比。 • 一个容忍度,定的是峰顶能矮多少 —— 不要求峰顶绝对最高,但比邻居矮一截,就不配叫峰顶。
这些单个拎出来都不复杂,凑在一起,才撑得起后面那套打分。对原始数据分析来说,这不算新道理 —— 先把规矩定清楚,后面比出来的高下才作数。
可这套账要立得住,还缺着最关键的一笔 —— 每类证据到底值多少钱?这笔 “价钱”(就是前面提过好几回的那套权重)不是谁拍脑袋定的,是引擎从数据里学出来的;学得好不好,还要换算成可信度(q 值)来检验,一轮不满意,就再校准一轮。好在证据只用挖一遍(打分那节说过),后面反复调的只是 “怎么定价”。这套价钱怎么学、q 值怎么算、校准怎么一轮轮转起来,咱们后续接着聊。
如果这篇对各位观众老爷有用,请伸出您尊贵的小手点个赞,小编也有更多的动力接着往下写 ~