ARTICLE · 1284247
硬件小白跟着 Codex 做 AI 语音助手:喊一声唤醒,让它聊天、拍照(下)
上集结束时,我已经可以按一下ESP32开发板上的按钮,对它说话,再从屏幕和喇叭收到 AI 的回答。
但每次都得伸手按一下,总觉得还差点意思。
这次,我把上集留的两个尾巴补上了:叫它的名字就能开始说话;让它拍照,就能把眼前的东西发给 AI 看。
实际操作是这样的:
我说:“小李。”
设备响起提示音。
我接着说:“拍照。”
摄像头拍下一张照片,传到 HereToo 的同一段对话。随后,屏幕出现回复,喇叭把对物品的描述读出来。
普通聊天也一样。提示音后说一句话,它就会回答,不需要再按 BOOT。
这两条流程都已经在我这套设备上实测成功。 播报结束后,再喊“小李”,也能接着发起下一轮。
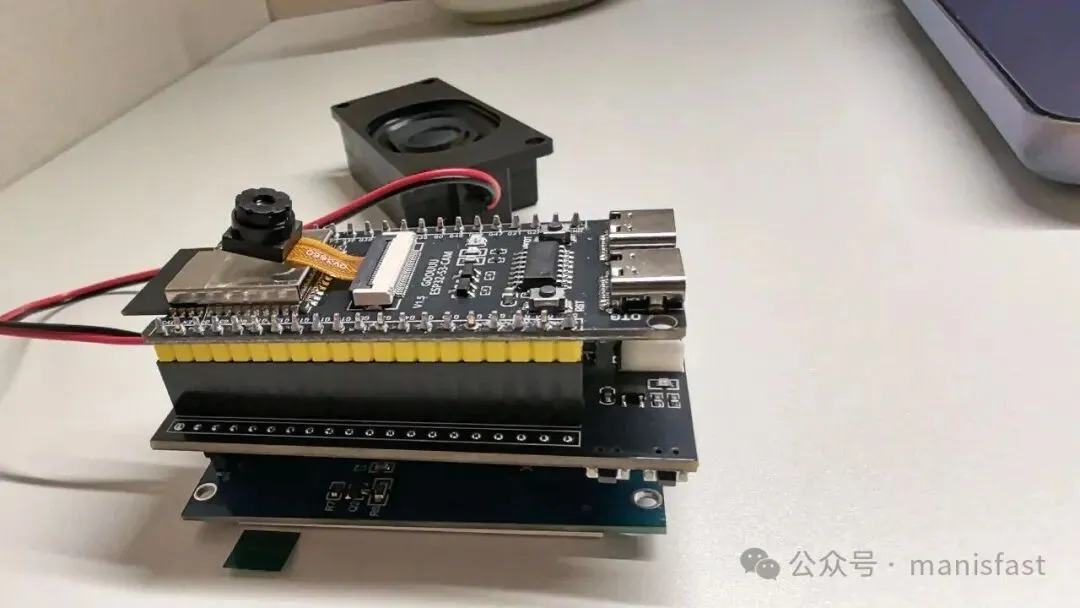
沿用上集的实物组装照片:摄像头主板、扩展板、屏幕和喇叭。这次没有换硬件,主要改固件。
我接入的是自己在做的 HereToo——“卡住的时候,陪你开始”的 AI 行动伙伴。你也可以接自己的 AI 应用,或者让 Codex 单独搭一个小助手后端。下面会把接口要求写清楚。
先把话说明白,这篇做到哪算完:做出一个能唤醒、能聊天、能按语音要求拍照的 USB 供电原型。 电池续航、嘈杂环境、远距离唤醒和长时间误触发,还没有完成验证。
开始前:先保住上集已经成功的部分
这一篇从“按键聊天已经正常”继续。还没跑通录音、屏幕、喇叭和后端的读者,建议先完成上集。
我用的仍是这套组合:
同样叫“ESP32-S3”的套件,引脚也可能不同。不要只看芯片名字,就把别人的固件刷进去。
开始前,我把这段任务交给 Codex:
请在现有能按键聊天的工程上继续开发。先读取进度记录、源码、引脚配置和编译脚本,核对当前设备。备份已经可用的固件、分区表和本次将改动的源码。本次先接语音拍照,再接本地“小李”唤醒。保留按键聊天,不擦除已有Wi-Fi和设备授权配置。不要修改电池电路,不要把编译通过当作实机成功。每完成一条流程,再引导我做真实测试。这里的“备份”很有用。调试新功能失败时,我们需要能退回上一版,而不是重新猜哪根线松了。
第一步:把设备和后端的分工想清楚
这套小设备没有在本地运行一个完整的大模型。
板子负责听、拍、显示和播放;后端负责转写、聊天、看图和生成语音。 新增的“小李”识别在板子上完成。
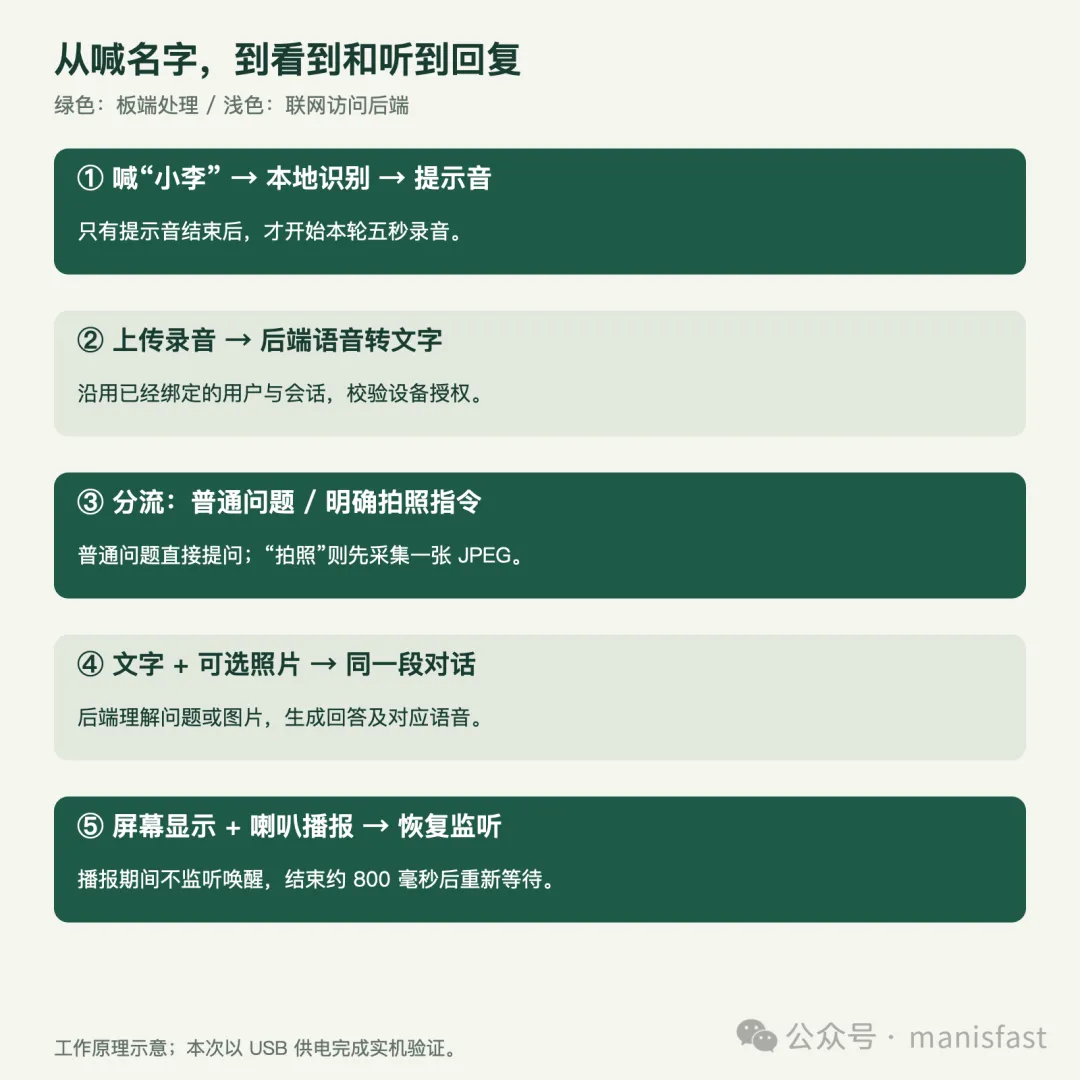
流程示意图。绿色部分在板端,浅色部分需要联网访问后端。
两条流程共用后半段:
普通聊天:语音转成文字后,直接提问。 拍照:语音转成文字后,判断是不是明确拍照指令;如果是,再拍一张照片,把照片和问题一起发送。
这样不必另外造一个“拍照聊天系统”。已经跑通的会话、屏幕显示、文字转语音和扬声器播放,都可以继续复用。
第二步:先按键说“拍照”,别急着一起加唤醒
我的开发顺序是:先保留 BOOT 按键,只加拍照。
因为同时改“怎么开始录音”和“怎么拍照”,一旦失败,就很难知道是哪一步出了问题。
把下面这段交给 Codex:
先保留短按BOOT后录音的流程,只增加拍照分支。复用此前实机通过的摄像头引脚配置。只有转写结果匹配明确拍照指令,才启动相机。先支持“拍照”这个固定口令。“不要拍照”“拍照是什么意思”和引用别人的话不能触发。其他话继续走普通聊天。相机先丢弃预热帧,再取一张JPEG。拍摄完成后释放相机资源,不在开机或待机时自动拍摄。拍摄失败要报告失败,不能假装带着照片继续提问。补充拍照指令的肯定、否定、讨论和超长输入测试。这一版拍的是 320×240 的 JPEG。先用它验证“拍到、发到、看懂、回复”这条流程;小字、远处细节等需求,后面再考虑分辨率和画质。
不要用简单的“句子里有‘拍照’两个字就触发”。“不要拍照”也包含这两个字,但显然不是要它拍。
我这版用了有限的明确短句匹配。最直接的验收口令就是:“拍照。” 对不在列表里的自然说法,暂时按普通聊天处理。
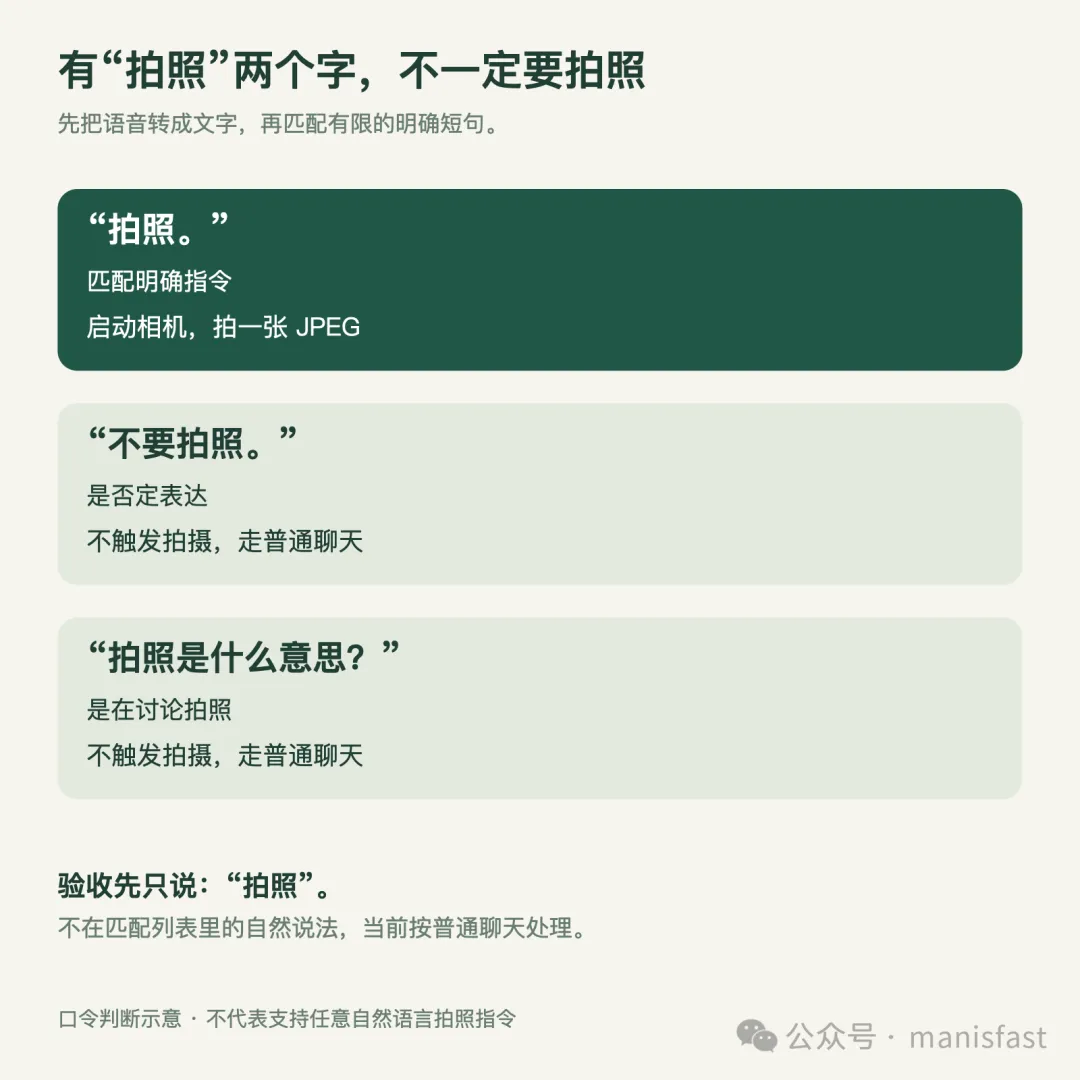
判断示意:先看是不是明确指令,不能只检查句子里有没有“拍照”两个字。
我真的遇到了一次“没有收到照片”
第一轮测试,我反馈:网页和助手都没有收到照片。
这时我们没有立刻换摄像头,也没有凭感觉把原因写成“网络不好”。Codex 开始监听设备状态,让我短按 BOOT,提示音后只说“拍照”。
这一轮日志里,先出现语音转写成功,再出现:
HERETOO_CHAT_PHOTO captured bytes=5298 width=320 height=240它说明相机确实取到了照片。后续,我在网页看到图片,助手也正确描述了物品。
第一轮为什么没收到,没有足够日志确认。 口令匹配这环节确实要查,但不能因为换个说法成功了,就一口咬定找到了根因。
这一关你也可以这样测:把摄像头对准杯子或书,短按 BOOT,提示音后说“拍照”,然后分别看网页、屏幕,听喇叭。
第三步:照片要进入同一段对话
拍下照片,只完成了一半。
接下来必须明确:照片发给哪个接口、属于哪个用户和哪段会话,后端是否真的把图片交给了能看图的模型。
我原有的 HereToo 设备接口已经支持图文提问,所以这次没有再部署新的后端。固件主要补充这些字段:
{"request_id": "本轮新生成的UUID","question": "拍照","share_image": true,"image": {"mime": "image/jpeg","data": "JPEG的Base64内容","captured_at": "实际拍摄时刻的UTC时间" }}这是字段示意;真正调用时,UUID、图片内容和时间都要由程序生成。
这里的关键是:照片和问题放在同一次提问中,沿用设备已经绑定的会话。 普通聊天不带图片字段,也不会顺便拍一张。
后端保存照片并返回本轮回复,设备继续按原来的逻辑显示文字、获取这条回复的语音、播放音频。网页则能在对应消息里看到图片。
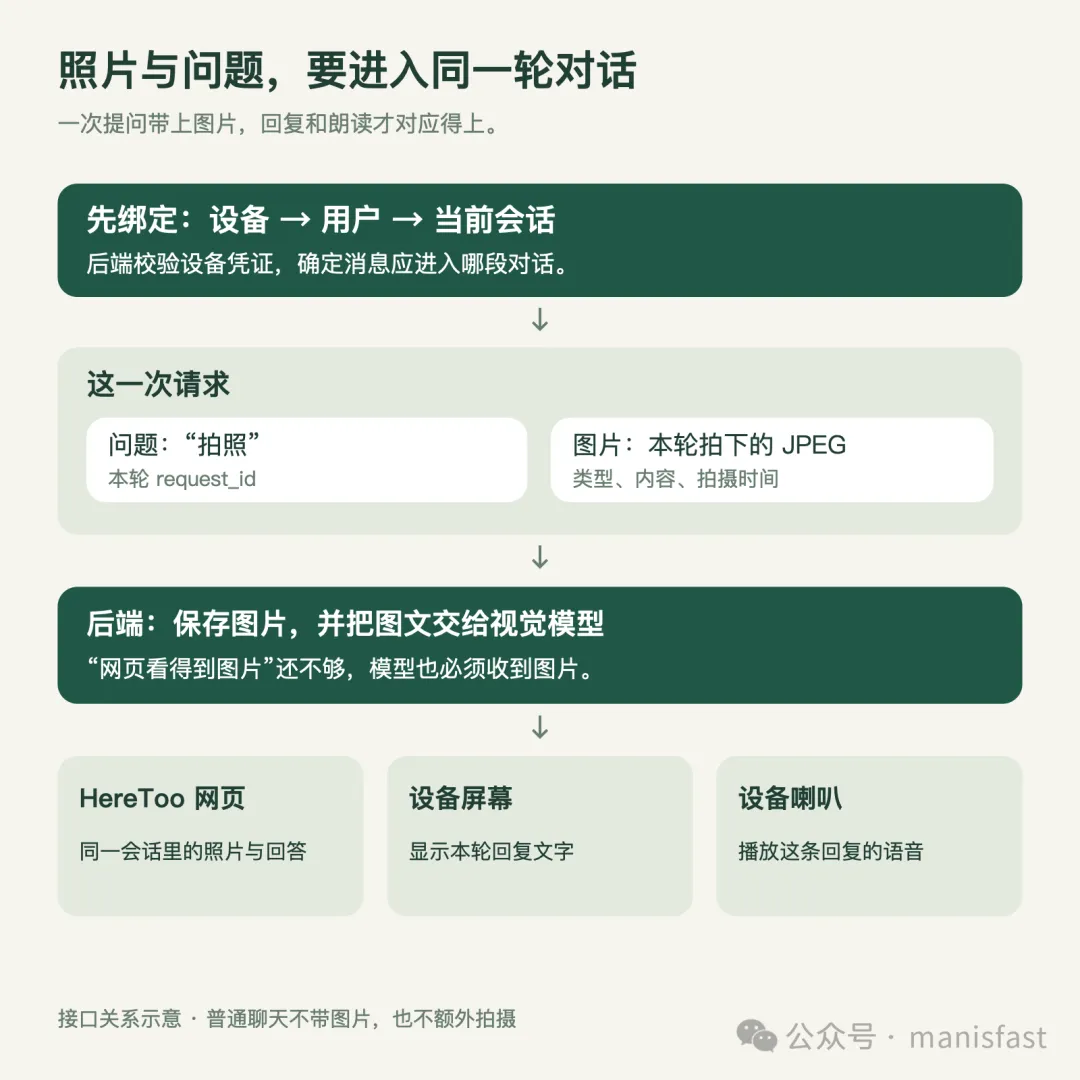
接口关系示意,并非网页截图:照片与问题一同提交,网页、屏幕和喇叭对应同一轮回复。
如果你没有 HereToo,也能自己做
你可以给自己的后端使用不同的接口路径,只要把设备与后端的约定对齐:
把接口要求和你现有的工程交给 Codex:
请核对我的后端是否已经支持带图片提问。若没有,先实现一个最小AI小助手后端,并让固件与其接口一致。设备凭证必须绑定具体用户和会话,支持失效和撤销。图片按JPEG接收,校验实际类型和大小,不只相信文件名。模型要支持图像输入,或先由视觉模型描述再交给对话模型。返回同一轮的文字、图片引用和语音获取方式。模型密钥放服务器,不写入固件,也不要在聊天中索要密钥。先用模拟接口检查请求结构,再接真实模型验证一张照片。设备使用HTTPS并校验证书,不用关闭鉴权来“临时跑通”。这条独立后端路线还需要你自己的模型服务和部署环境。本文实测的是我的 HereToo 接入,不能把一段提示词当成所有后端都已验证的成品。
第四步:给它加上本地“小李”唤醒
拍照通过后,才轮到唤醒。
我希望待机时不用把房间里的声音持续传到服务器,识别“小李”这件事先在板子上完成。
这次采用的方案是 **ESP-SR 2.4.7 中的中文 MultiNet 模型 mn7_cn**,把 xiao li 注册为自定义命令。你可以把它理解为:给设备本地加一个“听到这个词就开始下一步”的识别器。
这不是给“小李”重新训练了一个专用唤醒模型,也不是在板子上做开放式语音转文字。MultiNet 支持本地自定义命令词,具体能力可以查看乐鑫官方文档。本项目使用锁定版本,不直接照搬最新版接口。
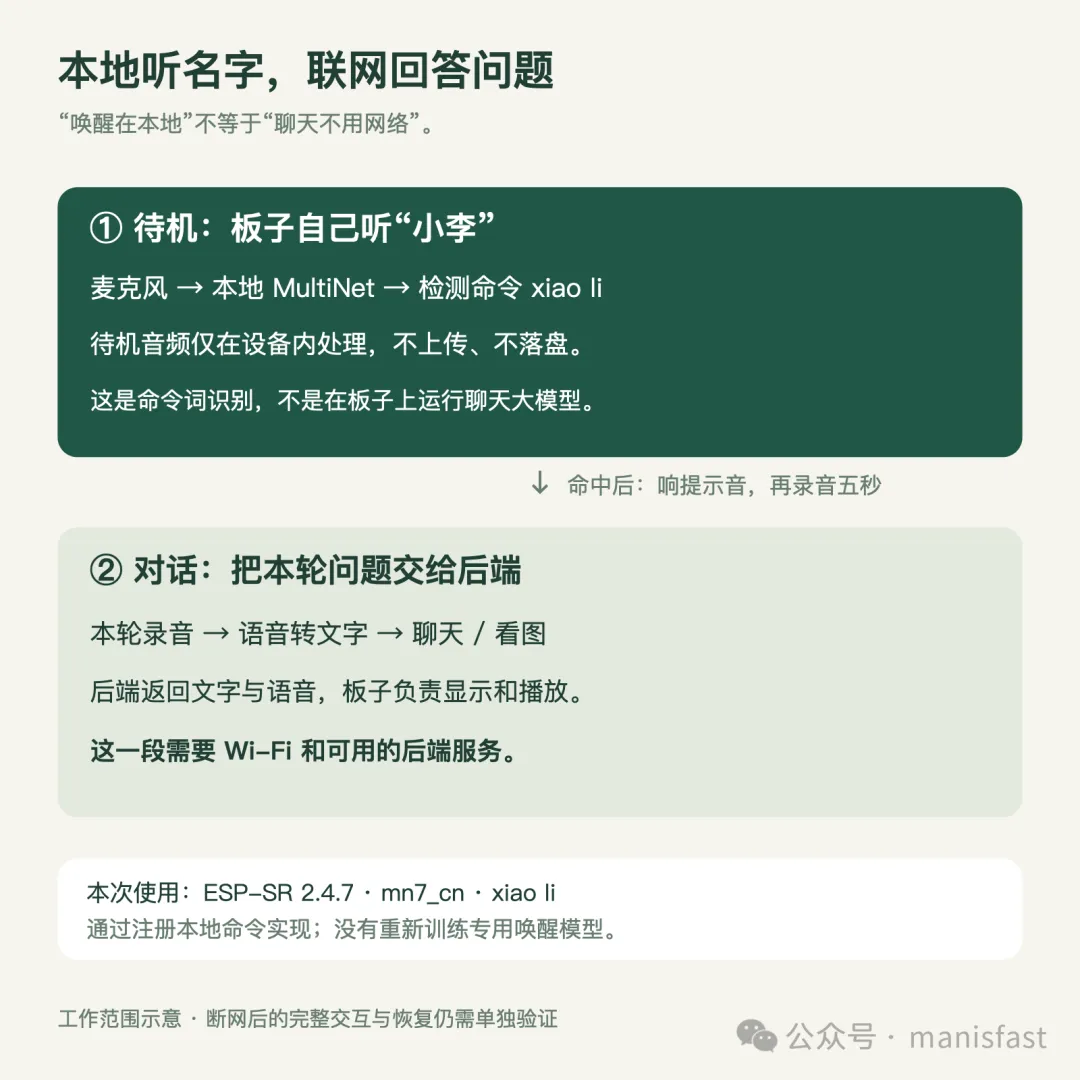
工作范围示意:待机识别在板端完成,唤醒后的问题仍通过后端转写、理解和回答。
这一阶段给 Codex 的任务是:
请核对ESP-SR 2.4.7实际头文件和示例,接入中文MultiNet模型mn7_cn。将“xiao li”注册为本地命令,触发后复用现有录音聊天流程。待机音频只在设备内处理,不上传、不落盘。优先复用已验证的16kHz麦克风通道,不更换引脚。唤醒初始化失败时保留按键模式,给出明确状态。日志只记录模型加载、触发、请求状态和错误,不记录私人音频或凭证。先报告模型大小、内存需求和分区安排,再编译刷写。这次模型约 2.6 MB,我们给它安排了独立的 4 MB 分区。原来存放 Wi-Fi、设备授权的区域保持原位置。
所以,不能只把模型文件复制进工程就结束。还需要让编译配置、模型选择、分区表和实际刷入的内容一致。跟做时把当前分区表交给 Codex 核对,不要直接照抄别人的烧录地址。
另一处调整是内存:原来的音频下载逻辑,会按允许的最大回复长度预留缓冲。模型常驻后,我们让已知长度的响应按实际大小申请空间,同时保留长度上限和完整性检查。
设备启动日志最终出现了:
HERETOO_WAKE MODEL_READY chunks=512 free_psram=5406968HERETOO_WAKE LISTENING local_only这说明模型已经加载、监听已经启动,剩余 PSRAM 约 5.4 MB。但能不能听懂我喊“小李”,还得靠下一步真人试。
第五步:让监听、录音、播放按顺序工作
有个问题容易被忽略:助手一边用喇叭说话,一边还在听自己的唤醒词,会不会把自己叫醒?
这一版的处理很直接:说话、处理请求和播报期间,暂停唤醒监听。
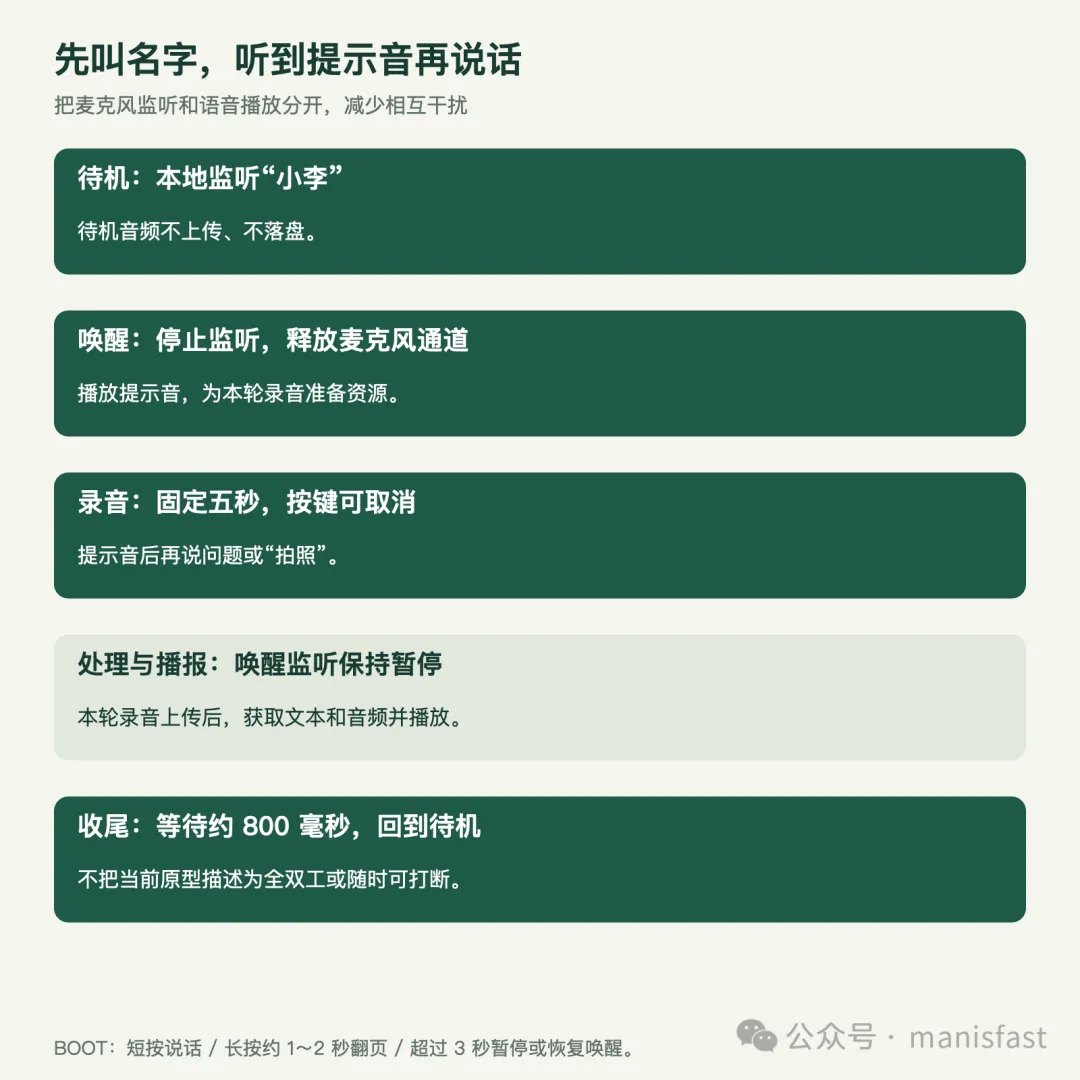
状态示意图。本版需要先喊名字,听到提示音后再说问题;不支持一口气说完,也没有验证播报中打断。
顺序是:
待机,本地监听“小李”。 检测到唤醒词,停止监听、释放麦克风通道。 播放提示音,开始五秒录音。 上传本轮语音,按需要拍照,等待回答。 屏幕显示文字,喇叭播报。 播报结束后等待约 800 毫秒,再恢复监听。
这段等待用于给播放收尾留出间隔,不能据此宣称已经解决了所有回声和误唤醒问题。
对应的 Codex 提示词:
把待机监听、录音、网络请求、语音播放串成明确的状态流程。同一个麦克风I2S通道不能被监听和聊天同时占用。播放提示音和回复时暂停唤醒,播报结束后再恢复。保留短按BOOT说话、录音中按BOOT取消、长按翻页。增加长按超过三秒暂停/恢复唤醒的入口。覆盖初始化失败、网络失败和取消后的资源释放路径。不要把这版描述为全双工对话或支持随时打断。本次先把识别阈值设为 0.65。这是本项目的起始配置,不是适合所有麦克风、距离和房间的最佳值。
“小李”只有两个音节。成功一次,不代表它不会把别的动静误听成“小李”,后面仍要做安静环境、背景说话和不同距离的测试。
第六步:按这个顺序做真人验收
刷写完成后,按商家要求,断开 USB 约五秒,再插回 TTL 口。等设备联网、验证授权、加载模型,不要刚上电就立刻喊。
我这套设备的授权限定当天会话,最长 24 小时。跨天测试如果提示未授权,先在电脑浏览器登录,打开今天的会话,再到自己的设备绑定页重新绑定。若绑定时串口被占用,让 Codex 先停止串口监控。
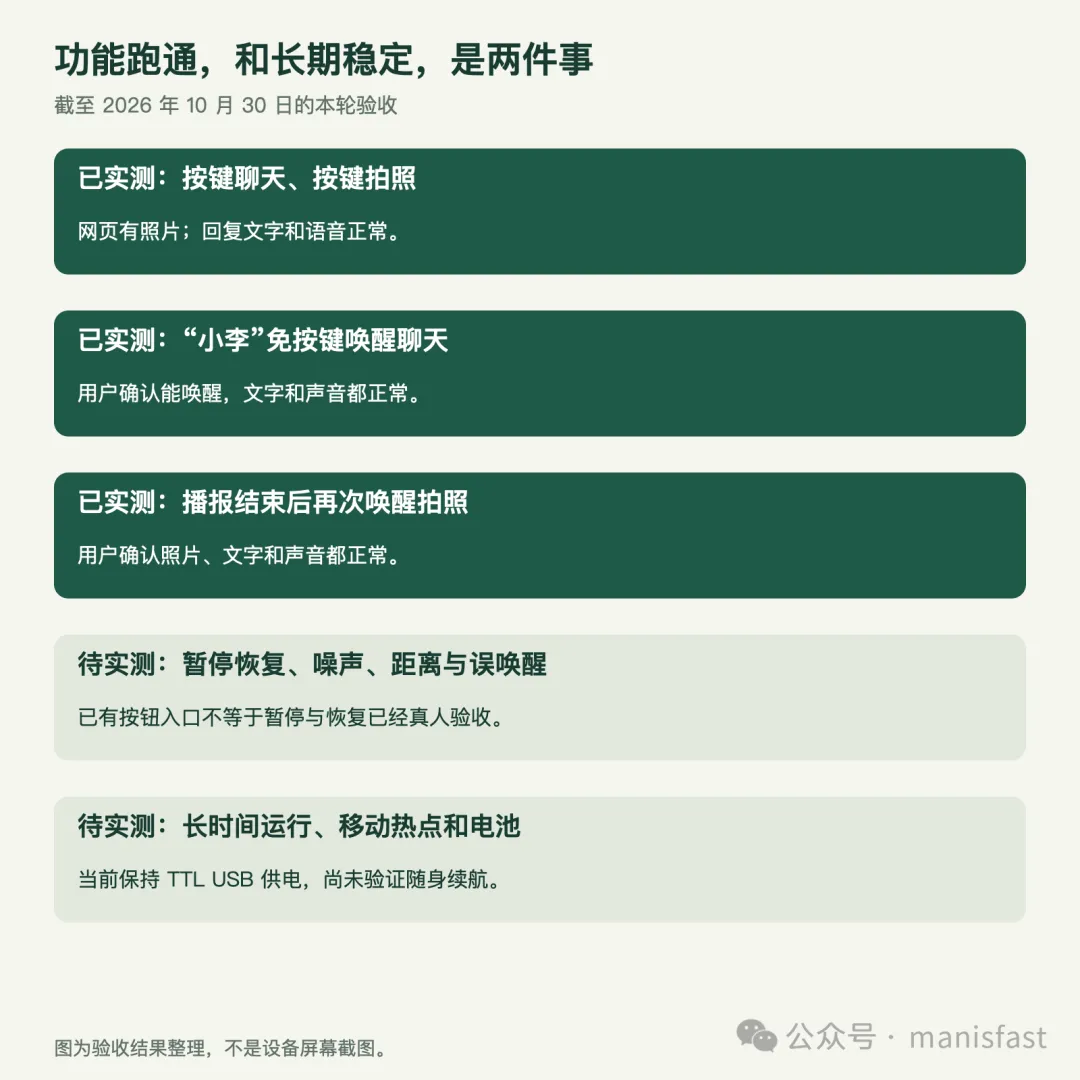
绿色为本次已经通过的主要流程;浅色为后续仍需测试的项目。
先验收普通聊天
等屏幕显示“可以叫小李了”,在距离麦克风约 20~40 厘米的位置说:
“小李。”
停一下,听到提示音,再说:
“你好,跟我打个招呼。”
这里的 20~40 厘米是首次测试时建议的站位,不是测出来的最大唤醒距离。
这一轮,我给 Codex 的反馈是:“能唤醒,文字和声音都正常。”
再验收唤醒后拍照
等上一轮播报结束,对准杯子或书:
先说“小李”,提示音后只说“拍照”。
不用碰 BOOT。分别检查三件事:网页里有没有新照片,屏幕有没有回答,喇叭有没有正确描述眼前的物品。
这一轮,我确认:“照片、文字和声音都正常。”
设备日志也记录到播报后恢复监听、再次检测到“小李”、采集照片,以及后续请求成功。至此,两条主要流程都通过了。
最后留一份具体的使用说明
长按暂停/恢复入口已经实现,但这次还没有专门做真人验收;正式日常使用前,应补测暂停后不响应唤醒、恢复后重新响应。
跟做时卡住,怎么向 Codex 反馈
“坏了”“没反应”很难帮助定位。把看到和听到的现象拆开说,会有效得多。
你可以这样发任务:
这轮现象是:____。我说的原话是:____。屏幕显示:____;喇叭表现:____;网页是否有照片:____。请先监听一次完整测试,区分唤醒、录音、转写、拍摄、上传、回复、播放。只依据日志和我的实际反馈定位,不先猜是硬件坏了。给出最小修改,修复后重测原来失败的步骤,并回归普通聊天。做到这里,它已经能陪我说话,也能看一眼眼前
这次没有换一块更贵的开发板,也没有把整个工程推倒重写。
我们从已经成功的按键聊天出发,先加拍照,确认照片真的进入对话,再加本地唤醒,最后把两者连起来测试。
Codex 负责读源码、写程序、检查接口、编译刷写和分析日志。我负责接好设备、对着它说话,并告诉它:我看到了什么,听到了什么。
对硬件小白来说,这种配合让我能一步步走到这里。也让我明白,动手做 AI 硬件时,每一个“成功”都应该能对应到一个具体动作和一个亲眼看到、亲耳听到的结果。
现在,喊一声“小李”,它能回答;再说一句“拍照”,它能看看我眼前的东西。
下一阶段,再去验证它在真实生活里能不能用得稳:会不会误唤醒、断网后能否恢复、拿远一点还能不能听见,以及接上电池以后能陪我多久。