ARTICLE · 1293866
邮储银行后端一面+二面真题(附PDF回答模板)
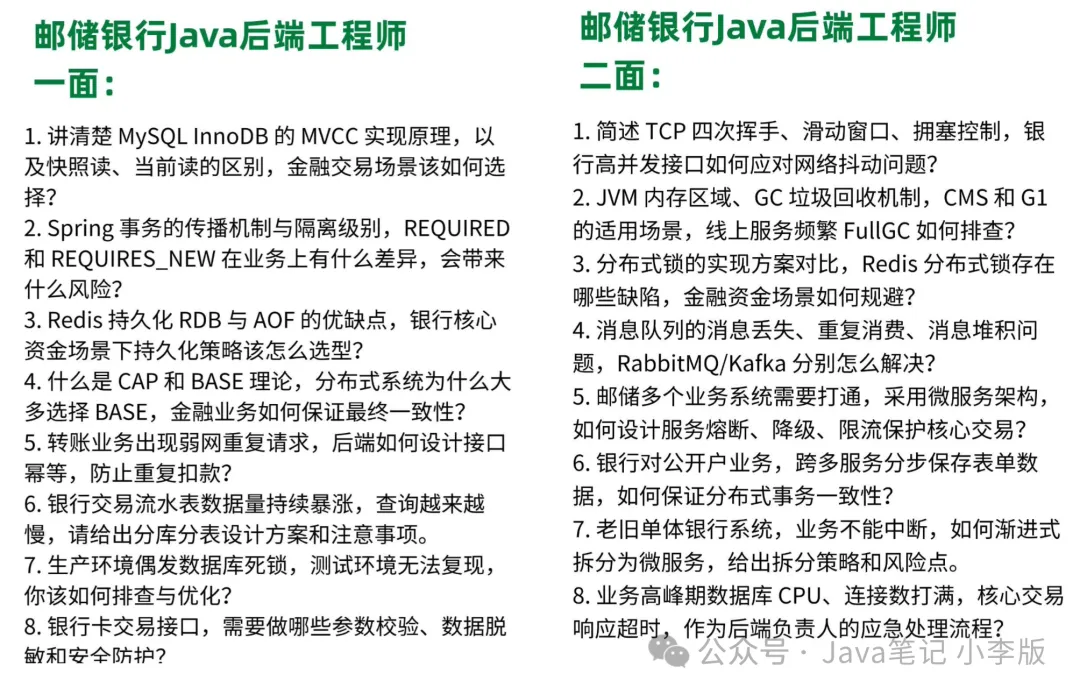
一、Spring事务的传播机制与隔离级别,REQUIRED和REQUIRES_NEW在业务上有什么差异,会带来什么风险?
回答模板:
① 隔离级别:Spring 的隔离级别就是一个枚举,本质是把数据库连接的隔离级别设下去,自己不实现隔离。默认是DEFAULT ,跟随数据库,MySQL 是 RR,Oracle 是 RC。七种里实际常用的是 READ_COMMITTED、REPEATABLE_READ 和SERIALIZABLE,SERIALIZABLE 在银行里基本只在极少数对账、清算场景用,因为并发度太低。要注意 Spring 管不了跨库、跨数据源的一致性,它只管当前连接。
② 传播机制:七种:REQUIRED、SUPPORTS、MANDATORY、REQUIRES_NEW、NOT_SUPPORTED、NEVER、NESTED。日常用的就三个:
REQUIRED(默认) | 有事务就加入,没有就新建,共用同一个物理连接和事务 | |
REQUIRES_NEW | 挂起外层事务,新开连接、新开事务 | 内外完全独立,内层提交不受外层回滚影响,反之亦然 |
NESTED | 基于 JDBC Savepoint 的嵌套,不是新事务 | 内层回滚只回到保存点,外层可继续提交 |
③ 业务差异:最典型的例子是转账记账。REQUIRED 下,主交易和记账流水是一条绳上的蚂蚱:主交易失败,流水一起回滚,数据是「要么全有要么全无」,这是我们希望的。REQUIRES_NEW 下,记账单独提交,哪怕主交易后面失败了,这条记录也已经落库了。所以 REQUIRES_NEW 适合「失败日志、审计流水、异常快照」这类必须留痕的场景,不适合「必须和主业务同生共死」的记账。
④ 风险(重点):我总结四个:
连接翻倍:外层事务占着一个连接,内层 REQUIRES_NEW 又拿一个,一个线程占两个连接。高并发下连接池很容易被打满,进而引发获取连接超时,整条链路雪崩。
锁冲突甚至死锁:外层事务已经锁住了账户行,内层新事务如果去更新同一行,就会等外层释放;而外层又在等内层返回,形成互相等待的死锁。这是 REQUIRES_NEW 在资金场景最危险的地方。
数据多写、无法回滚:内层提交后外层失败,出现「记账成功但主单失败」的脏数据,必须靠冲正或对账修复。
自调用失效:同一个类里 this.method() 调用不走代理,传播行为完全不生效。必须通过注入自身代理、AopContext.currentProxy() 或者拆到另一个 Bean 里。
⑤ 补充坑:默认只有 RuntimeException 和 Error 才回滚,受检异常必须写 @Transactional(rollbackFor =Exception.class) ;事务方法必须是 public;异常被 catch 吞掉不会回滚;事务里做 RPC 或发 MQ 会拉长事务时间。这些在代码评审里我都要求逐条过。
所以我的原则是:能用 REQUIRED 就不用 REQUIRES_NEW;确实需要独立事务时,先保证内层操作的数据和外层不重叠,并且用异步或消息解耦,避免连接和锁的双重放大。
二、转账业务出现弱网重复请求,后端如何设计接口幂等,防止重复扣款?
回答模板:
① 问题拆解:弱网下会出现三种情况:请求没到服务端、请求到了但响应丢了、服务端处理超时但实际成功。客户端的重试在前两种是必要的,在第三种就会造成重复扣款。所以幂等设计的本质是:让同一笔业务请求执行 N 次和执行 1 次的结果完全相同,并且每次返回同样的结果。
② 幂等键:客户端或上游系统在发起时生成一个全局唯一的 requestId ,通常是雪花 ID 或 UUID,放在报文头和报文体里,签名保护防止篡改。重试时必须复用同一个 requestId,这是区分「重试」和「新交易」的唯一依据。如果让服务端自己生成,客户端每次重试都拿到新 ID,幂等就失效了。
③ 四道防线:
入口层——Redis 占位:用 SET key value NX PX 1800000 ,key 是 idem:transfer:{requestId} 。设置成功说明是首次,继续处理;设置失败说明重复,读取缓存里的处理状态:处理中就直接返回「处理中,请查询」,成功就返回缓存的成功结果。注意顺序:必须先占位再执行业务,不能执行完再写,否则并发窗口内两个请求都会执行。
业务层——状态机条件更新:转账单有明确状态:INIT → PROCESSING → SUCCESS / FAIL。所有状态流转都用带条件的 UPDATE: UPDATE transfer_order SET status='PROCESSING' WHERE order_no=? AND status='INIT' ,影响行数为0 就说明已经被处理过,直接走查询返回。账户扣减同样用 WHERE balance >= amt 的条件更新,天然防超扣。
存储层——唯一索引:在转账流水表上建 uk_request_id 唯一索引,或者用「业务流水号」做唯一键。这是最后一道物理防线,即使前面都漏了,数据库也会拒绝重复插入并抛 DuplicateKeyException,捕获后转为查询返回。关键点:幂等记录的插入必须和业务扣款在同一个本地事务里,否则会出现「扣了款但幂等记录没写」的漏洞。
兜底层——结果查询与冲正:提供一个幂等的「单笔交易查询」接口,客户端超时后先查后重试,不要盲目重发。如果服务端处于「不确定态」——比如调用核心超时、不知道到底扣没扣——必须走单笔查证,确认未成功才能冲正或重发,绝不能凭猜测再发一笔。
public TransferResult transfer(TransferRequest req) {String key = "idem:transfer:" + req.getRequestId();// 1. 占位(先占再执行)if (!redis.setIfAbsent(key, "PROCESSING", 30, MINUTES)) {return queryOrProcessing(key); // 重复请求:查状态/返回原结果}try {// 2. 本地事务:状态机 + 条件扣款 + 唯一索引 + 幂等记录,同库同事务TransferResult r = transferService.doTransfer(req);redis.set(key, JSON.of(r), 30, MINUTES); // 缓存首次结果,保证返回一致return r;} catch (DuplicateKeyException e) {return transferService.queryByRequestId(req.getRequestId()); // 3. 唯一索引兜底} catch (Exception e) {redis.del(key); // 4. 明确失败才释放占位,允许重试throw e;}}
④ 三个易错点:
分布式锁不等于幂等。锁释放后重复请求照样能进来,而且 Redis 主从切换可能丢锁。锁只用来降低并发冲突,幂等要靠唯一键和状态机。
重复请求要返回相同结果。如果第二次返回「重复请求」错误码,客户端可能认为失败继续重试,反而放大问题。正确做法是返回首次的成功结果。
异常分支要区分。「确定失败」才释放占位允许重试;「不确定」(超时、网络异常)不能释放,要保持 PROCESSING让后续请求走查询或人工。
我一般的落地顺序是:请求号幂等键是最基础的,唯一索引是最后兜底,状态机保证业务状态不会倒退,对账保证钱不会错。哪怕前面全挂了,T+1 对账也能把差异捞出来做冲正。这就是银行和互联网做幂等的最大区别——互联网允许最终一致,银行要求账必须平。
三、JVM 内存区域、GC 垃圾回收机制,CMS 和 G1 的适用场景,线上服务频繁 Full GC 如何排查?
回答模板:
① 内存区域:分两类。线程私有的三个:程序计数器、虚拟机栈、本地方法栈,生命周期跟线程走,栈深度超了抛StackOverflowError。线程共享的两个:堆和方法区,堆分新生代(Eden + 两个 Survivor)和老年代,方法区在 JDK 8 之后是元空间,用本地内存;堆不够抛 OOM: Java heap space,元空间不够抛 Metaspace OOM,常见于动态生成类太多,比如 CGLIB 代理、热部署。另外还有直接内存,NIO 的 DirectByteBuffer 用的,不受堆大小限制但受物理内存限制,也会OOM。
② GC 机制:核心是分代假说——绝大多数对象都是朝生夕死,熬过多次 GC 的少数对象才进老年代。判断对象死活用可达性分析,从 GC Roots(栈上的引用、静态变量、常量、JNI 引用)出发,不可达就可回收。新生代用复制算法,Eden 和Survivor 之间来回复制,效率高、没有碎片;老年代用标记-清除或标记-整理。Minor GC 频繁但快,Full GC 会 STW,停顿长,所以要尽量避免。
③ CMS 和 G1:
对比项 | CMS | G1 |
算法 | 标记-清除,不压缩,有碎片 | Region 划分,标记-复制,整体无碎片 |
停顿 | 低停顿,但不可预测 | 可预测停顿, -XX:MaxGCPauseMillis |
适用堆 | 4~8G,老年代大、停顿敏感 | 8G 以上大堆,JDK 9+ 默认 |
典型问题 | 并发模式失败退化成 Serial Old、浮动垃圾、CPU 敏感 | Humongous 大对象、SATB 写屏障开销 |
简单来说:小堆、追求低延迟、JDK 8 时代用 CMS;大堆、要可控停顿、JDK 9 以上用 G1;堆特别大(几十 G 到 TB)且要求毫秒级停顿,就上 ZGC 或 Shenandoah。银行的核心交易服务如果堆在 8G 以上,我会优先 G1,因为停顿可预测比理论最低停顿更重要。
④ 频繁 Full GC 排查:我会按「看现象 → 抓数据 → 判类型 → 定根因 → 止血修复」这五步走。
看现象:接口 RT 毛刺、TP99 抖动、应用周期性卡顿,监控上能看到 Full GC 次数和停顿时间突增。先确认是「频繁但每次能回收」还是「回收后老年代仍然下不去」。
抓数据: jstat -gcutil pid 1000 看各区使用率和 GC 次数;GC 日志(JDK 9+ 用 -Xlog:gc* ,JDK 8 用 -XX:+PrintGCDetails )看每次回收前后的变化; jmap -histo:live 看对象数量排行; jmap -dump:live,format=b,file=heap.hprof 导出堆,用 MAT 分析支配树和 GC Root 引用链;线上可以用 Arthas 的dashboard、heapdump、vmtool,或者 JFR 做低开销采样。
判类型:三种典型形态。Full GC 后老年代明显下降、但很快又涨回来 → 对象晋升太快或堆太小;Full GC 后几乎不下降→ 内存泄漏;元空间持续增长 → 类加载泄漏。
常见根因:静态集合做缓存没有上限(本地 Map 越存越多,应换成 Caffeine 并设最大容量和过期);ThreadLocal 用完没 remove,线程池复用导致对象一直被引用;数据库连接、流、Channel 没关;监听器、回调注册了没注销;一次查询把几百万条数据全加载进内存;大对象直接进老年代;显式调用 System.gc() ;Survivor 太小导致对象过早晋升。
止血与修复:线上先止损——扩容、滚动重启(重启前先 dump 保留现场)、关闭非核心功能、限流。然后根据 MAT 定位到的引用链改代码,灰度验证。最后补上监控:Full GC 次数、老年代使用率、单次停顿时间都设告警。
我个人的经验是:Full GC 频繁,80% 是代码问题,20% 是参数问题。先 dump 再重启,不要重启完就当作解决了;能找到泄漏点的,一定从代码改,堆参数只能缓解。
四、老旧单体银行系统,业务不能中断,如何渐进式拆分为微服务,给出拆分策略和风险点。
回答模板
① 总体原则:四个词——不重写、不停机、可回滚、小步快跑。老系统里的业务逻辑是十几年沉淀下来的,很多规则藏在存储过程、定时任务、甚至老员工脑子里,推倒重来风险极高。所以我的思路是「绞杀」,不是「替换」:新功能用新服务写,老功能一块一块迁移,迁完一块关掉老代码一块。
② 第一步:领域梳理。先做现状盘点,用 DDD 的方法划分子域和限界上下文:客户、账户、产品、交易、支付清算、渠道、风控、报表。同时画出调用关系图、数据依赖图、变更频率和流量分布。这一步的产出是拆分优先级清单,判断依据是:业务独立性、变更频率、性能瓶颈、团队归属、故障影响面。
③ 第二步:绞杀者 + 分支抽象。在单体前面架一个 API 网关或路由层,所有流量先过网关。新服务上线后,网关按规则把部分流量路由到新服务,其余仍走老单体。老单体内部则用「分支抽象」:先抽出接口,本地实现还在老代码里,等新服务就绪后把实现换成远程调用(加防腐层做模型转换),这样调用方代码不用改。
④ 第三步:拆分顺序。我的建议是从边缘往核心拆:
第一梯队(低风险):渠道接入、通知短信、文件传输、报表查询、参数配置。这些模块无状态、依赖少、出问题影响面小,适合练手和验证基础设施。
第二梯队:客户信息、产品目录、额度管理。有一定状态但不算核心账务。
第三梯队(高风险):账户、记账、清算。这些必须等基础设施、团队能力、灰度机制都成熟后再动,而且往往采用「新老并行、双写比对」的方式。
⑤ 第四步:数据解耦(最难)。微服务拆分真正的难点不是代码,是数据库。我的路径是:先逻辑隔离,再物理拆分。第一步按服务划 schema 或加表前缀,禁止跨服务直接写别人的表,只能通过接口;第二步用 CDC(Canal 订阅 binlog)做数据同步,让新服务有自己的库;第三步做双写和比对,确认一致后再切断老库写入。切忌一上来就把表拆开,出了问题无法回滚。
⑥ 第五步:灰度与双跑。流量切换要可控:按客户号取模、按渠道、按机构、按比例逐步放量;关键交易做影子流量双跑,同一笔请求同时打新老系统,比对结果和耗时,一致率达标才切。所有路由都要有开关,出问题秒级切回老系统。
⑦ 基础设施先行。拆分前这些必须先就位:注册中心、配置中心、API 网关、统一鉴权、链路追踪(TraceId 贯穿)、集中日志、监控告警、CI/CD、容器化。没有这些就拆微服务,会给后面埋下很多坑。
⑧ 风险点(重点讲):
分布式事务与数据一致性:原来一个本地事务能解决的问题,拆完变成跨服务,必须用消息 + 补偿 + 对账,设计成本大幅上升。
性能下降:本地方法调用变成网络调用,序列化、超时、重试都会增加 RT;跨服务查询容易出现 N+1 问题,需要做聚合层或宽表。
故障传播:原来单体里一个异常不影响别的模块,拆完一个服务挂可能拖垮整条链路,必须配套熔断降级。
数据迁移风险:双写期间的不一致、迁移过程中的丢失、回滚时的数据回补,都要有校验脚本和对账机制。
老系统的隐藏逻辑:存储过程、触发器、定时批处理、硬编码规则,文档里没有但业务依赖,拆分时最容易漏。
组织与职责:康威定律——系统架构会向组织架构靠拢。拆分必须同步调整团队边界,否则会出现「服务拆了但没人负责」。
测试与回归成本:链路变长,端到端测试难度指数上升,需要契约测试和自动化回归。
银行特有的合规风险:变更要审批、有变更窗口、要双人复核;核心系统变更往往需要监管报备;必须保证审计留痕、数据可追溯、灾备同步。业务不能中断意味着只能滚动发布、蓝绿发布,且必须准备好回滚预案并演练。
总结:拆分的目标不是「拆得细」,而是「拆得动、退得回」。我的节奏是:先建基础设施,再拆边缘模块,数据先逻辑隔离再物理拆分,每一步都灰度、双跑、可回滚,核心账务放到最后。
由于文章篇幅有限,写太多怕影响大家的阅读感受,我把整个面试题以及答案都写进PDF文档了,大家可以回复关键字【邮储银行面试题】,免费获取。
觉得有用的话,别忘了关注【Java笔记 小李版】👇