ARTICLE · 1296468
AI日报|单图生成3D动态头发开源工具!ChatGPT与 Codex共享额度,12 月起!DeepSeek提出Super-agent架构并开源原型!
2026年10月31日—11月2日 AI资讯日报
【AIGC】
• HairDeck开源单图生成3D动态头发工具:只需一张二次元或风格化人物图片,就能生成独立的3D发片、UV和弹簧骨骼链,让头发随着人物转头自然摆动。支持导出GLB和VRM,官方测试中发片生成速度比CHARM快33倍。
【大模型】
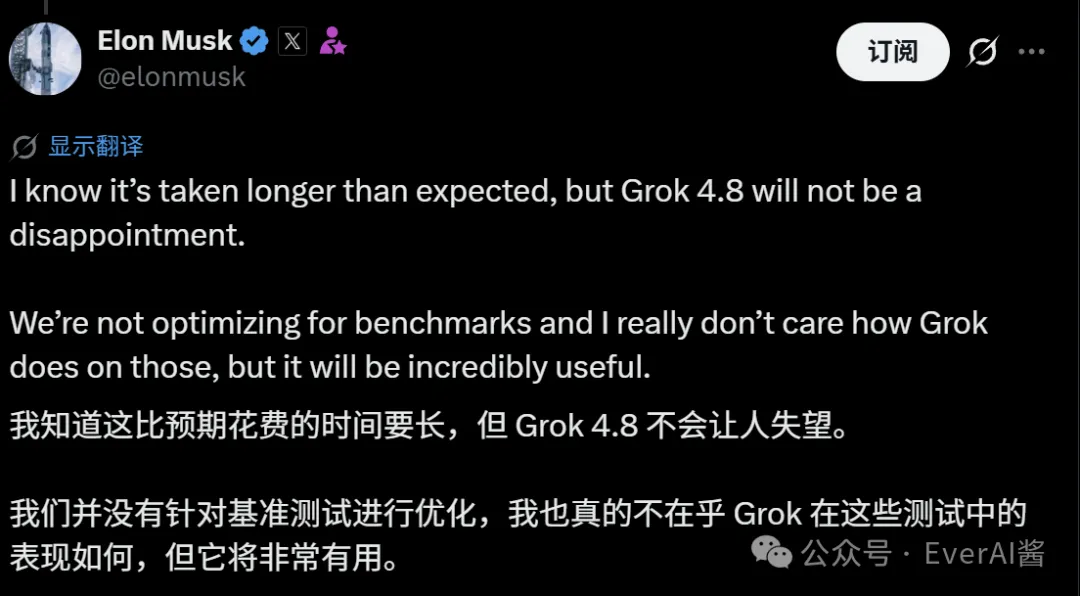
• 商汤开源SenseNova-Loop-9B模型:采用循环复用参数的Looped Transformer架构,用约90亿参数实现56层计算深度,支持图像理解、文档分析、编程和Agent任务。官方称部分复杂任务达到27B级模型的表现。 • 美团发布LongCat-2.5正式版:模型总参数达到1.6万亿,支持原生多模态、100万Token上下文和长程Agent任务,兼容Claude Code、Codex、Hermes等多种Agent执行框架,重点面向复杂软件工程与视觉编程。 • OpenAI发布GPT-6 Rosalind Research生命科学模型:采用与GPT-6 Astra相同的模型权重,针对生命科学研究开放专门访问通道,可辅助基因组分析、蛋白质研究、药物发现和实验规划。仅向通过安全及合规审核的机构开放。 • 马斯克回应Grok 4.8延期:称新模型开发比预期更久,但目标是提升真实使用价值,而非针对Benchmark优化。目前尚未正式公布发布时间和完整技术参数。
【Agent与开发工具】
• OpenAI Agents API新增五项能力:增加命令执行前自动审查、后台异步上下文压缩、实验性时间感知、会话运行中更新工具,以及跨Session系统提示词自动缓存,提升长期Agent运行的安全性和效率。 • DeepSeek提出Super-agent架构并开源原型:通过常驻Router统一接收和分发任务,多个Worker并行执行,配合事件驱动和Watchdog机制,探索可跨会话持续运行的Agent系统。公开仓库为MIT协议研究原型,部分设想尚未实现。 • ChatGPT与Codex将在12月统一使用额度:OpenAI计划将Work的Agent能力融入普通Chat,Plus、Pro和Business用户的ChatGPT与Codex将共享按Token计算的额度。Instant聊天不消耗这部分额度。 • ChatGPT推出双账号切换:用户最多可同时登录两个账号,无需反复退出即可切换。不同账号的聊天记录、记忆、文件和订阅仍彼此独立;同时Codex的28天改进计划进入最后阶段。
【行业信息】
• Claude Max更名为Max和Ultra:原Max 5x更名为Max,月费100美元;Max 20x更名为Ultra,月费200美元。已验证Ultra账户逐步取消五小时用量限制,但每周额度保持不变。 • 马斯克称Grok Bot成本难以持续:面对用户关于Grok Bot额度快速耗尽的反馈,马斯克表示提供该服务的成本相对于收入过高,目前尚无官方宣布的统一额度重置方案。
【其他】
• OpenAI推出Private Intelligence企业隐私方案:提供更严格的企业数据访问控制、Agent操作权限管理及安全机制。符合条件的API工作流可申请零数据留存,Private Inference目前处于预览阶段。 • Anthropic限制Claude Code复刻特定现有游戏:Opus 5.5的Claude Code提示词新增规则,避免直接重制他人的特定游戏。原创游戏、同类型玩法和使用用户自有素材的项目仍然允许。 • Grok API将默认加入不可见水印:SpaceXSI宣布从11月7日起,在部分Grok模型的API文本输出中默认嵌入不可见水印,用于识别AI生成内容。团队管理员可按模型选择关闭,部分锁定模型除外。
每天的AI资讯
🤖️ AIGC
HairDeck:一张图片生成3D动态发型,自带骨骼和物理摆动
清华大学、卡内基梅隆大学等机构的研究团队开源:
HairDeck。
这是一套面向风格化角色的3D头发生成系统。
与普通图生3D不同,HairDeck不仅生成头发的三维形状,还会自动创建:
独立发片、UV坐标和可用于动画的弹簧骨骼链。
什么是Hair Cards?
在游戏和虚拟人制作中,头发通常不需要逐根建模。
一种常见方案是使用:
Hair Cards(头发卡片)。
每张卡片是一条细长的三维发片。
多张发片叠加形成:
• 刘海。 • 侧发。 • 长发。 • 发尾。 • 其他发束结构。
这样可以兼顾视觉效果和实时渲染性能。
HairDeck怎么生成头发?
主要包含三个步骤。
第一步:理解参考图片。
用户输入一张风格化角色图片。
例如:
一名紫发动漫角色。
模型分析发型轮廓和头发方向。
第二步:生成独立3D发片。
采用:
Set Diffusion Transformer。
模型将每张Hair Card表示成一个Token,并联合生成整套发片。
这与逐根顺序生成头发的方法不同。
第三步:生成弹簧骨骼。
系统为发片配置Spring Bone骨骼链。
当角色头部转动时,发片可以产生相应的动态摆动。
核心能力
• 单图输入:从一张角色图片生成三维发型。 • 独立发片:保留各条发束的几何结构。 • UV支持:每张发片具有对应的纹理坐标。 • 自动骨骼:生成用于发片运动的弹簧骨骼链。 • 多结果生成:同一张图片可以生成不同发型版本。 • 标准格式输出:支持GLB和VRM。
官方性能
研究团队在CHARM测试集上公布:
其中,发片生成时间从约33.7秒下降至约1.01秒。
需要注意:
33倍加速仅对应指定测试中的发片生成阶段,不代表完整的图片处理、骨骼绑定和VRM导出也都能快33倍。
项目支持输出:
• GLB:三维头发网格。• VRM:带有角色与头发的虚拟人资产。• 发片几何数据。 • 弹簧骨骼数据。 • 角色转头动画预览。
开源情况
GitHub已开放代码和模型使用流程。
本地运行主要需要:
Linux、Python 3.12及NVIDIA CUDA GPU。
部分依赖模型还需要单独同意相关许可证。
🌟GitHub:
https://github.com/hyz317/HairDeck
🌟项目主页:
https://hyzcluster.github.io/HairDeck/
🌟模型权重:
https://huggingface.co/hyz317/HairDeck
🌟论文:
https://arxiv.org/abs/2610.40599
🧠 大模型
SenseNova-Loop-9B:商汤开源9B循环模型,用更少参数执行更深计算
商汤正式开源:
SenseNova-Loop-9B-Preview。
这是一款采用循环神经网络层设计的多模态语言模型。
最值得关注的是:
通过重复使用同一组参数,提高模型计算深度,而不是简单增加模型参数规模。
核心参数
为什么9B能执行56层计算?
普通Transformer通常让输入按顺序经过不同网络层。
例如:
32层模型依次执行32层计算。
SenseNova-Loop则采用:
共享参数的循环计算。
其内部有32组不同Decoder层。
其中第4至27层被执行两次。
最终达到:
32组独立层参数,实现56次Decoder层执行。
这意味着模型可以获得更深的计算路径,却不需要为重复计算的每一层重新存储一套参数。
核心技术
第一:Looped Decoder。
重复执行指定网络层。
第二:双流mHC机制。
通过Two-stream Manifold-Constrained Hyper-Connections,让信息在两个残差流之间传递和融合。
第三:混合注意力。
结合Linear Attention和Full Attention,平衡长上下文处理能力与计算开销。
支持哪些任务?
• 长文档理解。 • 图像与文字问答。 • 数据分析。 • 编程。 • 外部工具调用。 • Agent工作流。
商汤还展示了动态图形设计和PPT制作等应用案例。
性能表现
官方称:
部分复杂任务能够达到27B级模型的表现。
需要注意,这属于指定任务上的比较,不意味着SenseNova-Loop在所有任务中都等同于27B模型。
另外:
复用参数可以减少模型权重规模,但重复执行网络层仍然增加计算量。
因此并不能简单将其理解为在所有情况下同时获得更快速度与更低成本。
开源情况
模型权重已在Hugging Face发布。
采用Apache-2.0许可证。
不过部分推理加速方案和技术文档仍在完善中。
🌟模型权重:
https://huggingface.co/sensenova/SenseNova-Loop-9B-Preview
🌟官方动态:
https://x.com/SenseTime_AI/status/2116151078219858346
LongCat-2.5:美团发布1.6万亿参数多模态模型,重点提升Coding Agent
美团正式推出:
LongCat-2.5。
这是LongCat-2.5 Preview之后的正式版本。
新模型总参数规模达到:
1.6万亿。
重点升级:
多模态理解、复杂编程和长程Agent任务。
主要能力
1. 原生多模态。
能够结合图片和文字输入完成推理。
例如:
用户上传一张App界面设计图,要求模型生成对应代码。
模型需要同时理解:
视觉布局、组件结构和软件实现。
2. 长程编程Agent。
支持处理大型软件项目。
例如:
• 理解代码仓库。 • 修改跨文件功能。 • 调用开发工具。 • 检查执行结果。 • 处理复杂Bug。 • 完成多步骤软件开发。
3. 支持百万Token上下文。
官方API参数文档显示:
上下文长度为1,048,576 Token。
单次请求最大输出上限为:
262,144 Token。
实际使用需要考虑模型版本、价格及部署条件。
4. 兼容不同Agent Harness。
LongCat-2.5适配:
• Claude Code。 • Codex。 • Hermes。 • 其他兼容的Agent执行框架。
为什么强调Harness兼容?
同一模型可以接入不同的Agent系统。
例如:
开发者已经在Codex类环境中建立了文件管理、代码执行和测试工作流。
如果模型能够兼容相应框架,就不必重新设计全部执行流程。
开放状态
LongCat-2.5已于11月2日进入正式API服务。
但:
API正式上线不代表模型完整权重已开放。
需要根据官方最新公告确认权重和许可证情况。
🌟官方介绍:
https://longcat.ai/blog/longcat-2.5/
🌟API更新日志:
https://longcat.ai/platform/docs/ChangeLog.html
🌟价格说明:
https://longcat.chat/platform/docs/pricing/longcat-2.5
GPT-6 Rosalind Research:OpenAI推出生命科学专用模型,研究权限独立审批
OpenAI正式推出:
GPT-6 Rosalind Research。
这是GPT-Rosalind生命科学模型系列的新版本,主要面向:
药物研发、生物学研究和专业科学工作流。
与GPT-6 Astra的关系
OpenAI安全报告确认:
GPT-6 Rosalind Research与GPT-6 Astra使用相同模型权重。
此次没有为Rosalind额外进行新一轮模型训练。
区别主要来自:
访问控制、部署规则、科学工具和安全机制。
核心能力
1. 生物数据分析。
可辅助处理基因组、测序及其他生命科学研究数据。
2. 蛋白质和序列研究。
帮助研究人员分析蛋白质与生物序列信息。
3. 药物发现。
支持科学文献整理、候选靶点研究和药物化学相关分析。
4. 实验规划。
协助研究人员组织实验流程、整理实验结果及分析失败原因。
5. 科学工具调用。
可通过相关插件连接研究数据库、科学工具和内部系统。
访问范围
目前主要向经过审批的:
• 企业。 • 研究机构。 • 大学实验室。 • 部分政府研究合作方。
开放。
通过审批的机构可按授权范围在:
ChatGPT Work、Codex及API
中使用。
但API访问需要单独获得批准。
不同权限层级
OpenAI将Rosalind划分为:
Research和Discovery。
Research用于更前沿的生物科研任务。
Discovery主要面向常规科学工作,例如文献整理、数据分析和实验计划。
两者需要不同的访问审批。
安全限制
Rosalind仍然保留针对严重生物安全风险和恶意网络活动的保护。
OpenAI在相关系统卡中将其生物化学能力评估为High等级。
🌟OpenAI帮助中心:
https://help.openai.com/en/articles/20001193-gpt-rosalind-for-life-sciences-research
🌟系统安全报告:
https://deploymentsafety.openai.com/gpt-rosalind-6
🌟API价格:
https://developers.openai.com/api/docs/pricing?life-sciences-context-length=short
Grok 4.8延期:马斯克称不追求Benchmark,重点让模型更实用
埃隆·马斯克在X上回应有关Grok 4.8发布时间的问题。
他承认:
新版本开发耗时比预期更长。
但表示:
最终版本不会令人失望。
🌟消息地址:
https://x.com/elonmusk/status/2116036703538606301
🤖️ Agent与开发工具
OpenAI Agents API五项升级:Agent可以后台压缩、判断时间和动态更新工具
OpenAI宣布为:
Agents API
推出五项更新。
此次主要目标是:
让Agent运行更安全、更高效,并支持长期持续任务。
第一:Auto Review
命令执行前自动检查。
Agent准备运行Shell命令时,系统可以先评估操作是否存在风险。
例如:
删除文件、修改敏感配置或访问不必要的系统资源。
自动审查可以在执行前识别部分潜在问题。
但这不代表所有危险命令都能被百分之百拦截。
第二:Async Compaction
后台异步上下文压缩。
Agent执行大型任务时,会产生大量历史信息。
例如:
• 工具调用记录。 • 编程日志。 • 搜索结果。 • 文件分析。 • 错误信息。
如果全部长期保留,模型上下文会不断增加。
过去压缩过程可能影响任务执行。
新版允许:
在后台异步进行上下文压缩。
降低压缩造成的等待。
第三:Time Awareness
实验性时间感知。
模型可以更好理解:
现实中的时间正在流逝。
例如用户要求:
“最多用10分钟修复这个CI错误。”
Agent可以将时间限制纳入工作规划。
但这仍是实验性功能。
不应将其理解为模型能够保证所有任务严格在指定秒数内完成。
第四:Tool Updates
会话运行中动态修改工具。
过去某些Agent需要在Session开始前确定可用工具。
现在开发者可以在会话期间调整:
• 可用工具。 • 工具配置。 • 相应的会话工具设置。
例如Agent执行到某个阶段,需要接入新的数据服务。
开发者可以更新工具配置,而不必始终创建新会话。
第五:Prompt Cache Awareness
跨Session自动缓存系统提示词。
如果同一个Agent需要反复执行任务,系统Prompt可能高度重复。
新版会更主动复用缓存内容。
减少重复计算和输入Token成本。
五项更新总结
🌟官方动态:
https://x.com/stevendcoffey/status/2116303789649236048
🌟Agents API文档:
https://developers.openai.com/api/docs/guides/agents-api/overview
DeepSeek Super-agent:让AI长期在线的Router + Worker架构开源
DeepSeek团队发表:
Exploring Super-agent Design: Towards a More Autonomous Agent System。
文章探讨如何让Agent:
不再局限于单次会话,而是能够持续监听任务、调度工作,并在必要时主动反馈。
传统Agent的局限
一般Agent的工作方式是:
用户提出任务 → Agent执行 → 返回结果。
执行结束后,会话可能就停止了。
如果用户希望它长期关注一个项目,还需要额外的调度和状态管理。
DeepSeek提出的新架构
主要包含:
Router、Worker、Event和Watchdog。
第一:Router
Router是常驻任务入口。
负责:
• 接收用户消息。 • 识别任务类型。 • 判断授权范围。 • 分配任务。 • 汇总执行结果。
例如:
用户在飞书中说:
“帮我检查这个GitHub项目今天的Bug。”
Router接收消息后,将具体分析工作交给Worker。
第二:Worker
Worker负责实际执行。
一个Super-agent可以拥有多个独立的Worker会话。
例如:
• Worker A检查代码。 • Worker B分析测试失败。 • Worker C整理项目文档。
这些工作可以在条件允许时并行开展。
第三:事件驱动
Super-agent不需要每隔几秒机械地询问:
“有没有新任务?”
它可以监听:
• GitHub事件。 • 用户消息。 • 工具执行结果。 • 系统状态变化。
当满足条件时,再触发对应处理流程。
第四:Watchdog
Watchdog负责监控长期运行任务。
例如:
某个Worker异常停止。
系统可以记录失败状态,或者根据规则安排恢复。
这有助于降低长期Agent执行中任务中断的风险。
跨会话上下文
Super-agent希望将任务状态保存在会话之外。
例如:
项目目标、任务进度、工作目录和历史交付结果。
这样即使单个Worker结束,后续仍可以继续执行相关任务。
已开源什么?
DeepSeek公开:
dsh-superagent-prototype。
这是一个面向单个GitHub仓库的主动式编程Agent研究原型。
支持:
• GitHub事件监听。 • 可选飞书消息入口。 • 独立任务会话。 • 任务分配。 • 代码仓库工作目录。 • Pull Request结果交付。 • Web任务管理面板。
重要限制
DeepSeek明确表示:
这是研究参考代码,不是正式商业产品。
并且:
公开代码与内部版本并不完全一致,文章中部分未来架构设想也尚未在原型中实现。
开发者不应未经审查就直接用于生产环境。
🌟官方文章:
Super-agent 设计探索:迈向更自主的 Agent 系统
🌟GitHub:
https://github.com/deepseek-ai/dsh-superagent-prototype
ChatGPT与Codex将在12月共享额度,Chat和Work逐步融合
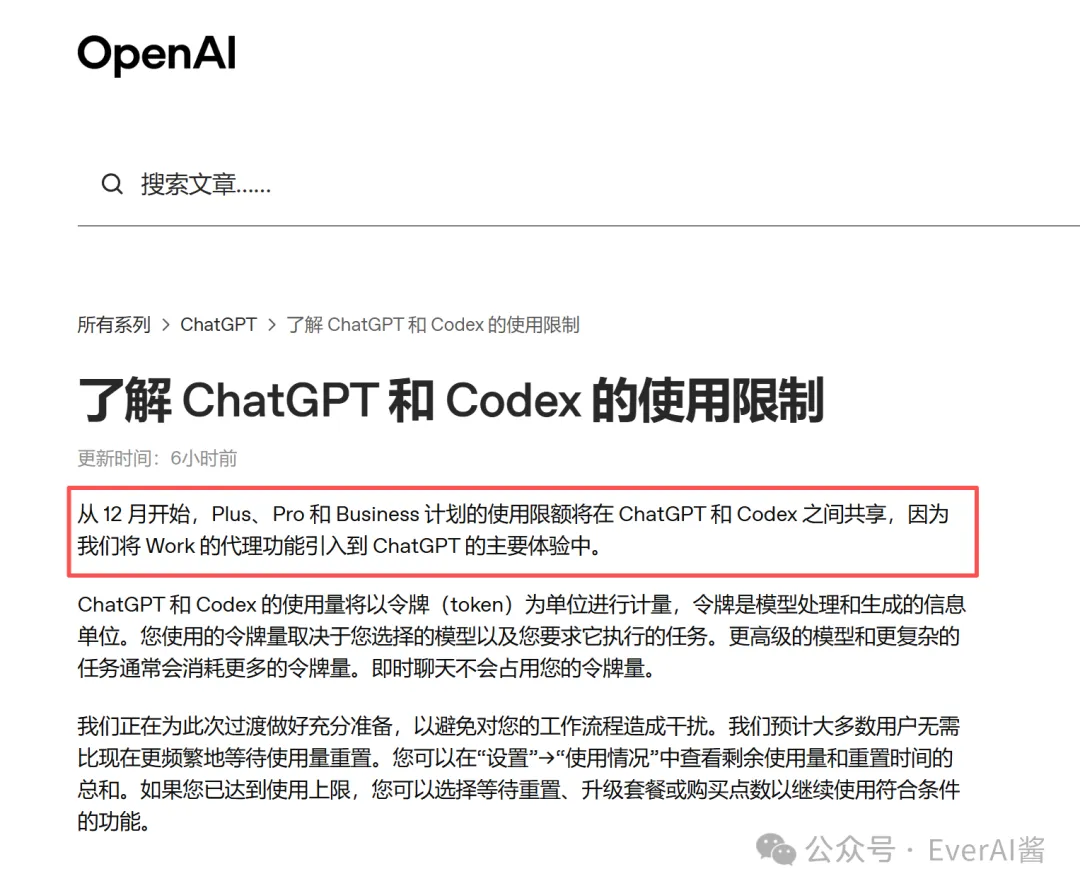
OpenAI帮助中心公布:
2026年12月起,将调整ChatGPT和Codex的使用额度计算方式。
这与近期ChatGPT团队提到的Chat和Work融合计划有关。
影响哪些套餐?
主要包括:
• Plus。 • Pro。 • Business。
当前如何计算?
目前:
ChatGPT Work与Codex
已经采用共享使用额度。
但普通Chat环节的用量计算方式不同。
12月将发生什么?
OpenAI计划:
将Work的Agent能力融入ChatGPT主聊天体验。
同时:
ChatGPT与Codex共享统一的Token额度。
什么是按Token计费的额度?
模型处理和生成信息时,会消耗Token。
通常:
输入越多、输出越长、模型越强、任务越复杂,消耗额度也越多。
不同模型可能有不同的额度消耗规则。
Instant聊天怎么办?
OpenAI明确说明:
Instant聊天不会消耗这部分共享额度。
所以不能将新政策理解为:
“以后普通聊天每说一句话都会扣除Codex额度。”
用户如何查看额度?
计划实施后,可以在:
Settings → Usage
查看:
• 剩余额度。 • 额度重置时间。 • ChatGPT与Codex合并后的使用情况。
超出额度怎么办?
用户可以:
• 等待额度恢复。 • 升级套餐。 • 购买符合条件的额外额度。
🌟OpenAI官方说明:
https://help.openai.com/en/articles/20001625-understanding-chatgpt-and-codex-usage-limits
ChatGPT支持双账号切换,Codex改进计划进入最后阶段
OpenAI为ChatGPT增加:
多账号切换功能。
最多同时登录两个账号
用户可以在同一客户端中保持两个ChatGPT账号登录。
切换时不需要反复退出和输入密码。
适合:
• 个人账号。 • 工作账号。 • 不同订阅账户。
账号数据不会合并
即使同时登录两个账号:
聊天记录、记忆、文件、工作区和订阅仍然独立。
例如:
个人账号中的文件,不会自动出现在另一个账号中。
订阅额度也不会相互共享。
支持平台
功能支持:
• ChatGPT网页端。 • iOS。 • Android。
移动端正在分批推送。
Codex额度重置活动
Tibo还表示:
28天Codex改进计划进入最后两天。
活动最后阶段会提供额外的额度重置机会。
相关重置次数可以保留到后续使用。
但具体领取资格、数量和有效规则,仍以对应账户实际显示为准。
行业意义
账号切换虽然是相对简单的功能,却有助于区分:
个人使用与企业工作。
特别是ChatGPT逐渐承担更多真实工作任务后,账号与数据边界变得更加重要。
🌟官方动态:
https://x.com/thsottiaux/status/2116405414921384099
🌟ChatGPT账号切换说明:
https://help.openai.com/en/articles/20001068-using-multiple-chatgpt-accounts-on-web-and-mobile
🏭 行业信息
Claude Max改名Ultra:200美元套餐取消五小时限制,但周额度不变
Anthropic宣布调整Claude个人高级订阅方案。
新旧套餐对照
价格保持不变。
现有订阅用户不需要主动迁移。
最大变化
已验证Ultra账户将不再受到五小时使用限制。
过去即使用户本周还有剩余额度,也可能因为连续五小时内使用过多而暂时受限。
新规则允许已验证的Ultra用户:
在每周额度允许的范围内,更灵活地集中使用模型。
例如:
用户可以连续数小时完成大型Coding Agent项目。
不必因为五小时窗口先用完而立即停止。
周额度没有取消
需要特别注意:
取消五小时限制,不代表变成真正无限量使用。
官方表示:
Ultra每周额度仍为Pro套餐的10倍。
此外还可能存在其他模型或功能级使用限制。
什么是已验证账号?
Anthropic根据:
• 账户历史。 • 支付记录。 • 风险控制信息。
自动判断账户是否符合条件。
新账号在完成验证前,仍可能受到临时的五小时限制。
🌟Anthropic官方说明:
https://support.claude.com/en/articles/17728952-what-is-the-ultra-plan
🌟官方动态:
https://x.com/claudeai/status/2116220869479428500
Grok Bot成本压力:马斯克称运营成本相对于收入过高
近日有用户在X上向马斯克询问:
Grok Bot的使用额度是否会重置。
该用户表示,不少人反映最近一周的额度很快用完。
马斯克如何回应?
马斯克称:
提供Grok Bot服务的成本相对于其收入过高,难以持续。
🌟消息地址:
https://x.com/elonmusk/status/2116992258520064397
🛡️ 其他
OpenAI Private Intelligence:企业敏感数据保护升级,Agent权限可以明确设定
OpenAI正式介绍:
Private Intelligence。
这是面向企业敏感工作的隐私、安全和Agent控制方案。
核心目标
让企业能够在使用前沿AI的同时,更严格地控制:
数据访问、数据留存和Agent执行权限。
第一:Zero Data Retention
简称:
ZDR。
对于符合条件的API工作流,OpenAI提供零数据留存选项。
这意味着:
处理完成后,不保留相关请求提示词和模型回复内容。
但需要注意:
这是一项特定API工作流中的数据处理安排。
并不代表所有OpenAI产品、所有日志和所有服务都默认零留存。
第二:Private Inference
目前处于:
Preview。
即预览阶段。
主要结合:
Confidential Computing。
即机密计算技术。
通过更严格的计算环境控制,减少模型处理敏感数据时的暴露风险。
第三:Agent权限控制
企业可以预先设定:
• Agent能够访问哪些数据。 • 可以调用哪些工具。 • 可以执行什么操作。 • 哪些动作需要人工审批。
例如:
企业可以允许Agent:
读取财务报告并生成分析。
但不允许它:
直接修改财务系统中的付款信息。
第四:企业安全保护
OpenAI还强调:
• 数据加密。 • 身份和访问控制。 • 威胁检测。 • 合规审计。 • 企业数据所有权。
🌟OpenAI官方介绍:
https://openai.com/business/private-intelligence
Claude Code限制复制特定游戏:原创游戏仍可正常开发
Anthropic技术团队成员Addy Osmani确认:
Claude Code的Opus 5.5提示词新增了两条游戏开发规则。
主要目的是:
避免帮助用户直接复刻他人的特定游戏作品。
哪些任务可能受到限制?
例如:
“完整复刻某款现有游戏,所有玩法、关卡、角色和视觉设计保持一致。”
即使用户将项目重新命名,也可能触发限制。
哪些游戏仍然允许制作?
Anthropic明确表示:
原创游戏。
某一游戏类型的作品。
根据用户自己的设计和素材制作的游戏。
都应该继续获得支持。
两者有什么区别?
例如:
“制作一款横版平台跳跃游戏。”
属于常见游戏类型创作。
但:
“完整复刻另一家工作室的特定作品。”
可能涉及对具体知识产权的复制。
为什么新增规则?
随着Coding Agent越来越擅长软件重建,部分开发者担心:
AI可以快速复制刚公开试玩的游戏。
Anthropic认为,需要在支持合法游戏开发与减少知识产权侵权风险之间保持平衡。
当前仍存在的问题
规则可能误判合法开发需求。
例如:
• 用户正在重建自己的旧作品。 • 用户拥有相关授权。 • 游戏已经采用允许复用的开源许可证。
Anthropic表示会继续优化相关提示规则。
🌟Anthropic团队回应:
https://x.com/addyosmani/status/2116213240363729013
🌟相关讨论:
https://x.com/chasmmmmmmmmmmm/status/2116062991686721968
Grok API新增不可见水印,11月7日起部分模型默认启用
SpaceXSI公布:
Output Watermarking。
即:
文本输出水印机制。
从2026年11月7日起,部分Grok模型的API文本输出将默认包含不可见水印。
什么是不可见水印?
它不是普通用户能够直接看到的文字标签。
而是在生成文本中嵌入特定的统计或技术信号。
用于帮助服务商后续判断:
某段文本是否由支持水印的模型生成。
首批支持哪些模型?
官方文档列出:
• Grok 4.7。 • Grok 4.6。 • Grok 4.5。
具体模型范围可能继续调整。
使用者需要修改API吗?
不需要。
水印默认在模型文本输出过程中添加。
开发者无需额外传入请求参数。
是否可以关闭?
可以。
团队管理员可以在控制台按照模型管理水印设置。
但:
部分模型属于锁定配置,可能不允许关闭。
开放时间
官方计划:
2026年11月7日正式默认启用。
🌟官方文档:
https://docs.x.ai/developers/advanced-api-usage/watermarking
内容由AI整理生成,存在错误可能,仅供参考阅读