ARTICLE · 1297650
把一本书发给AI,它真的读完了吗?
优尼把一部推理小说传给了AI。
进度条跑完。文件旁边亮起一个绿勾。
他问:“凶手是谁?”
答案来得很快。人物关系清清楚楚,作案动机有理有据。连结尾都像书评:“这也是人性复杂性的体现。”
优尼差点鼓掌。
直到他翻到最后一章:被指认的那个人,案发前三天已经出国了。
这个故事是虚构的,也不是某款产品的实测。但问题很真实:上传成功,究竟说明文件收到了,还是整本书已经读懂了?
图说:虚构阅读场景。收到文件、找到证据和正确回答,需要分别检查。
01先问一句 它是怎么拿到这本书的
我们说一个人“读过”,通常知道是什么意思。
换成AI,这句话可能指三件不同的事。
第一种,是训练时接触过相关内容。
训练会调整模型的参数。参数可以粗略理解为参与计算的一大批数值,它们共同影响模型怎样处理输入、生成答案。
书中的信息可能在这个过程中留下影响。但这不意味着,模型体内存着一本随时能按页码打开的原书。
它说得出名著情节,也可能答错细节。不同译本、删改版,更容易混在一起。
第二种,是这次把书放进了上下文。
上下文,就是模型这次计算可以利用的输入内容。可以把它想成临时工作桌。
文字通常要先转成词元,也就是模型处理文本的单位。一个词元可能是一段词、一个字,或其他文本片段,不固定等于一个汉字。
桌面有容量,通常按词元计。桌子更大,能摆的内容更多;摆上去,却不保证每个细节都用对。
第三种,是系统先查书,再把相关片段交给模型。
书被整理、建立索引。你提问后,系统找出看起来相关的内容,再据此回答。这叫检索增强生成,常简称RAG。
它像有位图书管理员帮忙找材料。可如果管理员只送来第二章,答案又需要第九章,材料就没凑齐。
真实产品可能组合这些办法。仅凭界面上一个绿勾,判断不了内部走了哪条路。
上传一本书,通常也不等于把它永久训练进了模型。
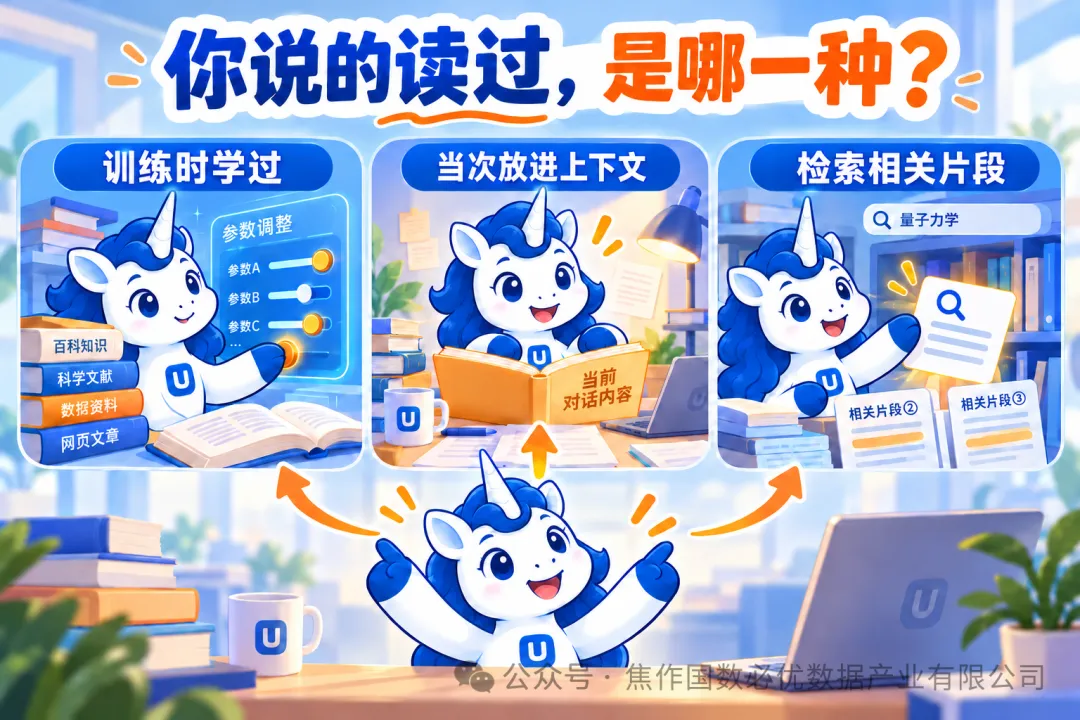
图说:三种路径可组合使用,不能把“文件已保存”当成“每次回答都看到了全书”。
02书还没读 小字可能先丢了
优尼不服:“我传的是完整版,总不会少页吧?”
文件完整,不代表模型收到的表示也完整。
PDF可能含有能直接提取的文字,也可能主要是一张张扫描图片。系统可能读取文字层、用OCR识别图片里的字,或让视觉模型处理页面。
OCR就是把图片中的文字识别出来。比如把拍下来的书页,转成可以搜索的文本。
麻烦藏在细节里。
双栏排版可能被串行。表格的数字可能还在,列标题却错位了。正文写着“全年开放”,页脚还有一颗不起眼的星号:“仅限工作日。”
星号被漏掉,答案就可能从阅读理解变成热情误导。
所以,AI读书出错,不一定是最后推理那一步出了问题。它也可能一开始就拿到了不完整的材料。
2026年10月的一篇文档问答预印本,专门区分了“找到页面”和“用好页面上的证据”。在它的实验条件下,补充提取出的文本能改善部分文字题,但图表题未必受益。
这提醒我们:找到正确页面,还要看系统能不能读出、用对其中的信息。这项研究不等于所有阅读产品的统一成绩单。
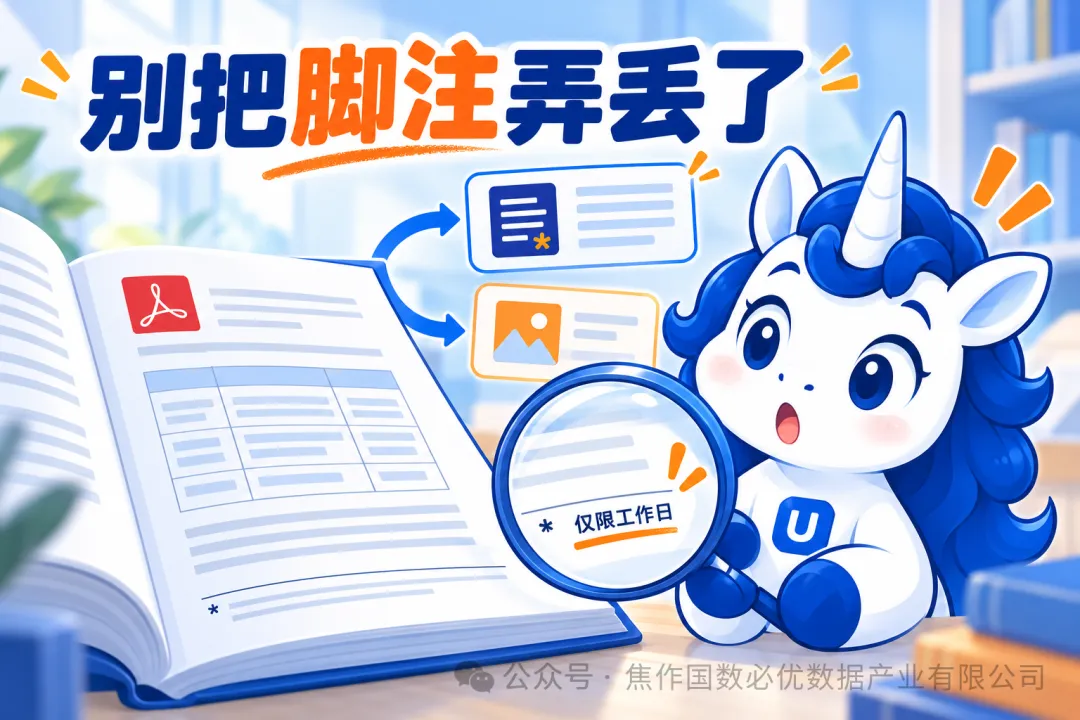
图说:图中是教学示例。文字、表格、脚注和图片,需要保留彼此的关系。
03找到一句话 为什么还会答错
优尼换了一道题:“书里的博物馆,那天下午能进去吗?”
假设一本虚构小说里,第二章写:“博物馆周一闭馆。”
第九章写:“那天正好是周一。”
回答这个问题,需要把两条信息连起来。如果只找到“下午五点关门”,就可能得出一个听起来很合理的错误答案。
这也是切块检索的难处。
为了方便搜索,系统常把长书拆成小段。段太小,条件和结论容易分家;段太大,又可能夹进很多无关内容。
还可能漏掉代词指的是谁、后文有没有推翻前文、叙述者是不是在撒谎。
因此,读书能力不能只考“找一句原话”。还得考跨章关系、时间顺序、不同版本,以及原文根本没有给出答案的情况。
已有长上下文评测也会把检索、信息汇总和多步问答分开考。一个任务做得好,不能直接兑换成“任何书都读懂”。
优尼懂了:“把证据放上桌,只是开庭。还没判完案。”
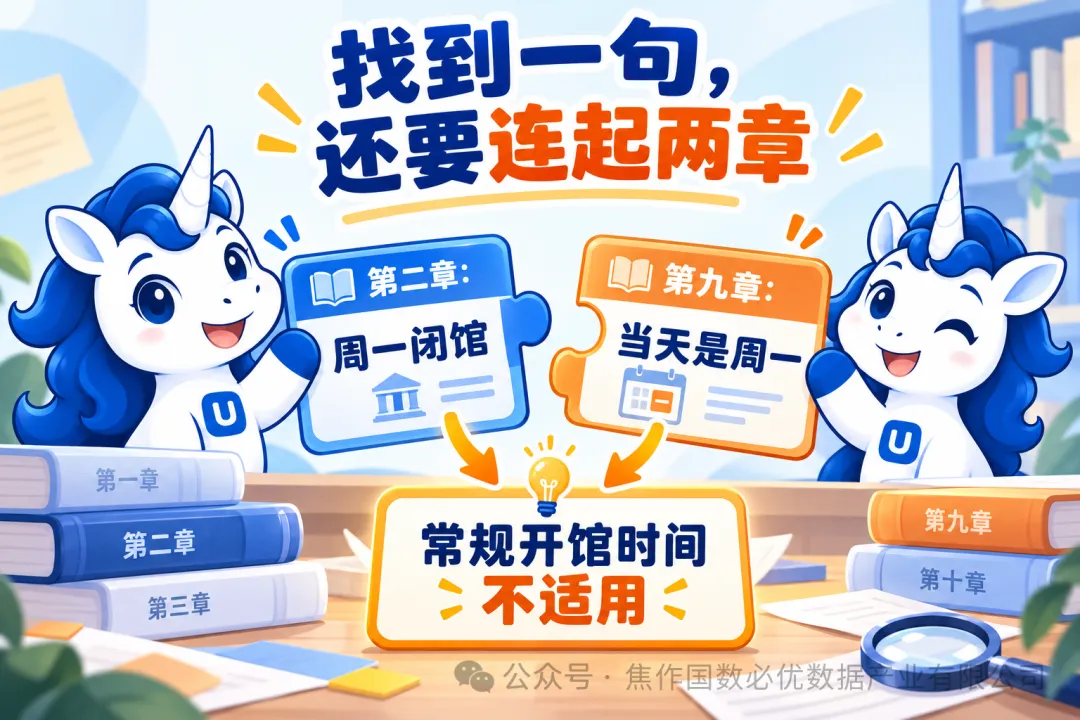
图说:虚构文本示例。结论依赖两章信息,不是只找到营业时间就能回答。
04怎么看出它在帮你读 还是帮你猜
先别急着出最难的题。可以从三步开始。
第一步,让它指出原文。
不要只问“结论是什么”。再问:“依据在第几章、哪个小节?请给出一小段能核对的原文。”
页码可能因版本或PDF页序而不同。章节、段落和短引文放在一起,更容易回查。
但引用标记也可能指错地方。有出处,不等于出处支持结论。重要内容仍要打开原文看。
第二步,追问前后条件。
“这句话适用于什么情况?后文有没有例外?另一章有没有相反说法?”
别让一段局部材料,被包装成全书态度。
第三步,给它留一条不知道的路。
比如:“只依据我提供的书。没有写到的,请明确说没有写到。你的推测要另行标出。”
这类要求不能保证不出错,但能把任务边界说清楚,也方便你检查答案。
想认真比较不同工具,可以用自己写的短材料,放进一个细节题、一个跨章题、一个无答案题。事先把标准答案和证据位置记下来。
再试试直接给它必要原文。如果这时能答对,原来的失败可能与材料获取有关;如果仍答错,还要检查理解或推理。
看不到内部记录时,这只能帮助缩小原因,不能冒充已经查明系统故障。
这是一套可尝试的检验办法。本文没有拿它对商业产品做排名。
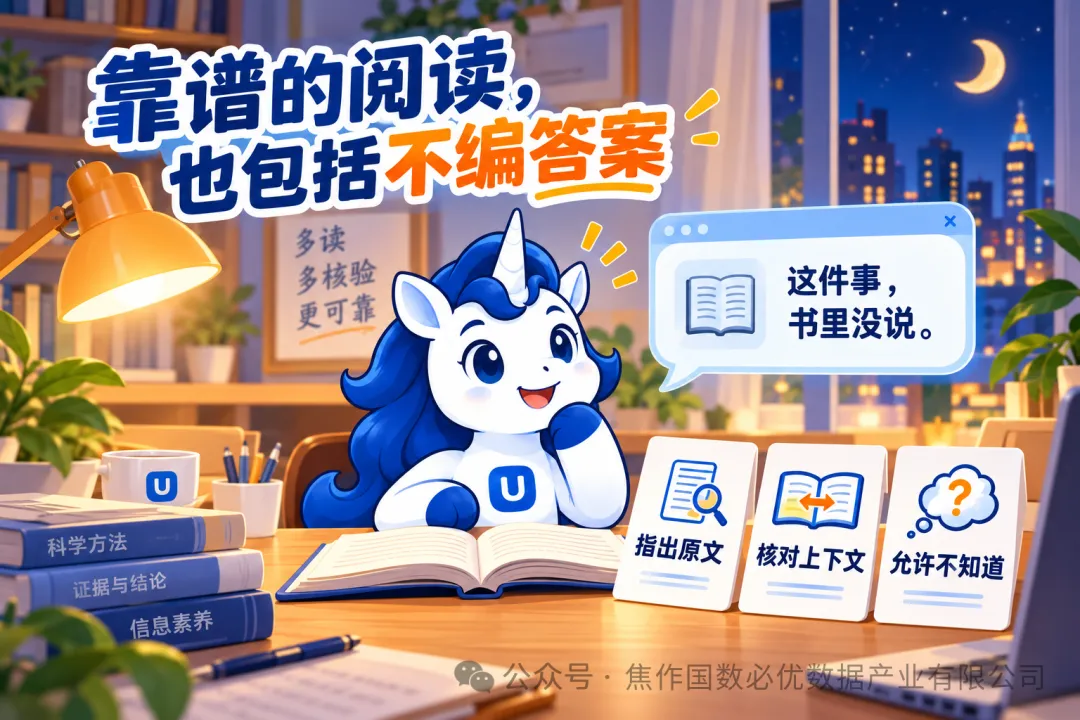
图说:查证不是让AI重复保证“我读完了”,而是检查答案与材料的关系。
05未来的读书搭子 应该比谁更靠谱
更大的上下文,当然有用。
但我们真正需要的,还包括:扫描页读得清,脚注不丢;相关章节找得全,证据能回查;材料互相矛盾时,愿意把矛盾摆出来。
长书处理还会花时间和计算资源。反复读全书、先检索再细读、保存笔记,各有成本与遗漏风险,没有一个按钮适合所有书。
涉及未公开稿件或私人资料,上传前也要确认服务如何保存和使用文件。
对读者而言,最值得保留的主动权,是能够随时问:“你这句话,到底根据什么?”
故事最后,优尼把问题改了。
“先别替我宣布凶手。帮我整理每个人案发当天的时间线,逐条标出依据。对不上的地方,单独列出来。”
这回,AI终于不再急着总结人性。
优尼也重新打开了书。
一个好的读书搭子,能帮你更快接近原文,也应该让你更容易发现它哪里读错了。
焦作国数必优数据产业有限公司
焦作国数必优数据产业有限公司由焦作市国有资本运营集团与河南必优标新科技联合组建,是国有控股混合所有制企业,也是焦作市河南省省级数据标注基地的单一运营主体。公司已形成焦作、新乡、商丘、太原多基地协同运营格局,员工规模超过1000人。
公司业务覆盖数据采集、清洗、标注、质量检验、安全交付及价值应用等环节,重点服务自动驾驶、大模型训练、智慧城市、新零售等领域;同时持续完善数据标注工程师培训体系,为地方数字人才培养和就业增收提供支撑。