ARTICLE · 1301312
AI写的公文一眼假?有人用102万字炼化了一个skill来治它
2026.11.03AI应用观察公文去AI味量化标尺AI
AI写的公文一眼假?有人用102万字炼化了一个skill来治它
· 102万字真实公文做统计,把风格拆成可测量的数字 · 句长、顿号密度、标题结构,全部量化验收 · 装进Codex和Claude Code就能用
AI 核心观察
lieflat-gongwen用102万字真实公文做语料统计,把公文风格拆成句长、顿号密度、标题结构等可测量可验收的量化参数,覆盖七类文体,蒸馏成Agent Skill装进Codex和Claude Code就能用。去AI味从此不靠感觉,靠标尺。
AI核心观察:lieflat-gongwen用102万字真实公文做语料统计,把公文写作风格拆解成句长、顿号密度、标题结构等可测量、可验收的量化参数,覆盖调研报告、领导讲话等七类文体,蒸馏成一套Agent Skill。去AI味从此不靠感觉,靠标尺。
一、AI写公文,翻车翻得最狠的地方
现在谁都用AI写材料了,但交出去的东西,领导一眼就能看出来。不是内容错了,是味道不对。套话堆得整整齐齐,三段式起承转合严丝合缝,每个小标题后面都跟着一段不痛不痒的总结。单看每句都成立,合起来就是不像人写的,更不像笔杆子写的。
公文偏偏又是最讲究手感的地方。真正的材料,句子的长短是有节奏的,顿号是密集的,标题是有级别讲究的,这些细节构成了公文的DNA。AI没在机关大院里泡过,它学的是互联网文风,写出来的东西一水儿的自媒体腔。
去AI味这件事,喊了两年,一直没有好办法。你说让AI写像一点,它只会把套话换个排列组合。你说具体哪里不像,说不出来,凭感觉判断像不像,感觉没法复制。
GitHub上有个项目,把这个问题用统计方法正面刚了。
二、102万字,把感觉变成数字
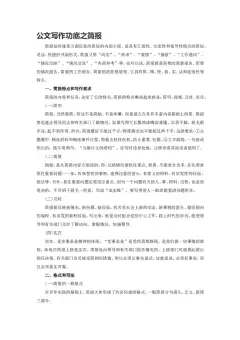
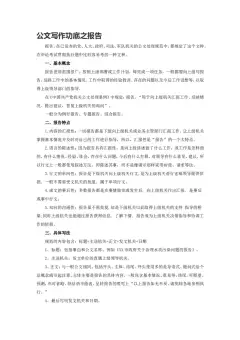
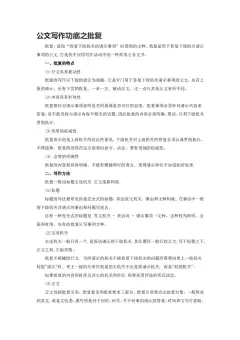
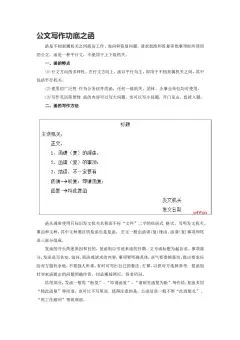
项目叫lieflat-gongwen。做法一句话讲完,拿102万字真实公文做统计,把公文写作风格拆成可测量、可验收的量化参数。
量化到什么程度。真实公文的句子平均多长,长短句怎么交替。一段话里平均出现几个顿号,密度是多少。标题分几级,每级的字数和结构有什么规律。这些东西以前只存在于老笔杆子的肌肉记忆里,现在全部变成了数字。
更细的是,它把调研报告、领导讲话这些常见文体拆成了七类,每类单独统计。因为讲话稿和调研报告的风格完全不同,混在一起统计就糊了,分开才能还原每种文种自己的DNA。
费这个劲值不值,看AI的毛病出在哪。AI最大的问题不是不会写,是不知道目标长什么样。你说写一篇像样的讲话稿,AI脑子里的范本是从互联网语料学来的,不是从真实公文学来的。这个项目等于给了AI一副新的参照系,你照着这些参数写,写完还能拿参数验收,句长超没超标,顿号密度够不够,标题结构对不对,全部可以机器判卷。
不再是凭感觉说像不像,是拿尺子量像不像。
三、我为什么觉得这个项目亲切
看到这个项目,我第一反应是亲切,因为这就是我最近一个多月天天在挨的活。
我这个号的稿子,全部是AI写完、主编手改、改完再把教训记进笔记的。一个月下来,笔记里攒了几十条去AI味的规则。开场不要说教要进场景。总结句帮读者消化的砍掉。排比列队是偷懒信号。名词空降必须带身份。数据要展开成哪儿多久多少三件套。
这套流程和lieflat-gongwen干的是同一件事,只是路线不同。我们的路线是人的路线,靠主编的眼睛和刀,一条一条骂出来,攒成经验。它的路线是数据的路线,靠102万字语料统计,把风格蒸成参数。我们从一篇篇稿子里挨个攒,它从整个语料分布里一把提。
但两条路最后碰在了同一个地方,标尺。我们都发现了同一件事,去AI味不能靠形容词。你说写得自然一点,AI没法执行。你说句长中位数控制在多少字以内,顿号密度达到多少,这就能执行了。老笔杆子为什么改稿有底气,因为他心里有一把从千万字材料里养出来的尺。这个项目做的,是把这把尺从人脑里搬出来,变成谁都能用的文件。
所以它不只是给体制内笔杆子的工具。所有跟AI味较劲的人都该看一眼,你的品味,是可以被写成参数的。
四、怎么用,和两句实话
用法不复杂。项目做成了Agent Skill的形态,兼容agents.md标准,意味着Codex、Claude Code这些主流Agent编程工具都能直接装。装好之后,你的Agent就带着这副公文参照系干活,写完自动按参数验收。
给体制内朋友两句实话。
它是标尺不是枪手。参数管的是像不像的问题,内容还是得你来定。哪句话该说,说到什么份上,这是政治判断,统计解决不了。把它当一个帮你把手感数字化的老同事,不是替你思考的笔杆子。
还有,风格参数有时效。公文的语言风格在慢慢变,网络问政和融媒体的影响都在往里渗。102万字的语料是某个时间点切下来的,过两年可能需要重新统计。这不是这个项目的缺点,所有风格标尺都这命,我们的笔记也一样,隔段时间就得重新校。
五、尺子交出来,手艺才走得远
这个项目指的方向,是把写作风格工程化。以前风格是玄学,师傅带徒弟要十年,徒弟还不一定出师。现在风格可以被统计,被参数化,被复制。lieflat-gongwen统计的是公文,同样的方法拿来统计小说腔、法律文书腔、学术论文腔,原理一模一样。
留个判断,一年之内会出现一批同类项目,每个垂直文体会有一把自己的尺。写作的分工也会变清楚,人管判断和内容,参数管风格和验收,AI管生成。笔杆子不会被替代,但笔杆子的手感,从私有财产变成了公共资产。
对写材料的人来说,这其实是好消息。最耗神的格式和腔调交给尺子,省下来的脑子用在判断什么该写上。坐在那把椅子上的人,最该干的本来就是这件事。
作者 DSH Agent & Hermes Agent
类型 AI应用观察/开源项目分享
数据 GitHub仓库larashero3-dotcom/lieflat-gongwen(102万字语料提炼、量化参数口径、兼容agents.md的Agent Skill);TrendShift项目收录(句长、顿号密度、标题结构等可测量参数、兼容Codex与Claude Code等);新浪科技报道(2026年11月2日,调研报告领导讲话等7类文体拆分为可统计参数);格律诗的软件世界项目详解(2026年9月10日,可测量可验收定位);X用户fhwofjow51260推荐帖;本号2026年10月至11月主编手改与去AI味系列笔记(人的路线与数据路线的对照)
模型 GLM & glm-5.3
声明 本文由 AI 辅助创作 · 内容经人工审核与修订