ARTICLE · 1302697
AI 越快,人越懒思考|斯坦福学习法,帮你守住独立思考
AI 越快,人越懒思考|斯坦福学习法,帮你守住独立思考注:本文系由AI技术辅助创作完成,旨在探讨人工智能领域的前沿问题与发展方向。图片由midjourney,comful ui,即梦,GPT-image2,nano banana,seedream, Trea work,workbuddy,DSH,codex等生成 你付着Codex,claud高级会员的钱,却只用了它十分之一的功力。 打开对话框,敲一句"帮我讲讲XX",“帮我做个XX的任务”AI 唰唰吐出一段,你扫两眼,觉得"嗯,懂了",关掉页面。下次遇到问题,再来一遍。 这套动作我们重复了三年。熟练得像呼吸,也廉价得像呼吸。 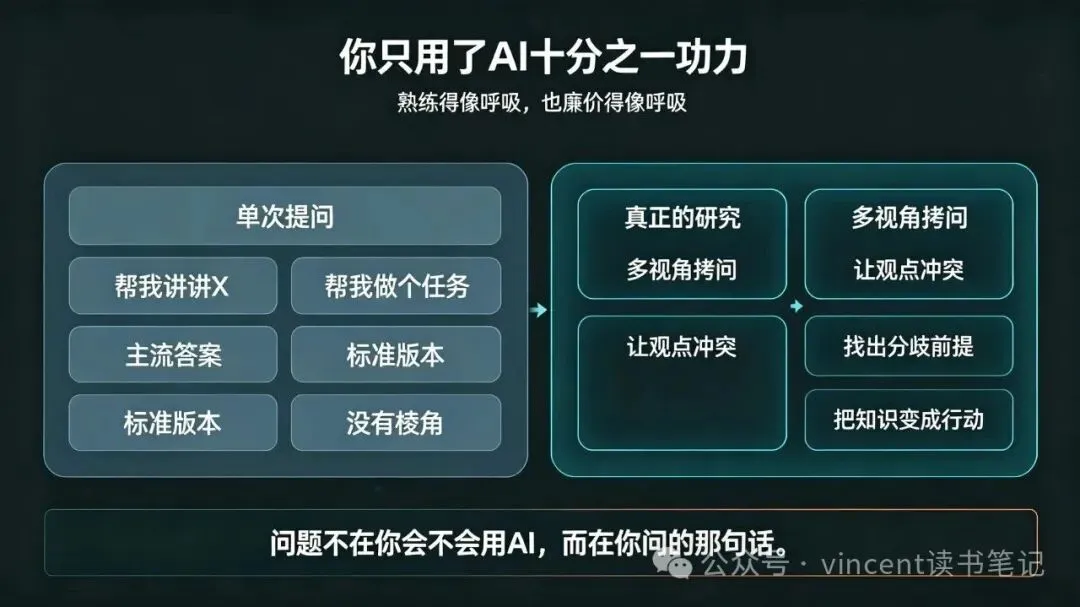
问题出在你问的那句话上。当你问"给我讲讲X",AI 给你的,是这个世界上关于 X 最主流、最标准、最没有棱角的版本。 它不会告诉你:每天亲手干这活的人,知道哪些书上永远不写的门道;觉得主流全错了的人,手里攥着什么反驳证据;跟着钱走的人,看到谁在闷声发财;见过历史轮回的人,知道这套剧本几十年前演过一遍,结局如何。 一个真正的博士做研究,从来不是只问一个问题。他会站在五六个完全不同的人的位置上,把同一件事翻来覆去地拷问。 这就是斯坦福大学 OVAL 实验室那套叫 STORM 的方法的核心。它 2024 年 6 月发表在国际顶会 NAACL 上,全称是"通过检索和多视角提问来合成主题大纲",GitHub 上有 2.8 万颗星,MIT 协议开源,官网上还挂着研究预览版。论文里那组人类评估的结论是:用多视角提问写出来的文章,比直接生成的文章更全面、更结构化,事实覆盖度也明显更高。 而一次博士级别的资料梳理,人工要几十个小时。不是他们慢,是"从五个角度读、找出矛盾、再总结、再自我挑刺"这一整套活儿,对人脑来说本来就是个几十小时的工程。 把它压到 5 分钟,不需要装软件,不用碰代码,不用注册账号。需要的只是一套问法,和一条不肯跳步的闭环。 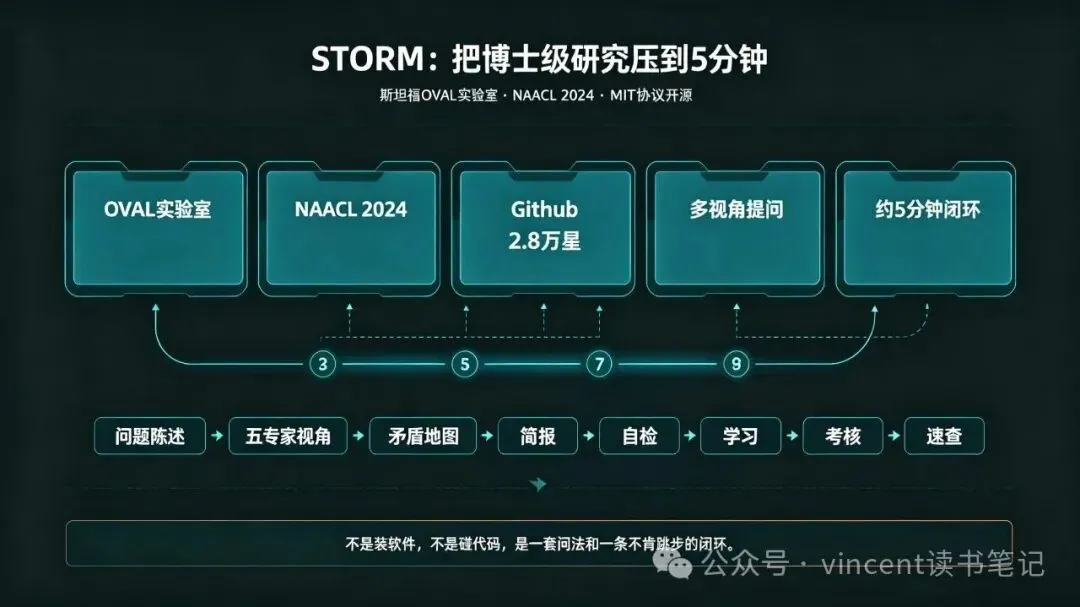
下面这条线,是完整的十步。每一步我都给你能直接复制的提示词,你换掉方括号里的内容,粘进去就能跑。 几乎所有无效学习都死在起跑线上。目标是一团雾,跑得越快,偏得越远。 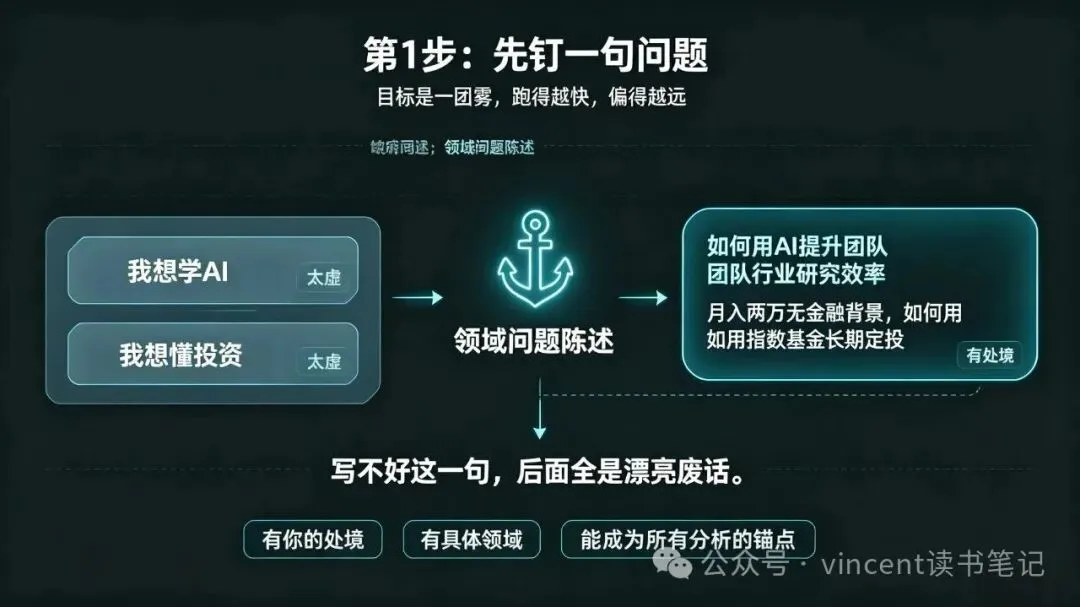
动手之前,只做一件事:写一句领域问题陈述。 不要写"我想学 AI",要写"如何用 AI 提升我团队做行业研究的效率"。不要写"我想懂投资",要写"月入两万、没有金融背景的人,如何用指数基金做长期定投"。 这句话是后面所有分析的锚点。五个专家、十步流程,全部围着它转。写不好这一句,后面全是漂亮废话。 判断标准很简单:这句话里得有你的处境。没有处境的问题,AI 只能还你一个标准答案。 关于这一步,多说一句。很多人以为问 AI 难在措辞,其实难在你得先知道自己站在哪儿。同样一个问题,从"我想学 AI"改成"我要让团队的研究效率提上来",AI 给你的东西立刻从教科书变成了工作手册。这不是提示词技巧,这是你把自己放进了问题里。 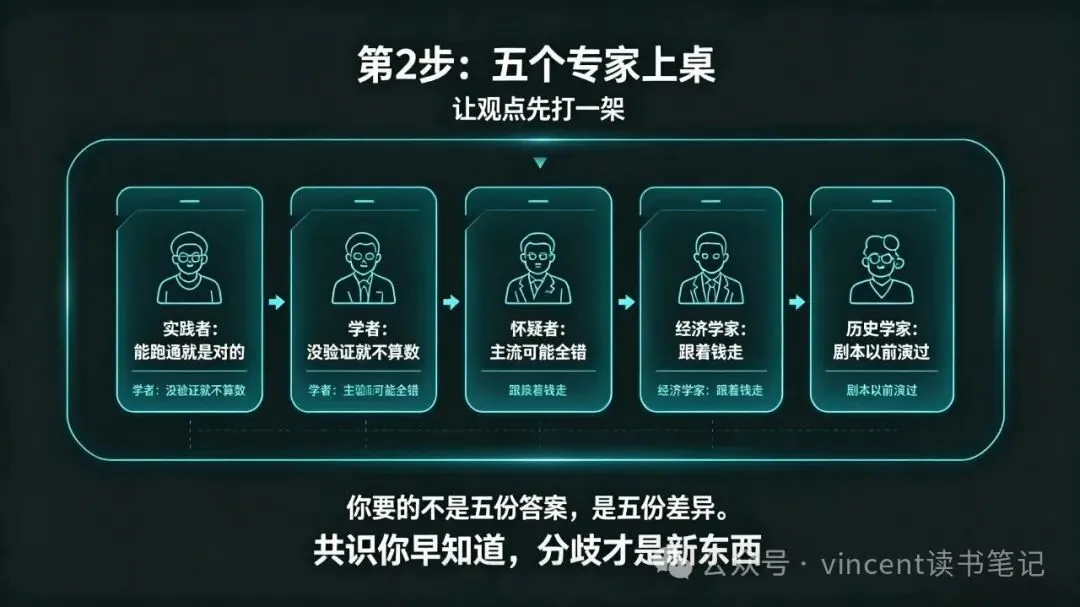
这是整套方法的心脏。复制下面这段,把【xxx】里的内容换成你第一步写的那句话。 我需要研究【你的问题】。请你模拟 5 个不同的专家视角来分析这个话题: 1. 实践者:每天亲手做这件事的人。他知道哪些学者不知道的?哪些现实里的麻烦总被忽略? 2. 学者:研究这个领域很多年的人。经过同行评审的证据真正说明了什么?证据在哪些地方跟大众认知相反? 3. 怀疑者:认为主流观点是错的人。最有力的反对意见是什么?支持者们故意回避了哪些证据? 4. 经济学家:跟着钱走的人。现在这套说法,谁从中获利?是什么样的利益在背后影响相关研究? 5. 历史学家:见过类似剧本的人。历史上有哪些相似先例?那些事最后怎么收场,能给我们什么教训? 针对每一个视角,请给我: 他的核心立场,两句话说清 支撑他观点的最有力证据 一件只有他会告诉我、其他视角绝不会提的事 发出去,你会拿到五份对同一个问题的、完全不一样的解读。 实践者告诉你学术界脱离实际的地方,怀疑者反手拆实践者的台,经济学家把大家不好意思说的利益关系摆上桌面,历史学家告诉你这事以前上演过,后来怎么收的场。 这六十秒干的活,是你问一百句"帮我讲讲X"都换不来的。 这里有个反常识的地方值得说透:你要的不是五份答案,是五份差异。单一视角永远有盲区,视角之间的差异才是学习的真正材料。五个人的共识你其实早就知道了,五个人的分歧才是新东西。 关于这一步,再说一句。真正的分歧从来不在结论上,而在每个人默认的那些前提上。实践者默认"能跑通就是对的",学者默认"没验证过就不算数",经济学家默认"跟着钱走不会错"。AI 把这五套默认摊开放在你面前的时候,你才第一次看清,自己一直站在哪一边。 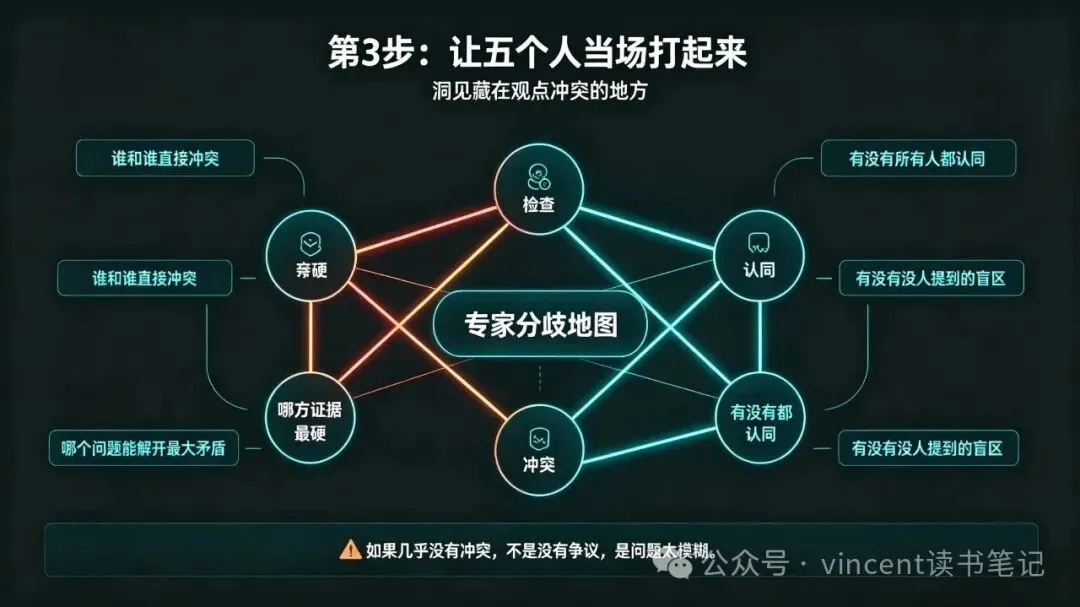
光有五份解读还不够。真正的洞见,藏在他们互相打架的地方。 接着发第二段: 基于上面 5 个视角,帮我梳理其中矛盾: 1. 哪些视角之间是直接冲突的?把每一处冲突、以及双方具体对立的主张列出来。 2. 哪个视角的证据最硬?哪个最虚?为什么? 3. 如果只能回答一个问题,回答哪个就能解开最大的那处矛盾? 4. 有没有一件事是所有视角都认同的?(这件事大概率是真的——连对手都点头了。) 5. 有没有一个角度,是五个视角里没有一个人提到的?(这就是整个领域的盲区,往往也是最值钱的发现。) 你会拿到一张"专家分歧地图":谁和谁在吵,为什么吵,哪边站得住,哪边站不住。 大多数人会跳过这一步,觉得"我都看完了还梳理啥"。恰恰是这一步,把"看个热闹的表面理解"和"真懂"分开了。 两个关键信号要盯死:五个视角都点头的,八成是真的,连对手都承认的事你可以放心用;五个人一个都没提的角度,很可能是整个领域的盲区,有时候这反而是最大的发现。 关于这一步,多说一句。吵架这件事,最怕的不是吵得凶,是吵得客气。你如果发现五个视角互相之间几乎没有冲突,那多半不是这个领域没有争议,是 AI 把它们各自磨平了棱角。这时候别往下走,回去把问题陈述写得更具体一点,重新问一遍。 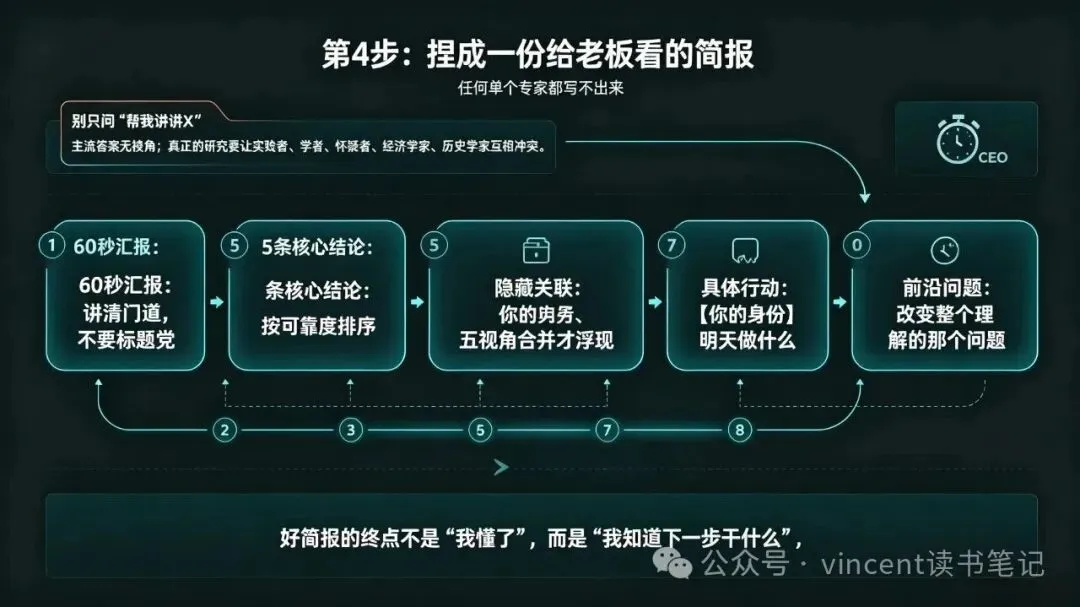
现在把前面所有东西拢到一起。 请把 5 个视角和矛盾地图里的所有内容,整合成一份研究简报: 1. 一段话总结:假设你要向一个只有 60 秒、但需要听懂门道的 CEO 汇报,你会怎么讲清这个话题?要细节,不要标题党。 2. 5 条核心结论:按"可靠程度"从高到低排。每一条注明:哪些视角支持它,哪些视角质疑它。 3. 一条隐藏的关联:只有把 5 个视角放在一起看才会浮现的那个不明显联系。 4. 一条可落地的行动:基于所有证据,一个【你的身份】具体应该做出什么不同的动作?要具体,别说空话。 5. 一个前沿问题:哪个问题一旦被回答,就会彻底改变我们对这个话题的理解? 出来的东西,任何单个专家都写不出来。它照顾到每个角度,点名了所有矛盾,给可靠度排了序,最后落到一个具体能干的动作上。 注意第 4 条。这是整份简报里唯一跟你有关的一条,也是唯一能验证你学没学会的一条。如果它给的动作你看了想"这不废话吗",说明你的第一步问题陈述写得太虚,回去重写。 关于这一步,多说一句。 一份好的简报,读完之后你该有的感觉不是"我懂了",而是"我知道下一步该干什么了"。懂是一种很轻的感觉,它能在关掉页面的三十秒内消失。而一个具体的动作,会在你明天早上坐到桌前的时候,还留在那儿。 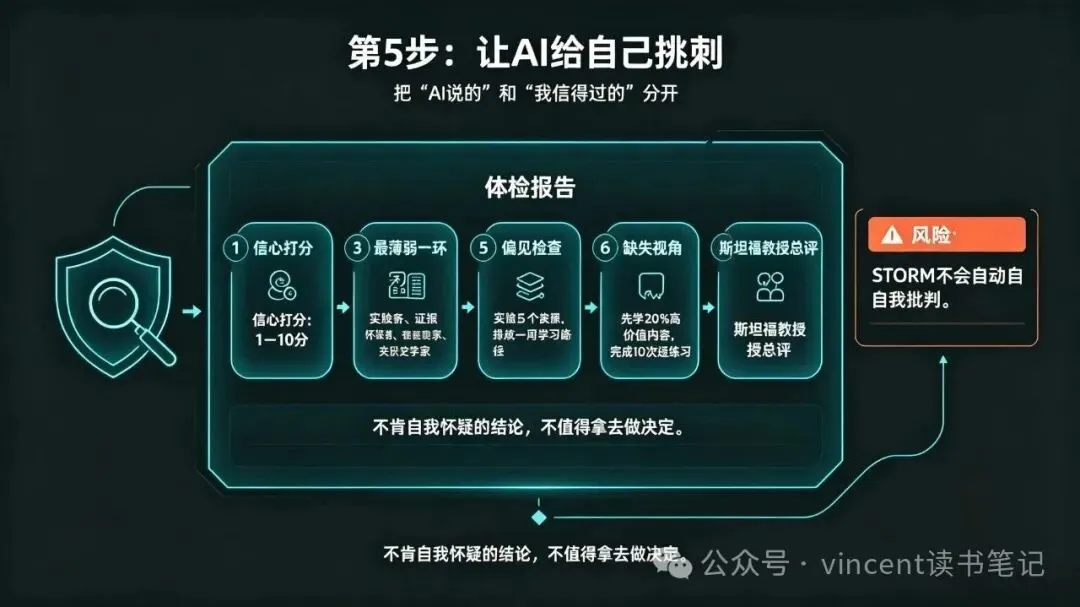
STORM 有个公认的软肋,斯坦福自己的研究员都坦白承认:它不会自我批判。来源偏见、张冠李戴的小毛病,会偷偷溜进结果里。 下面这段提示词专门补这个洞: 现在请你对刚才那份研究简报做一次"同行评审": 1. 信心打分:给 5 条核心结论分别打 1 到 10 分的可靠度,并解释每个分数为什么这么打。 2. 最薄弱的一环:哪条结论你最没把握?需要补充什么具体信息才能验证它? 3. 偏见检查:你的总结里哪个视角被过度放大了?有没有哪个声音盖过了其他人? 4. 缺失的视角:是否还有第 6 个角度,一旦加进来就会改变现有结论? 5. 总评:如果一位斯坦福教授来评这份简报,会给几分?他会让我改哪里? 这是一份诚实的体检报告:哪些结论硬,哪些虚,哪里有偏见,漏了什么角度。 真正的同行评审要熬几个月,你这一遍,六十秒。 到这里,五分钟过去了。你手里有什么?一份多视角简报、一张矛盾地图、一段六十秒总结、一个具体行动、一份可靠度评分。 但这时候你还没学会。你只是拿到了一张地图。真正十倍速部分,从下一步开始。 这一步最容易被跳过,因为它让人不舒服。你刚花五分钟攒出一份漂亮东西,转头就让人给它挑毛病,等于自己拆自己的台。但恰恰是这个动作,把"AI 说的"和"我信得过的"分开了。一个不肯自我怀疑的结论,不值得你拿它去做决定。 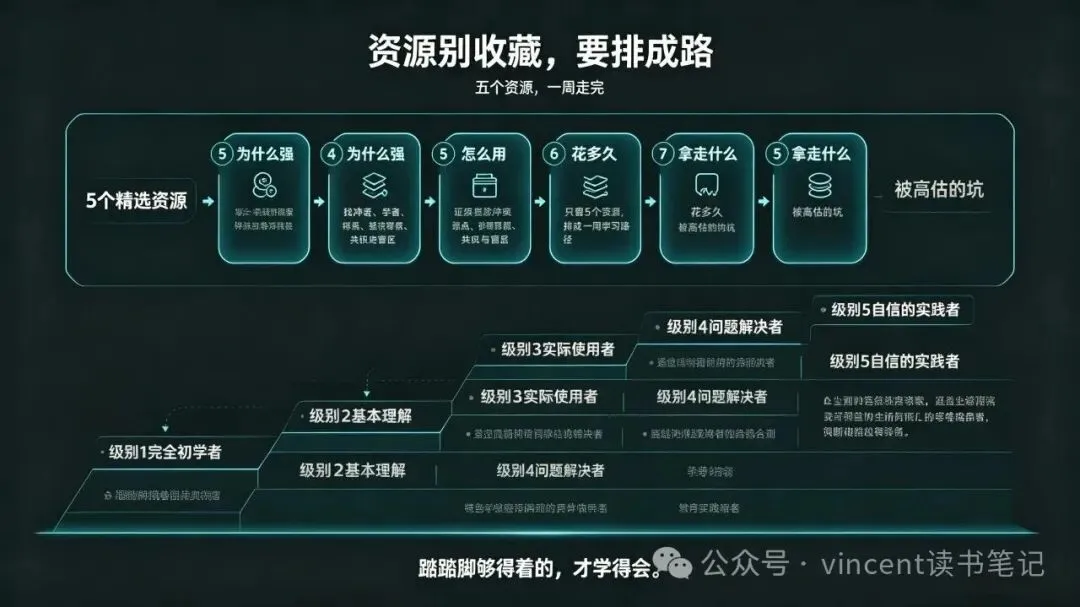
地图有了,接下来是资源。而大多数人的问题不是资源不够,是收藏夹里躺着三百个链接,一个都没打开。 关于【主题】的资源太多了,我不想再收藏了。请你当一个只帮我省时间的策展人: 选出 5 个最值得用的资源(书、视频、课程、社区都行),每个说清楚:它为什么比同类强、该怎么用(读/看/练)、大概要花多久、我该从它身上拿走的一个关键点。 再告诉我哪些是被高估的、我该躲开的坑。 最后把这 5 个排成一条一周能走完的学习路径。 五个,不多不少。超过五个你就不动了,这是人性,别跟它较劲。 收藏这个动作,本质上是在替未来的自己许一个空头承诺。你收藏的那一刻心里想的是"我以后会看",而那个"以后"永远不会来。真正管用的不是更多的资源,是一条能走完的路。 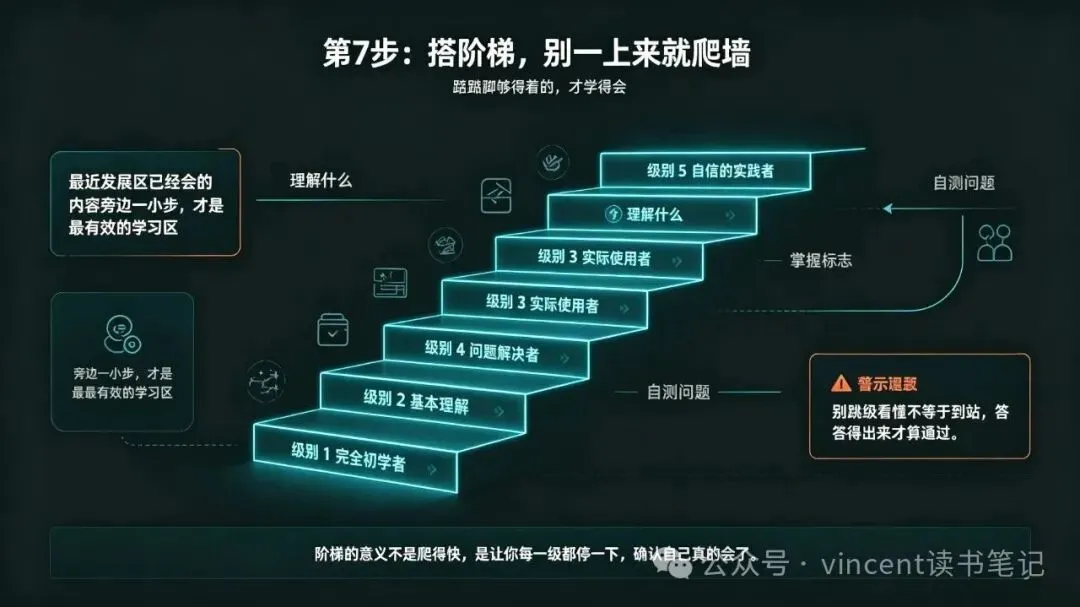
这里要插一个心理学概念,维果茨基的最近发展区:一个人能学会的东西,永远长在他已经会的东西旁边一小步。踮踮脚够得着的才学得会,隔太远的,看一百遍也就是个眼熟。 所以别贪心。让 AI 给你搭五级台阶: 我想一步一步地学习【主题】,不跳过任何重要基础。请你扮演一位专家教师和技能教练,把它分解为 5 个清晰的难度级别,从完全初学者到自信的实践者。每个级别包括: 1. 级别名称 2. 这个阶段我应该理解什么 3. 在这个级别上"掌握"是什么样子 4. 最需要重点关注的概念或技能 5. 一个证明我可以进入下一级别的里程碑 6. 一个动手练习或小型项目 7. 这个级别的学习者常犯的错误 8. 进入下一级别前的一个简单自测问题 按这个结构组织:级别 1 完全初学者、级别 2 基本理解、级别 3 实际使用者、级别 4 问题解决者、级别 5 自信的实践者。解释要实用、对初学者友好,专注真正的进步。 第 5 条和第 8 条是关键。没有里程碑和自测的阶梯,只是好听的分级。 人最容易犯的错,是把"看懂了"当成了"到站了"。阶梯的意义不是让你爬得快,是让你在每一级都停一下,问自己一句:如果现在就考我,我答得出来吗?答不出来,就还在这一级,不丢人,跳过去才丢人。 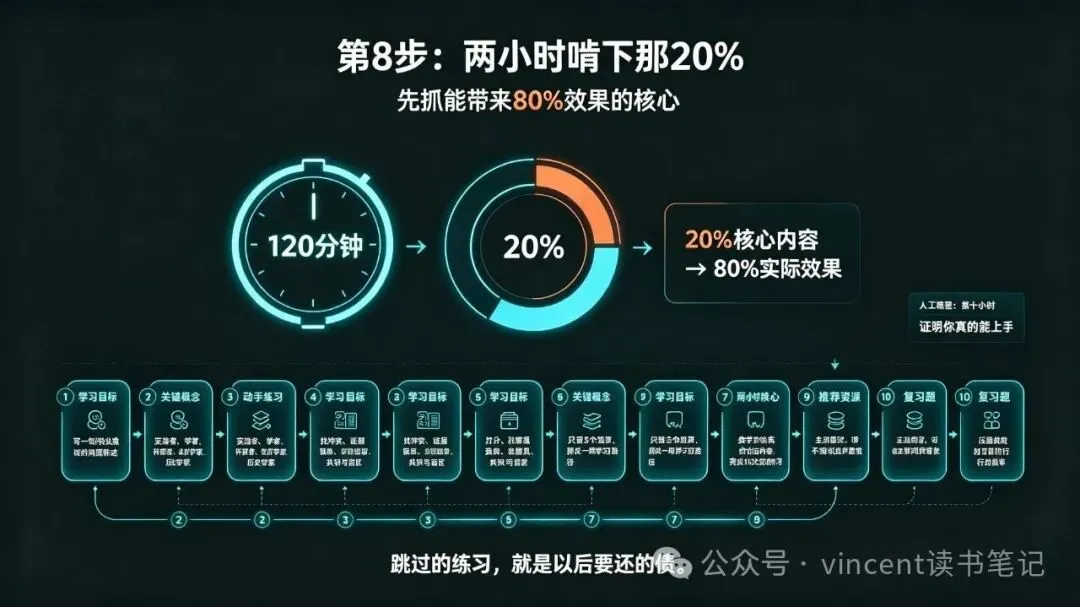
帕累托法则在这里是硬约束:能带来 80% 实际效果的那 20% 概念和技能,值得你先花两小时啃透,剩下的边用边补。 我想用 2 个小时学【主题】。请先找出能带来 80% 实际效果的那 20% 的概念和技能,解释它们为什么是核心;然后排成 10 次课的学习计划,每次课包含:学习目标、关键概念、一个动手练习、一个推荐资源(最好免费)、完成后的预期结果;每次课结束给我 5 个复习题;全部结束后,给我一个能证明我真的可以上手用的最终小项目。 十次课,每次十二分钟。听起来少得可疑,但你要的不是"学完",是"能上手"。 这一步必须真做,不能只看。那十次课里的动手练习,一次都别跳。跳过的练习,就是你以后要还的债。 两个小时是个很妙的长度。它短到你今天下班后就能挤出来,又长到足够你把一件事摸出个轮廓。它不承诺你会成为专家,它只承诺你今晚睡前,比早上多会一点东西。而所有真正的进步,都是这么一小段一小段攒出来的。 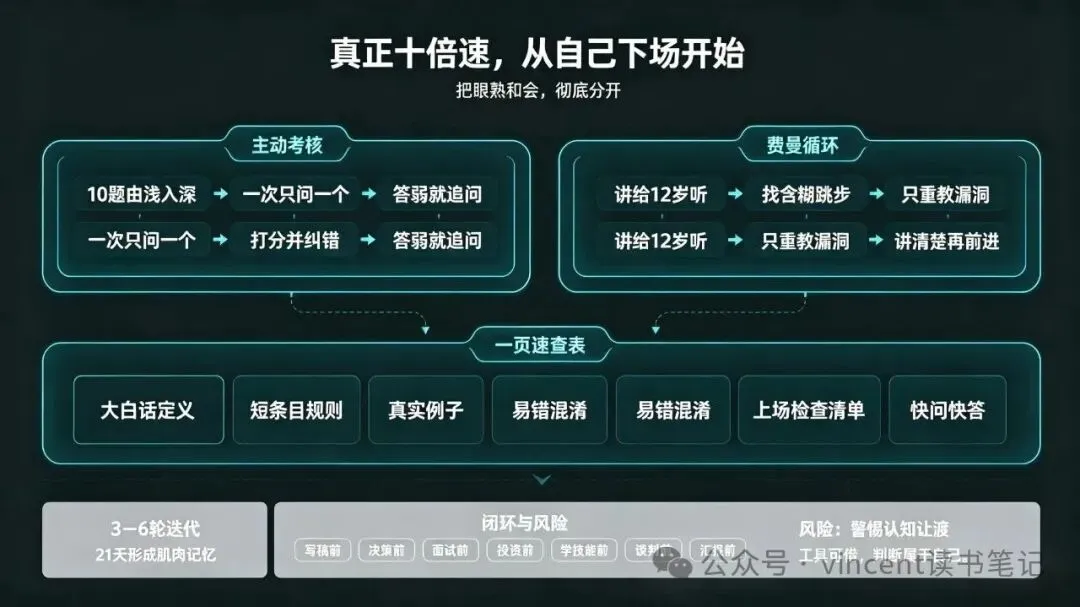
前面八步,AI 都在替你干活。这一步开始,你得自己下场。 先让 AI 当考官,往死里考: 我刚学完【主题】,想测试自己到底理解了多少。请你扮演一位严格但乐于助人的考官,通过主动回忆找出我理解的边界。从 10 个问题开始,一次只问一个。规则: 1. 问题逐渐变难:第 1-3 题初级,第 4-6 题中级,第 7-8 题高级,第 9-10 题专家级。 2. 一次只问一个问题,等我回答。 3. 每个回答之后做四件事:给我的答案打 0 到 10 分;告诉我哪里答对了;指出确切的差距、错误或薄弱点;用简单的语言重新解释我漏掉的部分。 4. 如果我答得很弱,先追问一个问题,再进入下一题。 5. 如果我答得很好,稍微增加难度。 6. 最后给我:最终得分、我最强的领域、我最弱的领域、一个简短的复习计划、5 个最终挑战题。 不要一次给我所有答案。让这像一场真实的学习面试。 为什么要这么干?因为从脑子里往外掏知识这个动作本身,比往脑子里塞知识,更能让知识记住。 你肯定有过考前抱佛脚、第二天反而记得特别牢的经历。就是这个机制:被这么考一遍,本身就是在学,不光是在测你会多少。多数人的学习全程只有输入没有提取,所以学完就忘,忘得理直气壮。 考完,把答崩的地方挑出来,让自己进入费曼循环: 我想用费曼学习法吃透【这个卡住的概念】。请你当一个有耐心的学习伙伴:先用简单的词、生活里的例子把它讲给我听,就当我是 12 岁;然后让我用自己的话复述一遍;接着找出我复述里每一个含糊、跳步、绕不过去的地方,只重新教这些部分;再让我讲一遍。循环下去,直到我的解释简单、准确、完整。在我讲清楚之前,别进入新内容。 费曼那句话你肯定听过:一个东西你没法讲给 12 岁的孩子听懂,你就还没真的懂它。四步就完了:学一遍,讲一遍,找出讲不清的地方回炉,再用更简单的话讲一遍。 这一步是整个流程里最不舒服的,也是最值钱的。它逼你把"眼熟"和"会"分开。 答错的时候,人是会有点难堪的。但你要记住一件事:AI 不记得你答错过什么,它也不会因此看低你。这是你这辈子能遇到的、最便宜的犯错机会。真正的考场不给你重来,这里给。 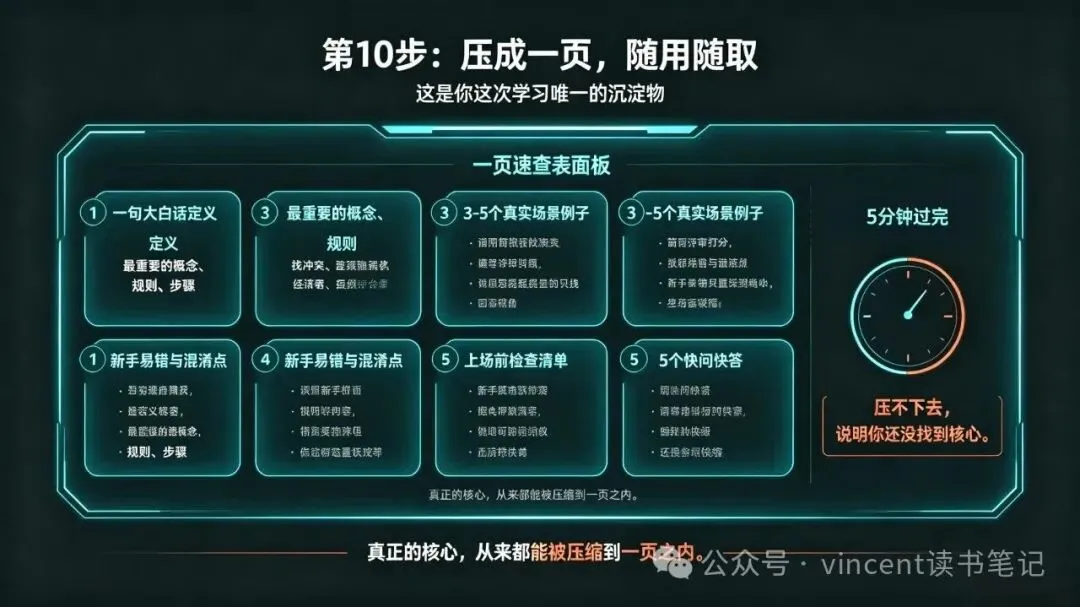
给我做一份关于【主题】的一页速查表,让我在要用它之前花 5 分钟就能过完:一句大白话定义;最重要的概念、规则、公式或步骤,全用短条目,别用长段落;3-5 个真实场景的例子;新手最容易犯的错、最容易混淆的地方;一份"上场前"检查清单;最后加 5 个快问快答,测测我还记得多少。 这一页纸,是你这次学习唯一的沉淀物。它比那份漂亮简报有用得多,因为简报是给"当时"的你看的,速查表是给"以后每次要用"的你看的。 一页纸是个很残酷的限制。它会逼你承认:有些东西你以为很重要,其实只是看着重要。真正的核心,从来都能被压缩到一页之内。压不下去,说明你还没找到那个核心。 十步不是走一遍就完的。拿一个真实任务去试,试完回到第三步重跑,直到主要矛盾收敛——你的分歧地图上不再冒出新的大冲突,剩下的都是细节。 每轮迭代后,把已解决的矛盾删掉或归档,保持图谱轻量。一张越画越乱的图,你第三次就不想打开了。 周期建议先坚持 21 天。三周,跑两到三个陌生领域,这套动作就会长在你手上,变成肌肉记忆。 别把它供起来当摆设。它能用的地方多到离谱: 写文章、报告之前:先跑一遍,你的稿子会盖住别人压根没想到的角度 做重大决定之前:实践者告诉你现实里行不行,怀疑者告诉你哪儿会翻车,经济学家告诉你谁在闷声赚钱 面试之前:五分钟从五个角度把目标公司扒一遍,实践者视角给你行话,怀疑者视角给你犀利的反问 投资之前:看多、看空、历史先例、利益版图、学术证据,五分钟全摆齐 学新技能之前:直接跳过一堆噪音 谈判之前:摸清对方的利益、软肋、历史套路 演讲、汇报之前:在观众张嘴提问之前,先把那些质疑挡回去 这套方法有个副作用,而且很隐蔽。 AI 看起来能帮你趟过以往看似不可能的执行门槛,于是过度的依赖会造成认知的让渡。你的判断、你的审美、你的思考,都为了"效率"双手奉上。那些一味回复"可以开始执行"的惯性里,省下的不只是时间,还有以往吃力解决问题后,一笔一划刻下的经验积累。 更要命的是,别人已经精心编排好顺序的说明,不加思考地全盘接受,只会让它顺滑地进入你的耳朵,也从你脑子里顺滑地溜走。不要活在"感觉自己懂了"的错觉里。 所以这套流程里,第五步的自查、第九步的考问和费曼循环,一步都不能省。它们不是流程里的装饰,它们是唯一能防止你变成"AI 的传声筒"的关卡。 工具可以借,速度得是自己的。你真正的速度,从来不是 AI 吐字的速度,是你从脑子里把知识掏出来的速度。 从今天挑一个你一直想搞懂但没搞懂的东西,写下那句问题陈述,然后跑第一步。 五分钟之后,你会知道该往哪看。 剩下的路,得你自己走。走得慢一点也没关系,只要是你自己走出来的。
第一步:先钉一句问题,别急着开跑
第二步:五个专家上桌,让观点先打一架
第三步:让这五个人当场打起来
第四步:捏成一份给老板看的简报
第五步:让 AI 给自己的作业挑刺
第六步:只留五个资源,就可以把"收藏"变成为"路线"
第七步:搭阶梯,别一上来就爬墙
第八步:两小时,先啃下那 20%
第九步:考到崩溃,这才是十倍速真正的引擎